
เจาะลึก 9 ตัวชี้วัดสำคัญของ LLM Inference ใน 5 นาที
บทนำ
การมี token throughput สูงเพียงอย่างเดียวไม่ได้การันตีประสบการณ์การใช้งานที่รวดเร็วเสมอไปสำหรับแอปพลิเคชัน LLM เพราะ token แรกอาจใช้เวลาประมวลผลนานเกินไป หรือ token ถัดมาอาจสตรีมล่าช้า โดยเฉพาะเมื่อระบบต้องรับภาระงานพร้อมกัน (concurrent load) จำนวนมาก
ตัวชี้วัด LLM inference จะช่วยแยกแยะประสิทธิภาพออกมาเป็นส่วนต่างๆ ที่วัดผลได้จริง ตั้งแต่ความหน่วงในการตอบสนองเริ่มต้น ความเร็วในการสร้าง token ไปจนถึงภาระงานรวมของระบบ บทความนี้จะครอบคลุม 9 ตัวชี้วัดหลักพร้อมสูตรคำนวณ เพื่อใช้ระบุคอขวดและติดตามประสิทธิภาพในระยะยาว ดังนี้:
- Per-request latency: ได้แก่ time to first token (TTFT), end-to-end latency (E2E), token generation time, time per output token (TPOT) และ inter-token latency (ITL)
- Latency ของหลายคำขอ: ค่าเฉลี่ย (mean), มัธยฐาน (median) และ tail percentiles
- Server load: requests per second (RPS) และ tokens per second (TPS)
- คุณภาพการบริการ: goodput
เราจะเริ่มทำความเข้าใจจากลำดับเวลา (timeline) ของการส่งคำขอเพียงรายการเดียวก่อน
การอ่านลำดับเวลาของคำขอ
ตัวชี้วัด latency ส่วนใหญ่กำหนดจากค่าสำคัญ 4 ค่า ได้แก่ ( t_{\text{send}} ) คือเวลาที่ส่งคำขอจาก client, ( t_{\text{first}} ) คือเวลาที่ได้รับ token แรก, ( t_{\text{last}} ) คือเวลาที่ได้รับ token สุดท้าย และ ( N_{\text{out}} ) คือจำนวน output token ทั้งหมด ส่วนการวัด ITL จะต้องใช้เวลาที่แต่ละ token มาถึง (( t_j )) โดยที่ ( t_1 = t_{\text{first}} ) และ ( t_{N_{\text{out}}} = t_{\text{last}} )
เมื่อนำมาวางบนลำดับเวลา การประทับเวลาเหล่านี้จะแบ่งช่วงของคำขอออกเป็นสองส่วนหลัก:
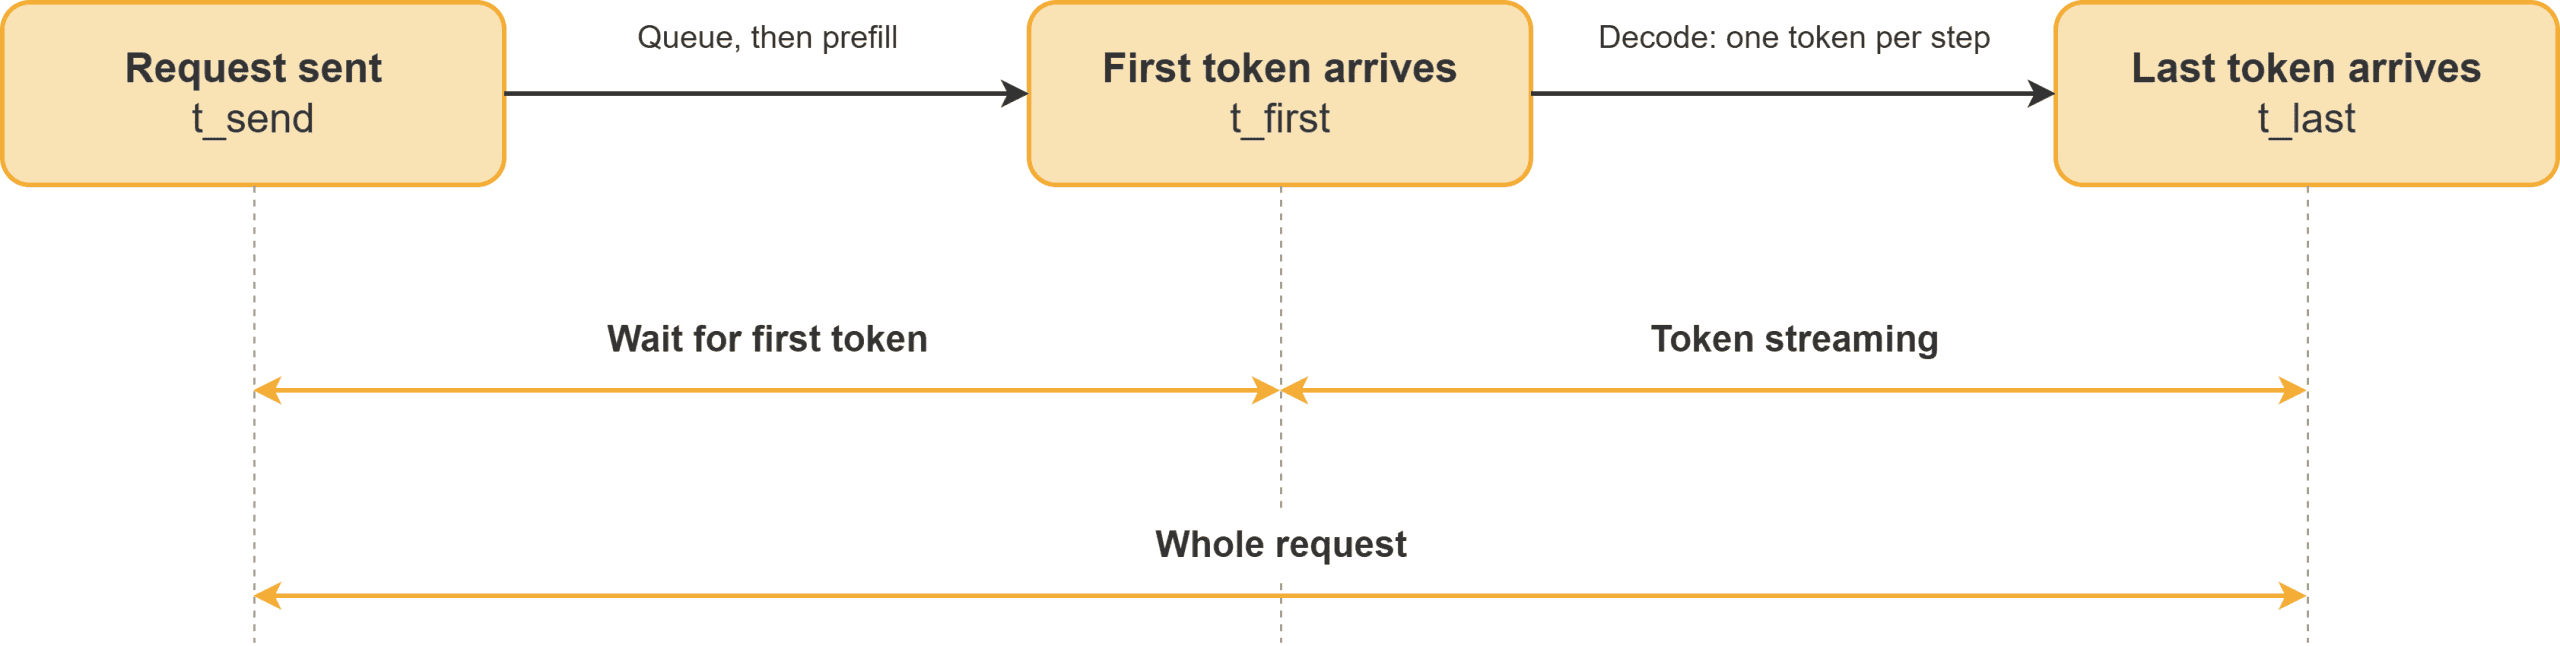
ลำดับเวลาของคำขอ: ช่วงรอ token แรก, ช่วงสตรีม token และภาพรวมคำขอทั้งหมด
ในช่วงก่อนถึง ( t_{\text{first}} ) คำขออาจติดอยู่ในคิวรอ จากนั้น server จะเริ่มช่วง prefill เพื่อประมวลผล prompt และสร้าง token แรกออกมา หลังจากนั้น server จะเข้าสู่ช่วง decode เพื่อทยอยส่ง token ออกมาทีละขั้นตอนจนจบ โดยตัวชี้วัด latency แต่ละตัวจะเลือกวัดเฉพาะส่วนหรือวัดทั้งช่วงเวลาดังกล่าว
การวัด Latency
ตัวชี้วัด 6 ตัวแรกจะใช้ระบุระยะเวลาที่ผู้ใช้ต้องรอคอย ทั้งสำหรับคำขอเดียวและภาพรวมหลายคำขอ
1. Time to First Token
TTFT คือความหน่วงระหว่างการส่งคำขอจนถึงการได้รับ token แรก ซึ่งรวมถึงเวลาในการเดินทางผ่านเครือข่าย การรอคิว และการประมวลผล prompt ค่านี้จะเพิ่มขึ้นตามภาระของ server และความยาวของ prompt
[
\text{TTFT} = t_{\text{first}} - t_{\text{send}}
]
แอปพลิเคชันแชทเชิงโต้ตอบมักให้ความสำคัญกับตัวเลขนี้มากที่สุด เพราะเป็นตัวกำหนดว่าผู้ใช้ต้องรอหน้าจอว่างเปล่านานเพียงใด
2. End-to-End Latency
E2E latency คือเวลารอคอยทั้งหมด ตั้งแต่เริ่มส่งคำขอจนกระทั่งได้รับ token สุดท้ายครบถ้วน
[
\text{E2E} = t_{\text{last}} - t_{\text{send}}
]
ค่านี้คือผลรวมของเวลาที่รอ token แรกบวกกับเวลาที่ใช้สตรีมข้อมูลจนจบ
3. Token Generation Time
Token generation time คือระยะเวลาในช่วงสตรีม หรือเวลาที่ server ใช้ส่งมอบ token ทั้งหมดหลังจากส่ง token แรกออกมาแล้ว
[
\text{TokenGen} = t_{\text{last}} - t_{\text{first}} = \text{E2E} - \text{TTFT}
]
ค่านี้จะเพิ่มขึ้นตามจำนวน output token ดังนั้นจึงควรประเมินความเร็วในการสตรีมผ่าน TPOT เพื่อตัดปัจจัยเรื่องความยาวออกไป
4. Time per Output Token
TPOT คือเวลาเฉลี่ยระหว่างการส่งแต่ละ token หลังจากได้รับ token แรกแล้ว เป็นการเฉลี่ยเวลาสตรีมให้เท่ากันในทุก token
[
\text{TPOT} = \frac{\text{E2E} - \text{TTFT}}{N_{\text{out}} - 1} = \frac{\text{TokenGen}}{N_{\text{out}} - 1}
] เนื่องจาก token แรกถูกนับรวมใน TTFT ไปแล้ว ตัวหารจึงเป็น ( N_{\text{out}} - 1 ) ทำให้ไม่สามารถระบุค่า TPOT ได้ในกรณีที่มีเพียง token เดียว ทั้งนี้ เครื่องมือ Benchmarking แต่ละเจ้าอาจมีนิยามต่างกัน เช่น บางรายรวม TTFT เข้าไปด้วย จึงควรตรวจสอบนิยามก่อนเปรียบเทียบผลลัพธ์
5. Inter-Token Latency
ITL คือช่องว่างระยะเวลาระหว่างสอง token ที่ส่งออกมาต่อเนื่องกัน ในหนึ่งคำขอที่มีหลาย token จะมีช่องว่างหลายจุดให้วัดค่าแยกกัน
[
\text{ITL}j = t{j+1} - t_j, \quad j = 1, \dots, N_{\text{out}} - 1
]
สำหรับคำขอเดียว ค่าเฉลี่ย ITL จะเท่ากับ TPOT แต่เมื่อวัดผลรวมหลายคำขอ (( R ) รายการ) วิธีคำนวณจะต่างกัน โดยค่าเฉลี่ย ITL จะนับทุกช่องว่างอย่างเท่าเทียม ขณะที่ค่าเฉลี่ย TPOT จะให้ความสำคัญกับภาพรวมแต่ละคำขอ:
[
\overline{\text{ITL}} = \frac{\sum_{i=1}^{R} \sum_{j=1}^{N_i - 1} \text{ITL}{i,j}}{\sum{i=1}^{R} (N_i - 1)}
\qquad
\overline{\text{TPOT}} = \frac{1}{R} \sum_{i=1}^{R} \text{TPOT}_i
]
คำขอยาวๆ เพียงไม่กี่รายการจะมีผลต่อค่าเฉลี่ย ITL มากกว่า ส่วน TPOT จะเฉลี่ยความสำคัญของคำขอทุกขนาดเท่ากัน นอกจากนี้ ITL ยังช่วยให้เห็นอาการกระตุก (stall) ระหว่างสตรีมได้ชัดเจนกว่า
6. ค่าเฉลี่ย, มัธยฐาน และ Tail Percentiles เนื่องจาก latency ของแต่ละคำขอนั้นไม่เท่ากัน การสรุปผลจากหลายคำขอจึงต้องใช้สถิติมาช่วย:
- ค่าเฉลี่ย (mean): คือค่าเฉลี่ยรวมซึ่งมักได้รับผลกระทบจากค่าที่สูงผิดปกติ (outliers)
- มัธยฐาน (median) หรือ P50: ค่าที่แบ่งครึ่งข้อมูล สะท้อนประสบการณ์ของผู้ใช้ทั่วไป
- P99: ค่าที่ครอบคลุม 99% ของคำขอทั้งหมด ใช้แสดงประสิทธิภาพของกลุ่มที่ช้าที่สุด (tail) โดยมี P90 และ P95 เป็นเกณฑ์ที่รองลงมา
ควรใช้ค่าสถิติเหล่านี้วิเคราะห์ทั้ง TTFT, TPOT และ E2E แยกกัน โดยคำนวณจากข้อมูลดิบทั้งหมดรวมกัน ไม่ควรนำค่า percentile ของแต่ละ server มาหาค่าเฉลี่ยซ้ำอีกครั้ง
การวัด Throughput และ Goodput
ตัวชี้วัด 3 ตัวสุดท้ายจะแสดงถึงประสิทธิภาพการทำงานของ server ในภาพรวมในช่วงเวลาหนึ่ง
7. Requests per Second
RPS คือจำนวนคำขอที่ประมวลผลเสร็จสิ้นต่อหนึ่งวินาที
[
\text{RPS} = \frac{N_{\text{completed}}}{t_{\text{end}} - t_{\text{start}}}
] เนื่องจาก RPS ไม่ได้สะท้อนขนาดของข้อมูลในแต่ละคำขอ จึงควรเปรียบเทียบเฉพาะเมื่อใช้ชุดข้อมูลที่มีความยาว prompt และ output ในสัดส่วนที่ใกล้เคียงกันเท่านั้น
8. Tokens per Second
TPS คือจำนวน token ทั้งหมดที่ server ประมวลผลได้ต่อวินาที โดยแบ่งเป็นฝั่ง input และ output:
[
\text{TPS}{\text{out}} = \frac{\sum{i} N_{\text{out},i}}{t_{\text{end}} - t_{\text{start}}}
\qquad
\text{TPS}{\text{in}} = \frac{\sum{i} N_{\text{prompt},i}}{t_{\text{end}} - t_{\text{start}}}
]
การระบุประเภท TPS ให้ชัดเจนเป็นสิ่งสำคัญ เพราะงานที่ส่ง prompt ยาวแต่ตอบสั้นอาจมีค่า input TPS สูงมาก แม้จะสร้าง output token ได้เพียงเล็กน้อยก็ตาม
9. Goodput
Goodput คืออัตราคำขอที่สำเร็จตามเกณฑ์ Service Level Objectives (SLOs) ที่กำหนดไว้ เช่น benchmark อย่าง vLLM จะใช้ค่านี้ในการวัดประสิทธิภาพ โดยคำขอจะถูกนับเป็น "good" ก็ต่อเมื่อผ่านเกณฑ์ latency ทุกด้านตามที่งานวิจัย DistServe paper ระบุไว้:
[
\text{TTFT}i \le s{\text{ttft}} ;\land; \text{TPOT}i \le s{\text{tpot}} ;\land; \text{E2E}i \le s{\text{e2e}}
]
เมื่อได้จำนวนคำขอที่เป็นไปตามเกณฑ์แล้ว จึงนำมาคำนวณเป็น Goodput:
[
\text{Goodput} = \frac{N_{\text{good}}}{t_{\text{end}} - t_{\text{start}}}
]
Goodput จะไม่มีทางสูงกว่า RPS และส่วนต่างระหว่างทั้งสองค่าจะช่วยบอกถึงอัตราคำขอที่พลาดเป้าหมายด้านประสิทธิภาพไป
บทสรุป
ตัวชี้วัด Inference ช่วยให้เราเห็นภาพการทำงานตั้งแต่ช่วงรอ token แรกไปจนถึงการสตรีมจบ ช่วยให้ผู้ดูแลระบบประเมินได้ว่า server รองรับภาระงานได้ดีเพียงใดและเป็นไปตามเป้าหมายที่ตั้งไว้หรือไม่ โดยมีสรุปดังตารางด้านล่าง:
| ตัวชี้วัด | สูตรคำนวณ | สิ่งที่บอกเรา |
|---|---|---|
| TTFT | ( t_{\text{first}} - t_{\text{send}} ) | เริ่มตอบสนองเร็วแค่ไหน |
| E2E | ( t_{\text{last}} - t_{\text{send}} ) | ตอบกลับเสร็จสิ้นทั้งหมดเมื่อใด |
| Token generation time | ( t_{\text{last}} - t_{\text{first}} ) | ช่วงเวลาที่ใช้สตรีมข้อมูล |
| TPOT | ( \frac{\text{E2E} - \text{TTFT}}{N_{\text{out}} - 1} ) | ความเร็วเฉลี่ยของการส่ง token |
| ITL | ( t_{j+1} - t_j ) | การสตรีมมีอาการสะดุดหรือไม่ |
| Mean, median, P99 | ( x_{(\lceil 0.99 N \rceil)} ) (สำหรับ P99) | เปรียบเทียบคำขอทั่วไปกับกลุ่มที่ช้าที่สุด |
| RPS | ( \frac{N_{\text{completed}}}{t_{\text{end}} - t_{\text{start}}} ) | จำนวนคำขอที่เสร็จต่อวินาที |
| TPS | ( \frac{\sum_i N_{\text{out},i}}{t_{\text{end}} - t_{\text{start}}} ) | จำนวน token ที่ผลิตได้ต่อวินาที |
| Goodput | ( \frac{N_{\text{good}}}{t_{\text{end}} - t_{\text{start}}} ) | คำขอที่เป็นไปตามมาตรฐาน SLO |
ข้อมูลอ้างอิงและการเรียนรู้เพิ่มเติม:
- Key Metrics for LLM Inference | Modular Handbook
- Benchmarking Metrics for LLM Inference
- DistServe: Disaggregating Prefill and Decoding for Goodput-Optimized Serving
- LLM Inference Performance Engineering: Best Practices
ขอให้สนุกกับการเรียนรู้!
Bala Priya เป็นนักพัฒนาและนักเขียนเชิงเทคนิคผู้เชี่ยวชาญด้านวิทยาศาสตร์ข้อมูลและ AI เธอมีความมุ่งมั่นในการเปลี่ยนแนวคิดทางเทคนิคที่ซับซ้อนให้กลายเป็นเนื้อหาที่ใช้งานได้จริง โดยมีความสนใจครอบคลุมตั้งแต่ LLM, agentic AI ไปจนถึงระบบ ML เมื่อว่างจากการเขียนโค้ด เธอมักจะแบ่งปันความรู้และแลกเปลี่ยนเรื่องราวผ่านวรรณกรรมในโลกของนักพัฒนา
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร