
Phonon TTS ระบบเสียง AI ออฟไลน์ ครองอันดับ 1 ด้านความเร็ว
เมื่อสองสัปดาห์ก่อน เราได้เปิดตัว Phonon โมเดล text-to-speech (TTS) ขนาดเล็กที่ทำงานบนอุปกรณ์ของผู้ใช้โดยตรง จุดเด่นคือไม่จำเป็นต้องเชื่อมต่อเซิร์ฟเวอร์หรือเครือข่าย ช่วยให้ข้อมูลที่คุณพิมพ์มีความเป็นส่วนตัวและปลอดภัยสูงสุด
การเปิดตัวครั้งนี้ได้รับผลตอบรับอย่างดีเยี่ยม เราจึงอยากแบ่งปันเบื้องหลังการพัฒนาความสามารถของ Phonon รวมถึงผลการทดสอบบน Open TTS Leaderboard ของ Hugging Face ที่พิสูจน์ถึงประสิทธิภาพที่ยอดเยี่ยม
ทำไมเสียง AI ควรประมวลผลบนอุปกรณ์
ปัจจุบัน AI เสียงส่วนใหญ่มักทำงานบนคลาวด์ ซึ่งต้องส่งข้อมูลไปกลับระหว่างเซิร์ฟเวอร์ แต่ Phonon เลือกใช้แนวทางที่ต่างออกไปโดยประมวลผลที่ตัวเครื่อง ทำให้ใช้งานได้แม้อยู่ในจุดอับสัญญาณ เราได้เปิดตัว weights ของ Phonon 31m ภายใต้ใบอนุญาต Apache 2.0 ซึ่งอนุญาตให้ใช้งานในเชิงพาณิชย์ได้ฟรี ส่วนโมเดลรุ่นอื่นๆ จะเป็นใบอนุญาตแบบ CC BY-NC สำหรับโปรเจกต์ที่ไม่แสวงหากำไร
โจทย์สำคัญของการพัฒนาคือการสร้างเสียงคุณภาพสูงในโมเดลขนาดเล็ก ซึ่งปกติมักจะต้องแลกเปลี่ยนกันระหว่างขนาดและคุณภาพเสียง แต่ Phonon สามารถก้าวข้ามข้อจำกัดนี้ได้สำเร็จ
ทีมงานใช้เวลา 6 เดือนในการพัฒนาร่วมกับพันธมิตร เพื่อปรับปรุงให้โมเดลมีขนาดเล็กลง รองรับหลายภาษามากขึ้น และเพิ่มฟีเจอร์การออกแบบเสียงรวมถึง voice cloning ที่แม่นยำ
Phonon พัฒนาต่อยอดจากตระกูล Pocket TTS โดยใช้เทคนิค flow matching ในการสร้างเสียง ซึ่งเป็นแนวทางที่ต่างจากระบบ TTS อื่นๆ แม้จะมีความท้าทายเรื่องความเสถียรทางตัวเลขในช่วงแรก แต่เราสามารถปรับแต่งจนได้คุณภาพเสียงที่ยอดเยี่ยมครบทั้ง 5 ภาษา
รายละเอียดการเปิดตัว
Phonon มีให้เลือกสองขนาดคือ 65 MB และ 75 MB รองรับภาษาอังกฤษ ฝรั่งเศส เยอรมัน สเปน และโปรตุเกส มาพร้อมเสียงพื้นฐานกว่า 100 เสียง และยังสามารถสร้างเสียงเฉพาะตัวได้ผ่าน Gradium Studio นอกจากนี้ยังเก่งเรื่องการจัดการข้อมูลเฉพาะอย่างหมายเลขโทรศัพท์ วันที่ และรหัสต่างๆ ได้อย่างแม่นยำ
ตัวโมเดลรองรับการทำงานบนสมาร์ทโฟน แล็ปท็อป คอมพิวเตอร์บอร์ดเดี่ยว จนถึงการรันบนเบราว์เซอร์ ซึ่งคุณสามารถ ลองฟังเสียงได้ทันที โดยรุ่น Phonon 31m สำหรับภาษาอังกฤษจะเป็น Open Source เต็มตัวให้นักพัฒนานำไปต่อยอดได้ทันที
เดโมและเสียงตอบรับจากนักพัฒนา
ในการ เปิดตัว เราได้แสดงตัวอย่างการใช้งานจริง เช่น การใช้ Apple Watch ช่วยชงกาแฟแบบออฟไลน์ หรือ iPhone ที่ช่วยนับจังหวะการออกกำลังกายในที่ไม่มีสัญญาณ แม้แต่หุ่นยนต์และเกมแนวไซไฟก็นำ Phonon ไปใช้พากย์เสียงแบบเรียลไทม์บนเครื่องของผู้เล่น
นอกจากนี้ ทีม Hugging Face ยังได้รวม Phonon เข้ากับไลบรารี Transformers ช่วยให้นักพัฒนาใช้งานได้ง่ายตั้งแต่วันแรก
ปัจจุบัน Phonon ถูกดาวน์โหลดไปแล้วกว่า 200,000 ครั้งในช่วง 2 สัปดาห์แรก และยังคงได้รับความนิยมอย่างต่อเนื่องบน Hugging Face ผ่านการพอร์ตไปยังเฟรมเวิร์กต่างๆ เช่น ExecuTorch และ Micdrop
ผลการทดสอบบน Hugging Face Open TTS Leaderboard
Open TTS Leaderboard เป็นเกณฑ์มาตรฐานใหม่ในการเปรียบเทียบโมเดล TTS กว่า 9,000 โมเดลบน Hugging Face Hub โดยวัดผลทั้งความชัดเจน ความเร็ว และความเป็นธรรมชาติของเสียง
ผลการประเมินพบว่า Phonon ครองอันดับหนึ่งใน ภาษาเยอรมัน และ ภาษาสเปน รวมถึงติดอันดับ Top 3 ในทุกภาษาที่ส่งเข้าทดสอบ แม้จะมีขนาดเล็กกว่าคู่แข่งถึง 100 เท่าก็ตาม
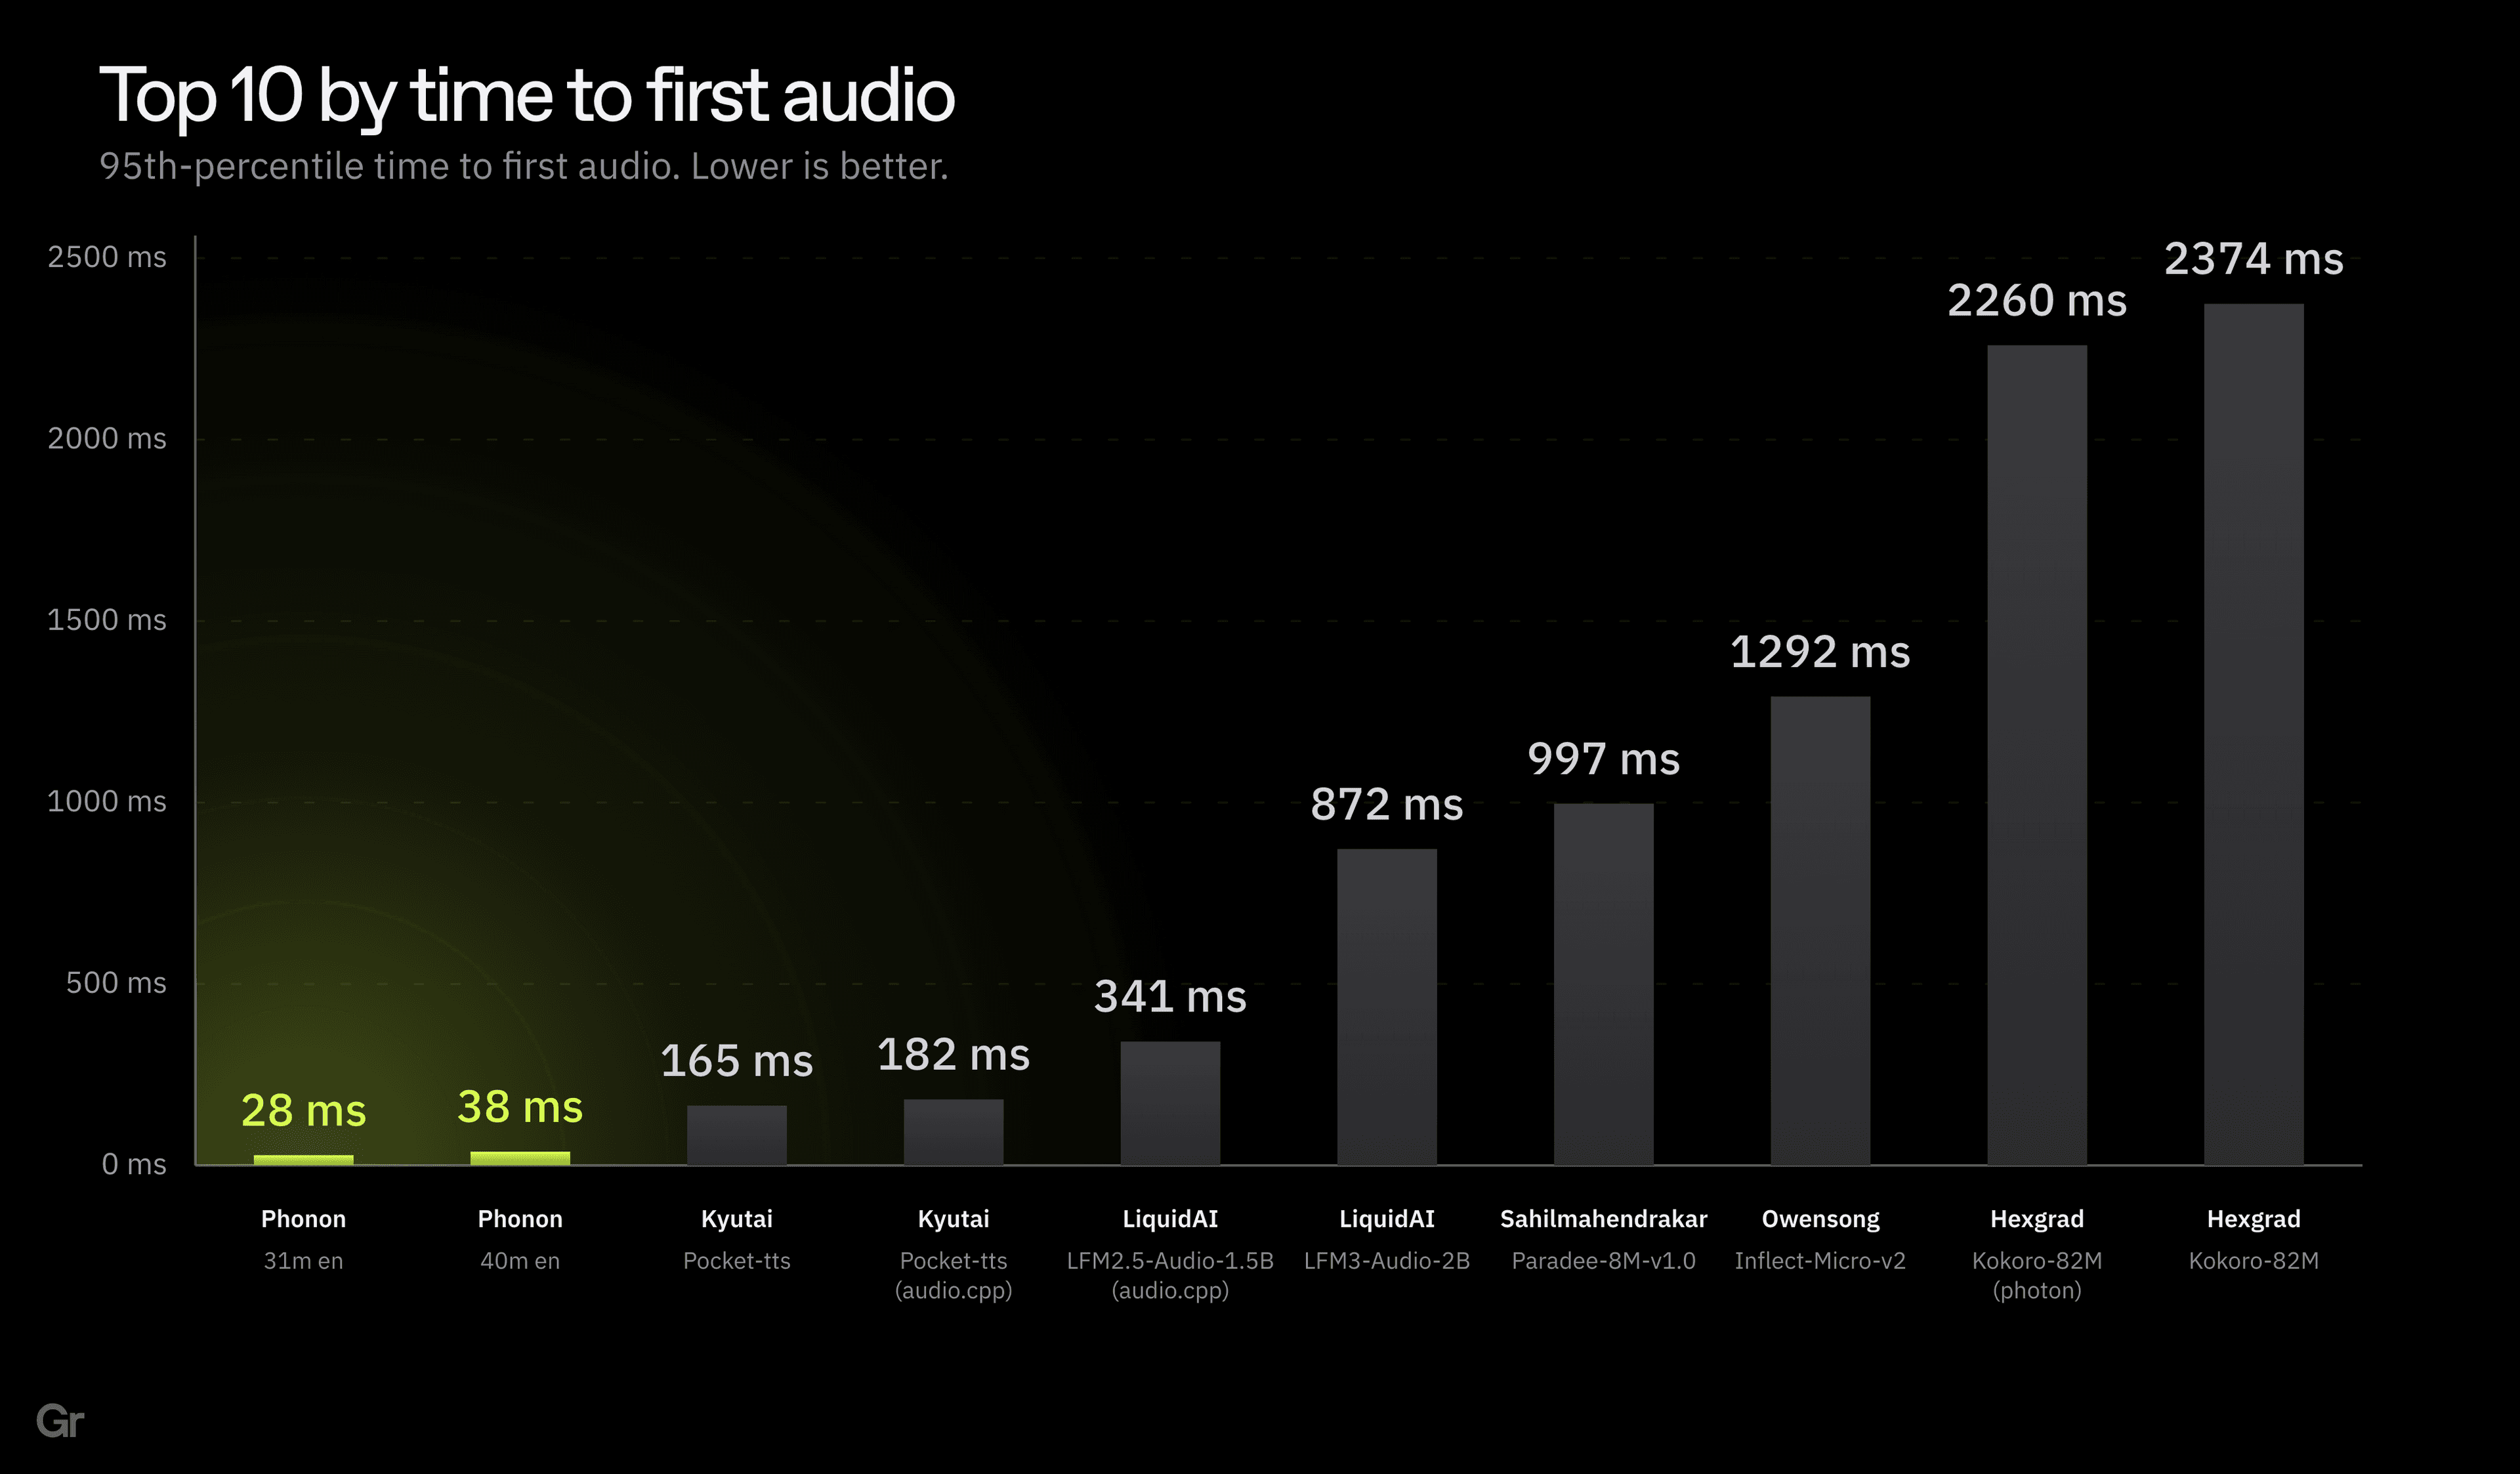
ด้านความเร็ว Phonon ครองอันดับสูงสุดใน CPU streaming benchmark สำหรับการสร้างเสียงเริ่มแรก (time-to-first audio)
เทคนิคการประมวลผล (Inference)
เราได้สร้างเฟรมเวิร์ก ptts ขึ้นมาเพื่อ Phonon โดยเฉพาะ รองรับ backend หลากหลายตั้งแต่ CPU, GPU จนถึง NPU บนชิปเซ็ตยอดนิยมอย่าง Snapdragon และ Apple Core ML
สำหรับนักพัฒนาที่ใช้ 🤗 Transformers รุ่น v5.21 เป็นต้นไป สามารถใช้งาน Phonon ผ่าน PyTorch ได้ทันที ซึ่งเหมาะสำหรับการประมวลผลข้อมูลเสียงขนาดใหญ่บน GPU หรือนำไปศึกษาโครงสร้างโมเดล
ตัวอย่างโค้ดการใช้งานเริ่มต้น:
from transformers import AutoProcessor, GradiumPhononTTSForConditionalGeneration

model_id = "gradium/phonon-31m-en"
processor = AutoProcessor.from_pretrained(model_id, device_map="auto")
model = GradiumPhononTTSForConditionalGeneration.from_pretrained(model_id, device_map="auto")

print(f"{model.num_parameters():,}")  # 30,788,354
print(f"{processor.audio_tokenizer.num_parameters():,}")  # 10,305,313
โมเดลนี้ทำงานโดยสร้าง audio latents แบบต่อเนื่อง (autoregressively) ซึ่งทำหน้าที่คล้ายกับ text tokens ในโมเดลภาษาทั่วไป โดยเสียงจะถูกคำนวณไว้ล่วงหน้าและดึงมาใช้ผ่าน speaker latents:
from huggingface_hub import hf_hub_download
from safetensors.torch import load_file

path = hf_hub_download("gradium/phonon-voices", "voices/LMDIYE0Oa377Qh6Z.safetensors")
voice = load_file(path)["speaker_wavs"][0].T  # (num_frames, 512)
การใช้งานสามารถทำได้ผ่าน chat template เหมือนโมเดล multimodal อื่นๆ ช่วยให้นักพัฒนาสร้างบทสนทนาที่มีเสียงประกอบได้ง่ายดาย ดูรายละเอียดเพิ่มเติมได้ที่ เอกสารอย่างเป็นทางการ ของ 🤗
ก้าวต่อไปของ Phonon
นอกจากความสามารถปัจจุบัน Phonon ยังสามารถปรับแต่งเพื่อรองรับภาษาใหม่ๆ เช่น เกาหลี อาหรับ หรือญี่ปุ่น รวมถึงการ fine-tune ด้วยคำศัพท์เฉพาะทางสำหรับธุรกิจ หากคุณต้องการโมเดลที่เล็กลงหรือต้องการฟีเจอร์เฉพาะ สามารถ ติดต่อเรา เพื่อแจ้งความต้องการได้
เราขอเชิญชวนให้ทุกคน ลองใช้งาน Phonon และร่วมสร้างสรรค์นวัตกรรมเสียงรูปแบบใหม่ไปพร้อมกับเรา
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร