
Together AI เปิดตัวระบบ Agent ช่วยดันความเร็ว Inference สูงสุด 2.6 เท่า
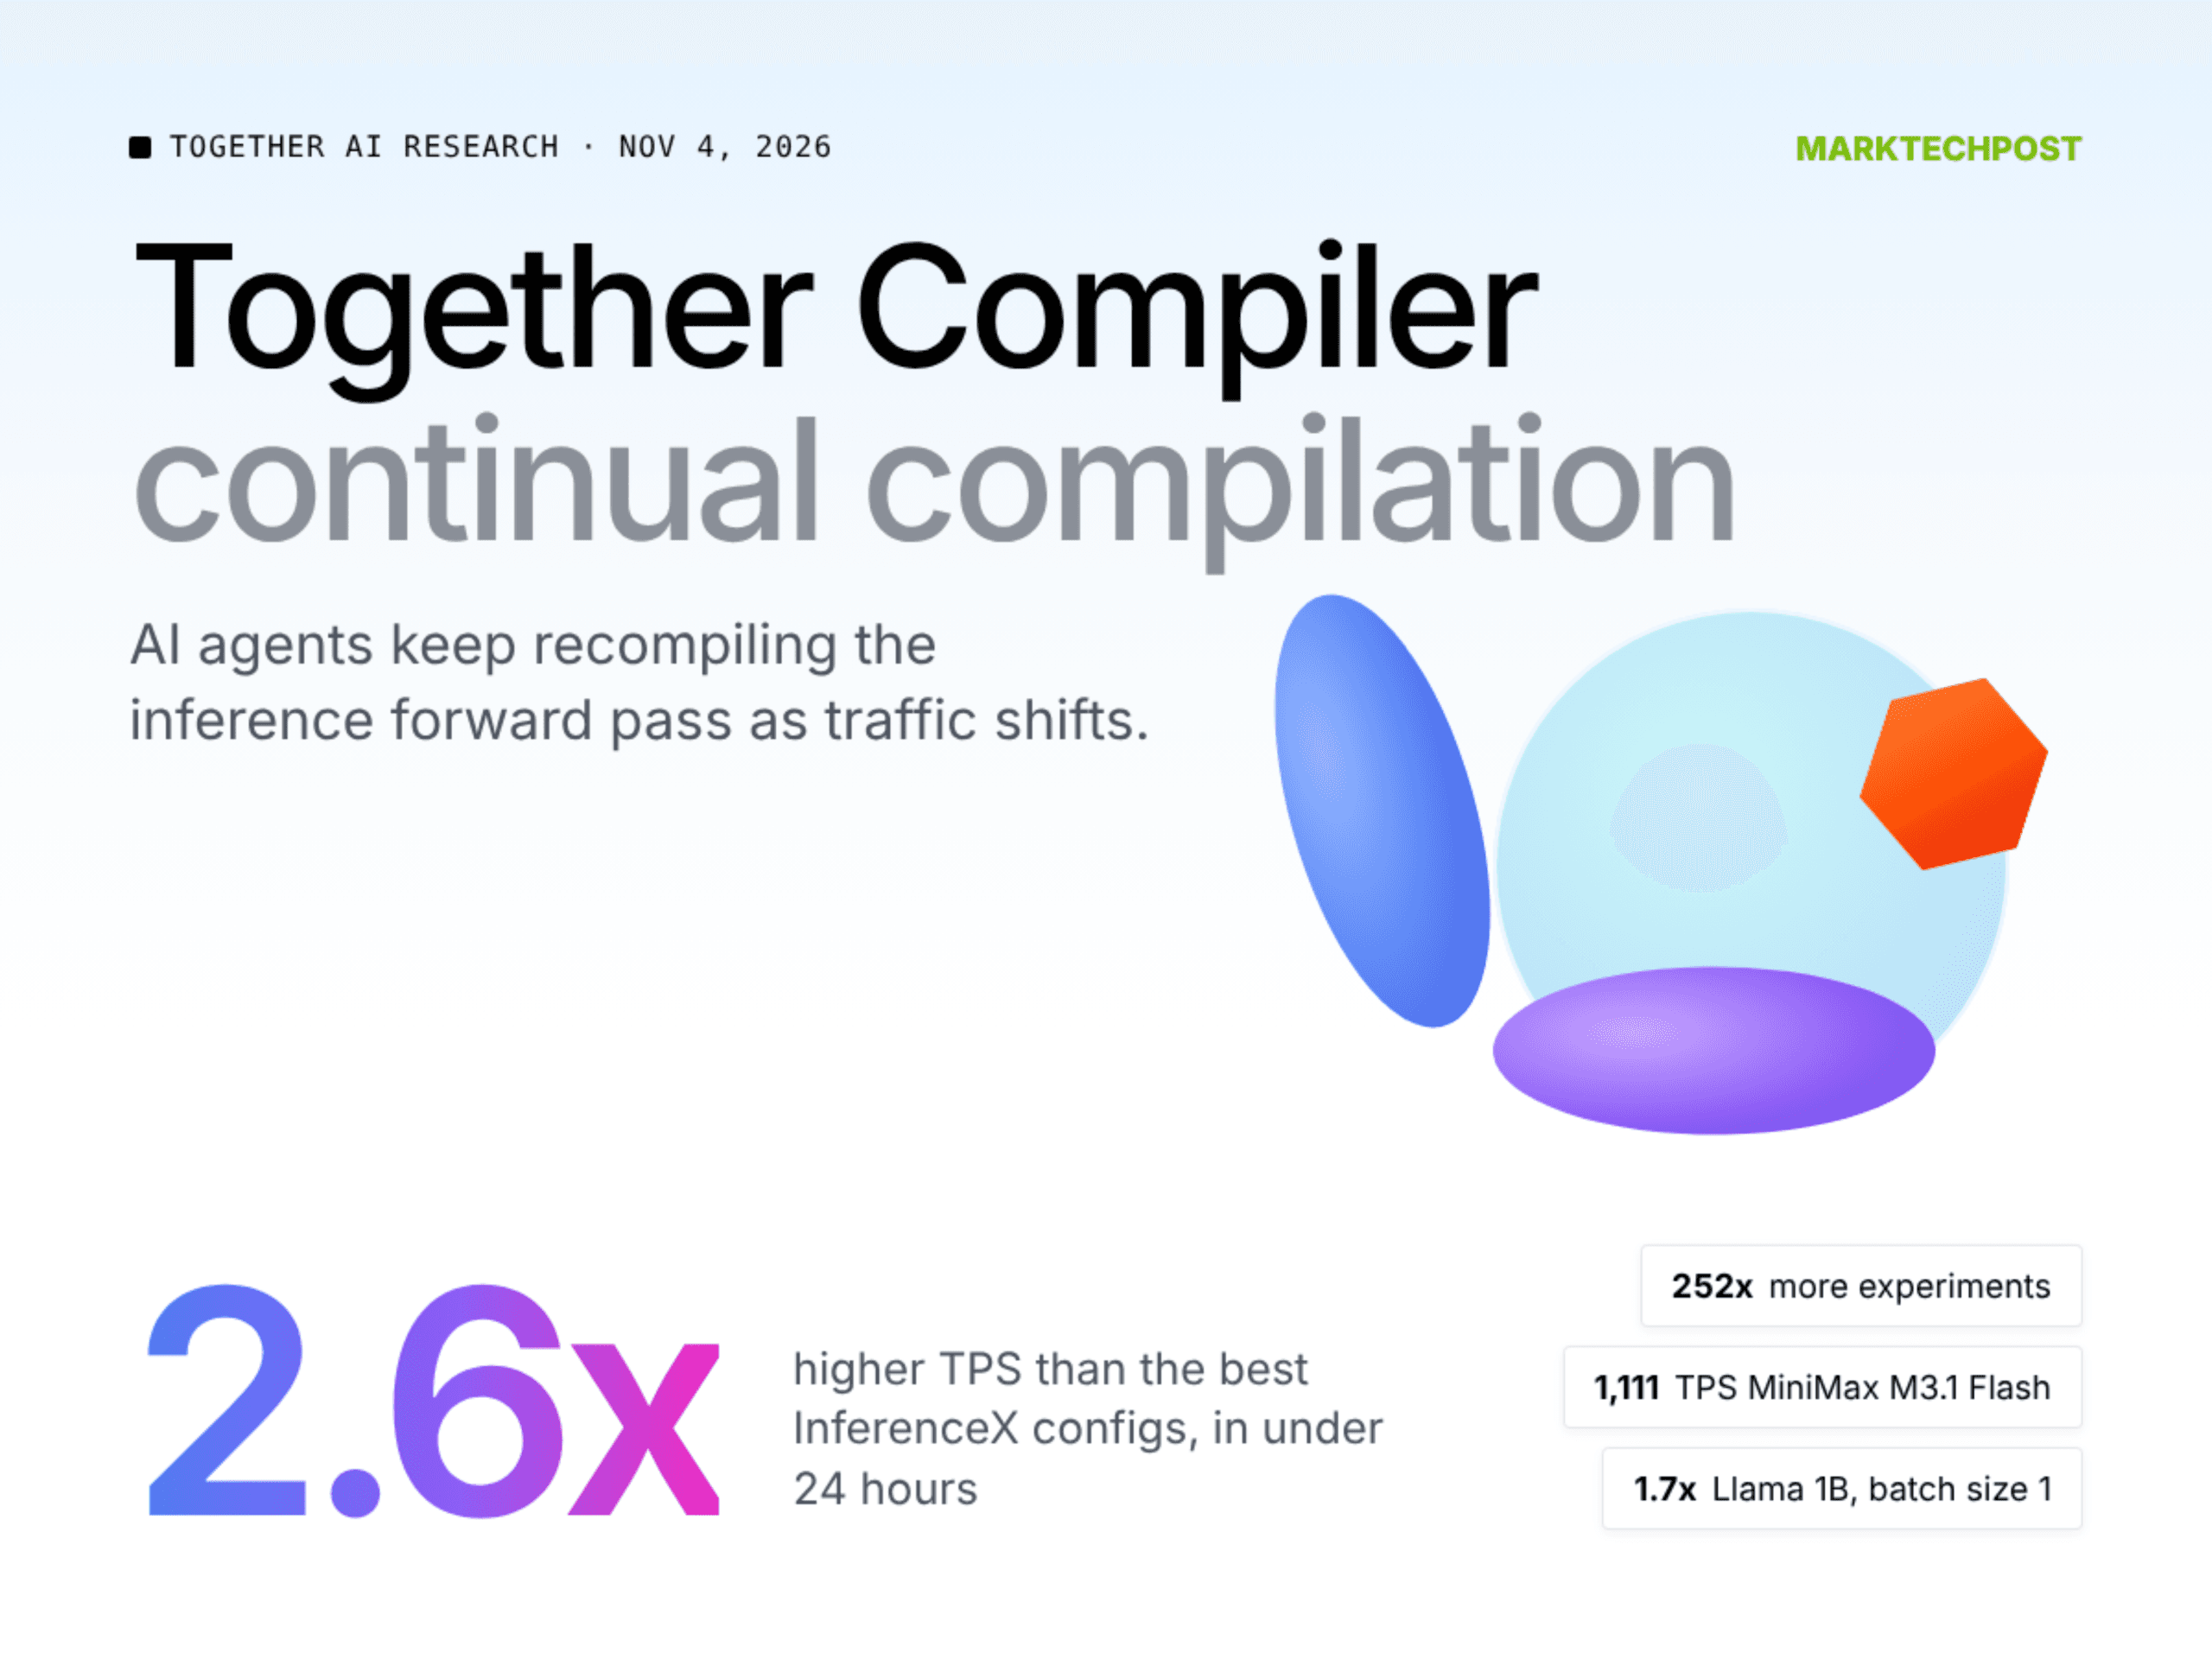
Together AI ได้เปิดตัว Together Compiler (TKCC) ระบบที่ขับเคลื่อนด้วย Agent ซึ่งทำหน้าที่ปรับแต่งกระบวนการ Inference อย่างต่อเนื่องตามการเปลี่ยนแปลงของ Traffic ในการใช้งานจริง โดยปัจจุบันได้เริ่มใช้งานแล้วบน Serverless Endpoint หลายแห่งของ Together AI เพื่อแก้ปัญหา Engine รุ่นเก่าที่ปรับแต่งเพียงครั้งเดียวซึ่งมักจะล้าสมัยอย่างรวดเร็ว
TL;DR
- ระบบ: เครื่องมือเพิ่มประสิทธิภาพที่ทดสอบกับ Kimi K3, GLM 5.3, MiniMax M3.1 Flash, DeepSeek v4.1 Flash และ Llama 1B
- ฮาร์ดแวร์: รองรับ NVIDIA B200, B300, GB300, H100, AMD MI355X และ AWS Trainium2 โดยใช้สูงสุดเพียง 2 Node ต่อโมเดล
- ประสิทธิภาพ: ทำความเร็ว (TPS) ได้สูงกว่าการกำหนดค่า InferenceX ที่ดีที่สุดถึง 2.6 เท่า ภายในเวลาไม่ถึง 24 ชั่วโมง
- ผลลัพธ์สูงสุด: ทำได้ 1,111 P90 TPS ต่อผู้ใช้บน MiniMax M3.1 Flash (B200) ซึ่งสูงกว่าค่ามาตรฐานถึง 1.8 เท่า
- ผลลัพธ์ต่ำสุด: GLM 5.3 บน MI355X มีประสิทธิภาพเพิ่มขึ้นจาก 463 เป็น 480 TPS (ประมาณ 4%)
Together Compiler คืออะไร?
Together Compiler คือวงจรการคอมไพล์แบบต่อเนื่องที่ใช้ Coding Agents ในการเขียน Forward Pass ของโมเดลขึ้นมาใหม่ โดยวิเคราะห์จากคำสั่ง Launch Server, Traffic Profile และการกำหนดค่าฮาร์ดแวร์ จากนั้น Agent จะเสนอวิธีการที่เร็วขึ้นผ่าน Engine ที่ทำงานค้างไว้ (Persistent Engine) เพื่อวัดผล และส่งโค้ดที่ชนะไปยัง Serving Engine ต่อไป
ทีม Together AI พบว่ารูปแบบ Traffic นั้นไม่เคยหยุดนิ่ง เช่น ความยาว Prompt ของลูกค้ารายหนึ่งเพิ่มจาก 18,000 เป็น 33,000 Token ในเวลาเพียง 3 วัน นอกจากนี้ การปรับแต่งด้วยข้อมูลแบบสุ่มอาจให้ผลลัพธ์ที่ผิดพลาด เนื่องจากข้อมูลจริงที่มี Context ยาวถึง 70,000 Token อาจใช้เวลาประมวลผลสูงถึง 62 ms ในขณะที่ข้อมูลสุ่มใช้เพียง 20 µs
นวัตกรรม Persistent Engine และการวัดผลสองระดับ
แทนที่จะเริ่มระบบใหม่ทุกครั้งที่ทดลอง Together Compiler ใช้ระบบ Persistent Engine ที่เริ่มทำงานเพียงครั้งเดียวและสลับ Function Pointer ผ่าน RPC ช่วยให้การทดสอบของ Agent เร็วขึ้นกว่าวิธีดั้งเดิมถึง 252 เท่า โดยมีการวัดผลสองระดับ (Two Measurement Tiers) ทั้งแบบเร็ว 12 Layer เพื่อคัดกรอง และแบบละเอียด 60 Layer บนข้อมูลจริง เพื่อสร้างสมดุลระหว่างความเร็วและความแม่นยำ
สำหรับการจัดการความขนาน ระบบใช้ Cost Model ในการจัดอันดับเลย์เอาต์ทั้งแบบ Tensor, Expert, Data และ Context โดยผสมผสานข้อมูลจาก Spec-sheet และการวัดผลจริง บนโมเดล Kimi K3 พบว่าการเลือกเลย์เอาต์ตามการใช้งานจริงช่วยให้ TPS สูงขึ้นถึง 24%
พลังของ Agent ที่เหนือกว่าความเชี่ยวชาญของมนุษย์
สิ่งที่น่าสนใจคือ Agent แบบพื้นฐาน (Naive Agents) ที่ได้รับคำสั่งให้ทำ Forward Pass ให้เร็วที่สุด สามารถเอาชนะกลยุทธ์ที่ดูแลโดยผู้เชี่ยวชาญที่เป็นมนุษย์ได้ โดยทำคะแนนรวมสูงกว่าถึง 6.2 เท่า เทียบกับ 4.9 เท่า ปัจจุบัน Together AI จึงเปิดให้ Agent เข้าถึง Source Code ของ Engine โดยตรงเพื่อให้ทำงานได้มีประสิทธิภาพสูงสุด
ในเวิร์กโหลด AgentX ของ SemiAnalysis InferenceX ระบบ Together Compiler สามารถเอาชนะการกำหนดค่าแบบเปิดที่ดีที่สุดได้สูงสุด 2.6 เท่า โดยในโมเดล Llama 1B ยังสามารถเอาชนะ Baseline ของ CUDA-graph ได้สูงสุด 1.7 เท่า และช่วยเร่งความเร็วโมเดลทางวิทยาศาสตร์ได้ตั้งแต่ 1.5 ถึง 6.4 เท่า โดยให้ผลลัพธ์ที่ถูกต้องแม่นยำระดับ Bit-exact
เปรียบเทียบกับระบบการปรับแต่งแบบ Agentic อื่นๆ
| หัวข้อ | Together Compiler | Cursor + NVIDIA multi-agent | AMD GEAK | Apple RSI-Inference Bench |
|---|---|---|---|---|
| ประเภท | Production optimization loop | Multi-agent kernel optimizer | Triton kernel agent framework | Benchmark สำหรับ coding agents |
| ขอบเขต | Full forward pass ใน serving engine | 235 standalone CUDA kernels | Individual Triton kernels | 37 tasks แก้ไข vLLM หรือ SGLang |
| ผลลัพธ์หลัก | สูงสุด 2.6x TPS เทียบกับ InferenceX best | 1.38x geomean | Speedup สูงสุด 2.59x | ให้คะแนน agent; ไม่มีผลลัพธ์เดี่ยว |
| งบประมาณเวลา | ต่ำกว่า 24 ชั่วโมงต่อการตั้งค่า | 3 สัปดาห์ | ไม่เปิดเผย | สูงสุด 8 ชั่วโมงต่อ task |
บทสรุปสำคัญคือ Together Compiler ช่วยให้การทำ Inference ก้าวข้ามขีดจำกัดเดิมด้วยการปรับแต่งอัตโนมัติที่รวดเร็วและแม่นยำตามการใช้งานจริง ช่วยลดภาระของวิศวกรและเพิ่มประสิทธิภาพฮาร์ดแวร์ให้ถึงขีดสุด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร