
Adaption Labs เปิดตัว ‘Invent a Dataset’ สร้างชุดข้อมูลเทรน AI จากคำอธิบาย โดยไม่ต้องมีข้อมูลตั้งต้น
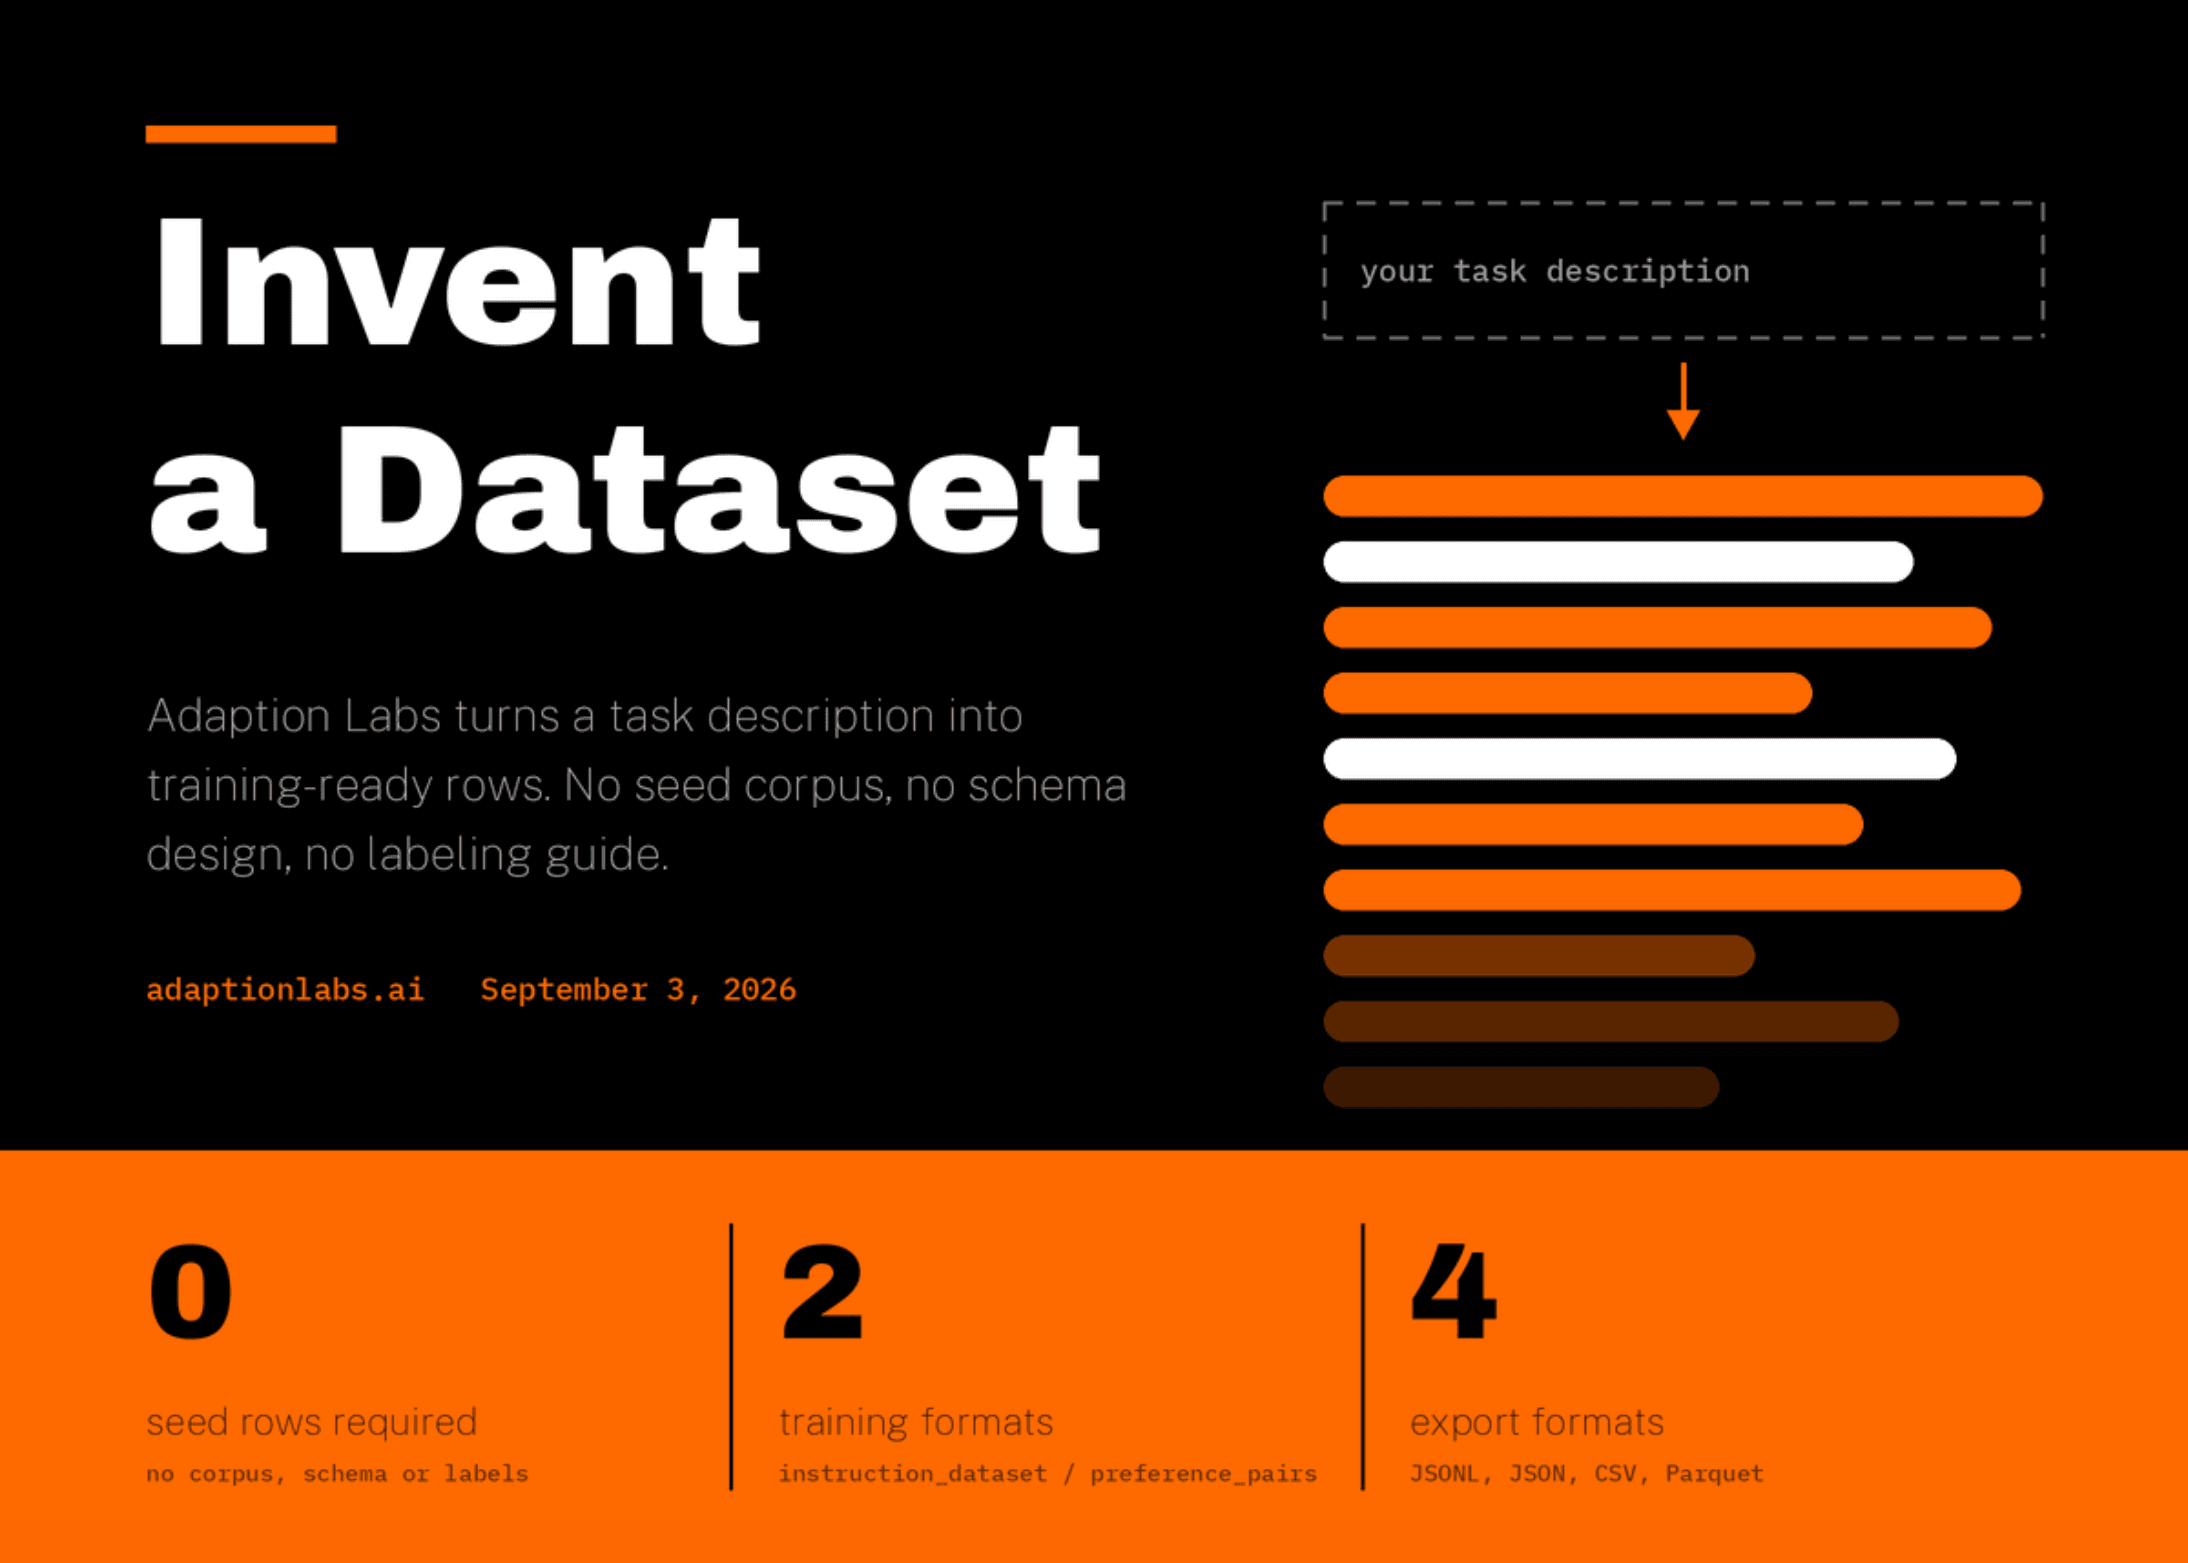
ในสัปดาห์นี้ Adaption Labs ได้เปิดตัว Invent a Dataset ฟีเจอร์ใหม่ที่สามารถสร้างชุดข้อมูลที่มีโครงสร้างและพร้อมสำหรับการเทรนได้โดยตรงจากคำอธิบายพฤติกรรมที่ต้องการให้โมเดลเรียนรู้ จุดเด่นคือผู้ใช้ไม่จำเป็นต้องมีคลังข้อมูลตั้งต้น (seed corpus) ไม่ต้องออกแบบ schema ล่วงหน้า หรือจัดทำคู่มือการทำ labeling ให้ยุ่งยาก
เครื่องมือนี้เปิดให้ใช้งานแล้วผ่านแอป Adaption รวมถึง Python SDK และ REST API โดยชุดข้อมูลที่สร้างขึ้นสามารถดาวน์โหลดได้ในรูปแบบไฟล์ JSONL, JSON, CSV หรือ Parquet ซึ่งผู้ใช้เป็นเจ้าของข้อมูลอย่างสมบูรณ์และนำไปเทรนต่อที่ไหนก็ได้ ทั้งนี้การประมวลผลจะทำงานบนแพลตฟอร์มของ Adaption โดยใช้ระบบเครดิต และยังไม่มีตัวเลือกแบบ self-hosted ในขณะนี้
ปัญหาที่กำลังมุ่งเป้าแก้ไข โดยปกติแล้ว เวิร์กโฟลว์การสร้างชุดข้อมูลมักเริ่มจากข้อมูลที่มีอยู่เดิม ซึ่งทีมงานต้องใช้เวลาหลายสัปดาห์ในการทำ labeling กรอง และปรับแต่งข้อมูลให้ตรงกับเป้าหมาย Adaption มองว่าแนวทางนี้จำกัดคุณภาพของโมเดลไว้เพียงแค่ความใกล้เคียงของข้อมูลที่มีอยู่เดิมเท่านั้น ซึ่งมักเป็นปัญหาสำหรับงานเฉพาะทางหรือข้อมูลความลับภายในองค์กรที่ยากจะเปลี่ยนเป็นชุดข้อมูลเทรนที่สมบูรณ์ได้
ทีมวิจัยได้สร้างความแตกต่างจากเครื่องมือสร้างข้อมูลสังเคราะห์ทั่วไปที่ต้องให้มนุษย์กำหนด schema และกลยุทธ์การสร้างก่อน แต่ Invent a Dataset เริ่มต้นจากระดับที่สูงกว่านั้น โดยเน้นที่ตัวพฤติกรรมเป้าหมายเป็นหลัก เพื่อข้ามขีดจำกัดของเครื่องมือแบบเดิม
วิธีการทำงานของ API
กลไกการทำงานของระบบถูกออกแบบให้เรียบง่ายผ่านการเรียกใช้ datasets.invent เพียงครั้งเดียวเพื่อเริ่มการผลิตข้อมูล โดยระบบจะส่งสถานะ running กลับมาทันที จากนั้นผู้ใช้เพียงแค่ตรวจสอบสถานะผ่าน datasets.get จนกว่าจะขึ้นว่า succeeded จึงจะสามารถดาวน์โหลดข้อมูลได้
การควบคุมเนื้อหาจะใช้รหัสโดเมน (Domain codes) เป็นหลัก ซึ่งผู้ใช้สามารถดึงรหัสล่าสุดได้จาก datasets.invent_domains เพื่อระบุขอบเขตงาน เช่น medical หรือเจาะจงลงไปที่ medical.symptoms_diagnosis โดยรองรับรูปแบบผลลัพธ์ทั้ง instruction_dataset สำหรับการทำ supervised fine-tuning และ preference_pairs สำหรับการเทรนแบบ DPO
สำหรับการใช้งานในระดับโปรดักชัน ระบบมีพารามิเตอร์สำคัญอย่าง estimate=True เพื่อประเมินราคาและเครดิตก่อนเริ่มงานจริง, prompt ที่รองรับคำอธิบายได้สูงสุด 10,000 ตัวอักษร และ idempotency_key เพื่อความปลอดภัยในการส่งคำขอซ้ำผ่านเครือข่าย โดยจำนวนแถวข้อมูลที่สร้างได้จะขึ้นอยู่กับแพ็กเกจที่เลือกใช้งาน
การขยายทางภาษาและท้องถิ่น
ระบบรองรับการขยายข้อมูลทางภาษาผ่าน language_expansion ใน 2 รูปแบบ คือ translate สำหรับการแปลเป็นภาษาเป้าหมาย และ localize ที่จะปรับเปลี่ยนถ้อยคำให้เหมาะสมกับวัฒนธรรมเฉพาะท้องถิ่นแทนการแปลตรงตัว โดยผู้ใช้สามารถควบคุมสัดส่วนการขยายข้อมูลได้ผ่าน sample_rate และระบบจะคิดเครดิตตามจำนวนแถวผลลัพธ์ที่เกิดขึ้นจริง
วงจรแบบ Zero-data
Invent a Dataset ถือเป็นจิ๊กซอว์ชิ้นแรกของวงจรการพัฒนา AI โดย ID ของชุดข้อมูลที่ได้สามารถส่งต่อไปยัง autoscientist.create ได้โดยตรง เพื่อเพิ่มประสิทธิภาพข้อมูลและสูตรการเทรนควบคู่กันไป ซึ่ง AutoScientist ที่เปิดตัวไปเมื่อเดือนพฤษภาคม 2026 เป็นส่วนงานหลักที่ดูแลด้านการเทรนแบบ Adaptive Data
จากรายงานของ Adaption พบว่า AutoScientist มีประสิทธิภาพเหนือกว่าการเทรนโดยเจ้าหน้าที่วิจัยถึง 35% โดยมีอัตราการชนะ (win rates) เพิ่มขึ้นจาก 48% เป็น 64% จากการทดสอบใน 8 กลุ่มอุตสาหกรรม บนชุดข้อมูลขนาด 5,000 ถึง 100,000 แถว ผ่านโครงสร้างพื้นฐานของ Together AI
ประเด็นสำคัญ
- Invent a Dataset สร้างข้อมูลสำหรับเทรน AI จากคำอธิบายงานโดยตรง ไม่ต้องมีข้อมูลตั้งต้นหรือการทำ label
- รองรับการทำงานแบบ async ผ่าน API เพียงคำสั่งเดียว ครอบคลุมทั้งการกำหนดโดเมนและภาษา
- ข้อมูลที่ได้พร้อมใช้งานในรูปแบบ instruction หรือ preference pairs และดาวน์โหลดได้หลายฟอร์แมต
- เชื่อมต่อกับ AutoScientist ได้ทันที เพื่อสร้างวงจรการพัฒนา AI ที่สมบูรณ์ตั้งแต่เริ่มต้นจนจบกระบวนการ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร