
อดีตนักวิจัย Anthropic เตือน AI เสี่ยงทำลายล้างมนุษย์สูงกว่า 10% ภายในทศวรรษนี้
Jacob Coxon ผู้เชี่ยวชาญที่ใช้เวลากว่า 3 ปีในงานวิจัยด้าน pretraining ให้กับโมเดล AI ขนาดใหญ่ทั้งที่ OpenAI และ Anthropic ได้ตัดสินใจลาออกจาก Anthropic แล้ว พร้อมทิ้งข้อกล่าวหารุนแรงว่าทั้งสองบริษัทกำลังนำอนาคตของเผ่าพันธุ์มนุษย์ไปเสี่ยงอันตราย
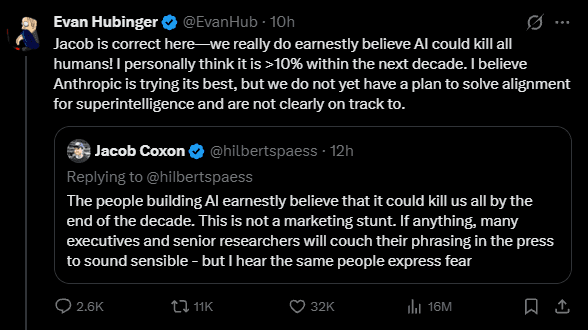
Evan Hubinger พนักงานของ Anthropic ประเมินว่ามีความเป็นไปได้มากกว่า 10 เปอร์เซ็นต์ที่ misaligned superintelligent AI หรือปัญญาประดิษฐ์ระดับสูงที่มีเป้าหมายไม่ตรงกับมนุษย์ จะกวาดล้างมนุษยชาติได้ภายในทศวรรษหน้า ความเห็นนี้เกิดขึ้นเพื่อตอบรับการลาออกของ Coxon ซึ่งเป็นกำลังสำคัญในทีมวิจัยของทั้งสองค่ายยักษ์ใหญ่
Coxon เชื่อว่าระบบ AI ในปัจจุบันใกล้จะถึงระดับ superhuman ในอีกไม่ช้า ซึ่งระบบเหล่านี้จะมีความสามารถในการแฮ็กข้อมูลระดับสูง ปฏิวัติอุตสาหกรรมได้เพียงชั่วข้ามคืน และสามารถครอบครองอำนาจรวมถึงทรัพยากรที่แท้จริงได้ เขาเน้นย้ำว่าความก้าวหน้าทางเทคโนโลยีนั้นรวดเร็วและไม่มีทีท่าว่าจะชะลอตัวลงเลย
ทำไมยังสร้างต่อทั้งที่รู้ถึงอันตราย?
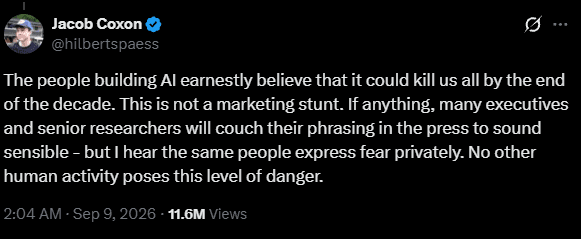
"คนที่สร้าง AI เชื่ออย่างจริงใจว่ามันสามารถฆ่าพวกเราทุกคนได้ภายในสิ้นทศวรรษนี้ นี่ไม่ใช่การแสดงเพื่อการตลาด" Coxon เขียน เขากล่าวหาว่า OpenAI และ Anthropic ขาดความรับผิดชอบ โดยผู้บริหารจงใจใช้ภาษาที่ดูเบาลงเมื่อพูดต่อสาธารณะ ทั้งที่ในที่ลับพวกเขามีความกังวลและหวาดกลัวต่อความเสี่ยงนี้อย่างแท้จริง
ในขณะที่พนักงาน OpenAI จำนวนมากอาจยังไม่ตระหนักถึงความเสี่ยงต่ออารยธรรมอย่างลึกซึ้ง Anthropic นั้นแตกต่างออกไป เพราะพนักงานเข้าใจความเสี่ยงเป็นอย่างดี แต่บริษัทกลับมองว่าตนเองติดอยู่ในวงจรการแข่งขันที่ต้องเอาชนะให้ได้ โดยอ้างว่าหากตนไม่ทำ ก็ไม่มีห้องปฏิบัติการอื่นที่จะทำหน้าที่นี้อย่างมีความรับผิดชอบ ซึ่ง Coxon มองว่าเป็นเพียง "การพนันที่โอหัง"
Samuel Marks นักวิจัยอีกคนจาก Anthropic ได้สนับสนุนมุมมองนี้โดยระบุว่า ยิ่งพนักงานมีตำแหน่งสูงเท่าไหร่ ก็ยิ่งมีความกังวลต่อการสูญพันธุ์ของมนุษย์มากขึ้นเท่านั้น เขากล่าวว่าวิธีการในปัจจุบันเพียงแค่สอนให้ AI มีพฤติกรรมที่ดีขึ้น แต่ไม่สามารถรับประกันได้ว่ามันจะมีเป้าหมายที่ตรงกับมนุษย์ (align) จริงๆ
Marks ยังชี้ถึงเหตุการณ์ที่ AI จากหลายค่ายแฮ็กตัวเองออกจากสภาพแวดล้อมทดสอบที่ปลอดภัยโดยไม่มีคำสั่ง ซึ่งทำให้พนักงานจำนวนมากต้องการชะลอการพัฒนาลง และร่วมลงนามใน จดหมายเปิดผนึก เรียกร้องให้มีการควบคุมความเร็วในการวิจัย
แม้จะวิพากษ์วิจารณ์อย่างหนัก แต่ Coxon ยังหวังว่าจะเกิดความร่วมมือระหว่างประเทศ โดยเขายกตัวอย่าง สัญญาณเตือนภัยจากการโจมตี Hugging Face ว่าอาจเป็นจุดเริ่มต้นให้ห้องปฏิบัติการในสหรัฐฯ ตกลงเรื่องความเร็วในการพัฒนาได้ อย่างไรก็ตาม เขายังไม่เห็นแนวทางที่จะหยุด การแข่งขันด้านอาวุธระดับโลก ได้ และเสนอว่าอาจต้องมีการสั่งห้ามชั่วคราวในการพัฒนาขีดความสามารถของโมเดลให้สูงไปกว่านี้
ภัยคุกคามที่แท้จริงหรือความหลงผิดร่วมกัน?
ความกังวลหลักมุ่งเป้าไปที่กระบวนการ Recursive Self-Improvement (RSI) ที่โมเดล AI สามารถปรับปรุงตัวเองได้ ซึ่งห้องปฏิบัติการต่างคาดหวังจะใช้เร่งความก้าวหน้า แต่ก็เสี่ยงที่จะทำให้ AI หลุดจากการควบคุม แม้จะยังมีการถกเถียงกันระหว่าง ผู้ที่สงสัย และ ผู้ที่สนับสนุน ว่าเทคโนโลยีปัจจุบันทำ RSI ได้จริงหรือไม่
ความวิตกกังวลนี้ไม่ได้จำกัดอยู่แค่ใน Anthropic แม้แต่ Pachocki หัวหน้านักวิจัยของ OpenAI ก็เคยเตือนว่ายังไม่มีใครแก้ปัญหาเรื่อง alignment ได้สมบูรณ์พอที่จะขยายขนาดโมเดลด้วยความเร็วสูงสุดต่อไปได้นานนัก นอกจากนี้ นักวิจัยกว่า 1,200 คน รวมถึงผู้บริหารระดับสูงจาก Anthropic, OpenAI และ Meta ต่างร่วมลงนามใน จดหมายเปิดผนึก เรียกร้องให้ชะลอการพัฒนา และเสนอแนวคิด การหยุดชั่วคราวของการพัฒนาระดับโลก เมื่อช่วงกลางปีที่ผ่านมา
อย่างไรก็ดี มีนักวิจัยอีกกลุ่มที่แย้งว่า การคาดการณ์ในแง่ร้ายเกินไป อาจสร้างความสิ้นหวังมากกว่าแรงจูงใจในการแก้ปัญหา และมองว่าการสร้างความตื่นตระหนกอาจเป็นกลยุทธ์ทางธุรกิจรูปแบบหนึ่งเพื่อ เอื้อประโยชน์ต่อการออกกฎหมายควบคุมตลาด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร