
Baidu เปิดตัว Unlimited OCR 2 โมเดลโอเพนซอร์สประมวลเอกสารยาว
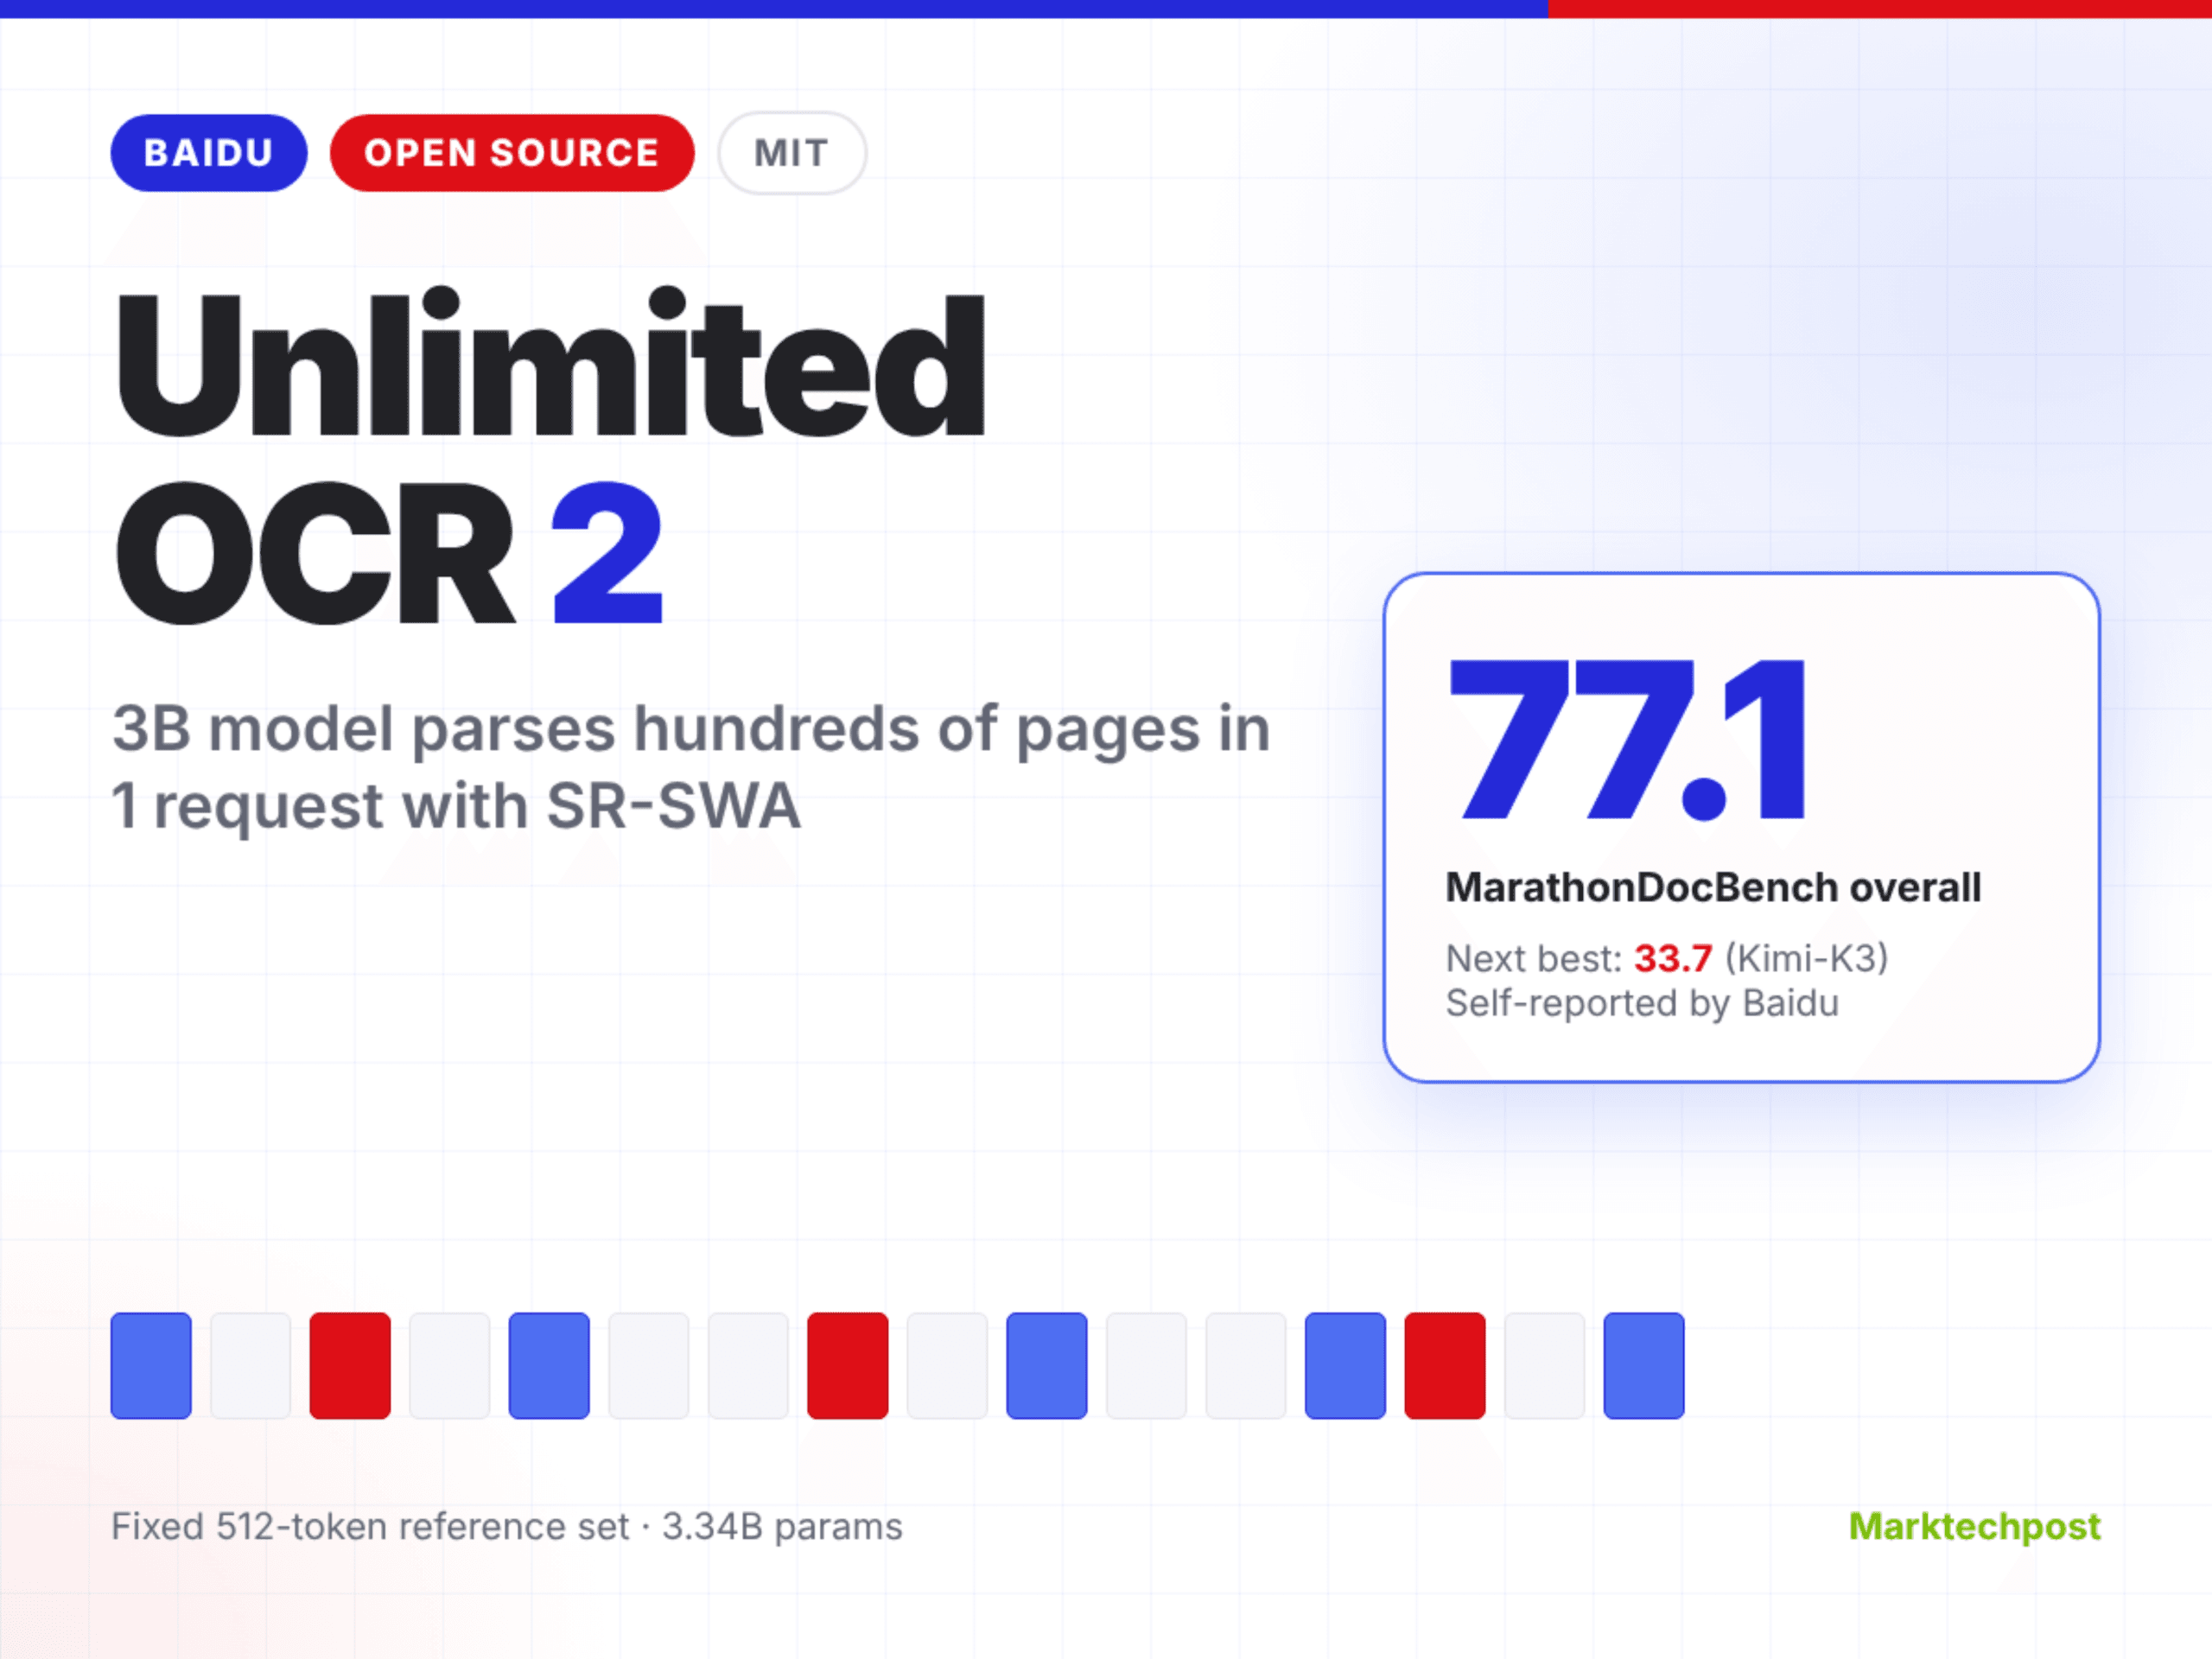
Baidu เปิดตัว Unlimited OCR 2 โมเดล OCR แบบโอเพนซอร์สที่ออกแบบมาเพื่อจัดการเอกสารที่มีความยาวมากเป็นพิเศษ โดยโมเดลขนาด 3B นี้สามารถประมวลผลทั้งหนังสือ เอกสารราชการ และรายงานที่มีความยาวหลายร้อยหน้าได้ในการส่งคำขอเพียงครั้งเดียว
หัวใจสำคัญของการพัฒนาคือการใช้ SR-SWA ซึ่งเป็นรูปแบบ sparse attention ที่ช่วยให้ค่าใช้จ่ายในการถอดรหัส (decoding cost) ต่อขั้นตอนเกือบจะคงที่ โดย Baidu ได้ปล่อยค่าน้ำหนัก (weights) ภายใต้ใบอนุญาต MIT พร้อมเปิดเผยรหัสต้นฉบับบน GitHub
TL;DR
- ขนาด: พารามิเตอร์รวม 3.34B (ไม่ระบุจำนวนพารามิเตอร์ที่ใช้งานจริง) รองรับความยาวตำแหน่งสูงสุด (Max position length) ที่ 131,072 tokens
- การใช้งาน: รันบน 1 CUDA GPU ในรูปแบบ BF16 โดยทดสอบบน NVIDIA A800-80GB ใช้ขนาด weights รวมประมาณ 6.7 GB
- ประสิทธิภาพ: ครองอันดับหนึ่งในเกณฑ์มาตรฐานเอกสารหลายหน้า (multi-page benchmarks) ทั้งสองรายการจากการทดสอบเปรียบเทียบกับโมเดลอื่น 9 รุ่น
- จุดแข็ง: ทำคะแนนรวมได้สูงถึง 77.1 บน MarathonDocBench สำหรับเอกสารหลายร้อยหน้า ทิ้งห่าง Kimi-K3 ที่ได้ 33.7
- จุดอ่อน: ได้คะแนนด้านลำดับชั้นหัวข้อ (heading hierarchy) (TEDS) บน MarathonDocBench เพียง 48.2 ซึ่งเป็นคะแนนย่อยที่ต่ำที่สุด
Unlimited OCR 2 คืออะไร?
Unlimited OCR 2 คือโมเดล vision-language ขนาด 3B จาก Baidu ที่สามารถแปลงภาพหน้าเอกสารที่เรียงลำดับแล้วให้กลายเป็นข้อความที่มีโครงสร้าง ครอบคลุมทั้งข้อความ ตาราง สูตร รูปภาพ หัวข้อ และลำดับการอ่าน
โมเดลนี้เป็นรุ่นต่อยอดจาก Unlimited-OCR ที่ปล่อยออกมาในเดือนมิถุนายน 2026 เพื่อพัฒนาความสามารถของ DeepSeek-OCR ให้สูงขึ้น โดยยังคงโครงสร้างเลย์เอาต์สไตล์ DeepSeek-OCR ที่ใช้ตัวเข้ารหัส SAM ViT-B ร่วมกับ CLIP-L ส่งข้อมูลไปยังตัวถอดรหัส mixture-of-experts ขนาด 12 เลเยอร์ ในโหมดหลายหน้า แต่ละหน้าจะใช้ 273 image tokens
กลไกการทำงานของ SR-SWA โดยปกติแล้วต้นทุนของ full attention จะเพิ่มขึ้นเป็นทวีคูณตามความยาวของลำดับข้อมูล ซึ่งในเอกสาร 100 หน้า จะมี input tokens สูงถึง 27,300 tokens ก่อนที่จะเริ่มประมวลผลผลลัพธ์ ทำให้เกิดภาระต่อหน่วยความจำอย่างมหาศาล
SR-SWA หรือ Sparse Reference Sliding Window Attention เข้ามาแก้ปัญหานี้ด้วยการบีบอัด text-visual attention ให้เหลือเพียงชุดข้อมูลอ้างอิงสำหรับการทำงาน (working references) ที่คงที่เพียง 512 tokens ช่วยให้ความหน่วง (latency) และการใช้หน่วยความจำเกือบจะคงที่แม้เอกสารจะยาวขึ้น ซึ่ง Baidu เรียกสิ่งนี้ว่าการประมวลผลแบบ ‘unlimited-horizon’
ผลการทดสอบบน MPDocBench และ MarathonDocBench
ทีมพัฒนาได้ทดสอบบน MPDocBench (เอกสารหลายสิบหน้า) และ MarathonDocBench (เอกสารหลายร้อยหน้า) พบว่า Unlimited OCR 2 ทำคะแนนได้ 84.6 บน MPDocBench นำหน้า Qwen3.8-Max และ Gemini-3.8-Flash อย่างมีนัยสำคัญ
ประเด็นที่น่าสนใจคือความเสถียรของโมเดล โดยขณะที่โมเดลคู่แข่งอย่าง Qwen3.8-Max มีคะแนนตกลงจาก 78.3 เหลือเพียง 22.9 เมื่อต้องประมวลผลเอกสารร้อยหน้า แต่ Unlimited OCR 2 กลับมีคะแนนลดลงเพียงเล็กน้อยเท่านั้น
คะแนนย่อย (MPDocBench / MarathonDocBench):
- ข้อความ: 94.8 / 89.6
- สูตร: 89.4 / 87.9
- ลำดับการอ่าน: 92.3 / 85.3
- ตาราง: 87.8 / 74.8
- ลำดับชั้นหัวข้อ: 60.1 / 48.2
การใช้งาน Unlimited OCR 2
ผู้ใช้สามารถรันโมเดลผ่าน Transformers สำหรับการทดสอบเบื้องต้น และใช้ SGLang สำหรับการใช้งานจริง (serving) โดยใน Transformers จะมีฟังก์ชัน infer สำหรับประมวลผลทีละหน้า และ infer_multi สำหรับประมวลผลทั้งเอกสารในคำขอเดียวเพื่อให้รักษาบริบทข้ามหน้าได้
สำหรับการใช้งานผ่าน SGLang จะต้องใช้ wheel รุ่นปรับแต่งเฉพาะจาก Baidu ซึ่งมีการกำหนดตารางเวลา 10 หน้าต่อหน้าต่าง (window) เพื่อลดการใช้หน่วยความจำสูงสุด อย่างไรก็ตาม Baidu เตือนว่าควรระวังเรื่องการจัดสรรหน่วยความจำที่อาจทำให้หน่วยความจำเต็มได้หากตั้งค่าไม่เหมาะสม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร