
เทคนิคจัดกลุ่มตามความยาว เพิ่มประสิทธิภาพ SLM แทนการวนลูป
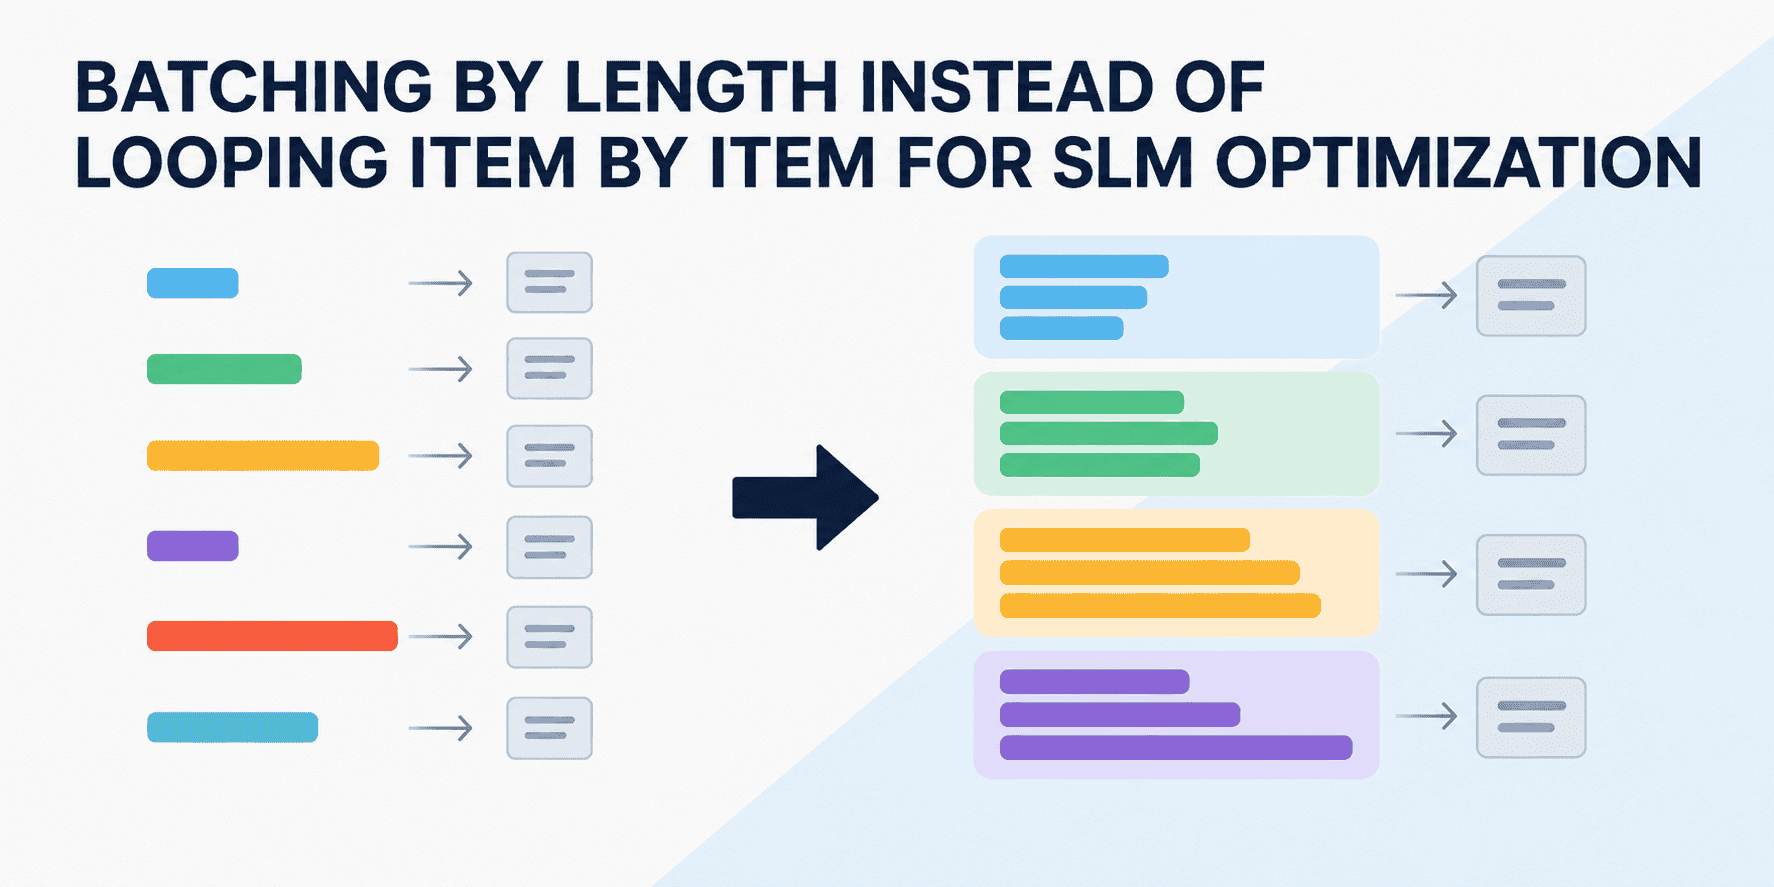
บทความก่อนหน้านี้ในซีรีส์ได้นำเสนอเรื่อง การจำกัดพื้นที่ผลลัพธ์ (constraining output space) และ การใช้พรอมต์ส่วนหน้าซ้ำด้วย key-value cache ซึ่งเป็นแนวทางเพิ่มประสิทธิภาพงานอัตโนมัติเฉพาะทางของแบบจำลองภาษาขนาดเล็ก (small language model หรือ SLM) สำหรับบทความที่สามนี้จะมาปิดท้ายซีรีส์ด้วยเทคนิคการประมวลผลแบบกลุ่ม (batching) ตามความยาว แทนการวนลูปประมวลผลทีละรายการ
การทดสอบประสิทธิภาพ (benchmark) ทั้งหมดในบทความนี้ยังคงใช้โมเดล Qwen2.5-0.5B-Instruct ในรูปแบบ float16 ผ่าน Hugging Face Transformers โดยรันบน M2 Macbook Air (RAM 24GB และ Neural Engine แบบ 16-core)
ก่อนเริ่มทำงาน อย่าลืมตั้งค่าสภาพแวดล้อม Python และติดตั้งแพ็กเกจที่จำเป็นดังนี้:
pip install torch transformers accelerateเราจะยังคงใช้กรอบการทำงานในเรื่องตั๋วสนับสนุน (support ticket) จากบทความแรกของเรา
ทำไมต้องประมวลผลแบบกลุ่มตามความยาวแทนที่จะวนลูปทีละรายการ
การประมวลผลตั๋วสนับสนุนทีละใบต่อการส่งต่อข้อมูลหนึ่งรอบ (forward pass) คือจุดที่ทำให้สูญเสียประสิทธิภาพมากที่สุด เนื่องจากที่ขนาดกลุ่ม (batch size) เท่ากับ 1 โมเดลขนาดเล็กจะถูกจำกัดด้วยแบนด์วิดท์ของหน่วยความจำ (memory-bandwidth bound) มากกว่าพลังการประมวลผล (compute-bound)
ลักษณะดังกล่าวทำให้ฮาร์ดแวร์ต้องดึงค่าน้ำหนัก (weight) ทั้งหมดออกจากหน่วยความจำเพื่อประมวลผลทีละลำดับ (sequence) แล้วจึงเริ่มกระบวนการเดิมใหม่กับลำดับถัดไป ส่งผลให้หน่วยคำนวณทางคณิตศาสตร์ส่วนใหญ่ถูกปล่อยให้ว่างอยู่เฉยๆ ซึ่งปัญหานี้เกิดขึ้นทั้งบน GPU และ CPU โดยเฉพาะ CPU บนเครื่องคอมพิวเตอร์ทั่วไปที่เป็นฮาร์ดแวร์หลักในการรันโมเดลขนาด 0.5B ในความเป็นจริง
การประมวลผลแบบกลุ่มช่วยเฉลี่ยค่าใช้จ่ายในการอ่านค่าน้ำหนักไปยังหลายลำดับได้ แต่การใช้งานทั่วไปก็ยังสร้างความสูญเปล่า เนื่องจากสมาชิกร่วมกลุ่มต้องถูกเติมข้อความ (padding) ให้ยาวเท่ากัน ขณะที่ข้อความในโลกจริงมักมีลักษณะแบบหางยาว (long tail) คือมีข้อความส่วนน้อยที่ยาวมาก แต่ส่วนใหญ่จะสั้นกว่ามาก หากเราเติม padding ให้ทุกกลุ่มยาวเท่ากับค่าสูงสุด (global maximum) จะทำให้ทรัพยากรส่วนใหญ่สูญไปกับการคำนวณ padding
วิธีแก้ปัญหาคือการ จัดเรียงตามความยาวโทเคน (sort by token length) ก่อนจะแบ่งกลุ่ม เพื่อให้แต่ละกลุ่มมีขนาดข้อความใกล้เคียงกัน และเติม padding เท่าที่จำเป็นตามความยาวสูงสุดเฉพาะกลุ่มนั้นๆ (local maximum) เท่านั้น
การวนลูปทีละรายการ
ด้านล่างนี้คือโค้ดเปรียบเทียบมาตรฐาน (baseline) แบบประมวลผลทีละรายการบนฐานข้อมูลที่มีความยาวสมจริง โดยใช้ร่วมกับการจำกัดพื้นที่ผลลัพธ์ (constrained scoring) จากบทความแรกในซีรีส์ เพื่อให้แต่ละรายการใช้ค่าใช้จ่ายเท่ากับหนึ่ง forward pass พอดี:
import os
import time
import inspect
import torch
import numpy as np
from transformers import AutoTokenizer, AutoModelForCausalLM

MODEL_ID =ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร