
Perplexity พัฒนา AI Agent ฝึกฝนผ่านข้อผิดพลาดของผู้ใช้งานจริง
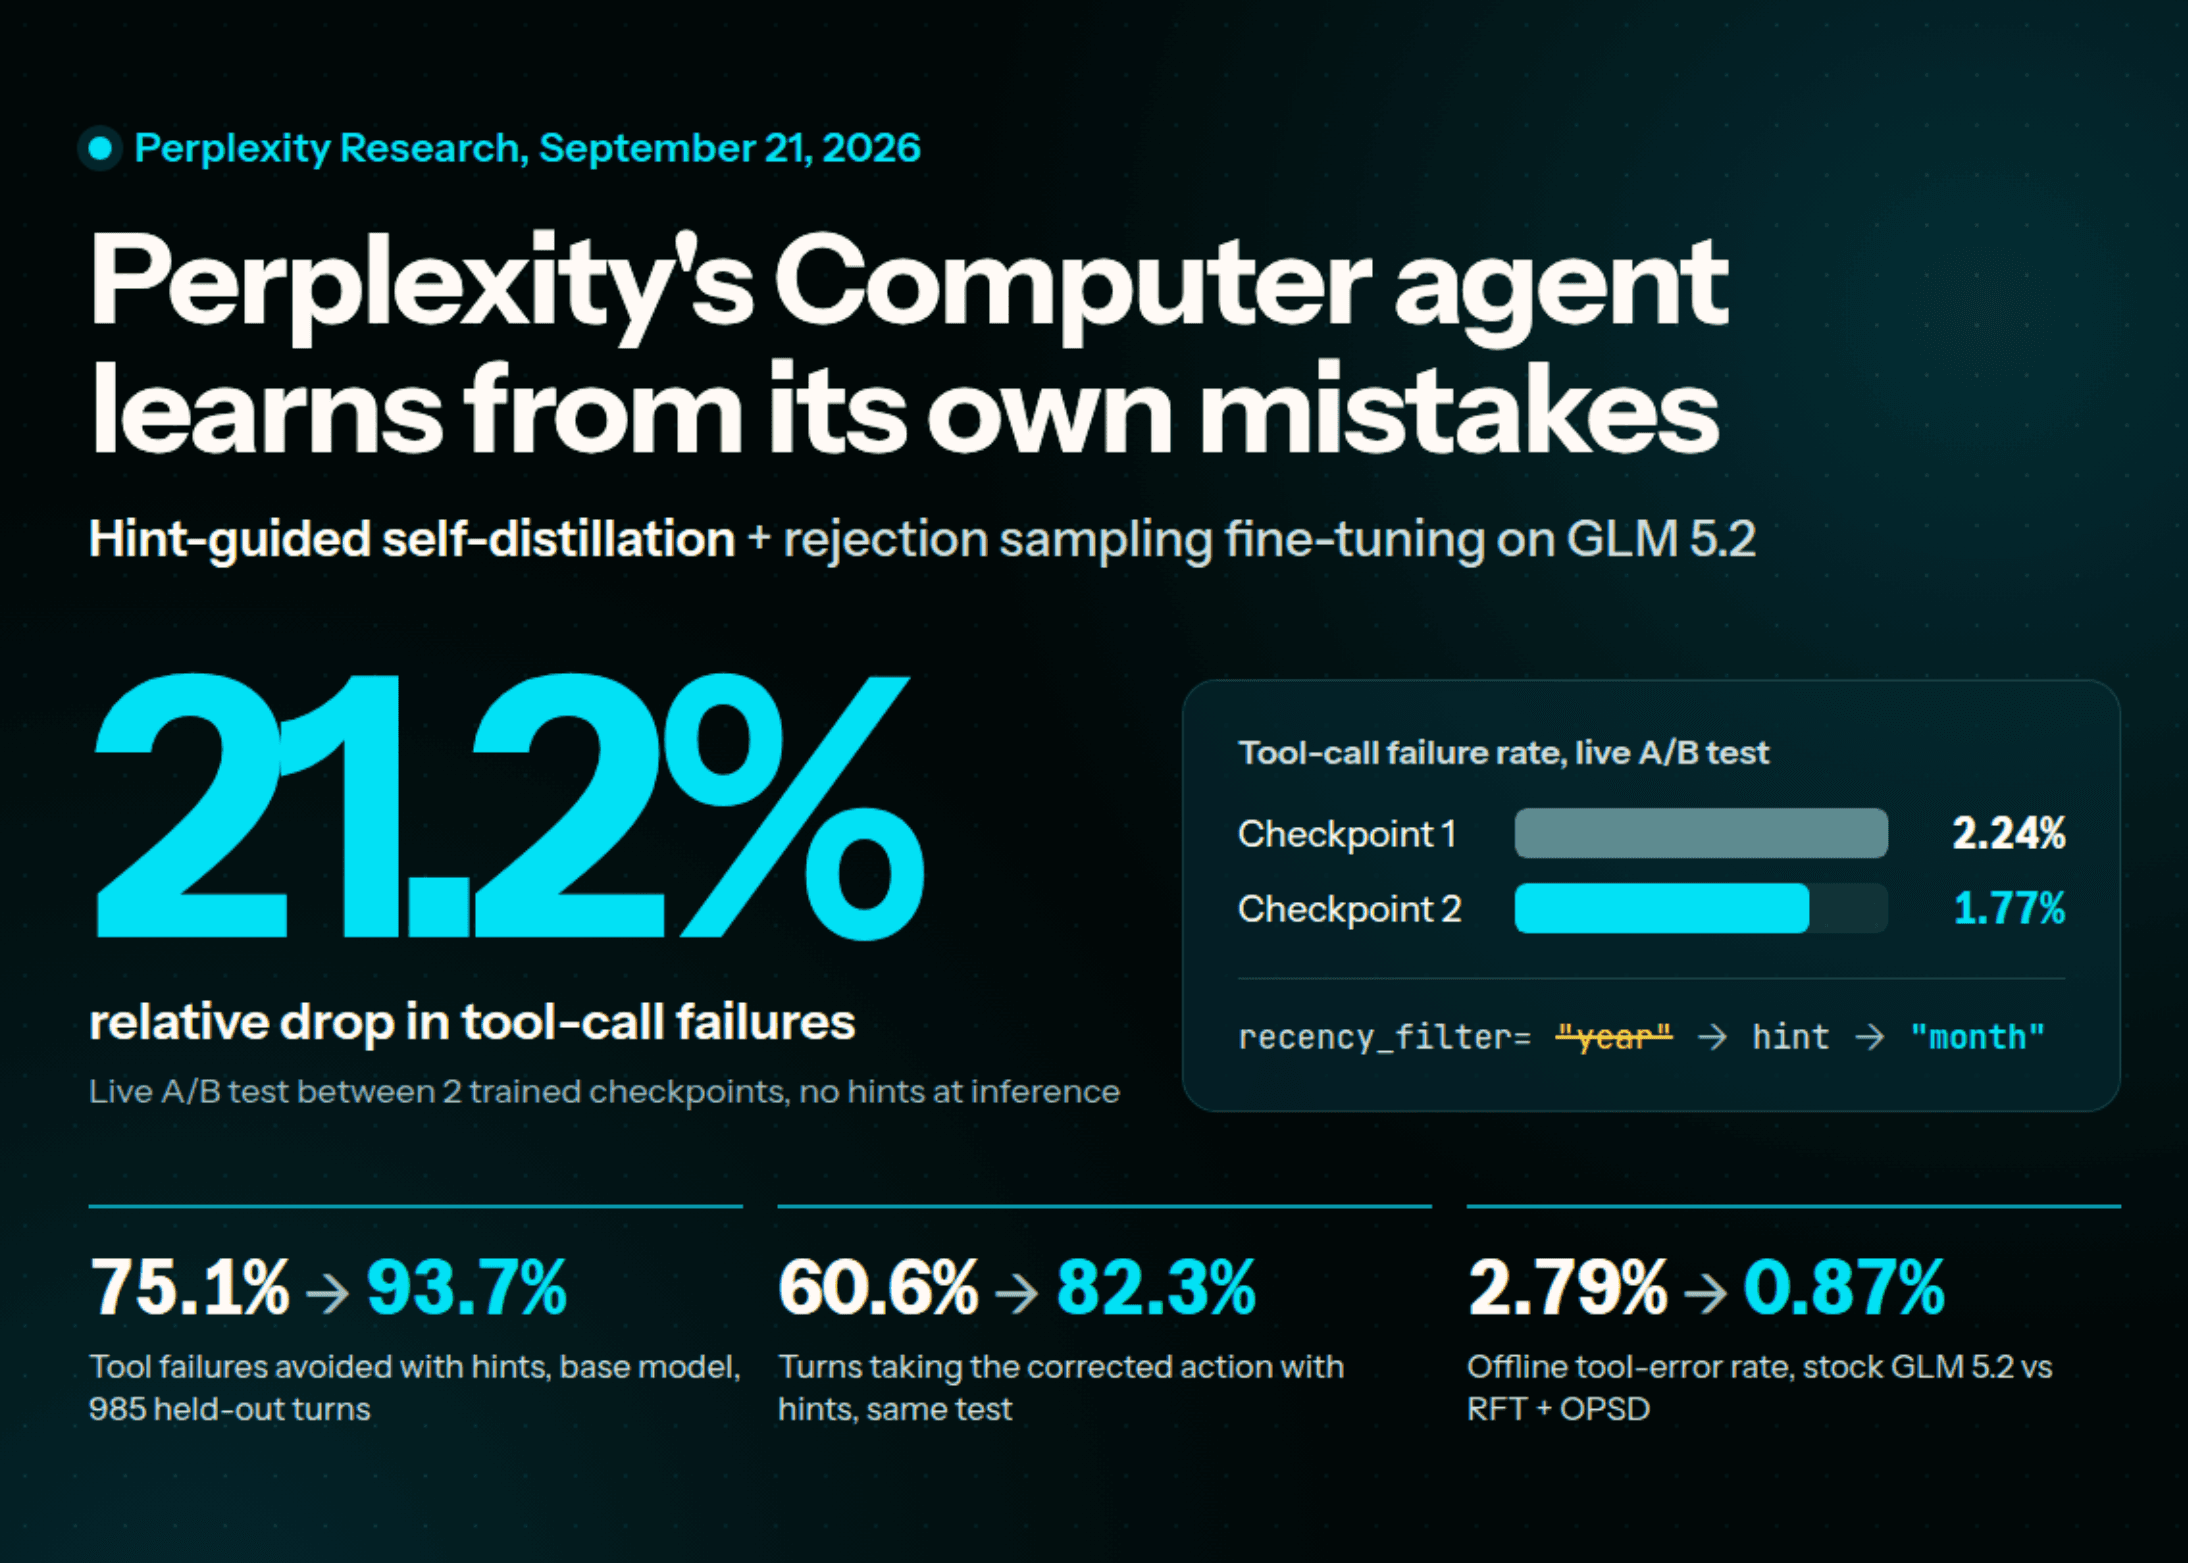
Perplexity Research published a new post-training study เปิดเผยผลการศึกษาการฝึกฝนโมเดลภายใน Perplexity Computer โดยใช้ข้อมูลจากเซสชันผู้ใช้งานจริง รวมถึงกรณีที่เกิดความผิดพลาด
วิธีการนี้ใช้วิธีการจับคู่ระหว่าง rejection sampling fine-tuning เข้ากับ hint-guided self-distillation จากการทดสอบ A/B test แบบสด พบว่าอัตราความล้มเหลวในการเรียกใช้เครื่องมือ (tool-call) ลดลงจาก 2.24% เหลือ 1.77% ระหว่างจุดตรวจสอบการฝึก 2 จุด ซึ่งทีมวิจัยระบุว่าเป็นการลดลงเชิงสัมพัทธ์ที่ 21.2% อย่างมีนัยสำคัญทางสถิติ
อย่างไรก็ตาม โมเดลนี้ยังไม่สามารถนำไปใช้งานได้โดยตรง เนื่องจาก Perplexity ยังไม่ได้ปล่อยน้ำหนักโมเดล (weights) หรือรหัสสำหรับการฝึกออกมา โดยปัจจุบันรันเป็นเพียงตัวเลือกโมเดลภายใน Perplexity Computer เท่านั้น สำหรับโมเดลฐานที่ใช้คือ GLM 5.2 ซึ่งมีให้ใช้งานแบบเปิดบน Hugging Face
ทำไมการกรองเฉพาะผลลัพธ์ (Outcome-Only Filtering) ถึงยังไม่เพียงพอ โดยปกติแล้วมาตรฐานของ rejection sampling fine-tuning (RFT) จะตัดสินแต่ละเซสชันและเลียนแบบเฉพาะเซสชันที่สำเร็จเท่านั้น แต่ในความเป็นจริง ผลลัพธ์ที่สำเร็จไม่ได้หมายความว่าทุกขั้นตอนจะถูกต้องเสมอไป
Agent อาจกู้คืนจากการเรียกใช้เครื่องมือที่ผิดพลาดในระหว่างทางจนให้คำตอบที่ถูกต้องได้ ซึ่งการเลียนแบบเส้นทาง (trajectory) ทั้งหมดนั้นอาจเป็นการตอกย้ำข้อผิดพลาดเดิม ในขณะเดียวกัน การทิ้งเซสชันที่ล้มเหลวก็เท่ากับการทิ้งหลักฐานสำคัญของความผิดพลาดที่สามารถหลีกเลี่ยงได้ในอนาคต
เลียนแบบ, แก้ไข หรือเก็บไว้เป็นบริบท
ทีม Perplexity ได้แยกการตัดสินใจออกเป็น 2 ส่วน คือการคัดเลือกเซสชันที่มีพฤติกรรมควรค่าแก่การเลียนแบบ และการระบุเทิร์น (turn) ที่มีข้อผิดพลาดซึ่งจำเป็นต้องได้รับการแก้ไข โดยในแต่ละเทิร์นจะถูกจัดการด้วย 1 ใน 3 วิธี ดังนี้:
- Imitate (เลียนแบบ): ใช้กับเทิร์นที่ไม่เกิดข้อผิดพลาดในเซสชันที่สำเร็จ โดยจะได้รับ cross-entropy (CE) loss
- Correct (แก้ไข): ใช้กับเทิร์นที่เกิดข้อผิดพลาดพร้อมมีคำใบ้ (hint) ที่ผ่านการตรวจสอบแล้ว จะได้รับ Kullback-Leibler (KL) divergence loss
- Keep as context (เก็บไว้เป็นบริบท): เทิร์นที่เหลือจะถูกคงไว้ในอินพุตเพื่อให้บริบท แต่จะไม่ได้รับ loss ใดๆ
คำใบ้ (Hint) กลายเป็นสัญญาณการฝึกฝนได้อย่างไร
คำใบ้คือคำสั่งแก้ไขสั้นๆ ที่อ้างอิงจากข้อมูลเดิมที่โมเดลมีอยู่แล้ว เช่น หากโมเดลเรียกใช้การค้นหาโดยตั้งค่าตัวกรองผิดประเภท คำใบ้จะระบุจุดที่พลาดและแนะนำค่าที่ถูกต้องให้ทันที
กระบวนการแก้ไขจะใช้เทคนิค On-Policy Self-Distillation (OPSD) โดยให้โมเดล GLM 5.2 ตัวเดียวกันทำงานสองรอบ รอบแรกเป็น "อาจารย์" ที่เห็นคำใบ้ และรอบที่สองเป็น "นักเรียน" ที่ไม่เห็นคำใบ้ เพื่อให้โมเดลเรียนรู้เป้าหมายที่ถูกต้องผ่านค่าความน่าจะเป็นของโทเค็นถัดไป
การตามรอยคำร้องเรียนไปสู่ความผิดพลาดที่แท้จริง
ระบบจะดึงข้อมูลจากเซสชันที่ใช้งานจริง โดยคัดกรองข้อมูลส่วนบุคคลออกและใช้ LLM ตัดสินความยากของงาน ในกรณีที่มีข้อร้องเรียนจากผู้ใช้ LLM จะระบุเทิร์นที่เป็นต้นเหตุของปัญหา ซึ่งมักจะไม่ใช่แค่เทิร์นสุดท้ายก่อนมีการร้องเรียนเสมอไป
ตัวอย่างเช่น เมื่อผู้ใช้ขอข้อมูล 'w3' แต่โมเดลทึกทักว่าเป็นคำผิดและไปค้นหา 'W-2' แทน คำใบ้จะมุ่งเป้าไปที่การแก้ไขการตีความที่ผิดพลาดตั้งแต่จุดเริ่มต้น ไม่ใช่แค่การแก้คำตอบสุดท้ายให้ถูกเท่านั้น
Interactive Explainer
ผลการประเมินแสดงอะไรบ้าง
ผลการทดสอบชี้ให้เห็นว่าโมเดลฐานสามารถหลีกเลี่ยงความล้มเหลวเดิมได้ถึง 93.7% เมื่อมีคำใบ้ นอกจากนี้ อัตราข้อผิดพลาดของเครื่องมือแบบออฟไลน์ยังลดลงอย่างต่อเนื่อง โดยรุ่นที่ใช้ RFT ร่วมกับ OPSD มีอัตราผิดพลาดต่ำสุดเพียง 0.87%
สำหรับการใช้งานจริงในรูปแบบ A/B test กับผู้ใช้กว่า 100,000 ราย พบว่าความล้มเหลวลดลงอย่างมีนัยสำคัญเมื่อใช้จุดตรวจสอบรุ่นล่าสุด แม้ว่าคะแนนความไม่พอใจของผู้ใช้จะยังไม่เปลี่ยนแปลงอย่างชัดเจนนัก แต่ Perplexity ถือว่าความสำเร็จในการลดความล้มเหลวของเครื่องมือเป็นก้าวสำคัญของการพัฒนา Computer Agent ต่อไป
ประเด็นสำคัญ
- Perplexity เรียนรู้จากเซสชันที่ล้มเหลวเพื่อปิดจุดอ่อนของโมเดล
- ใช้คำใบ้ที่ผ่านการตรวจสอบเพื่อเปลี่ยนข้อผิดพลาดให้เป็นเป้าหมายการแก้ไขแบบ KL
- ใช้โมเดลเดียวทำหน้าที่เป็นทั้งอาจารย์และนักเรียนในการฝึกฝน
- ลดความล้มเหลวในการเรียกใช้เครื่องมือขณะใช้งานจริงลงได้ 21.2%
- ชุดทดสอบมาตรฐานอย่าง BrowseComp และ SpreadsheetBench ให้ผลลัพธ์ที่หลากหลาย
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร