
ทดสอบ Qwen 3.8 27B บน RTX 5090 พบปัญหาคอขวดซอฟต์แวร์รุนแรง
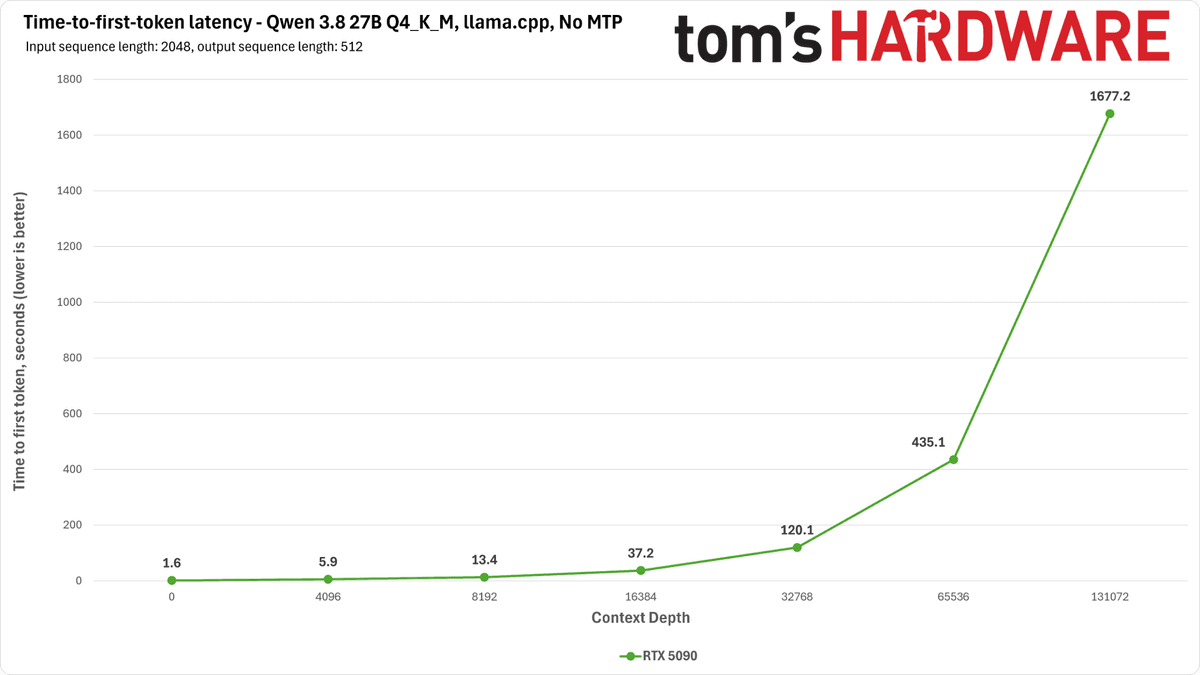
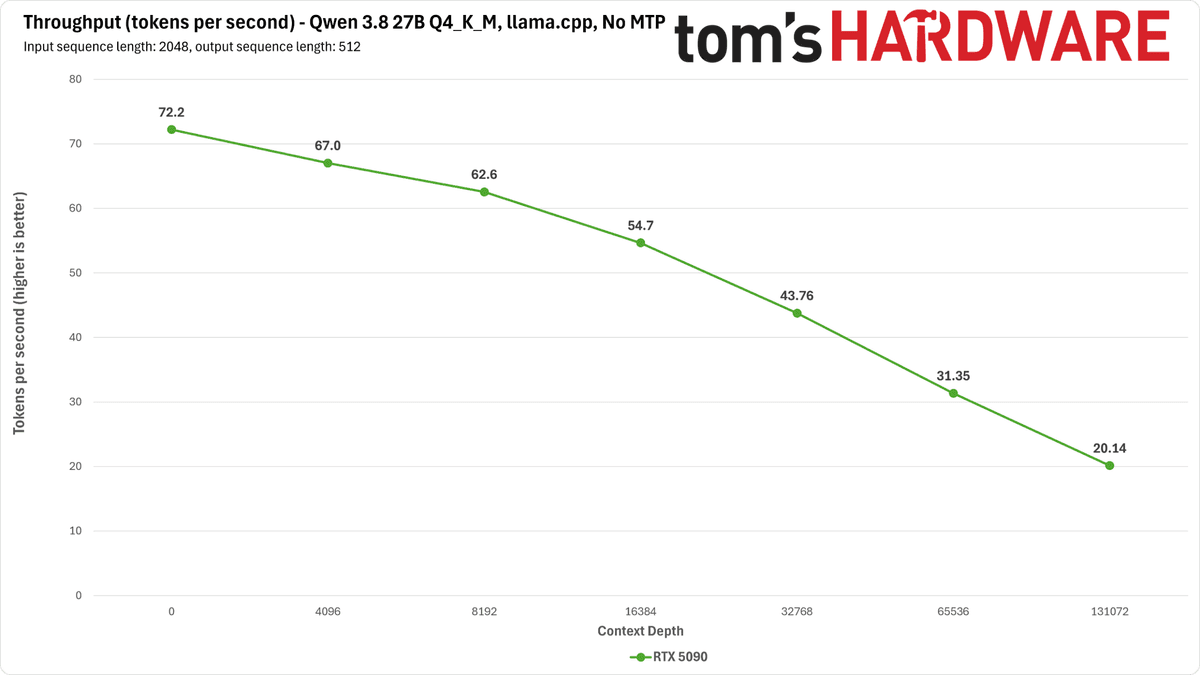
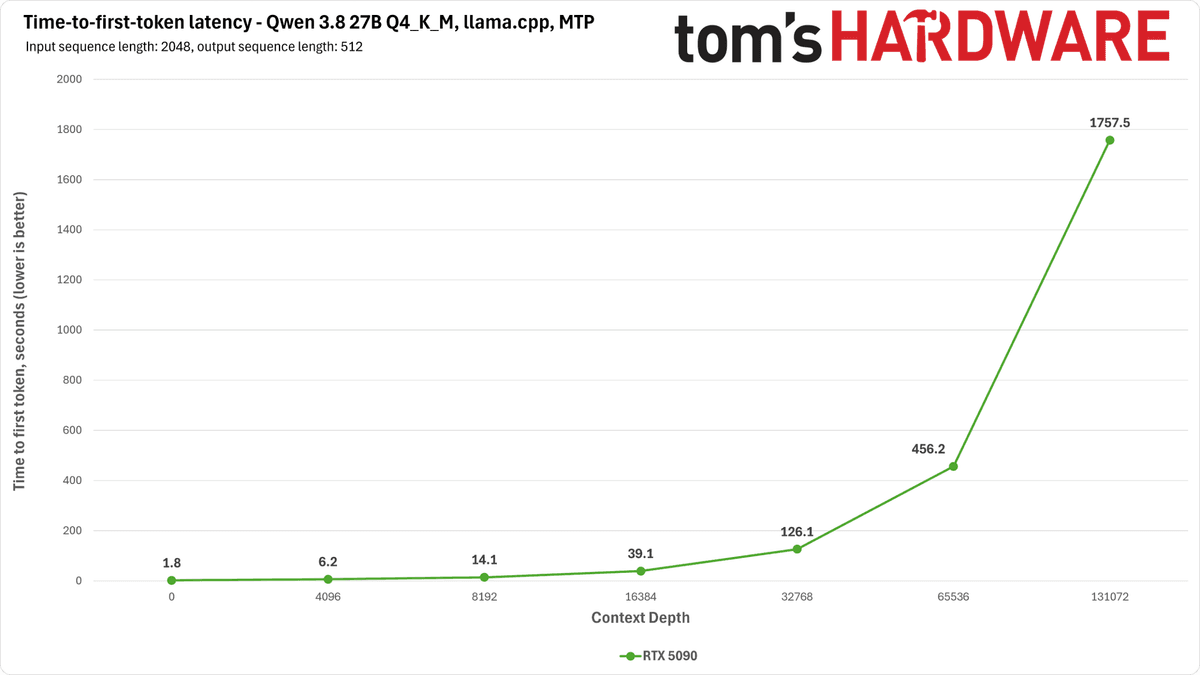
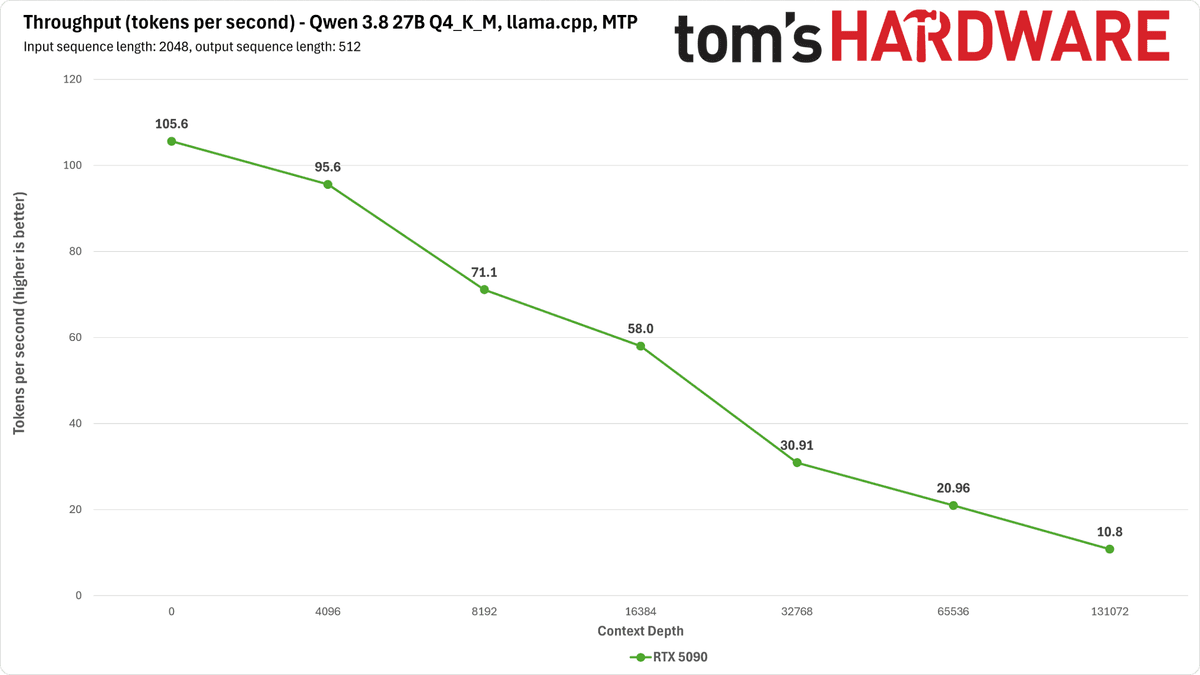
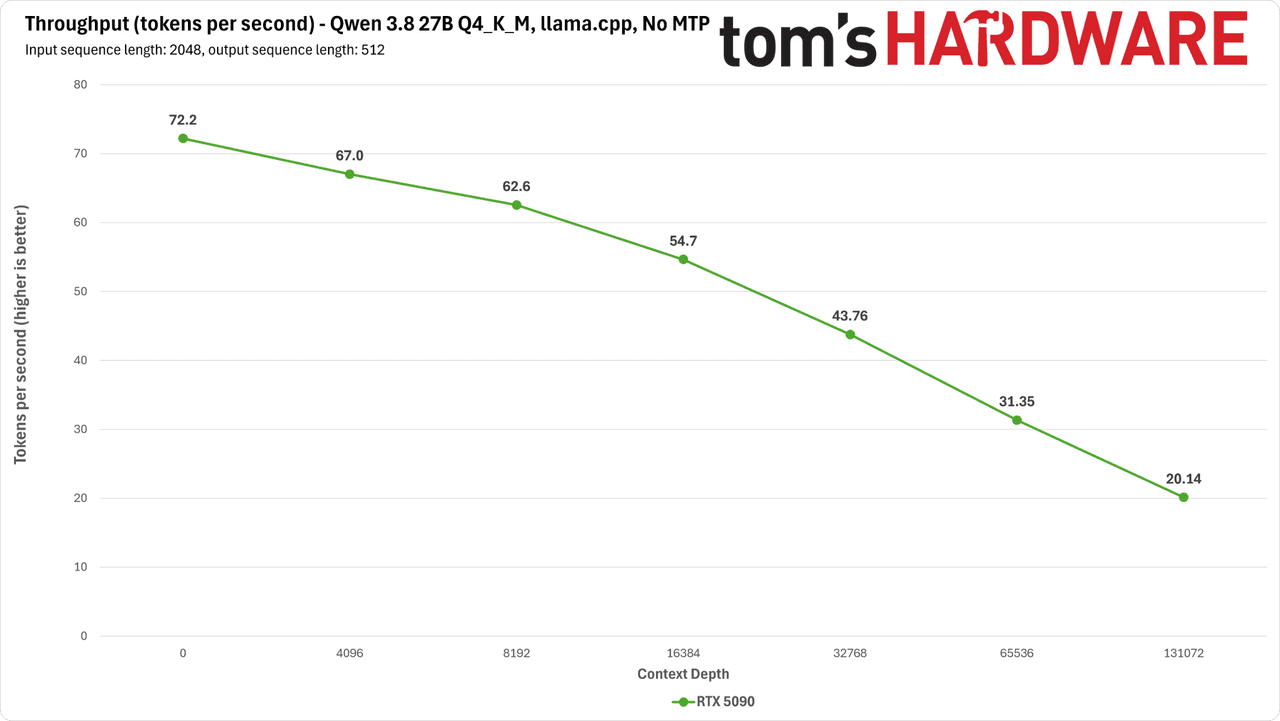
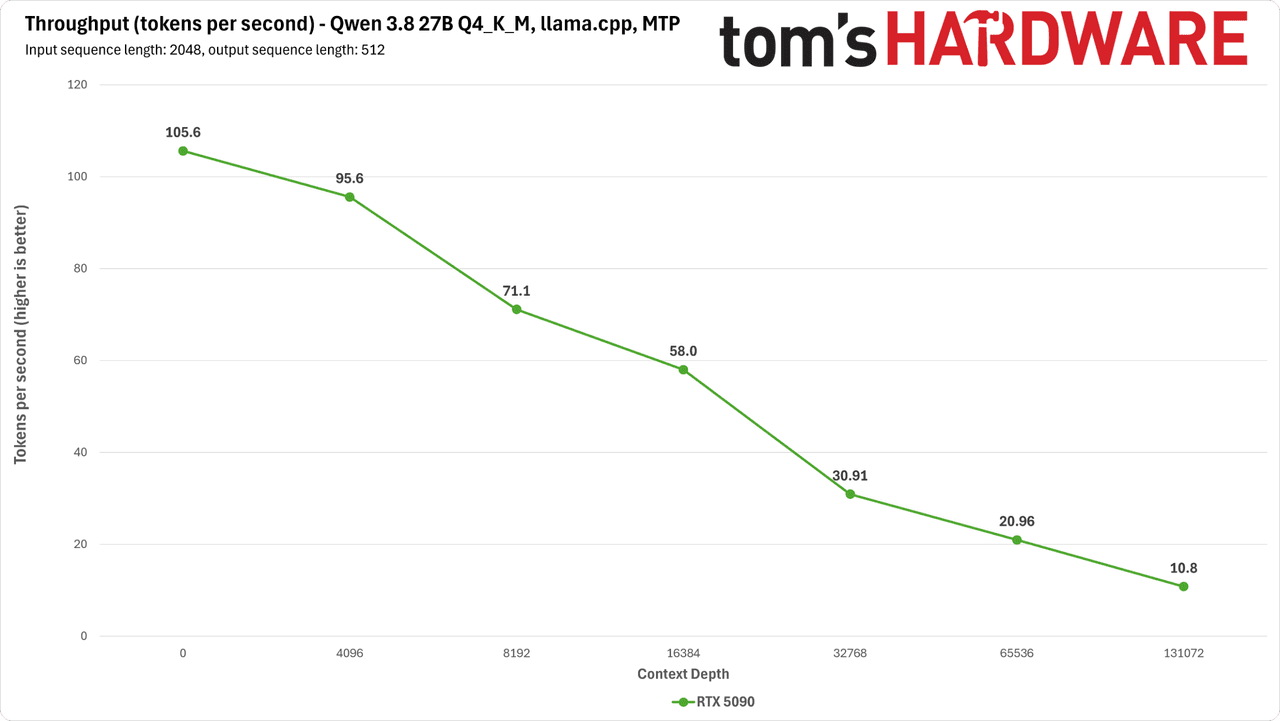
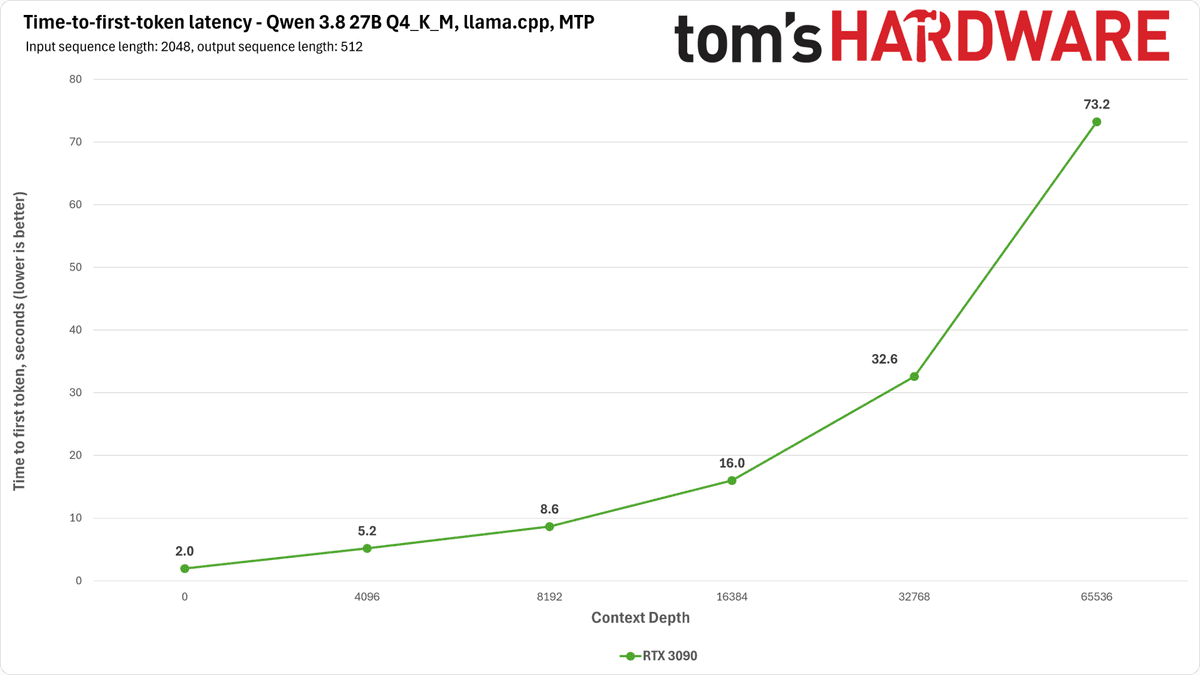
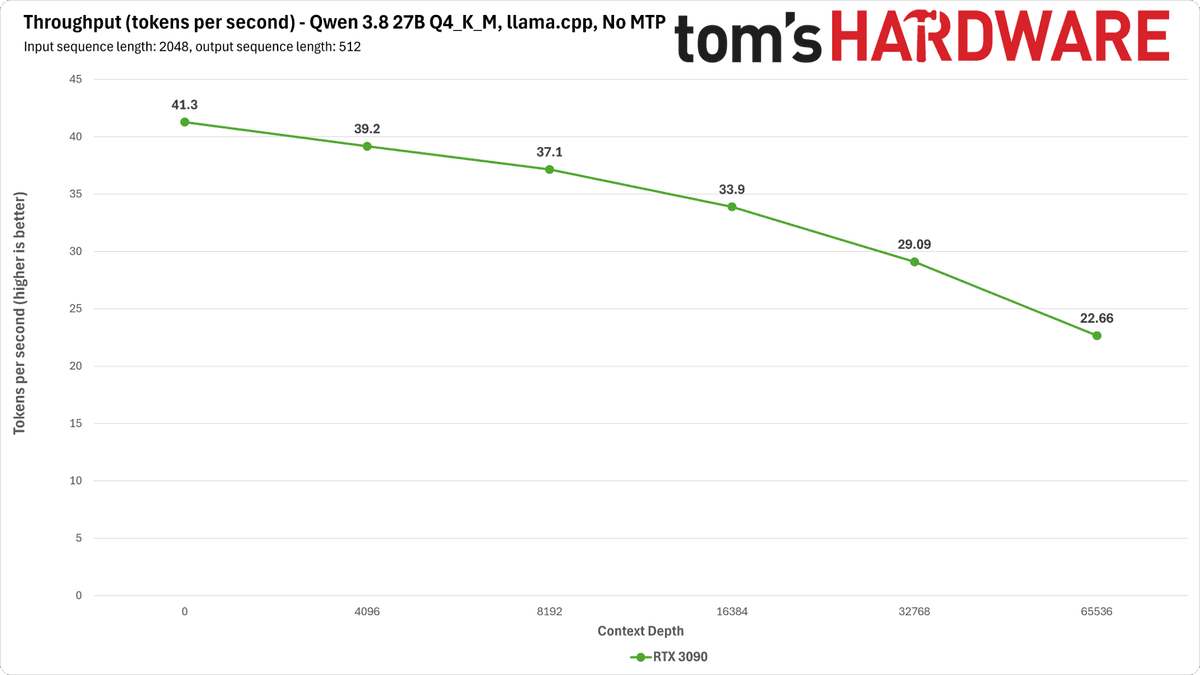
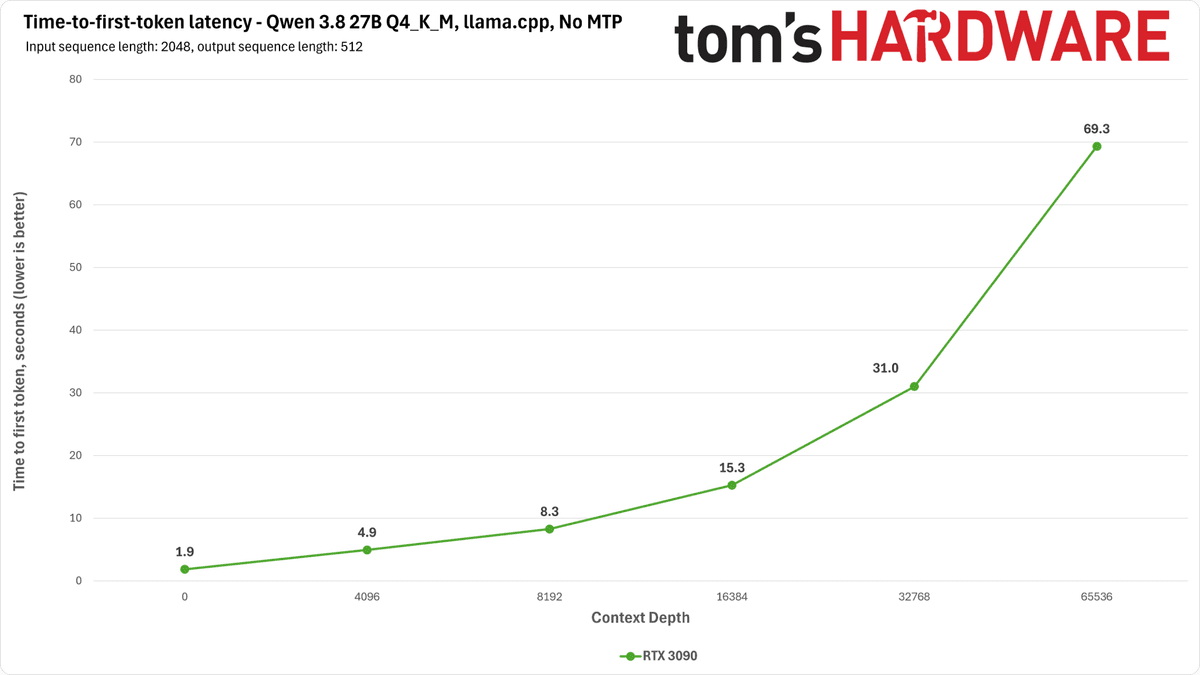
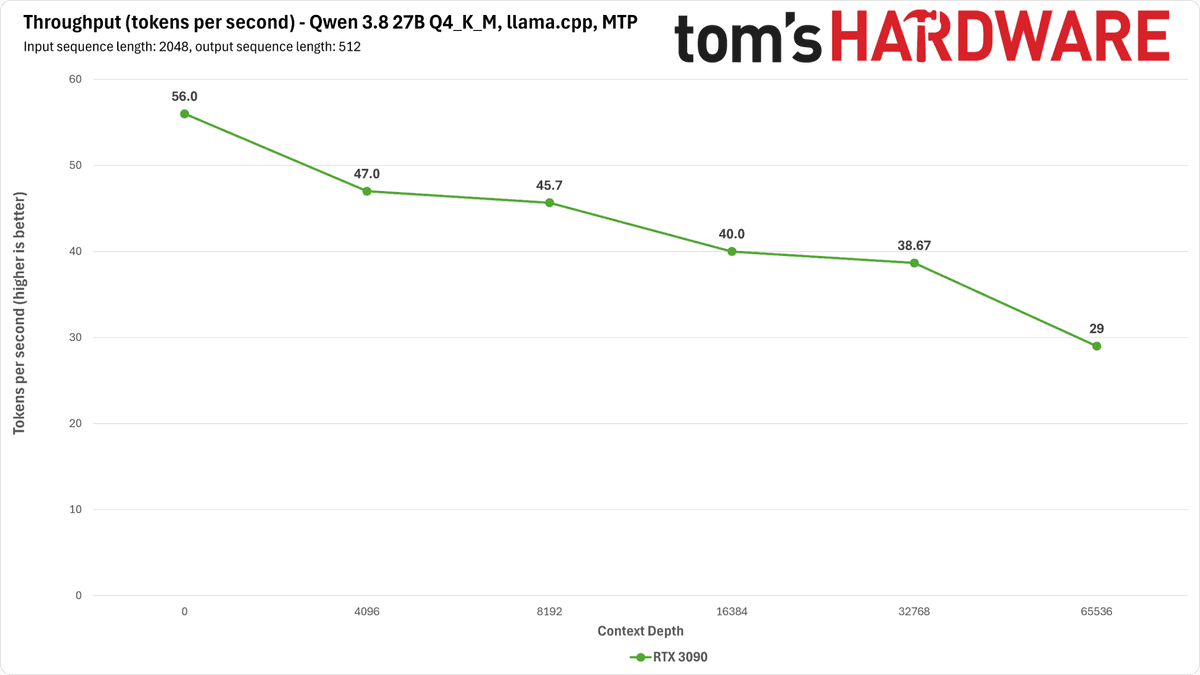
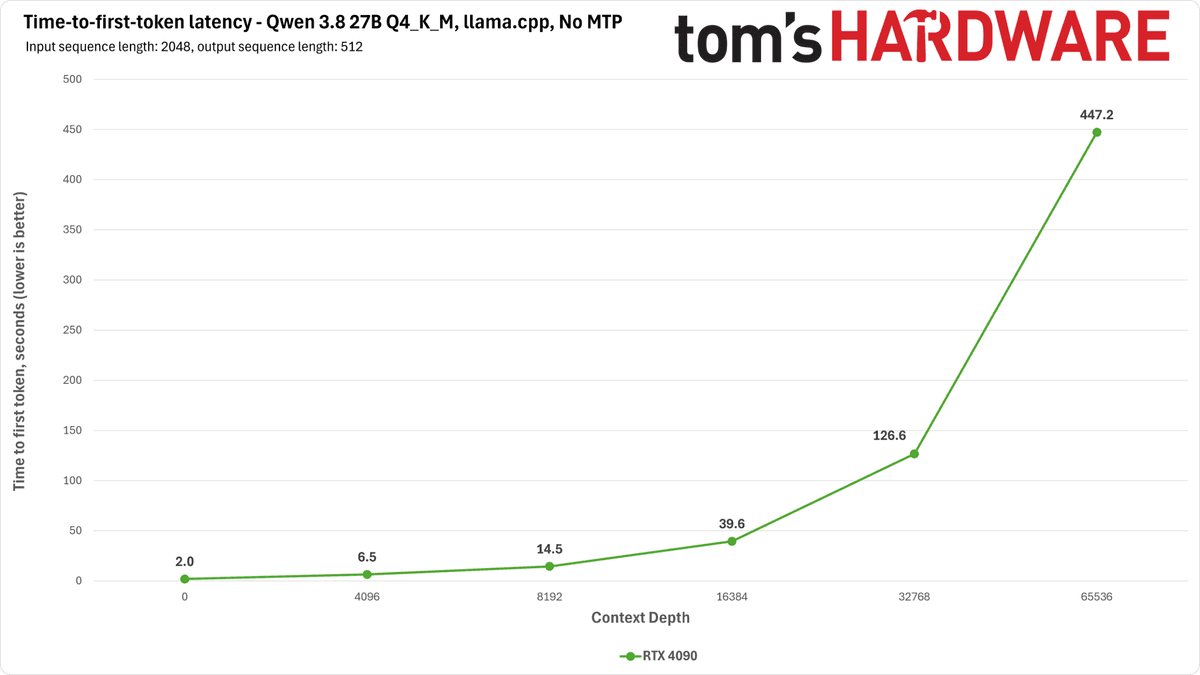
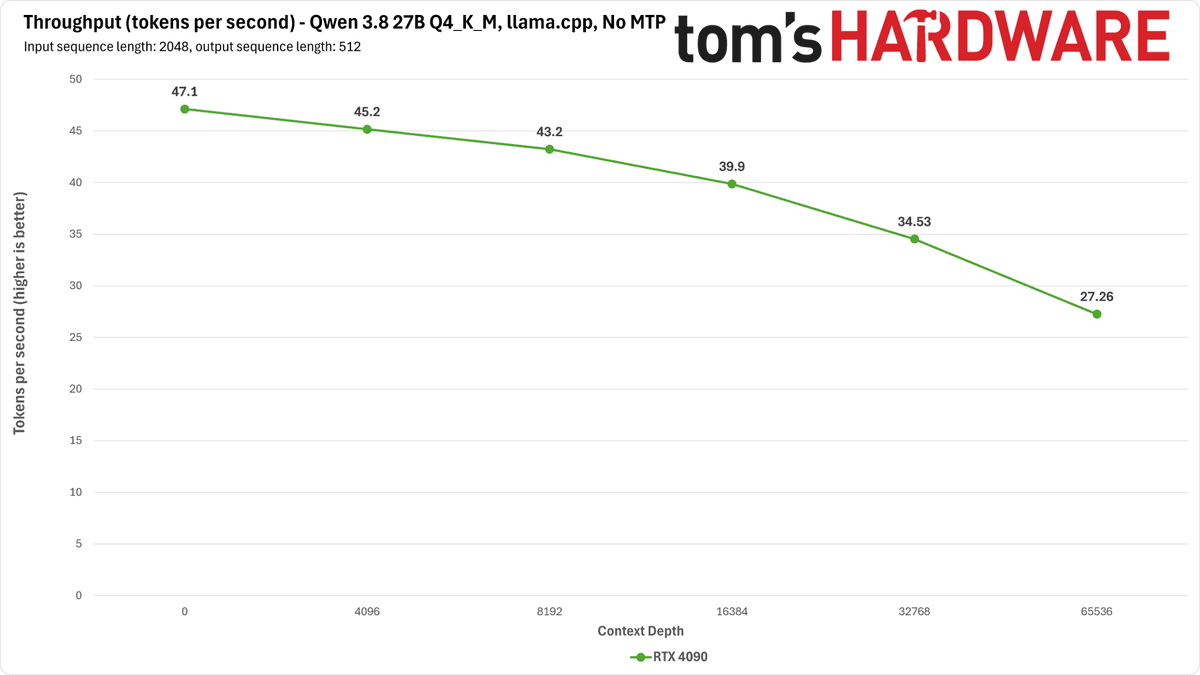
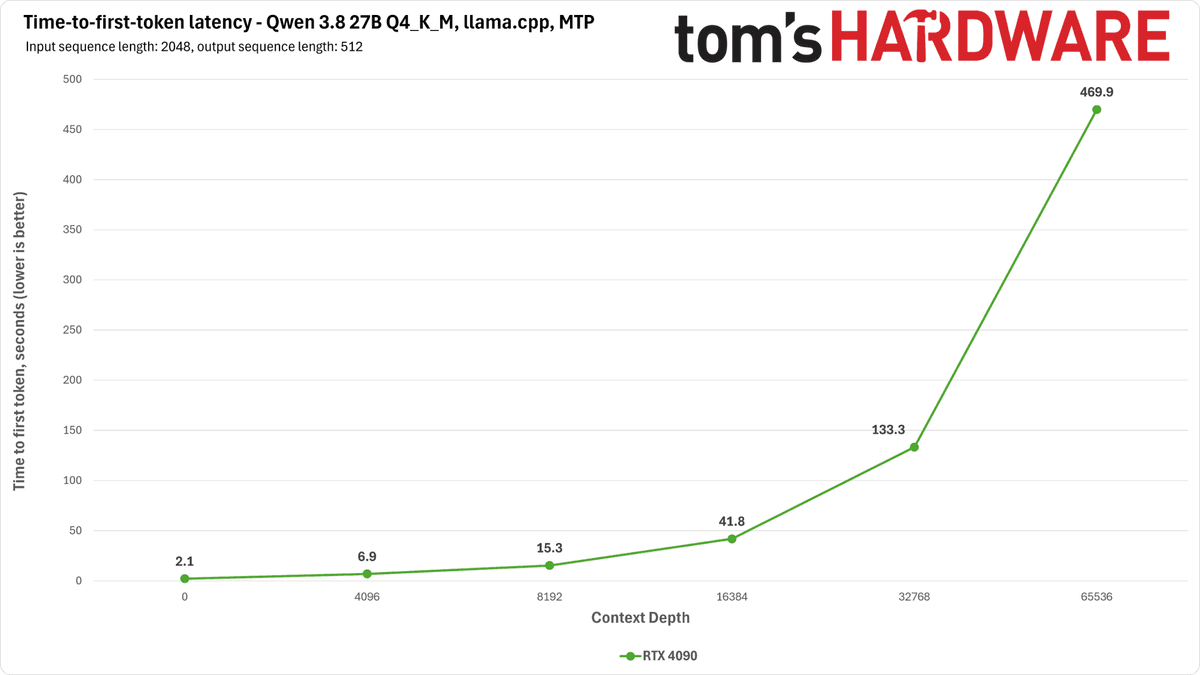
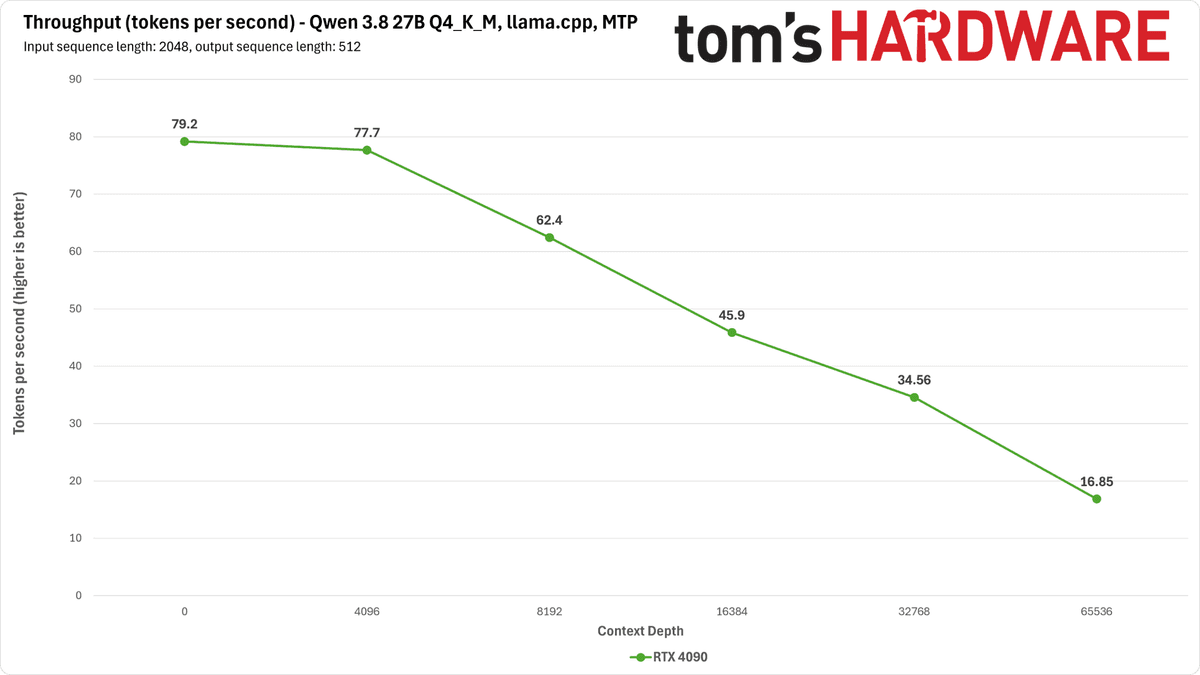
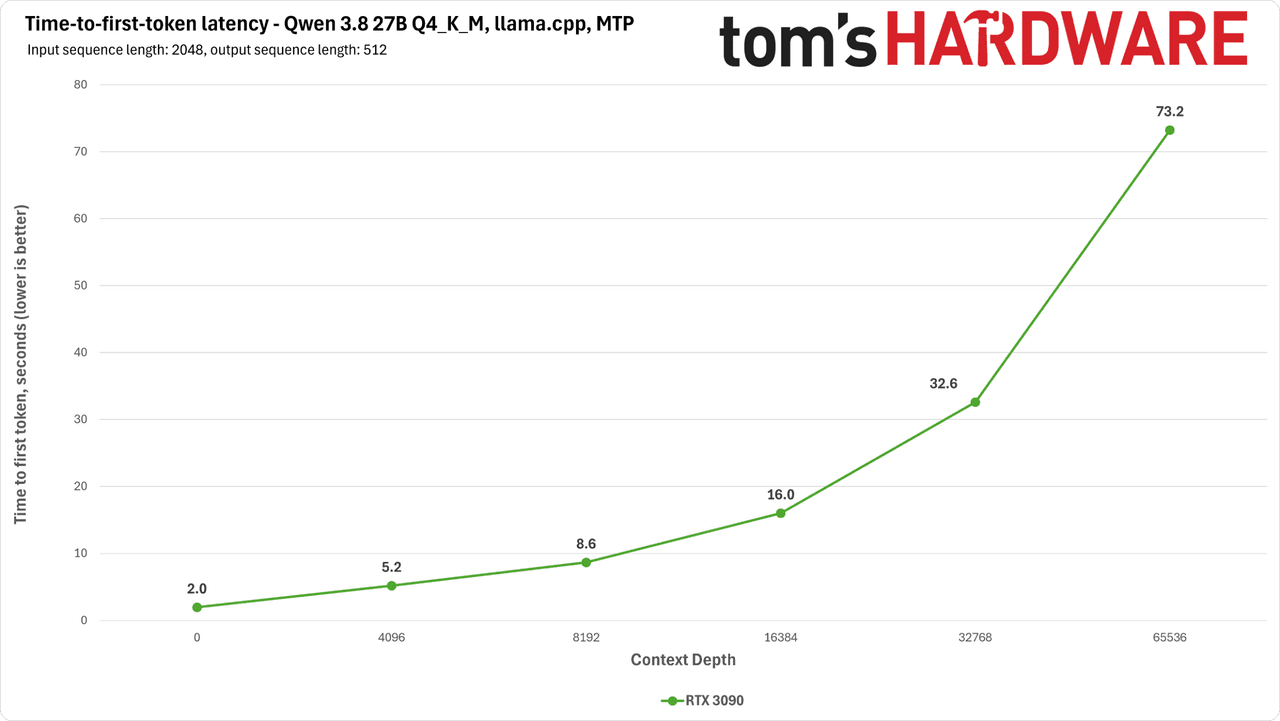
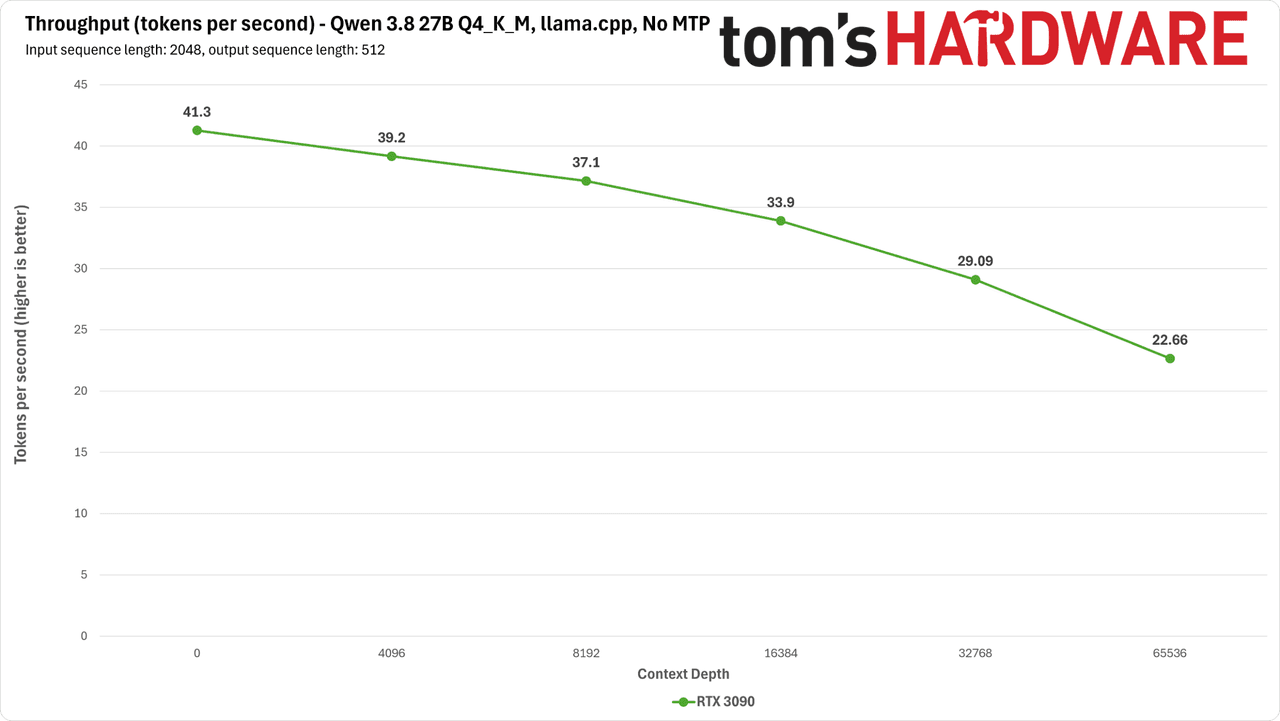
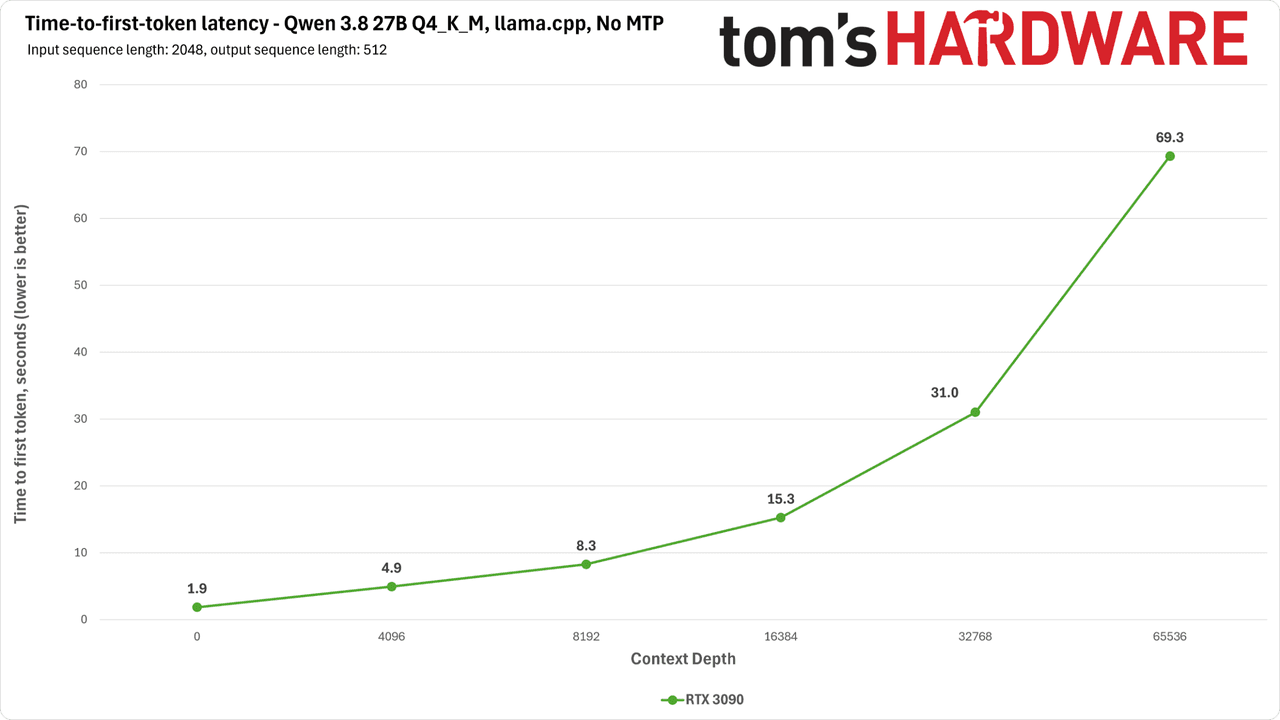
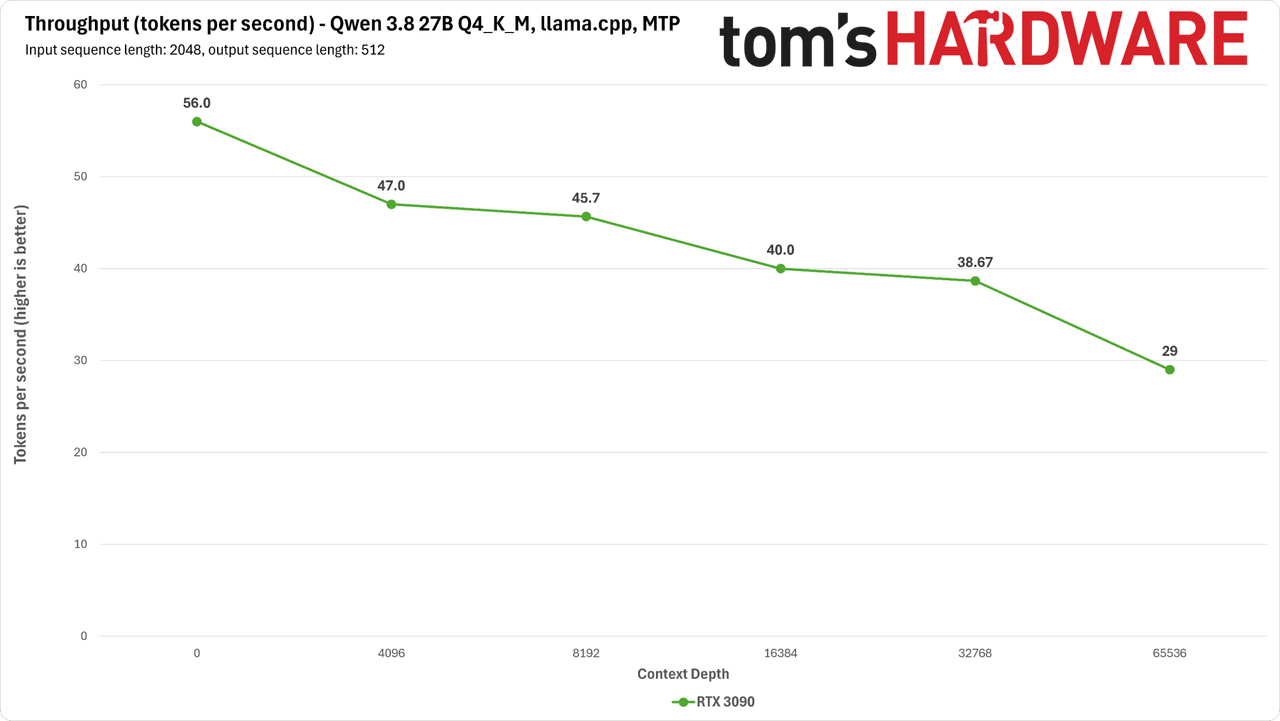
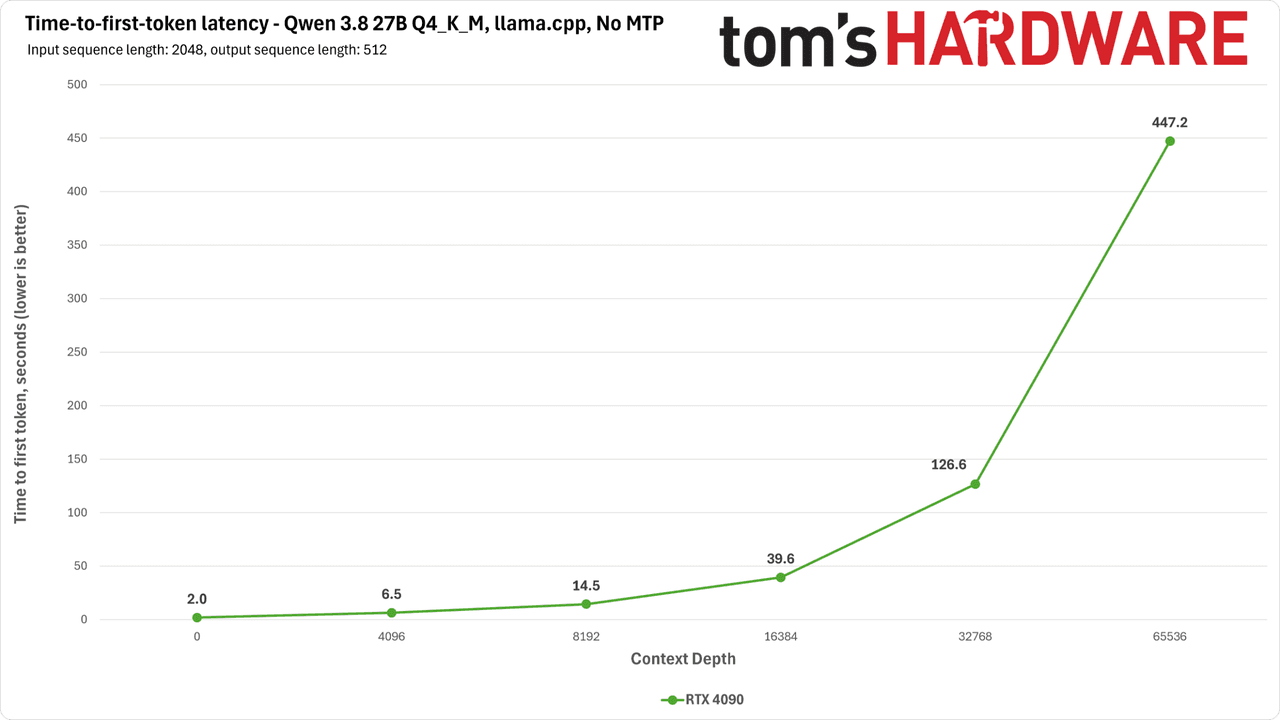
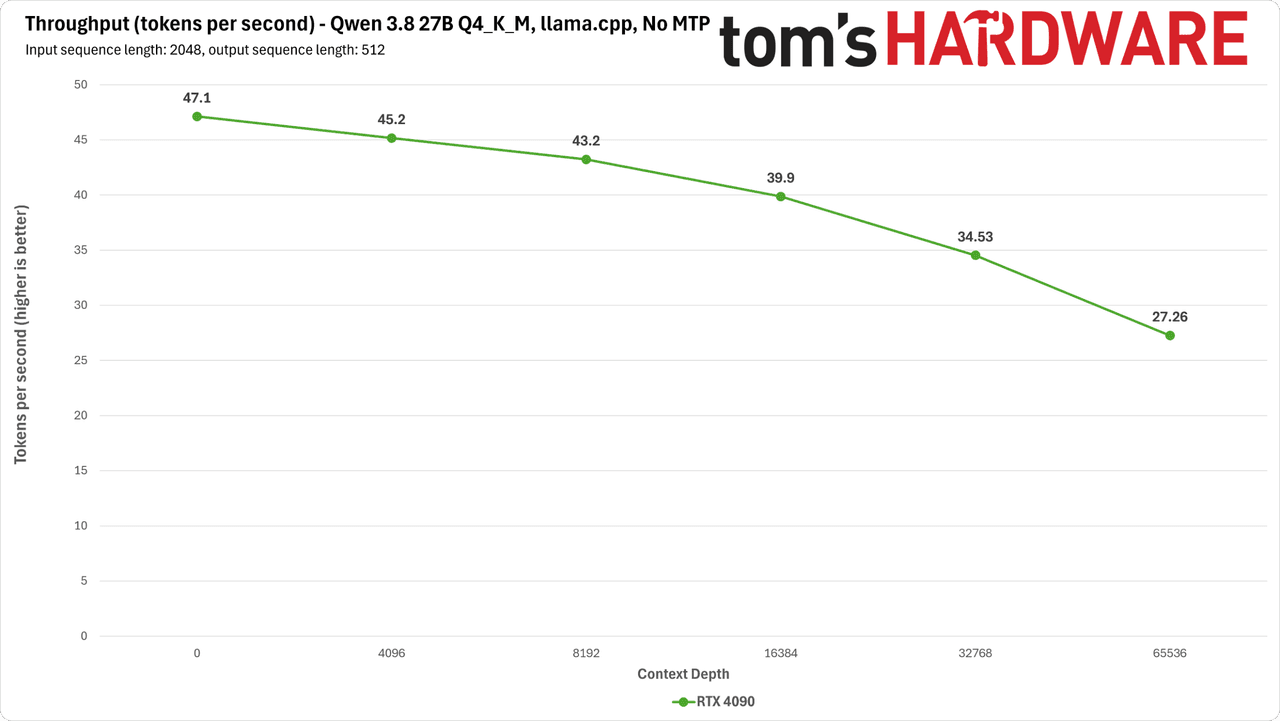
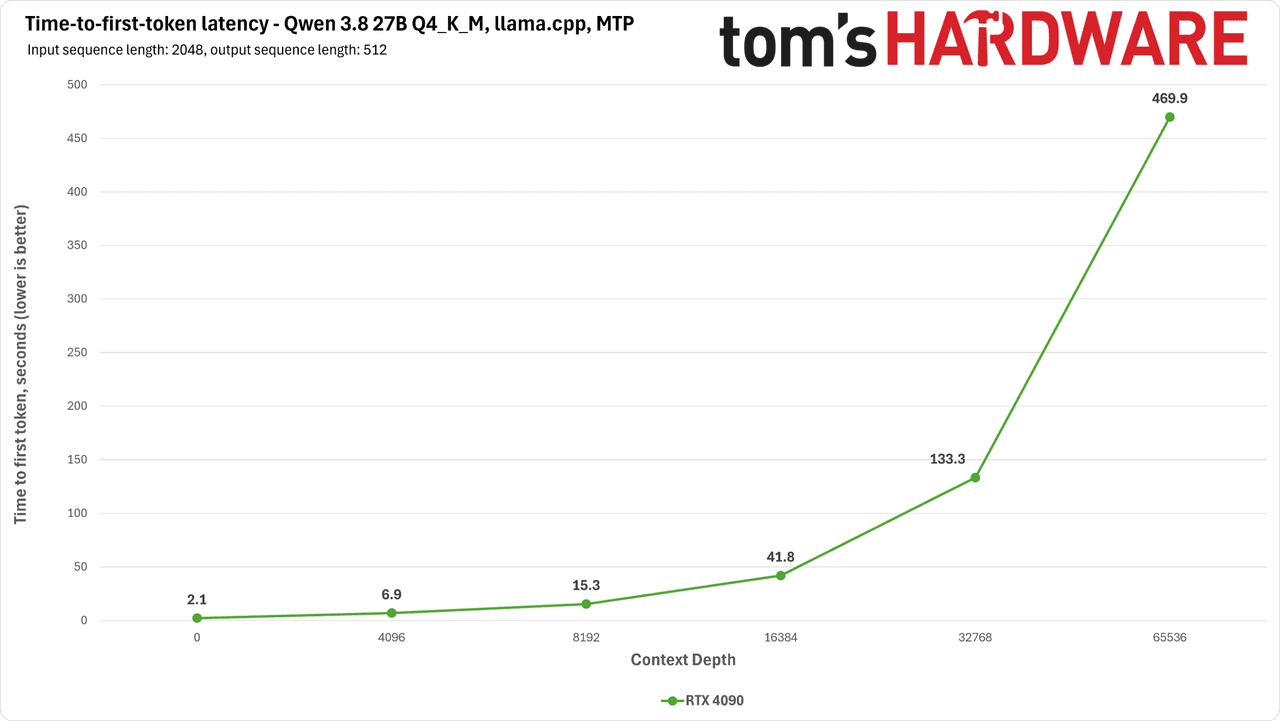
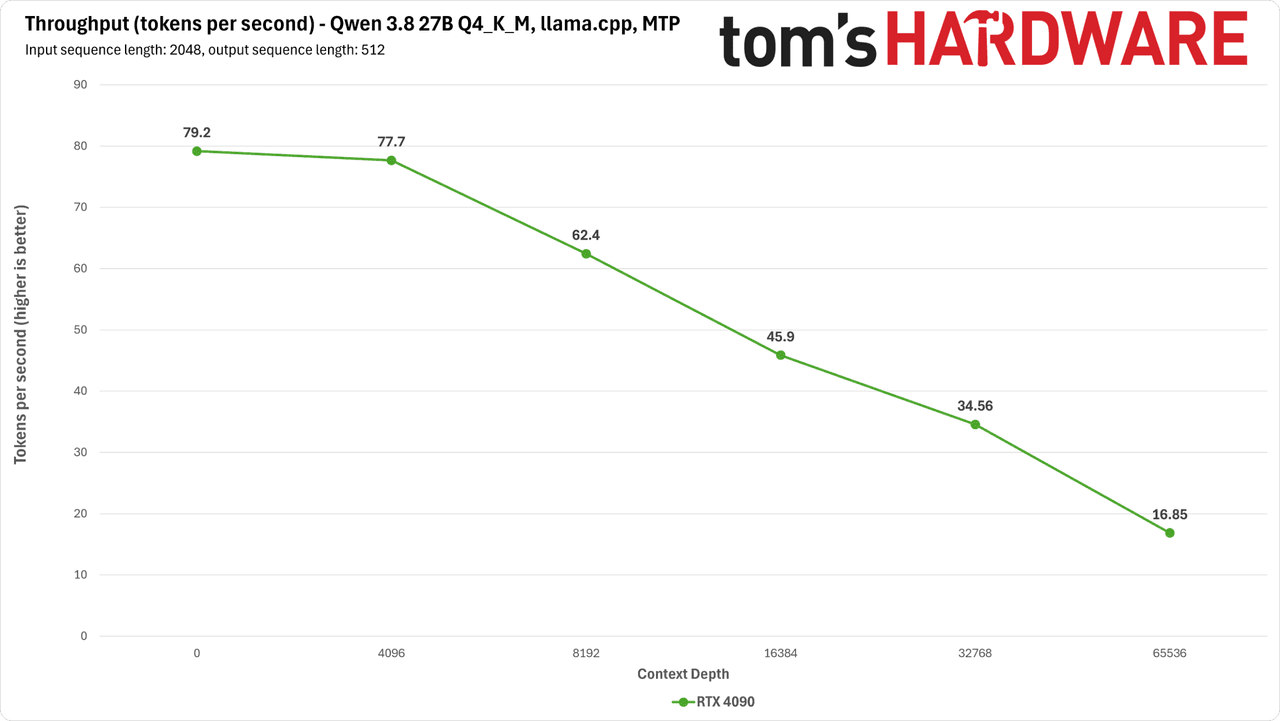
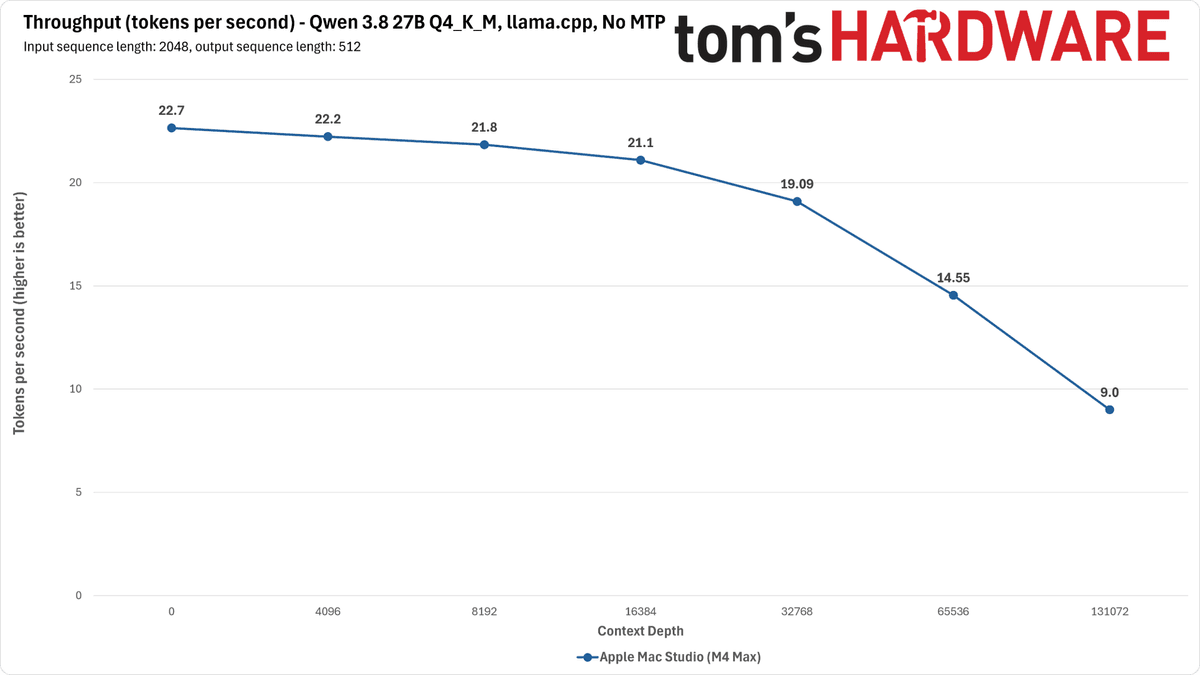
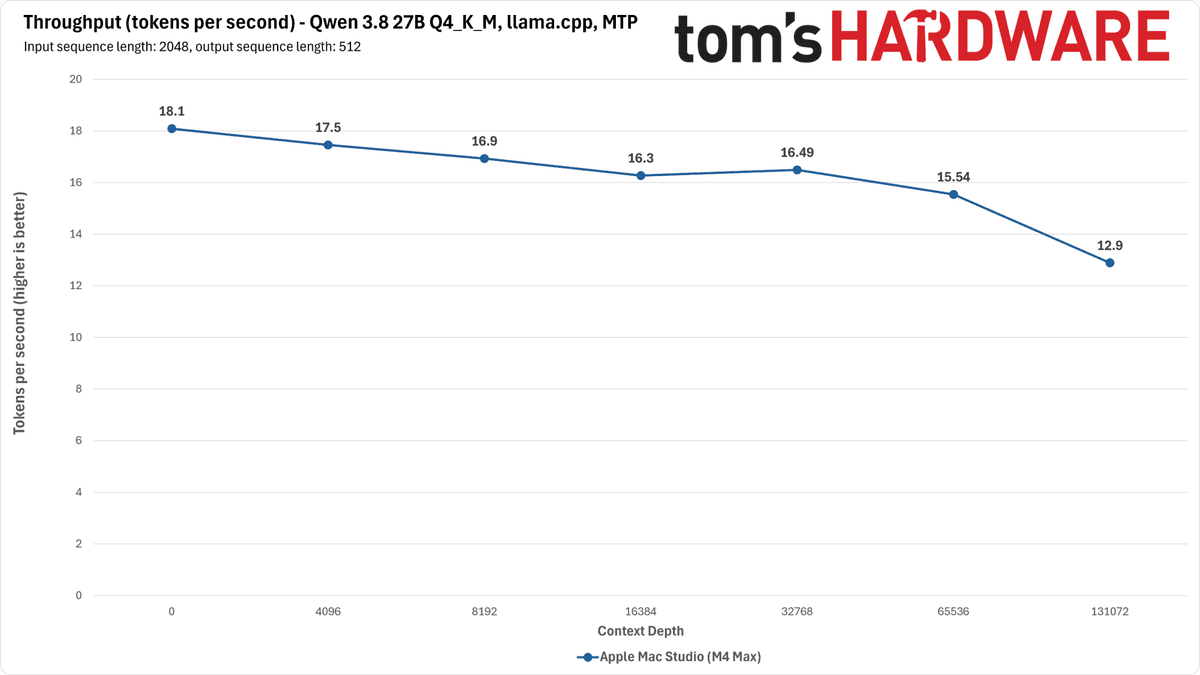
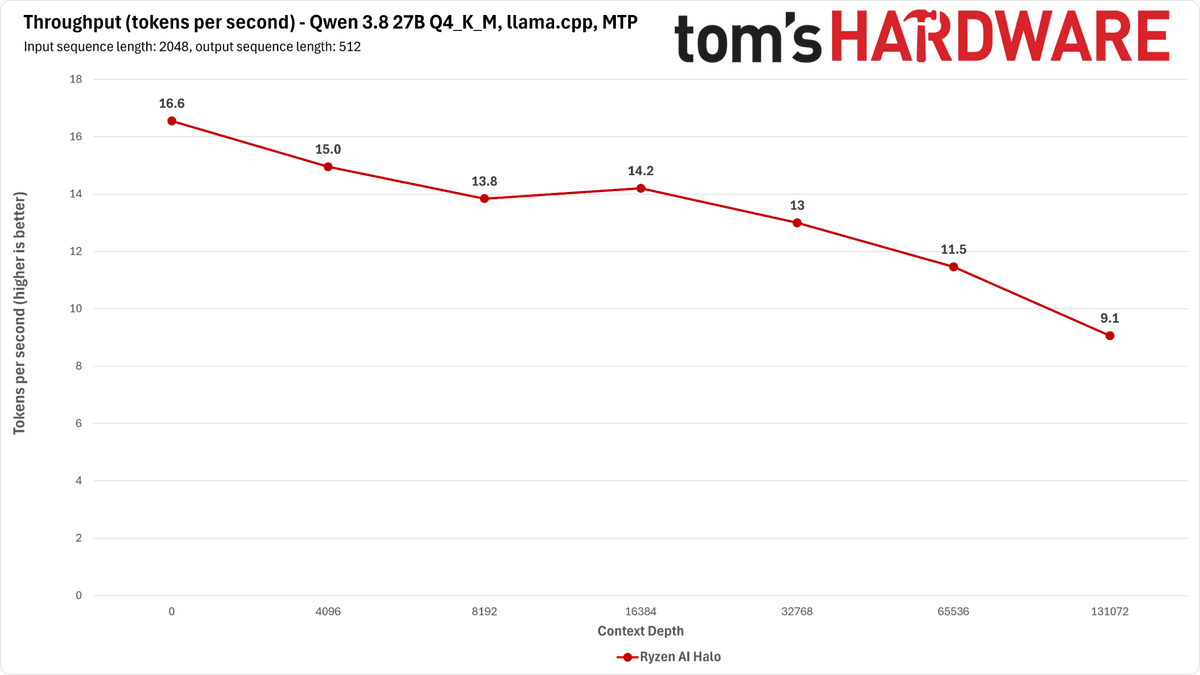
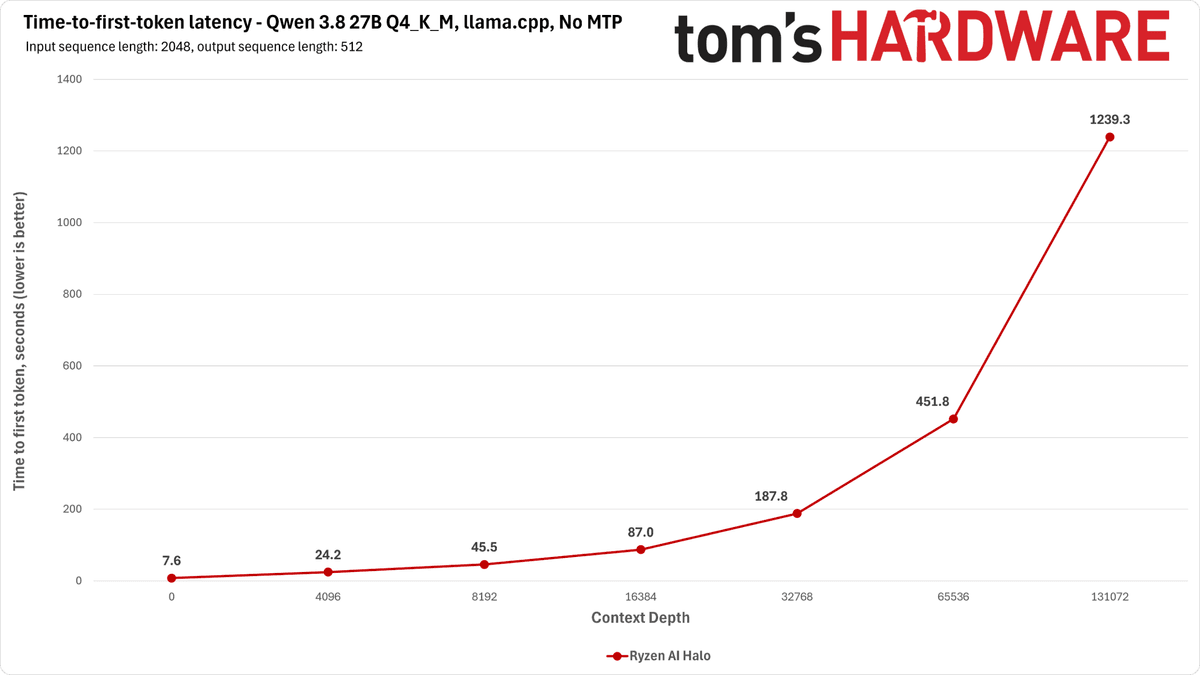
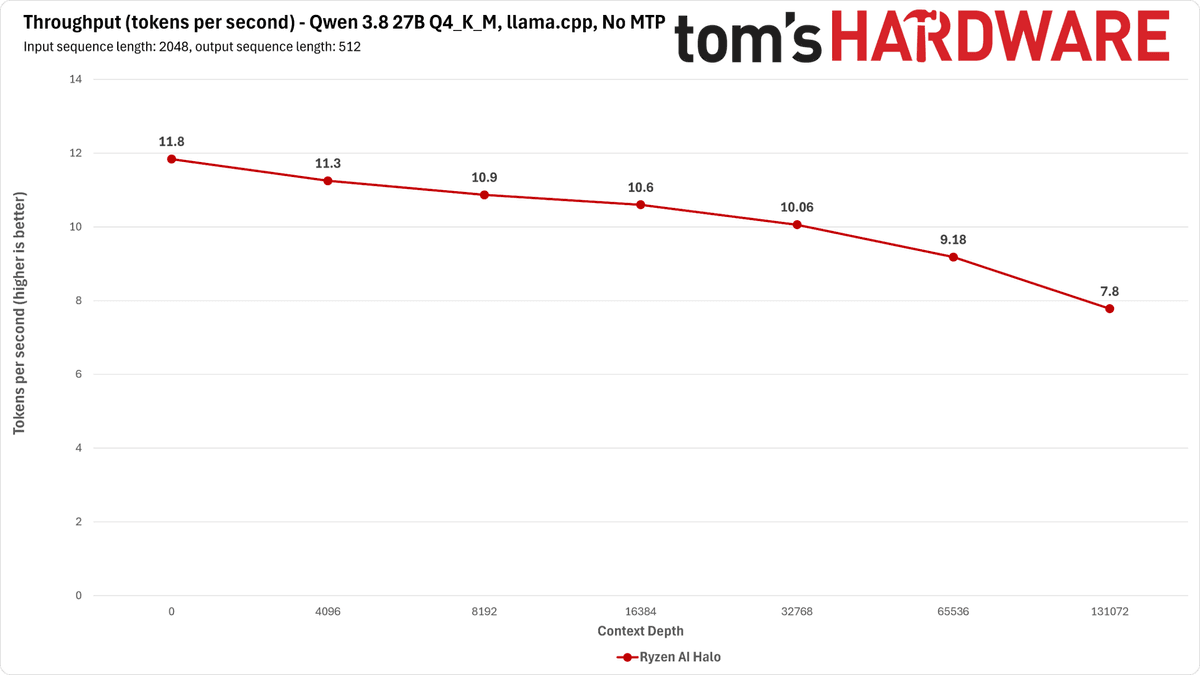
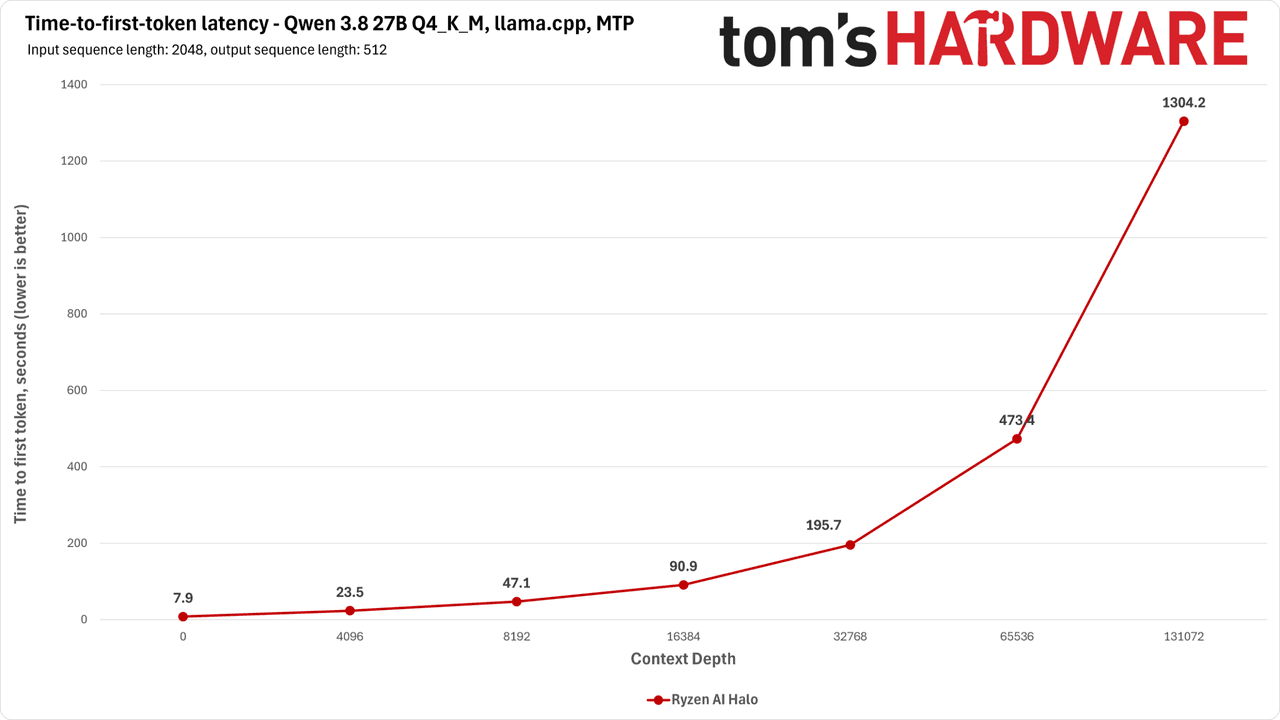
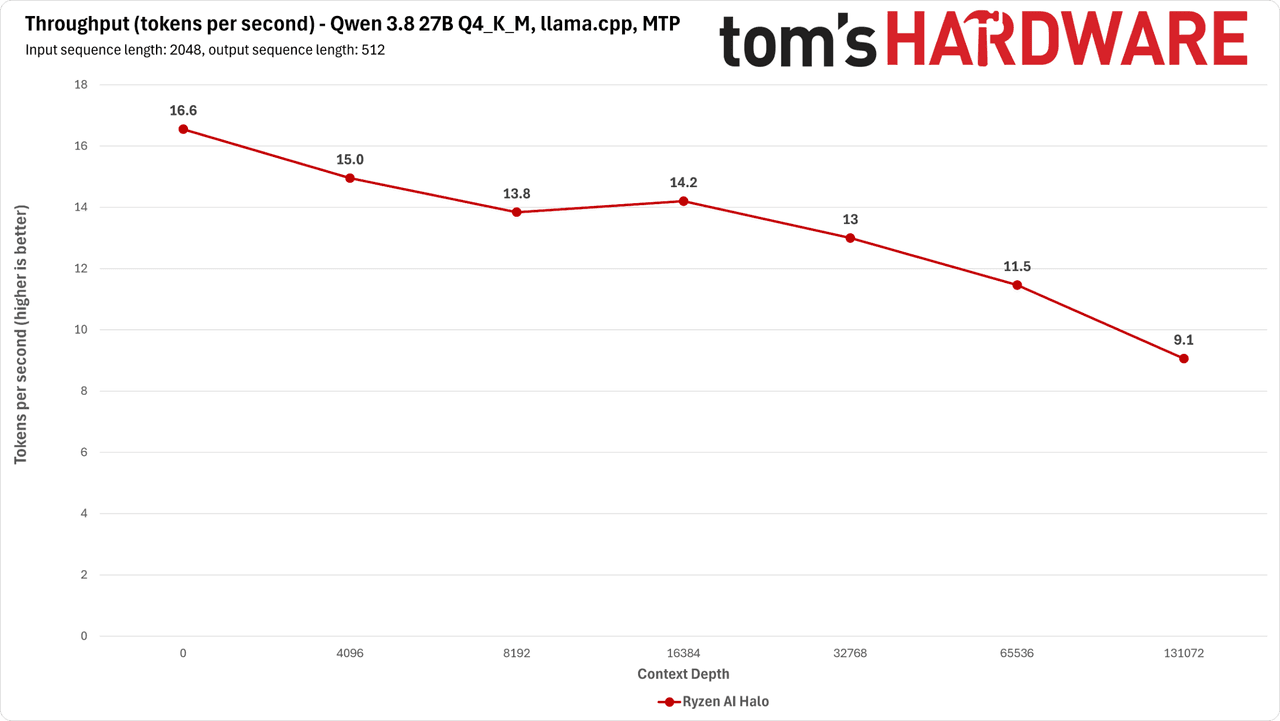
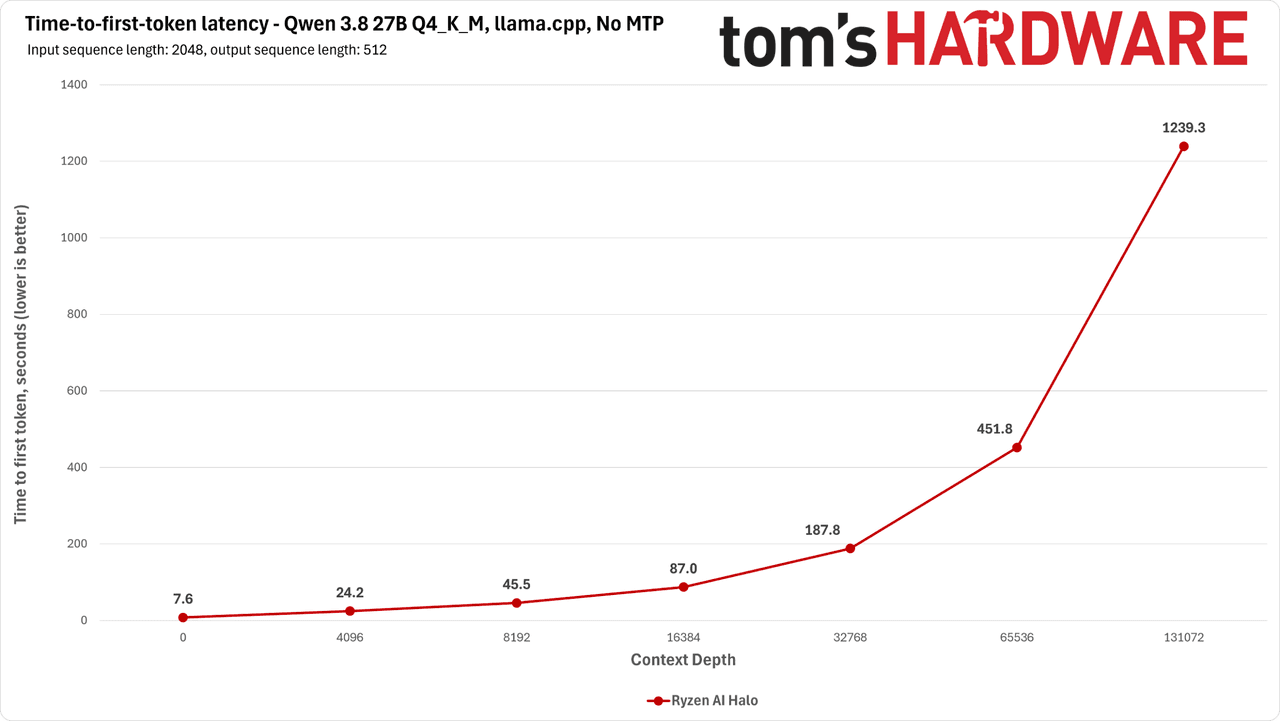
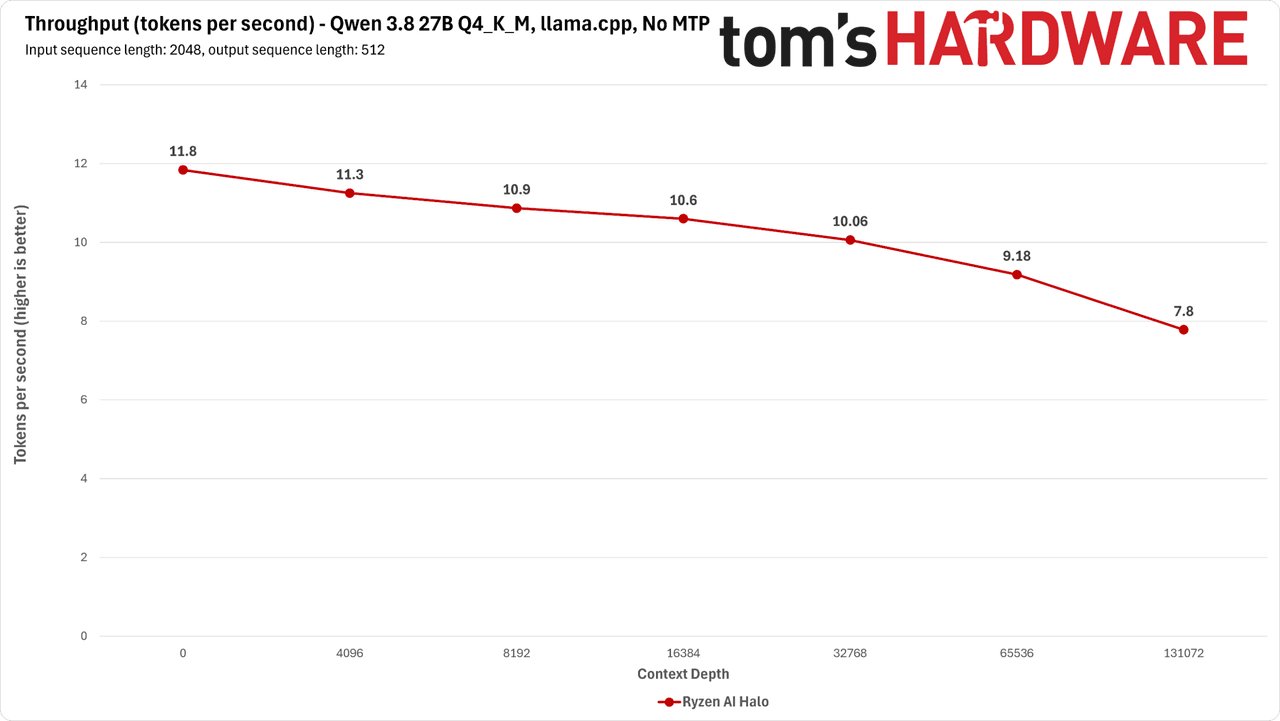
การทดสอบโมเดล AI โอเพนเวทตัวใหม่ Qwen 3.8 27B ของ Alibaba บนการ์ดจอ RTX 5090 พบปัญหาที่ไม่คาดคิด โดยแม้การ์ดจะมี VRAM ถึง 32GB และแบนด์วิดท์หน่วยความจำสูงถึง 1.8 TB/s แต่หากใช้ตัวรันโมเดลอย่าง llama.cpp จะพบว่าความเร็วในการประมวลผลช่วงบริบท (Context) ยาวๆ นั้นย่ำแย่มาก
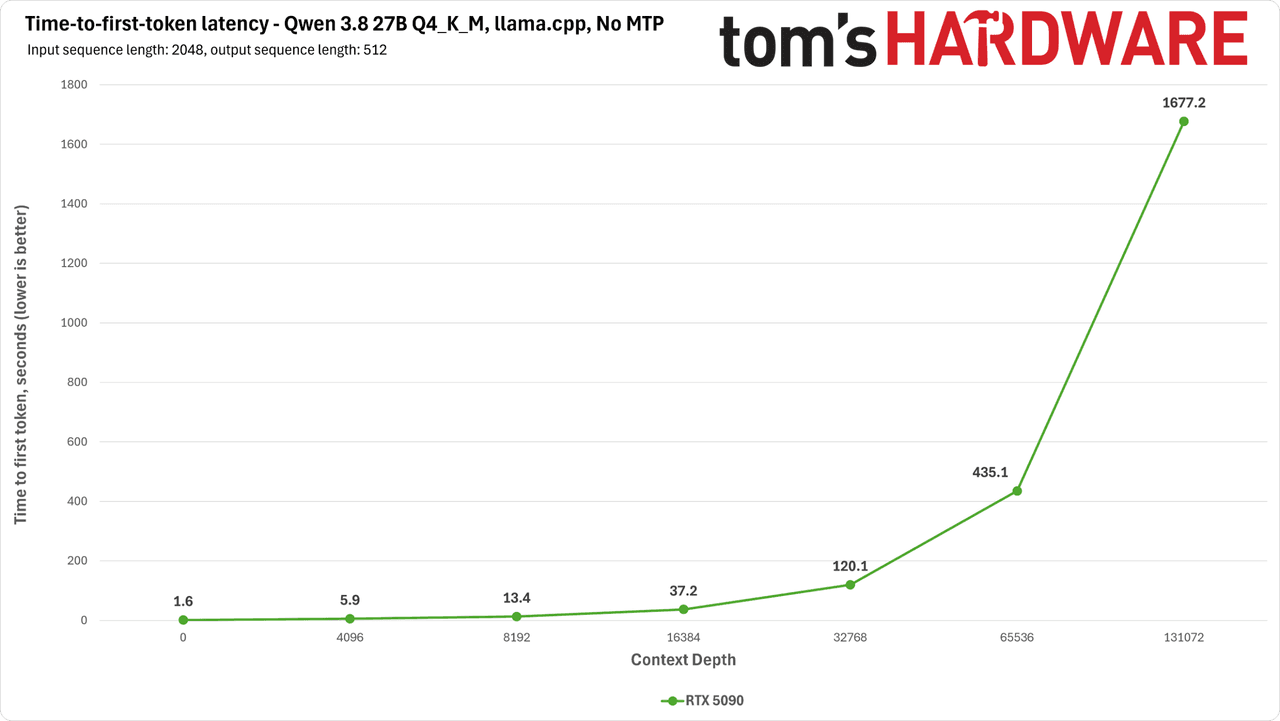
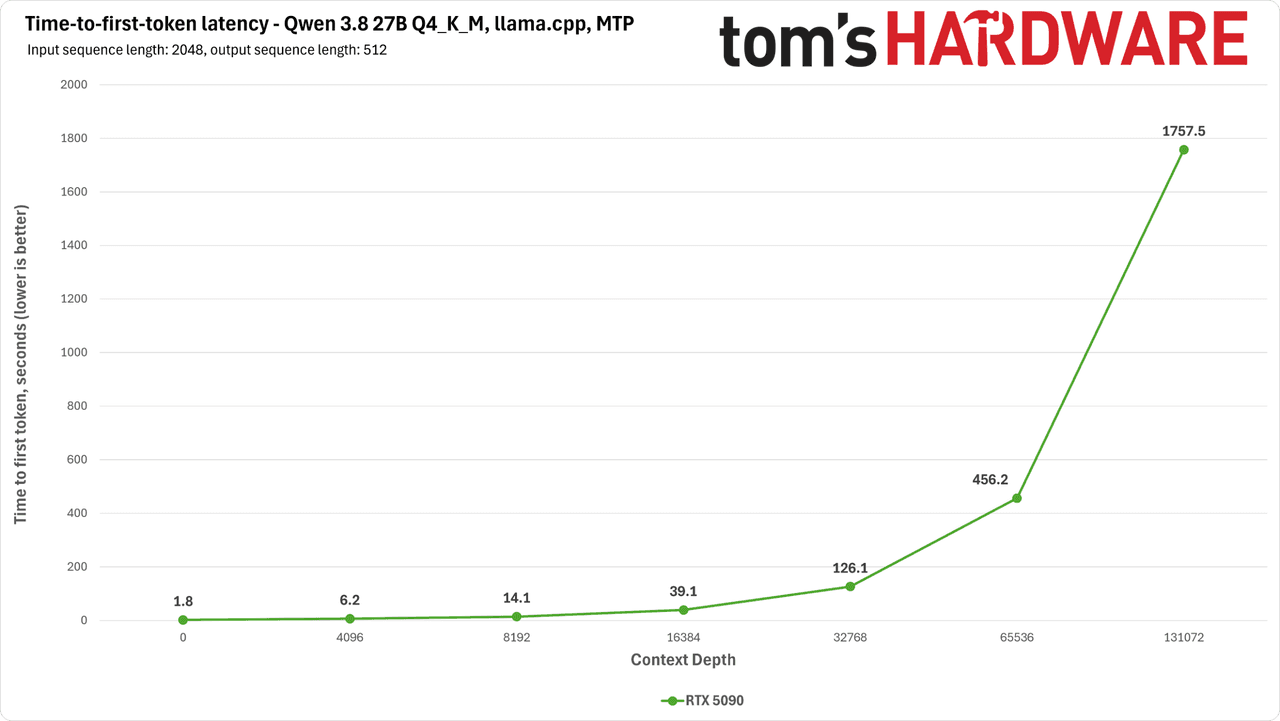
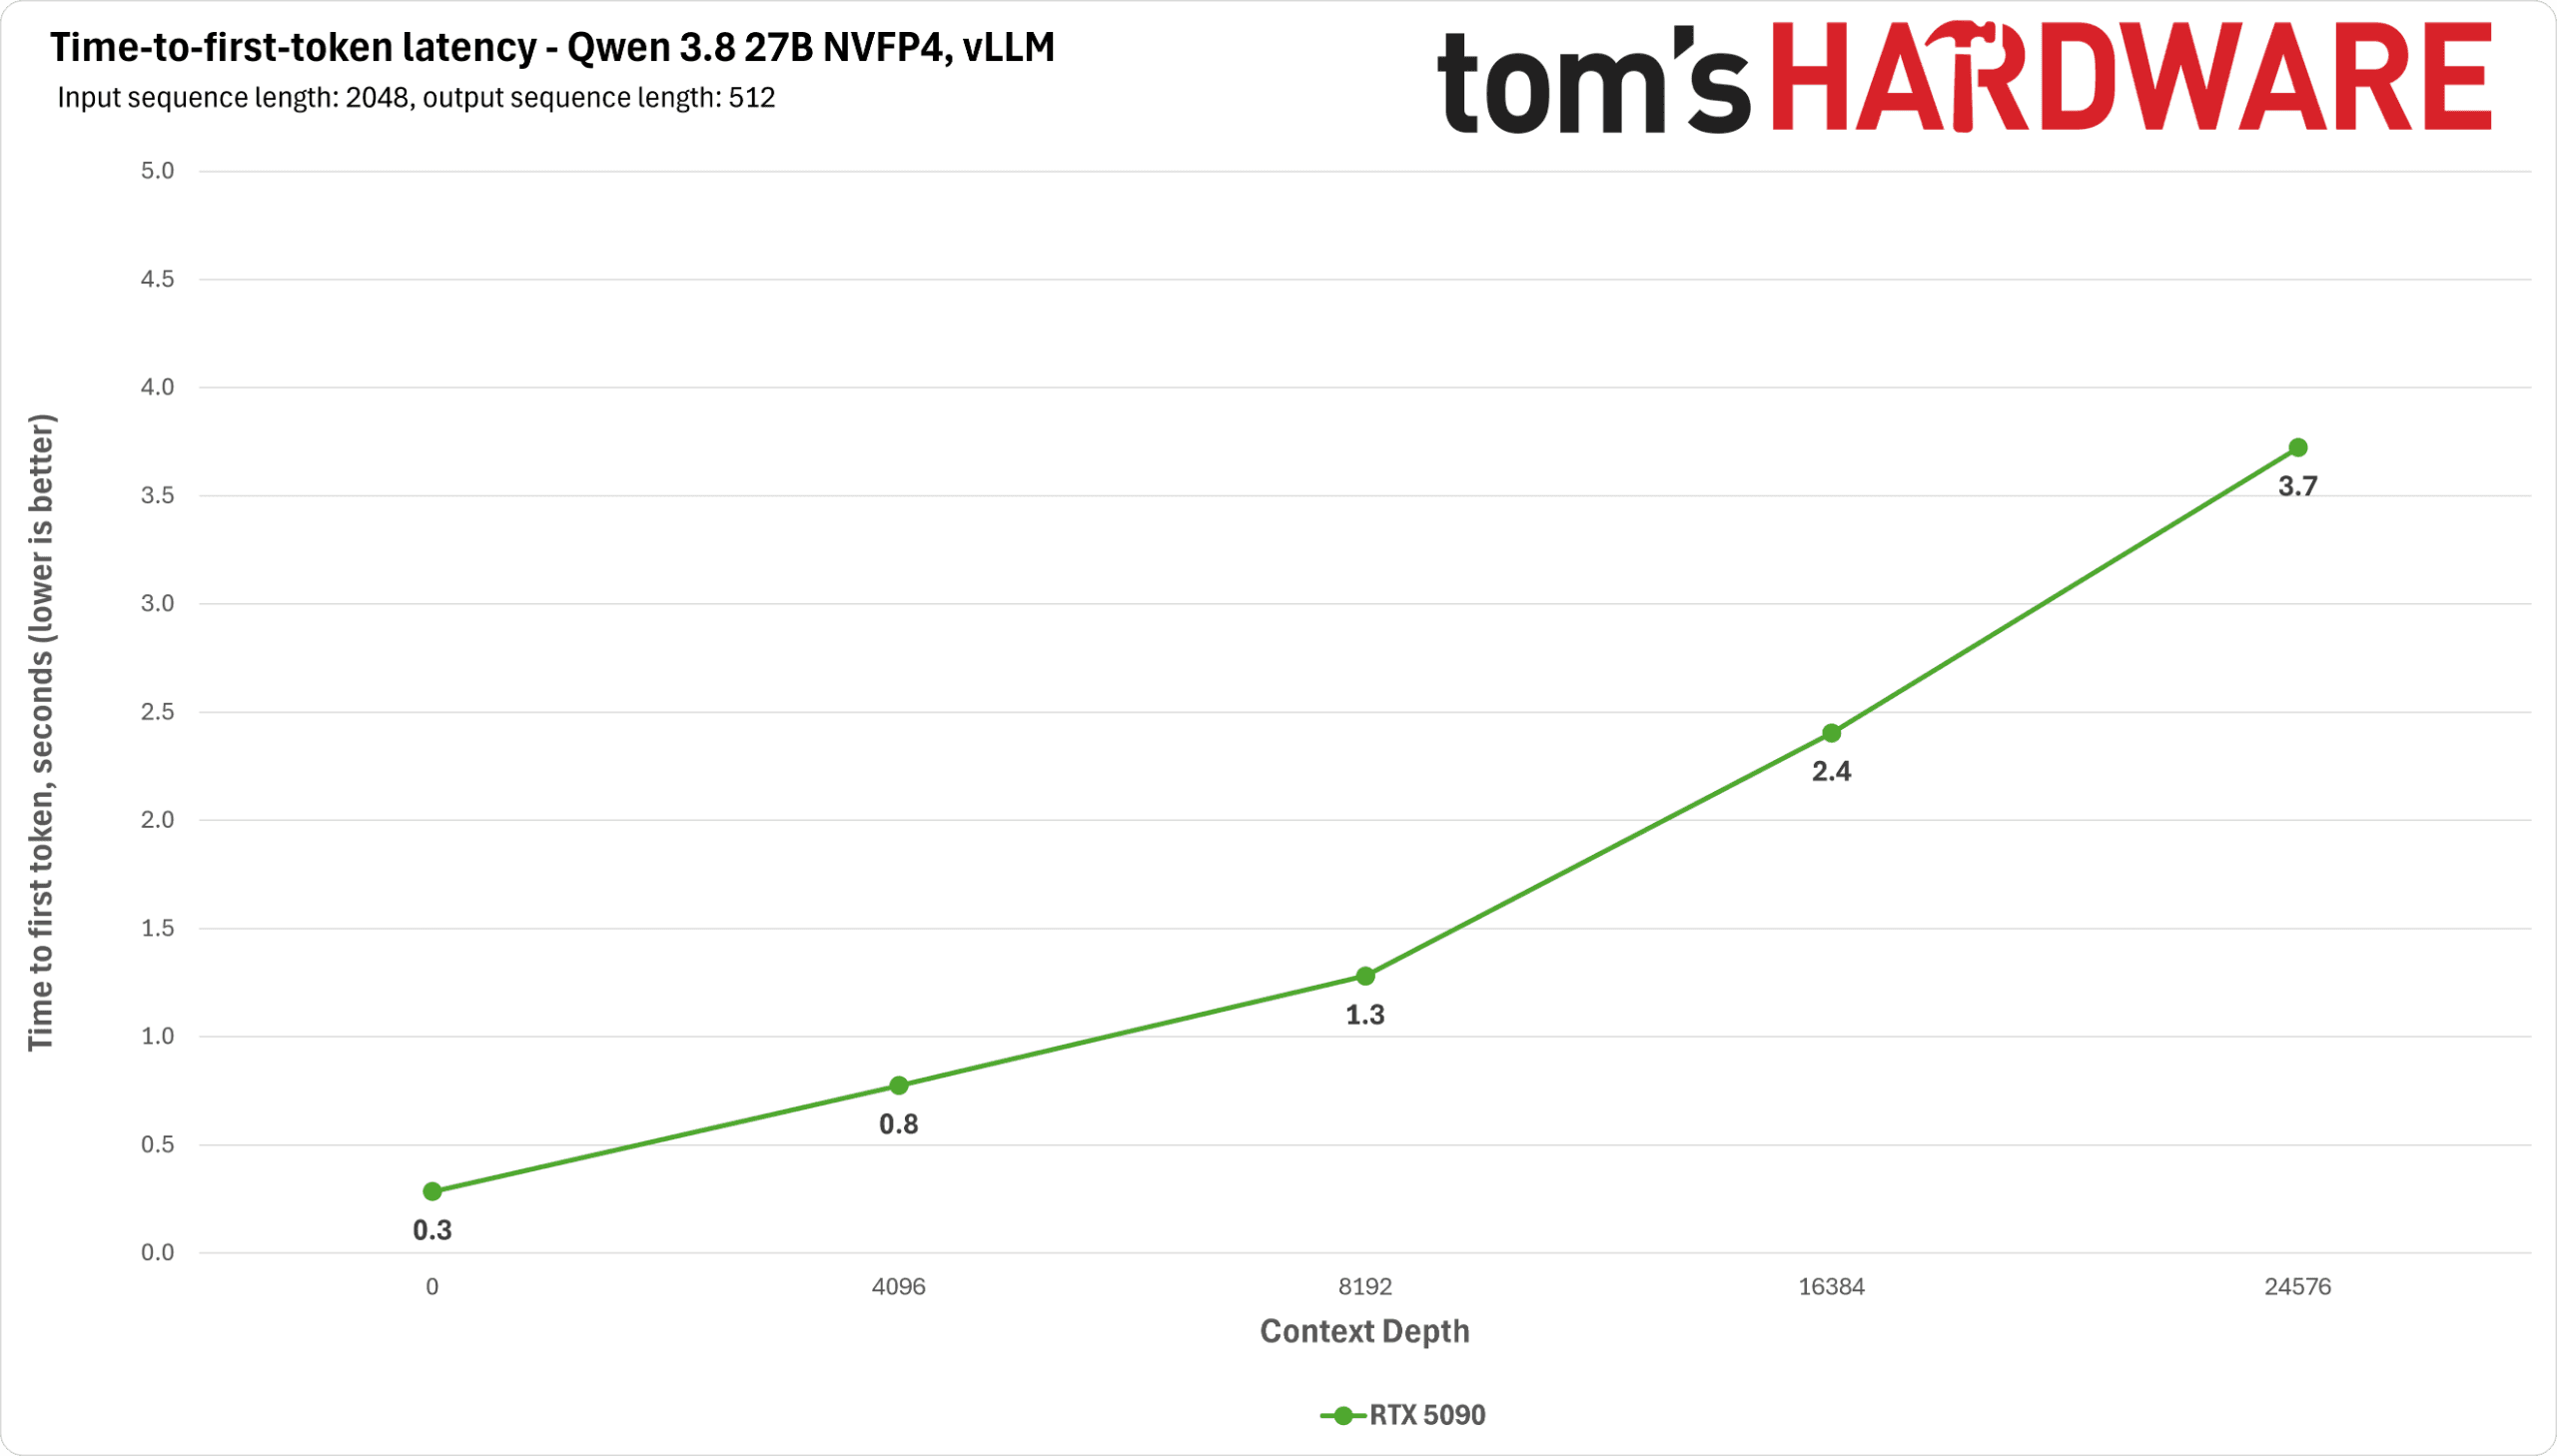
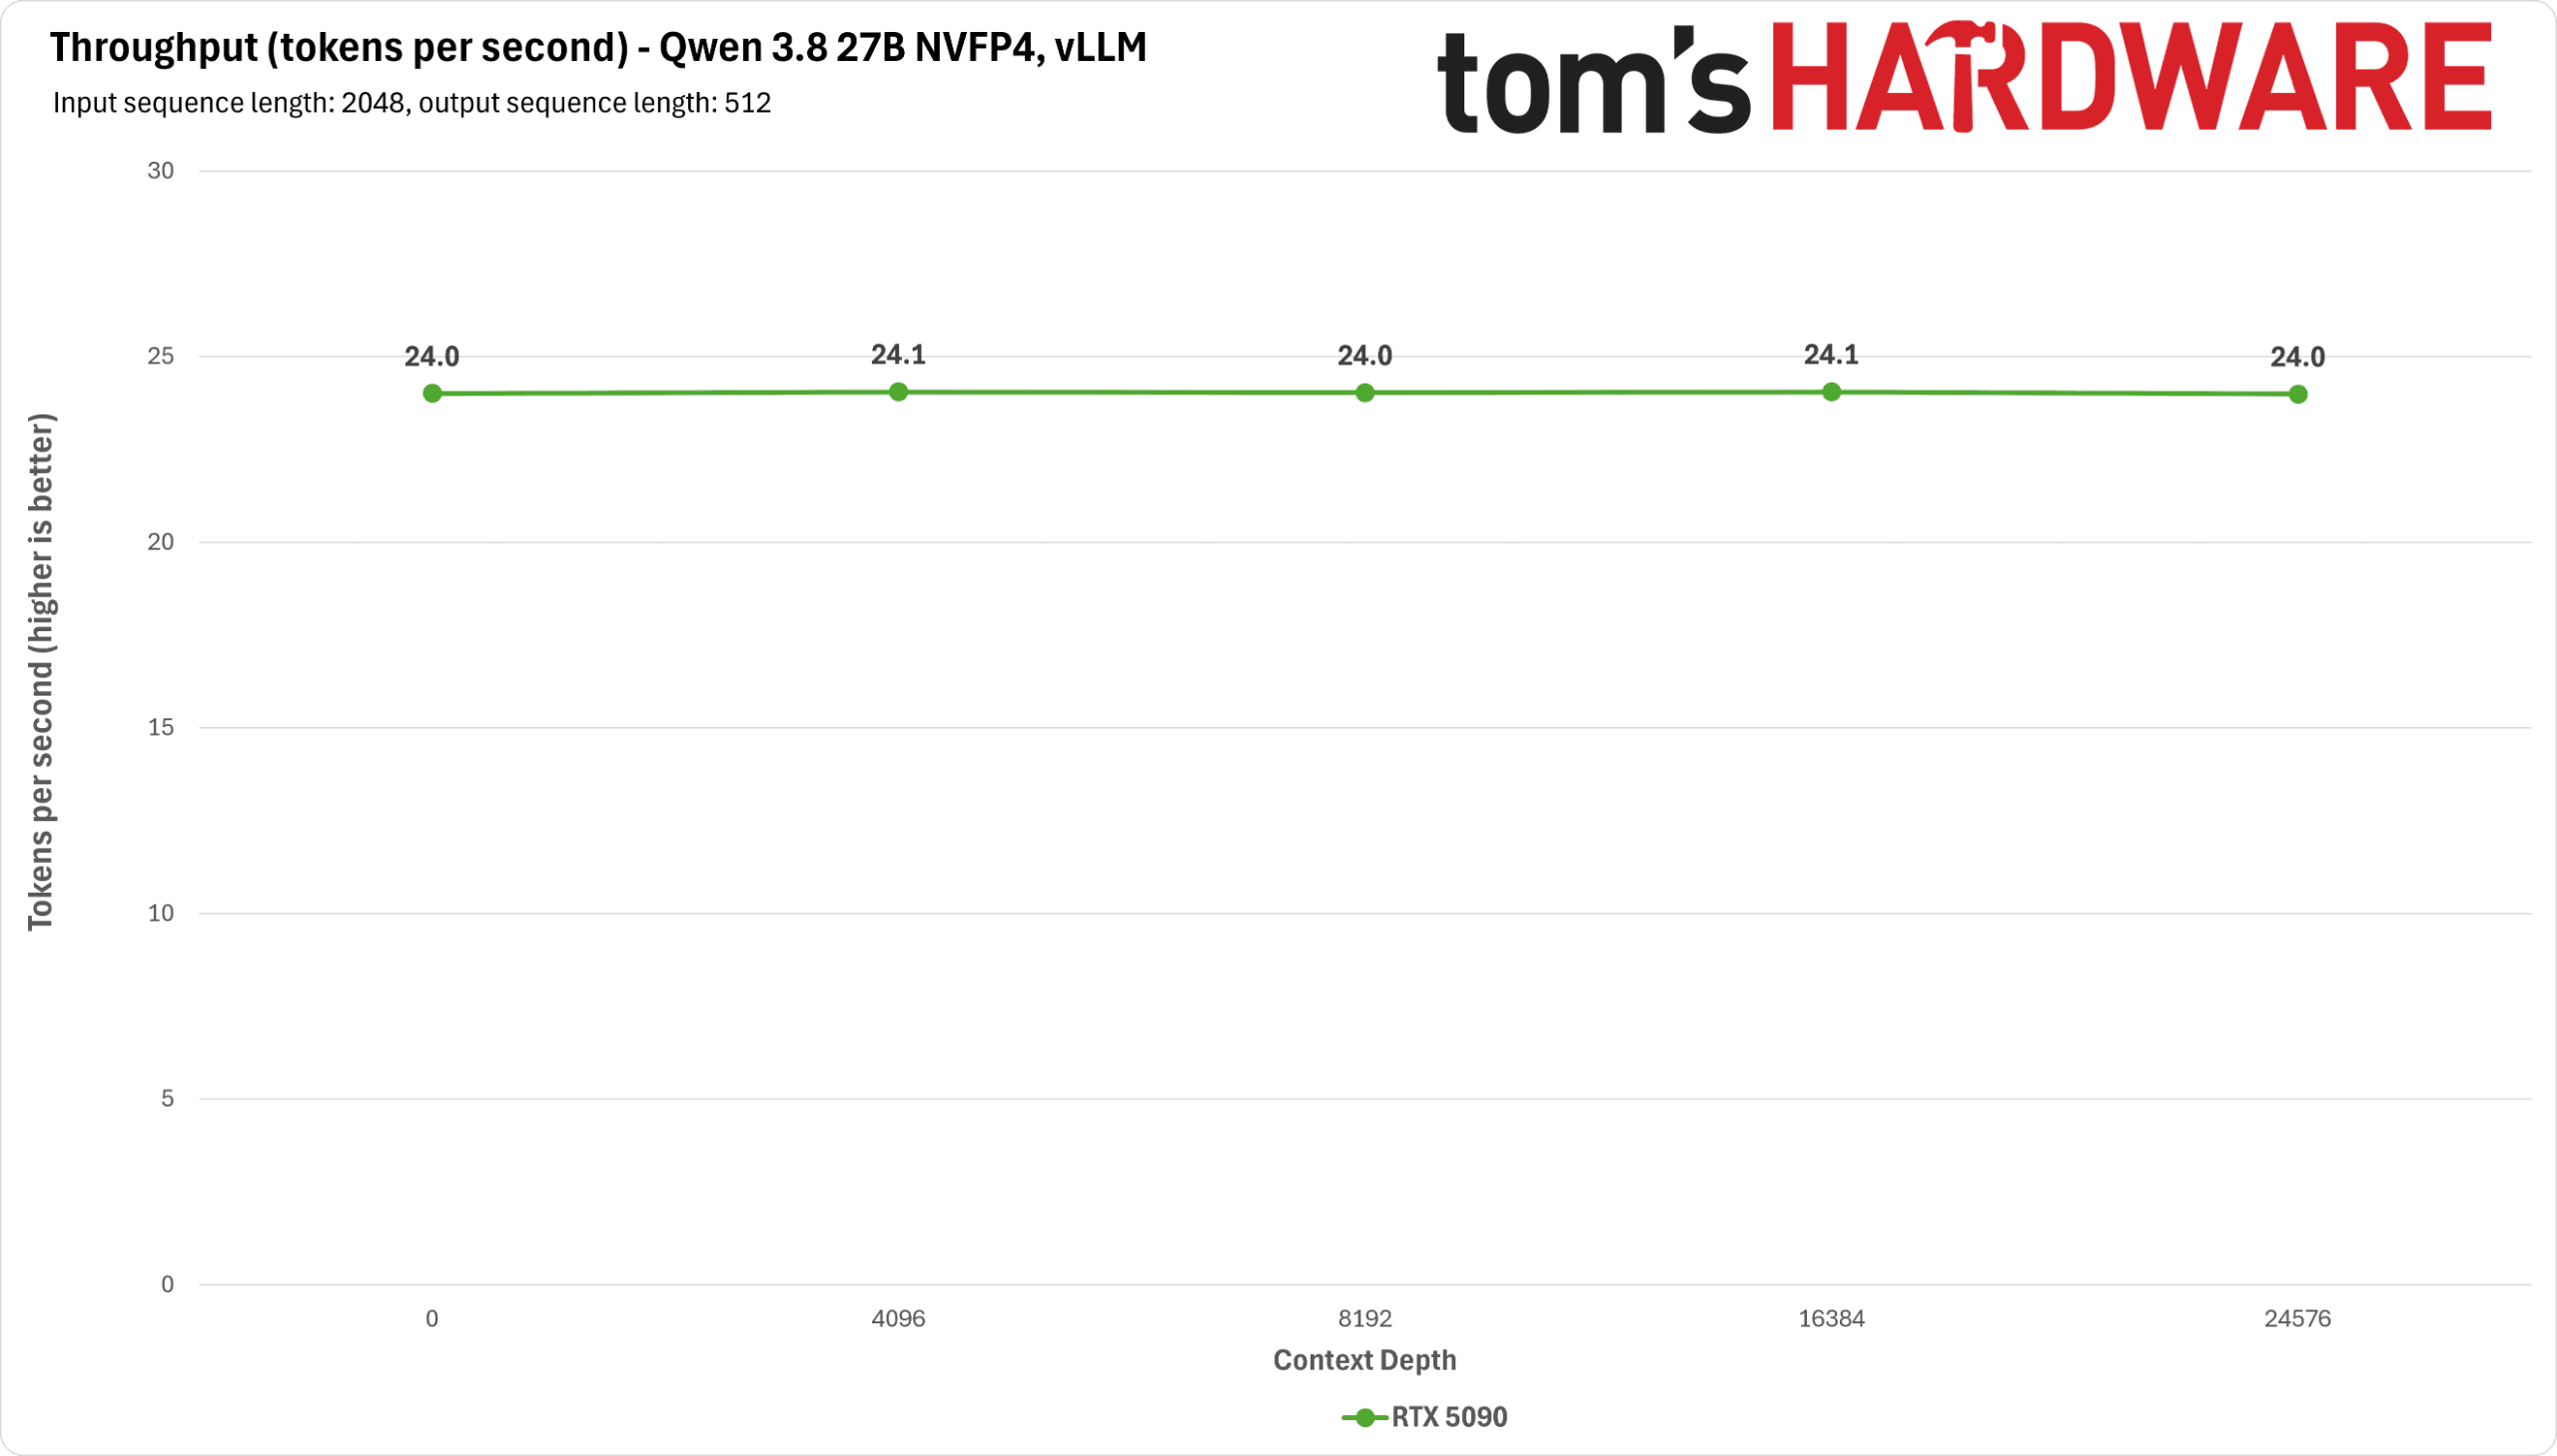
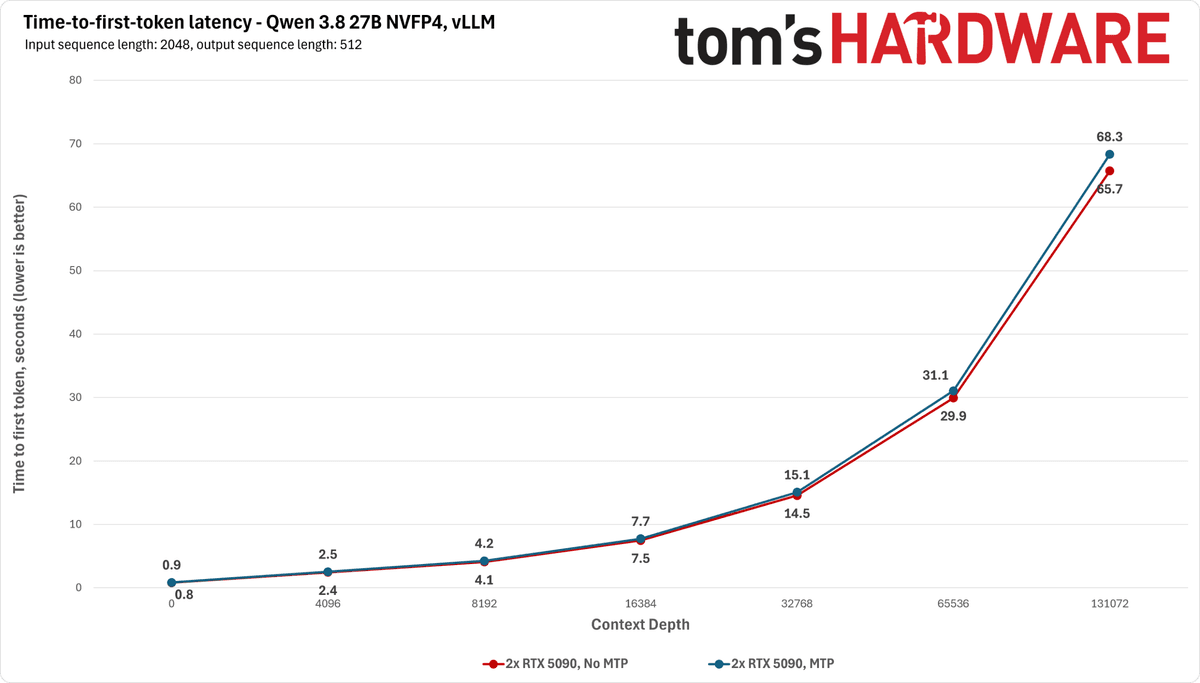
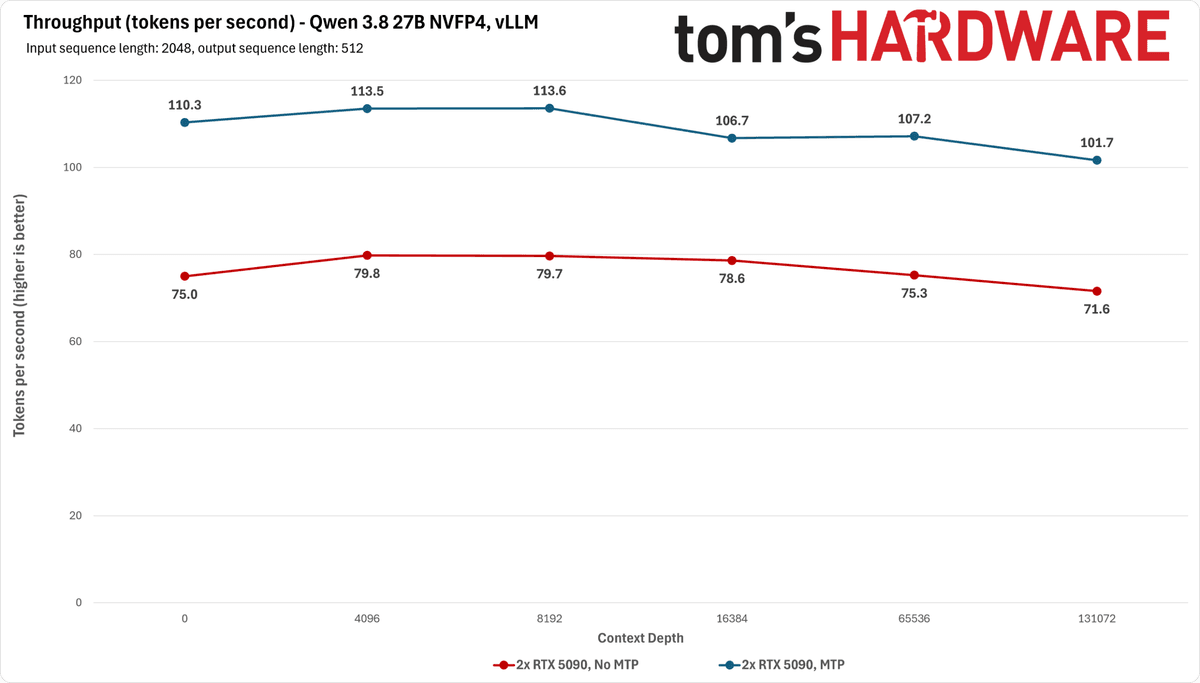
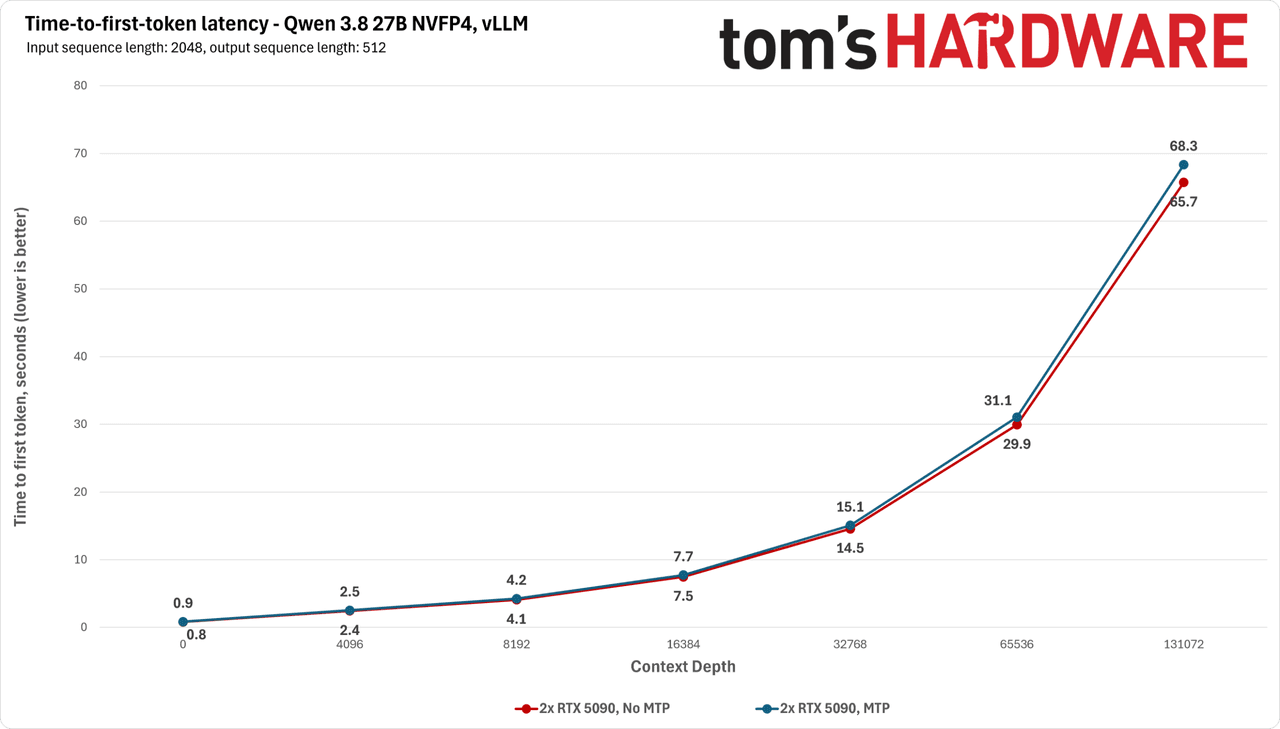
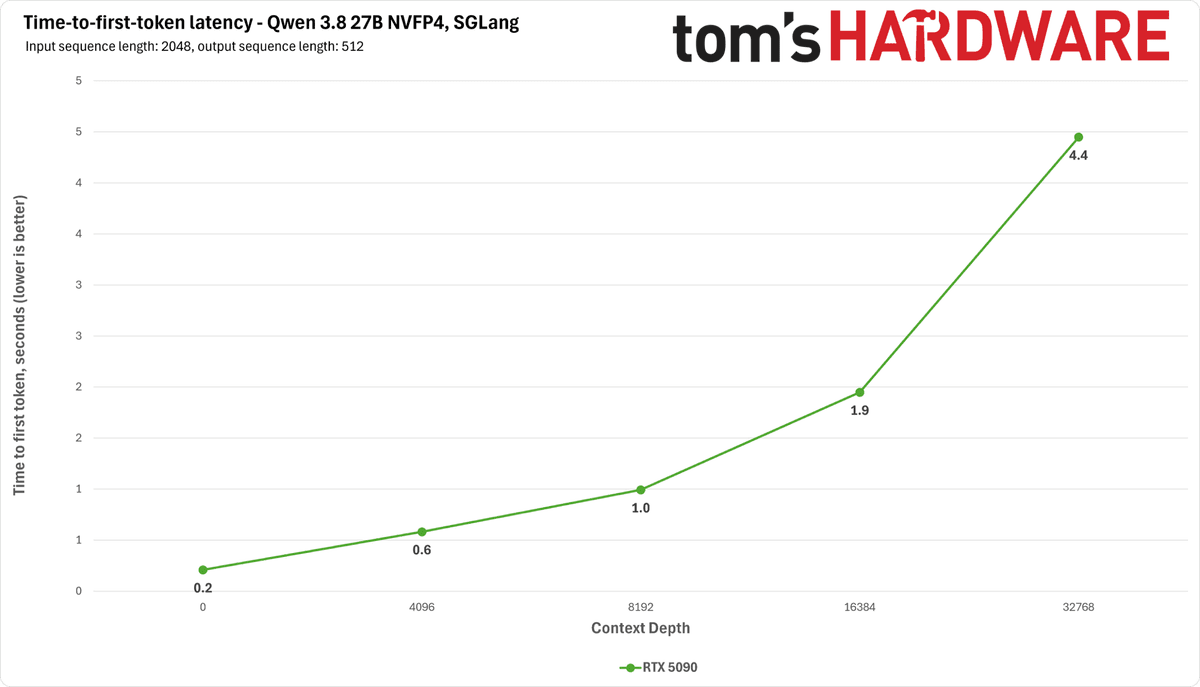
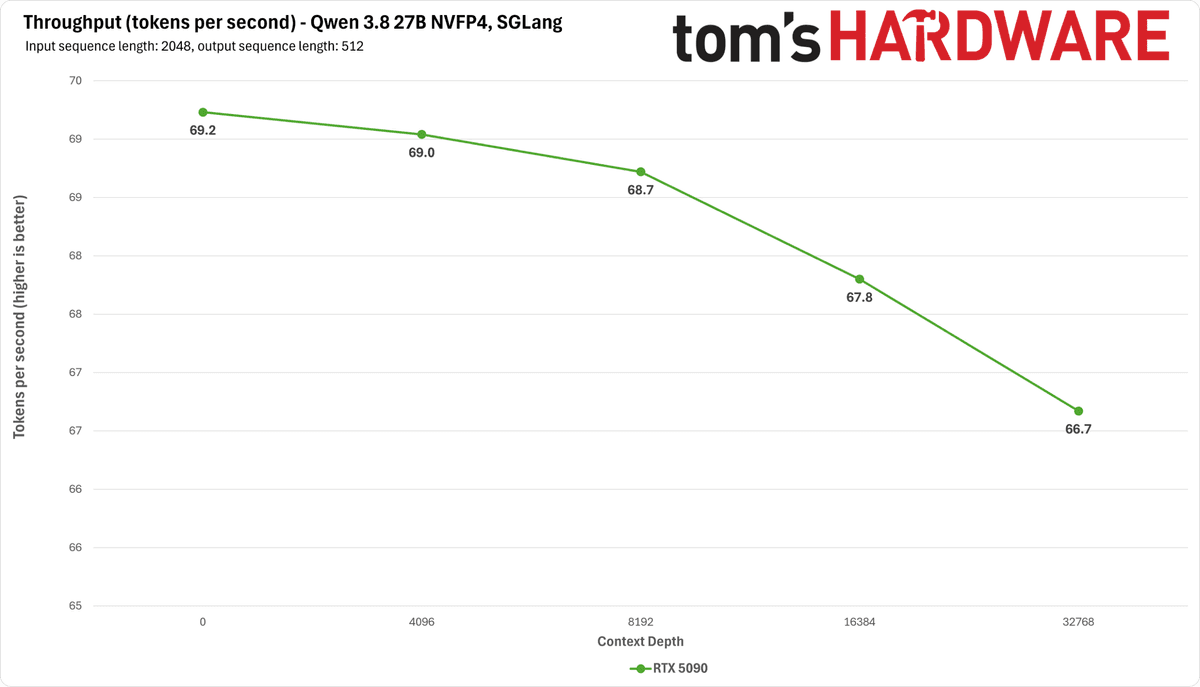
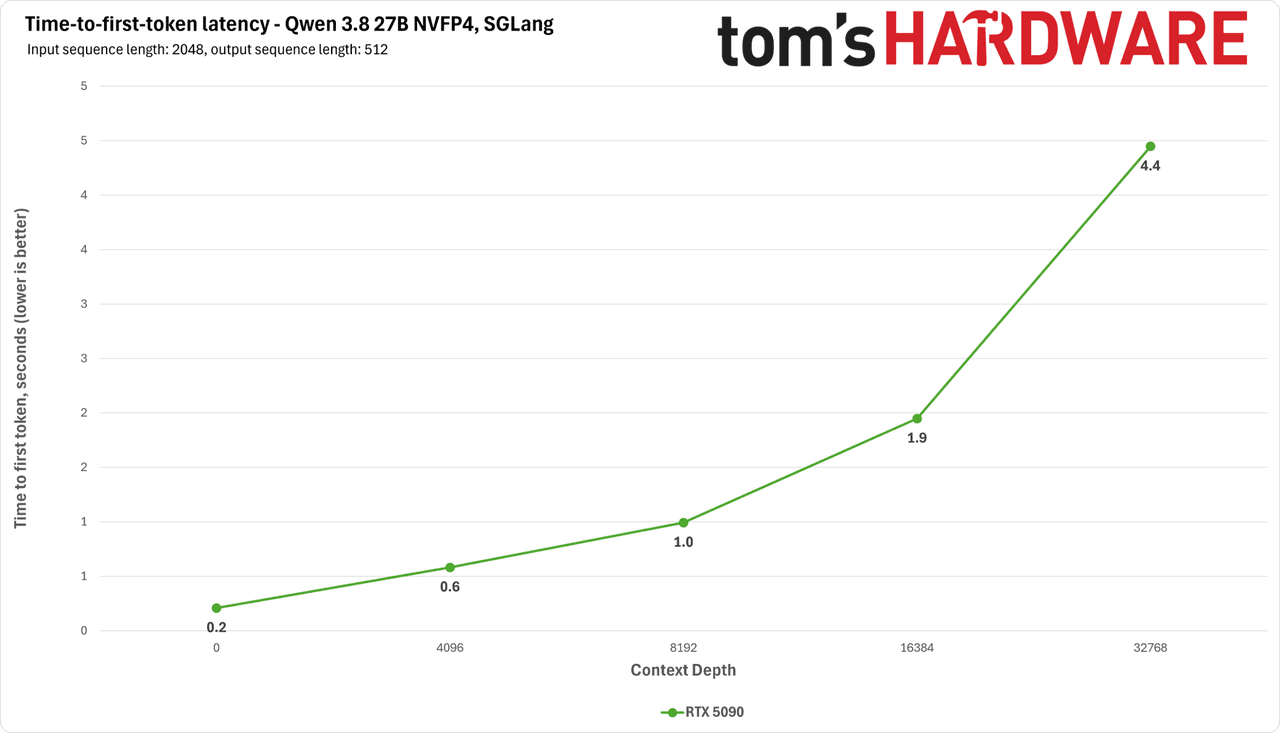
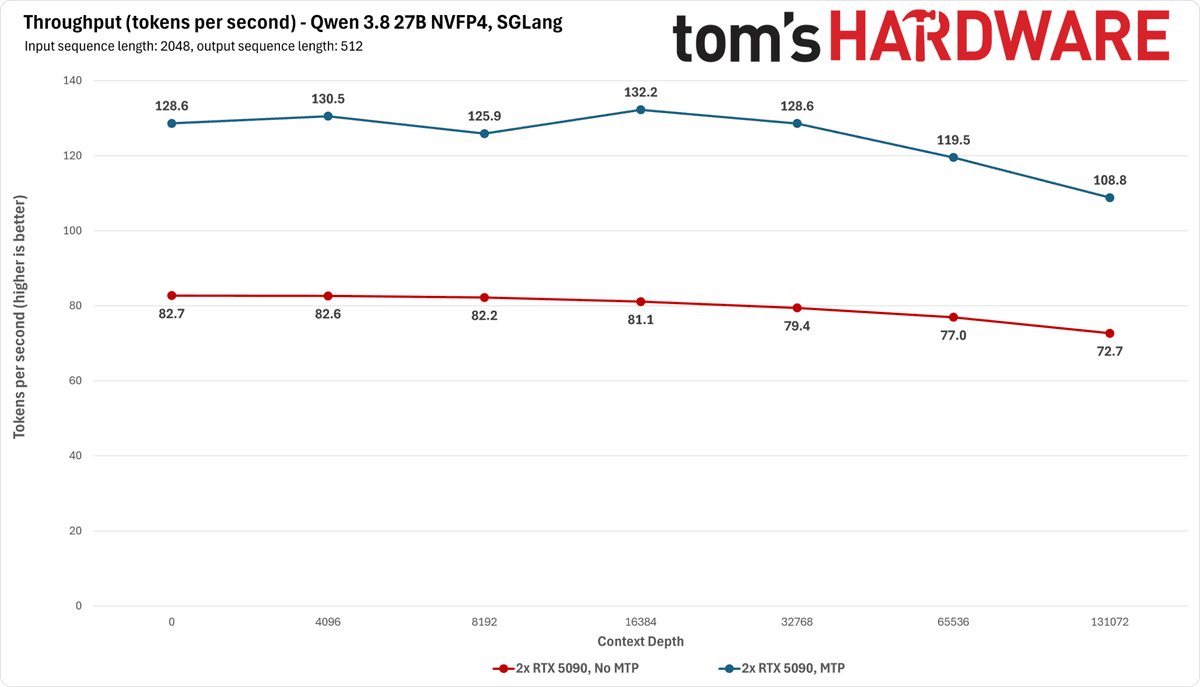
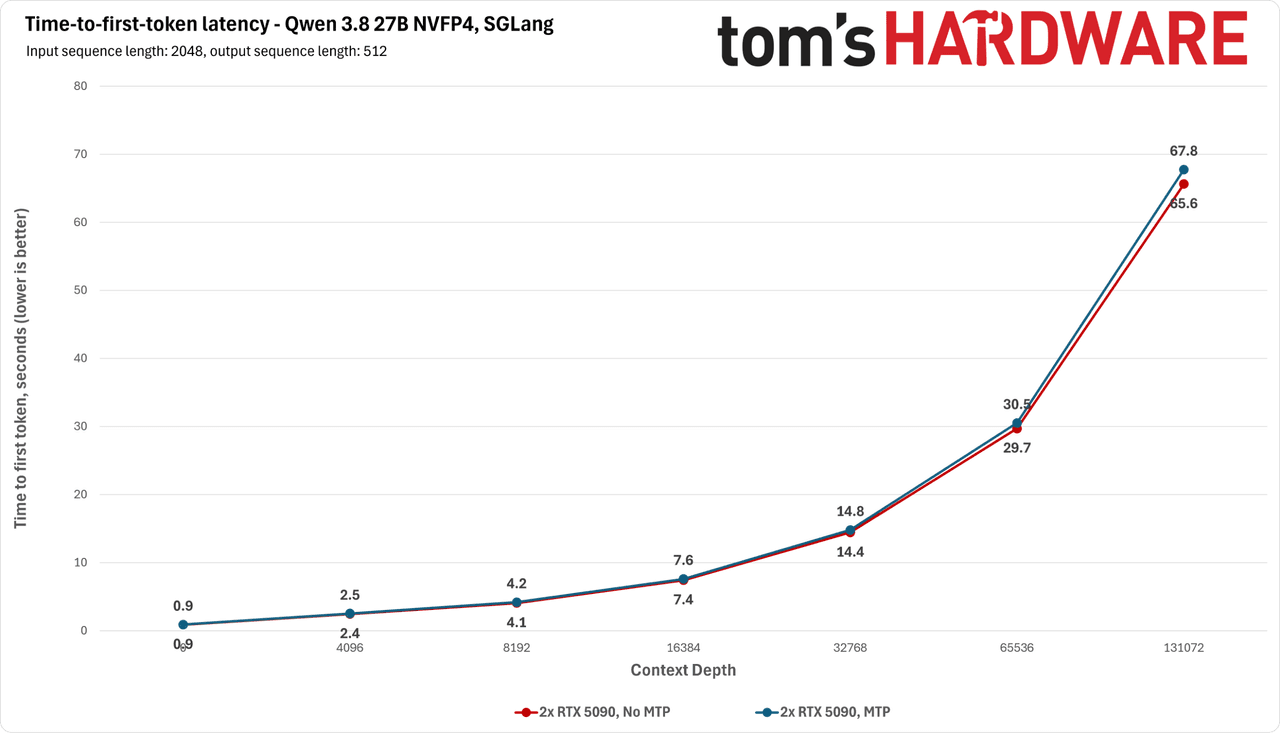
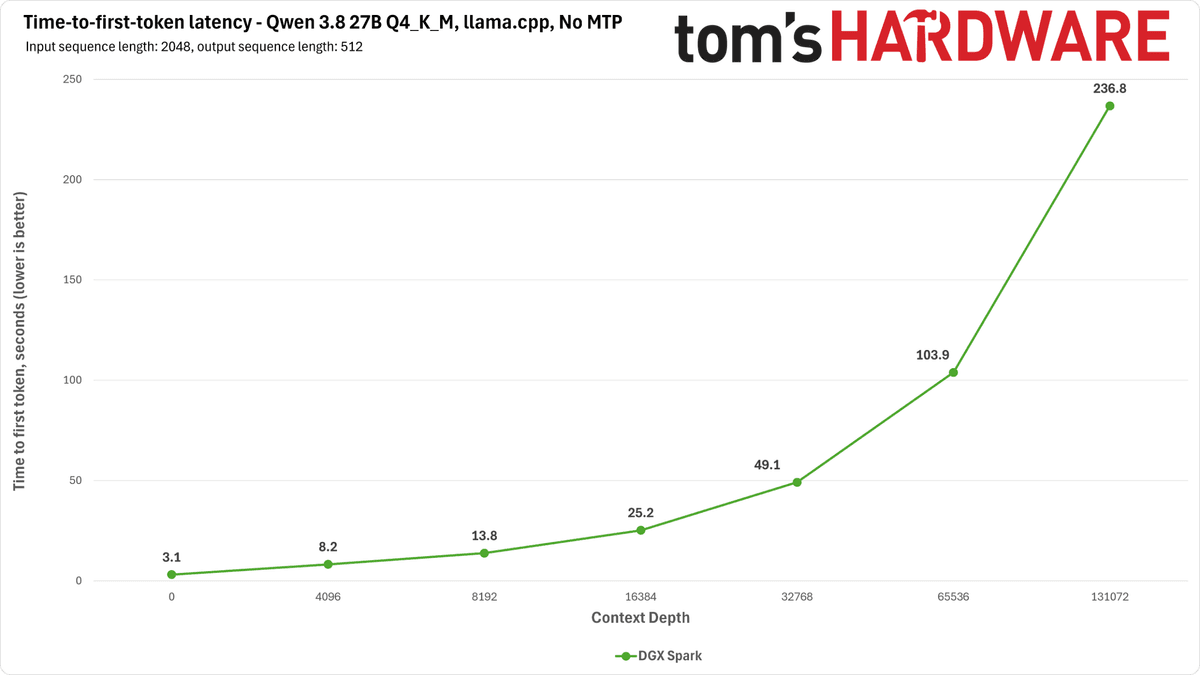
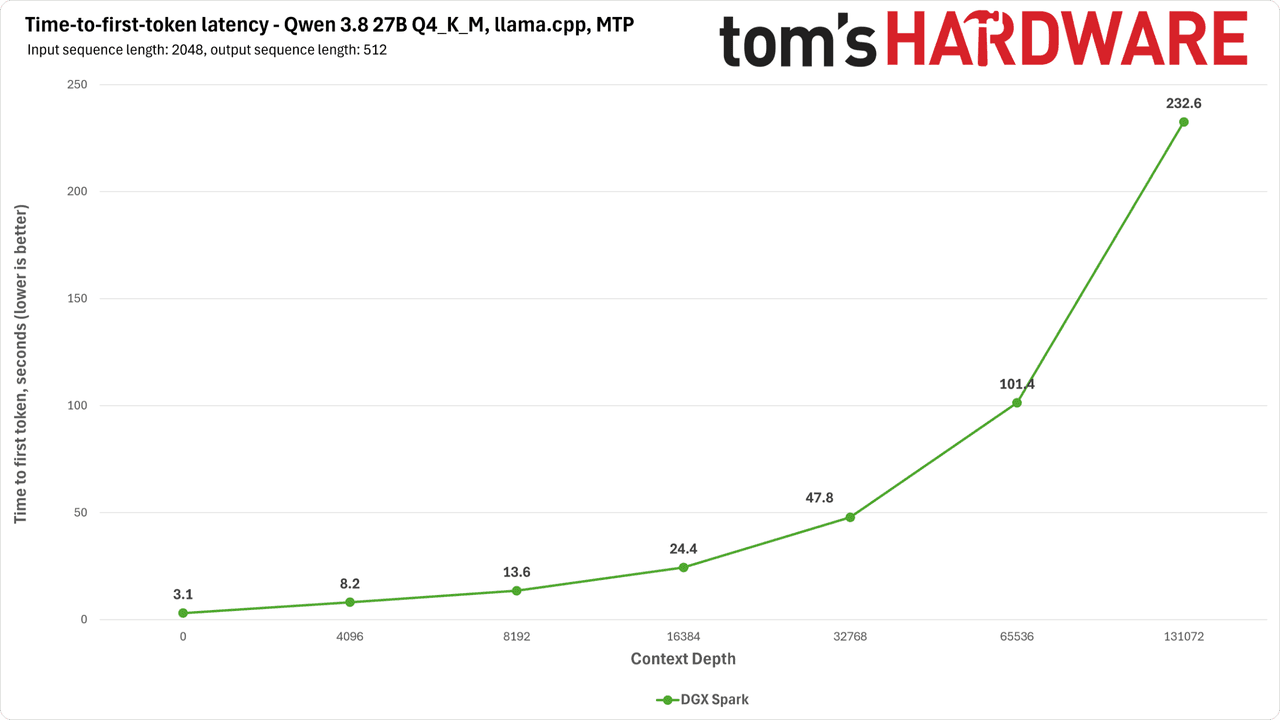
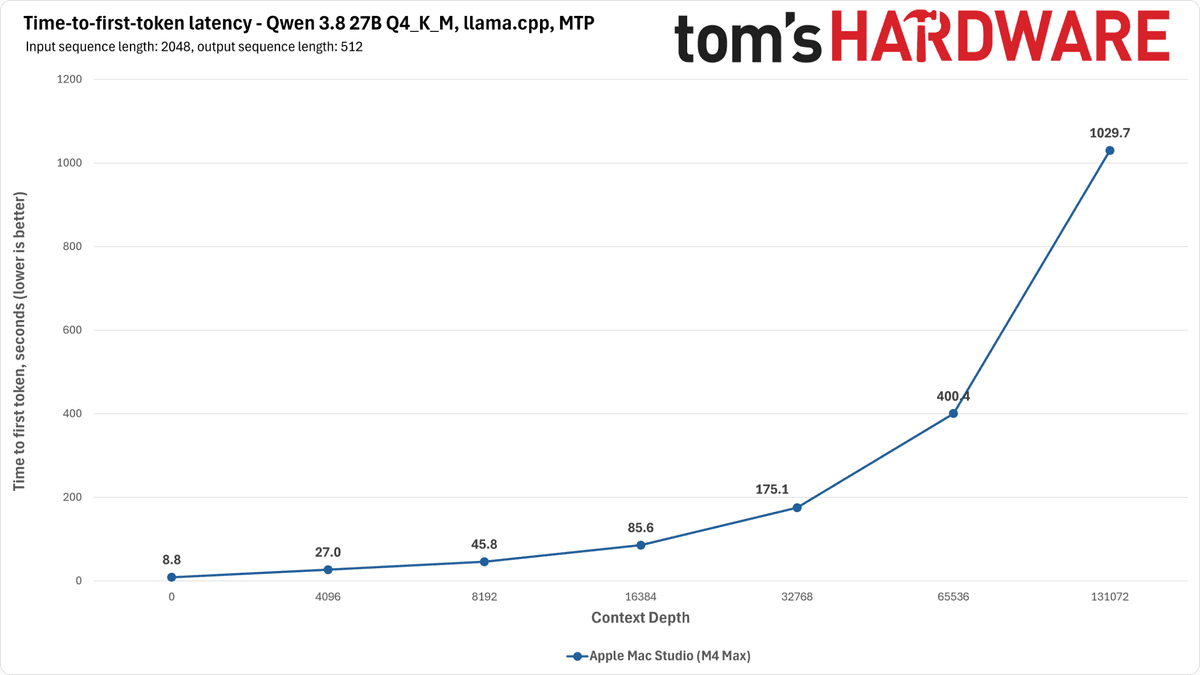
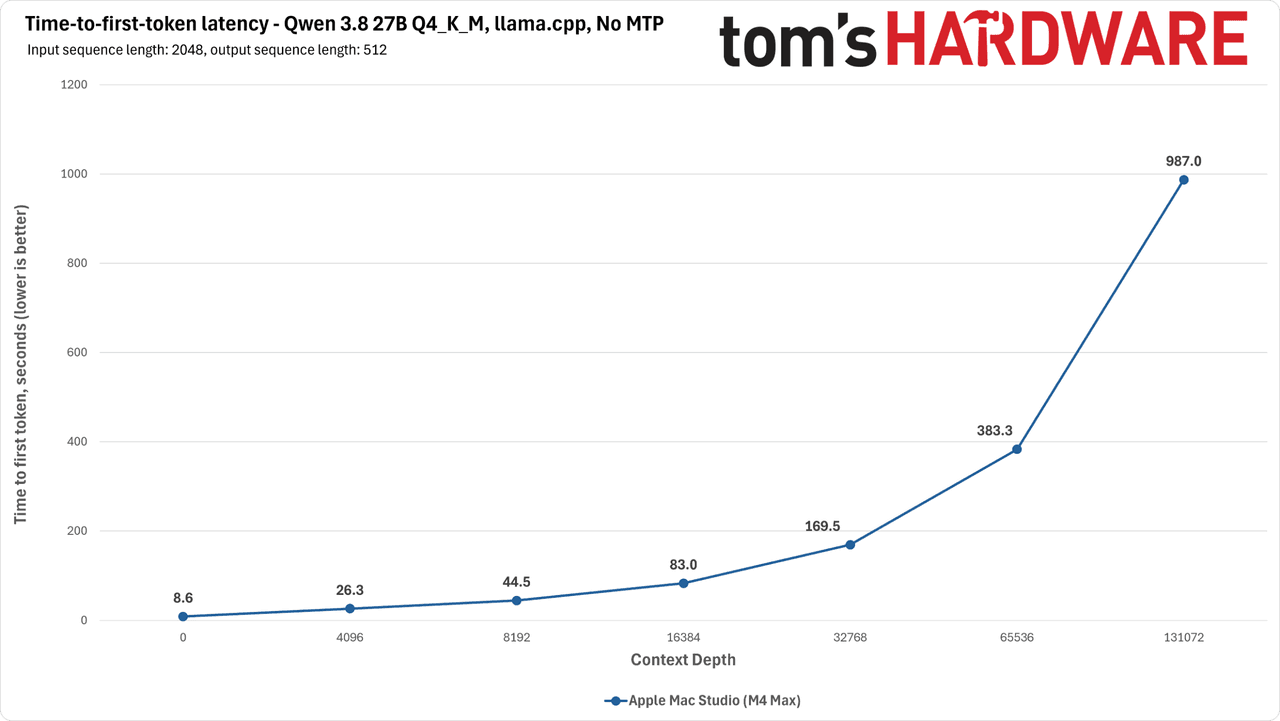
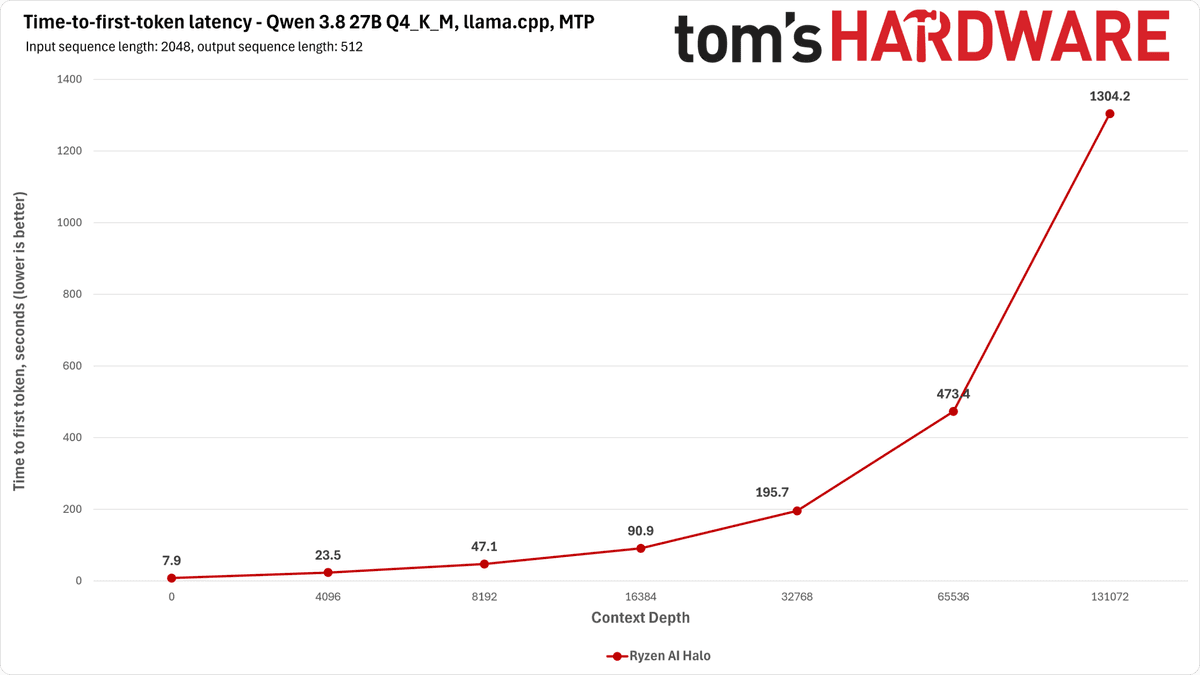
จากการทดสอบพบว่าเวลาที่ใช้ในการตอบโต้ครั้งแรก (Time-to-first-token) บน RTX 5090 เพียงใบเดียวอาจสูงถึง 30 นาที ซึ่งชี้ให้เห็นว่าปัญหาอยู่ที่ซอฟต์แวร์และเอนจินการอนุมาน (Inference) มากกว่าขีดความสามารถของฮาร์ดแวร์ โดยการเปลี่ยนไปใช้ vLLM หรือ SGLang ช่วยให้ประสิทธิภาพดีขึ้น 3 เท่า แต่จำกัดบริบทไว้ที่ 32K เท่านั้น
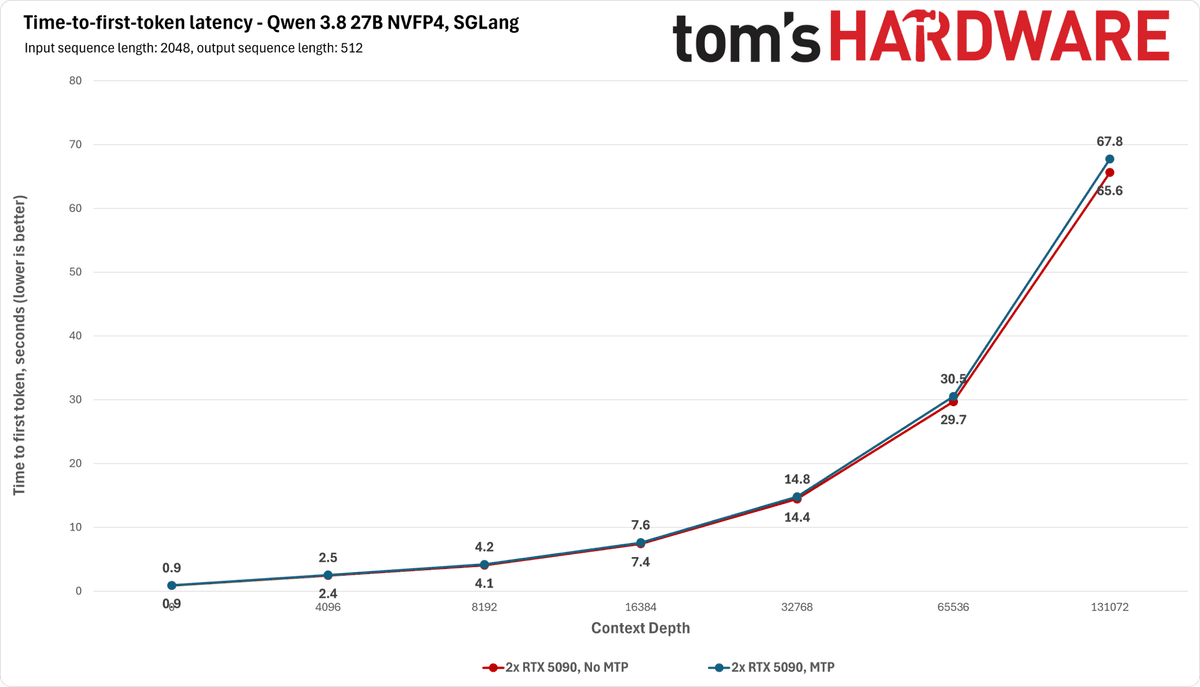
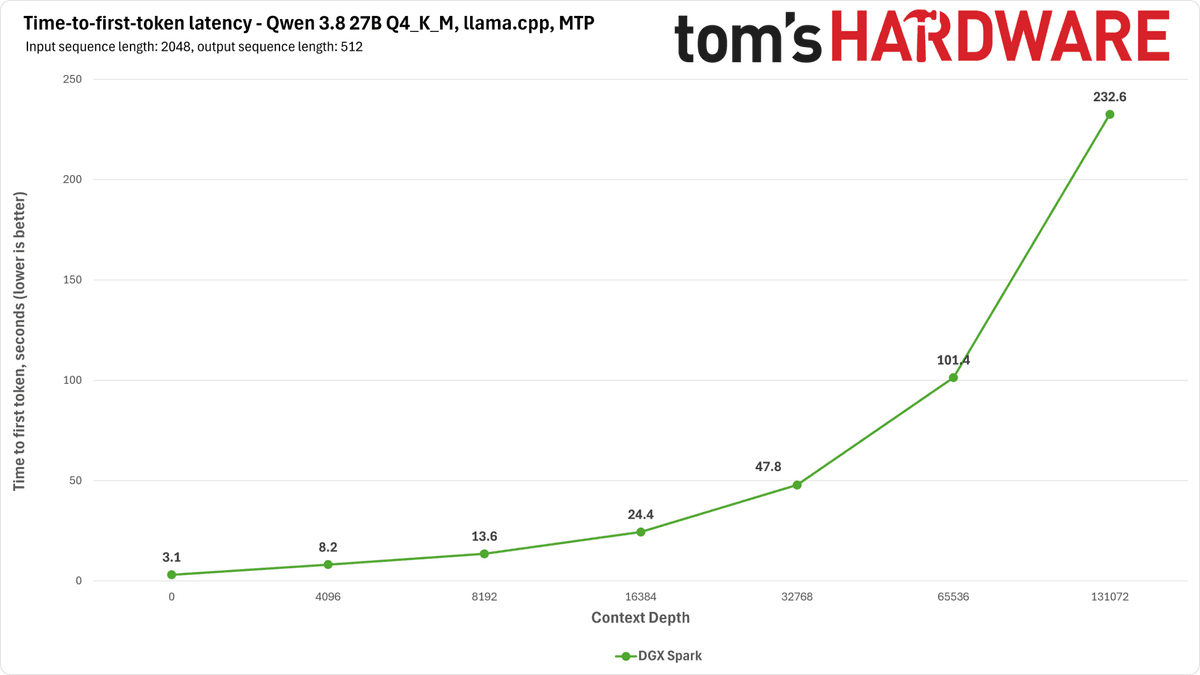
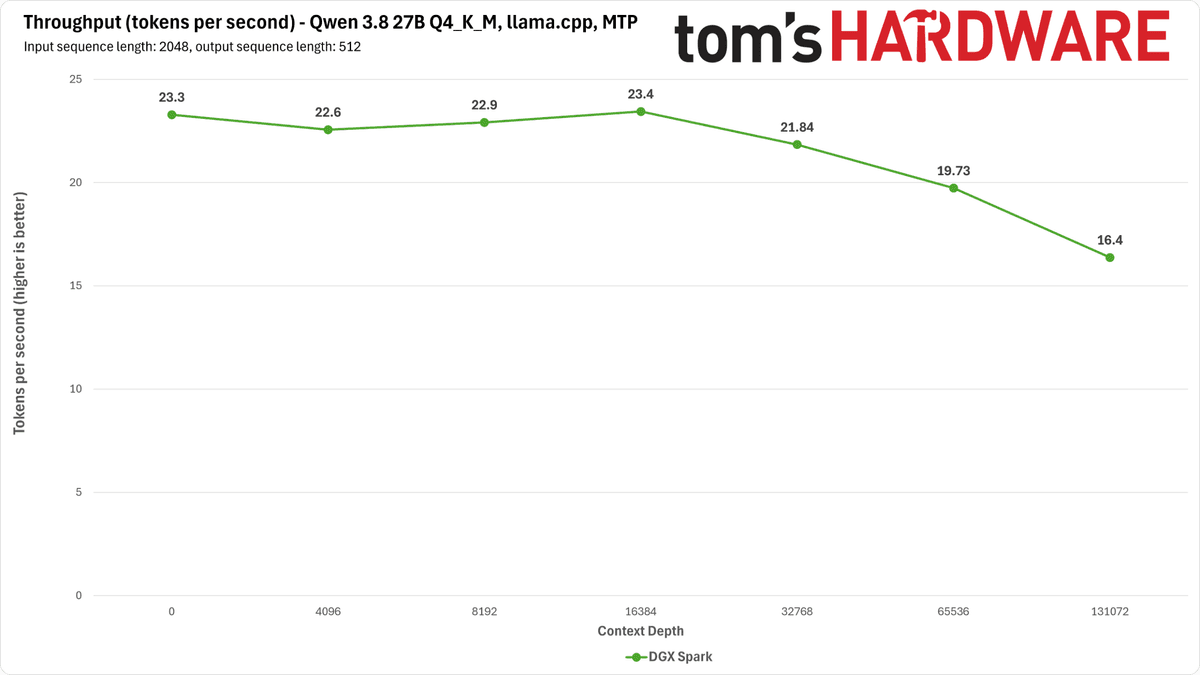
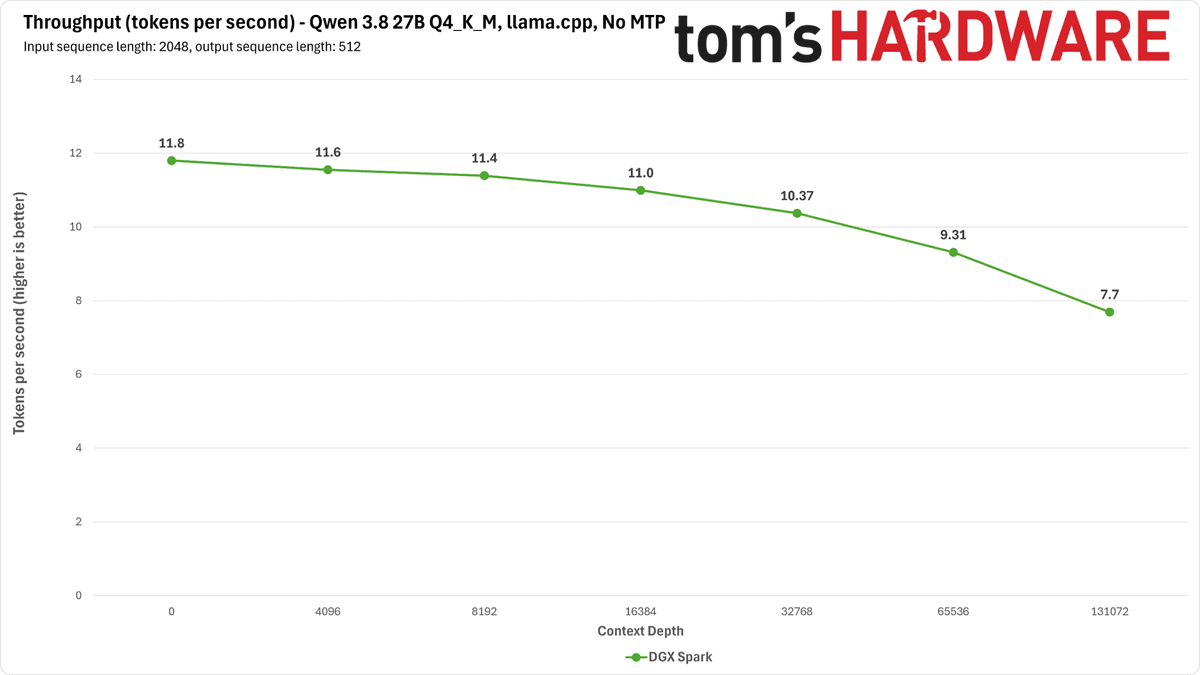
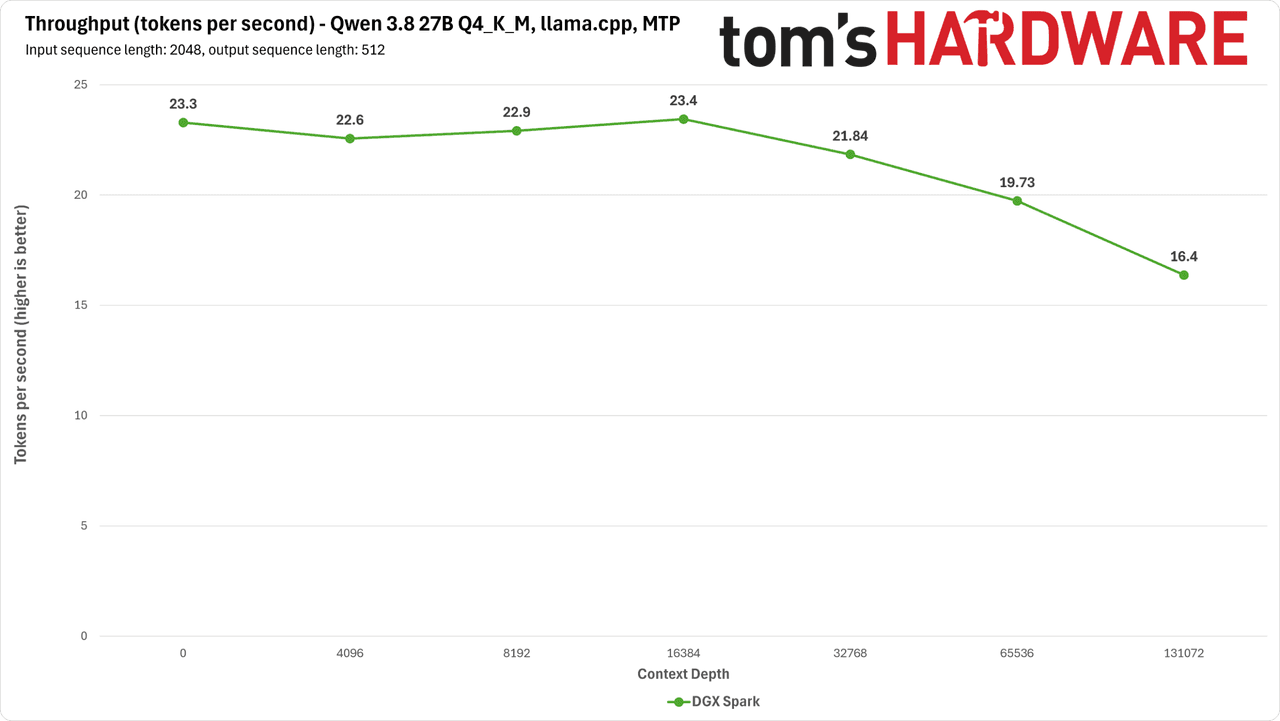
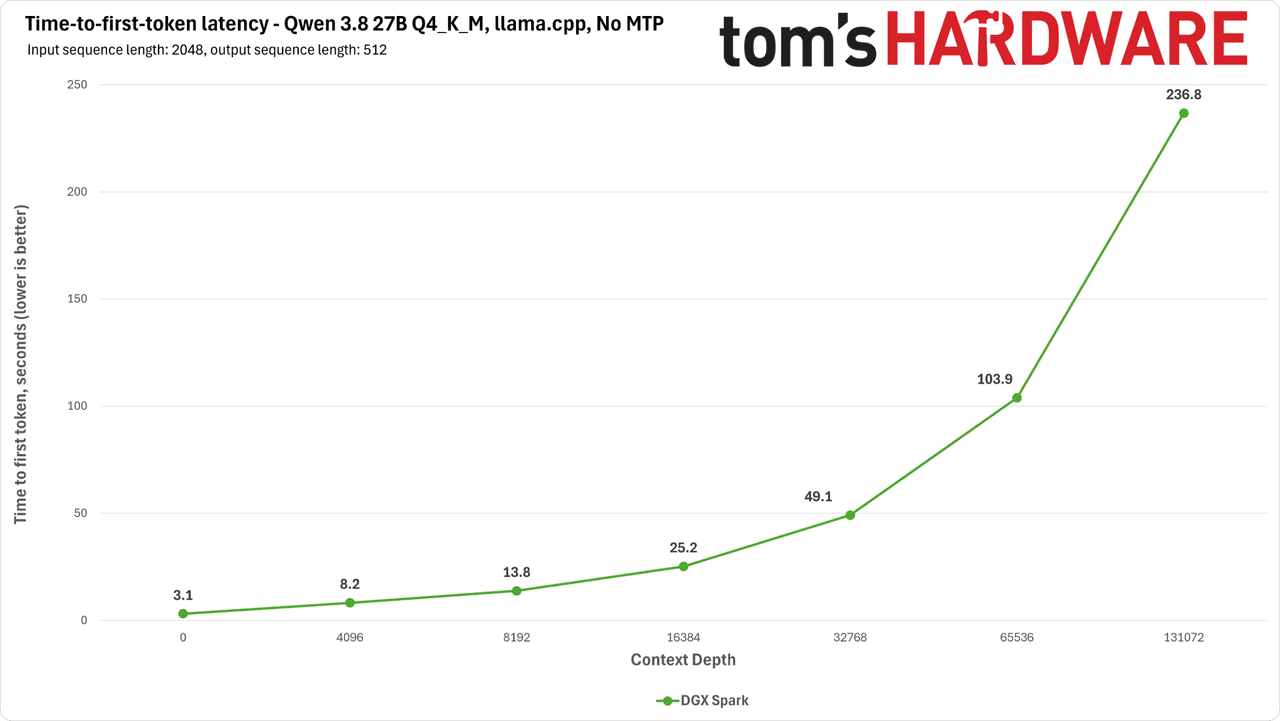
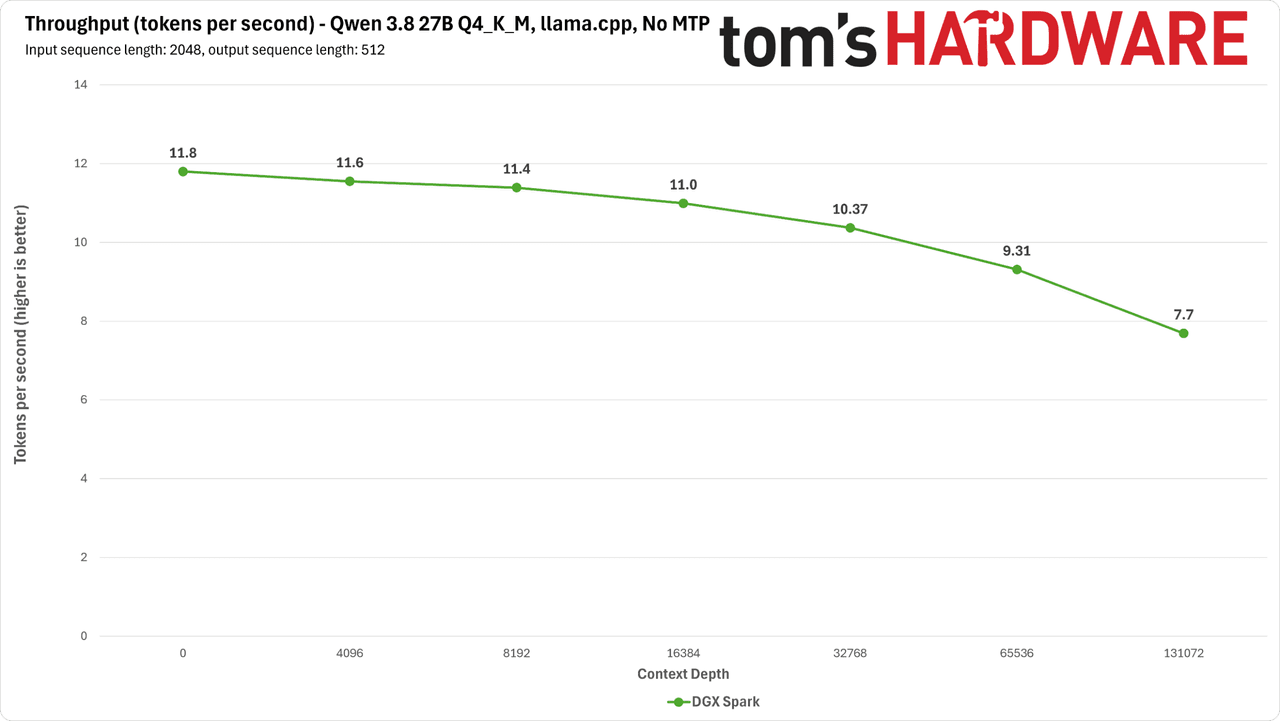
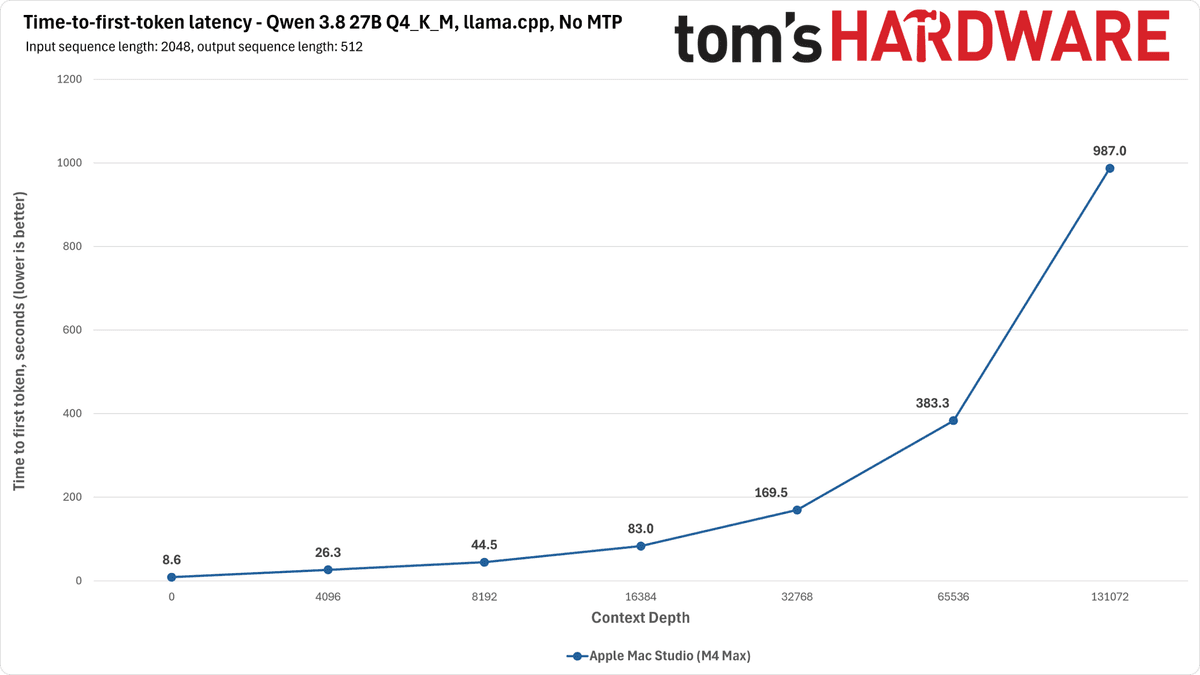
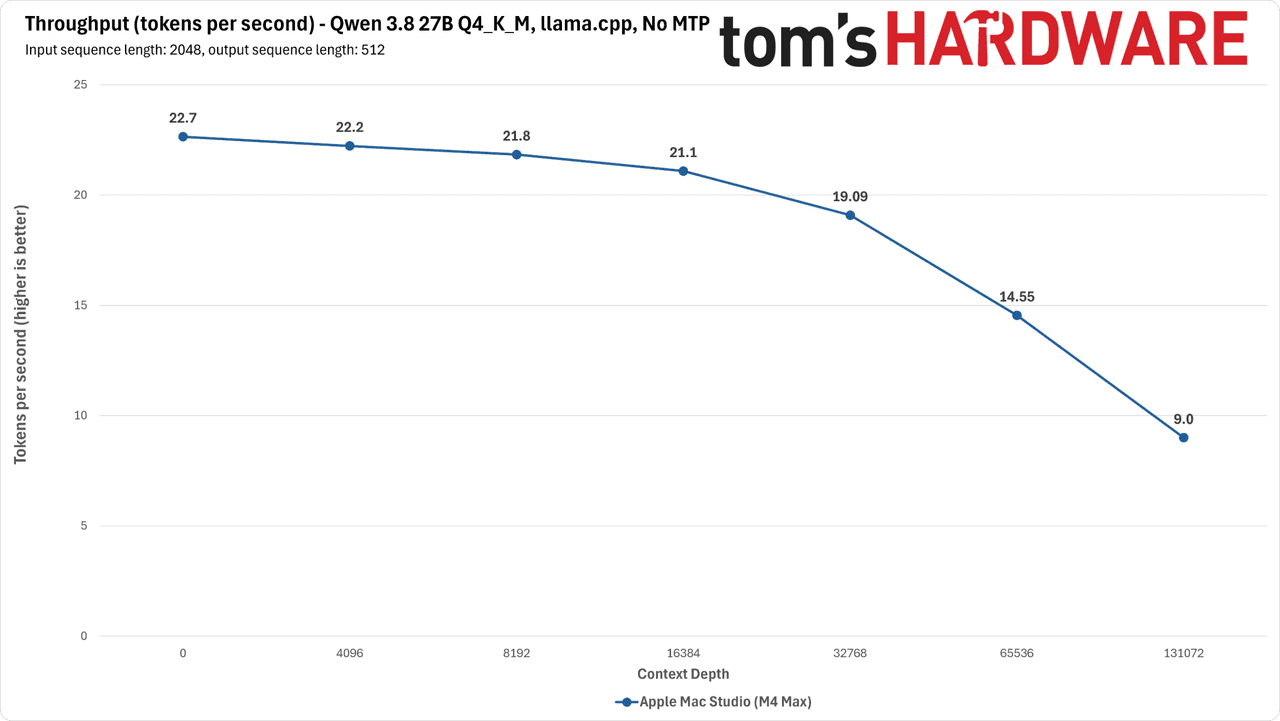
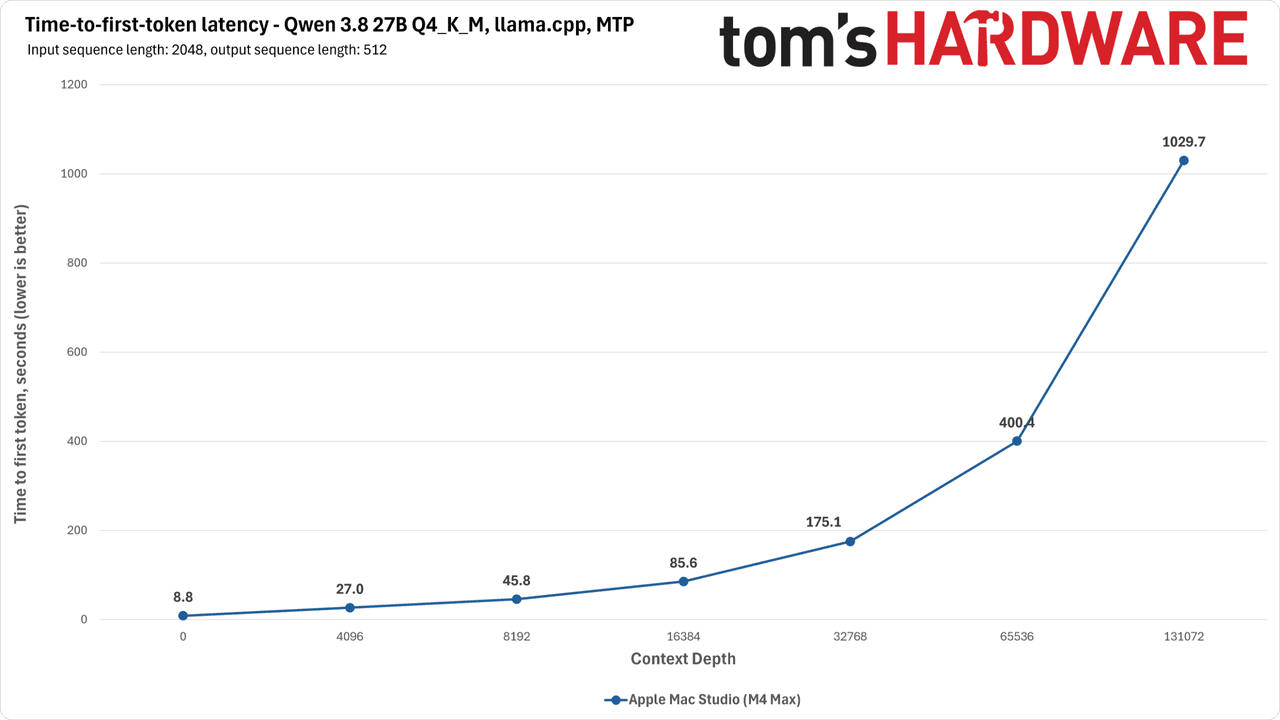
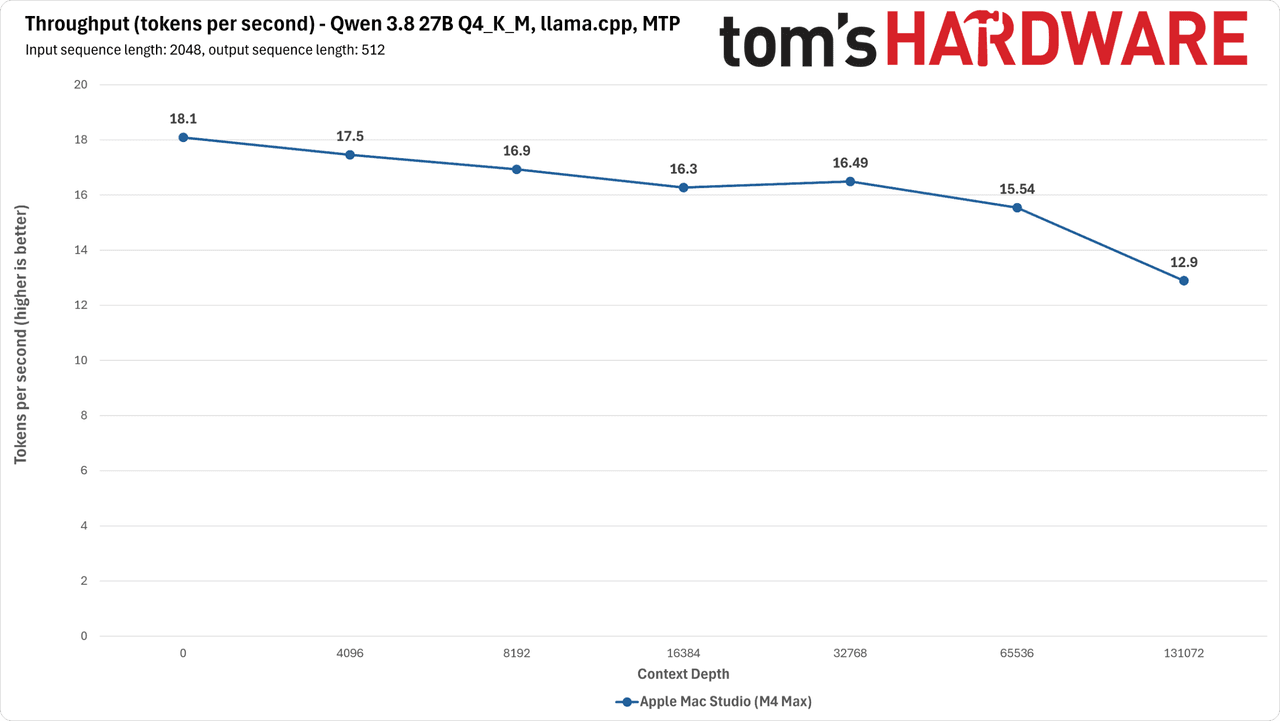
หากต้องการใช้งานให้เต็มประสิทธิภาพที่ 262K บริบทพร้อมความเร็วที่น่าพอใจ จำเป็นต้องใช้ RTX 5090 ถึง 2 ใบซึ่งมีราคาสูงกว่า 13,000 ดอลลาร์ ในขณะที่ระบบ Unified Memory อย่าง DGX Spark และ Mac Studio M4 Max ให้ผลลัพธ์ที่น่าสนใจในด้านความเร็วการประมวลผลคำสั่งเบื้องต้น (Prefill) แม้จะมีแบนด์วิดท์ต่ำกว่าก็ตาม
บทสรุปของการทดสอบชี้ให้เห็นว่าการเลือกซอฟต์แวร์และเอนจินให้เหมาะสมกับฮาร์ดแวร์มีความสำคัญพอๆ กับสเปกเครื่อง หากไม่ได้เน้นเรื่องความปลอดภัยของข้อมูลหรือการปรับแต่งเฉพาะทาง การใช้บริการโมเดลผ่านระบบคลาวด์อาจคุ้มค่าและรวดเร็วกว่าการลงทุนสร้างเครื่องโลคัลราคาแพงในขณะนี้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร