
BotPsy: โมเดล AI ขนาดเล็กกว่าพันล้านพารามิเตอร์เพื่อผู้ช่วยส่วนตัวบนอุปกรณ์
Frontier cloud LLM ในปัจจุบันมีต้นทุนการดำเนินงานสูงและผันผวนได้ง่าย อีกทั้งการพึ่งพาโมเดลบุคคลที่สามยังสร้างความเสี่ยงด้านความเป็นส่วนตัวและการควบคุมข้อมูล เนื่องจากผู้ให้บริการอาจจำกัดการเข้าถึงได้ทุกเมื่อ นอกจากนี้ งานประจำวันส่วนใหญ่ไม่จำเป็นต้องใช้ความฉลาดระดับสูงสุดเสมอไป เอเจนท์ขนาดเล็กที่เชี่ยวชาญเฉพาะทางจึงเป็นทางเลือกที่คุ้มค่ากว่าในการประมวลผลบนอุปกรณ์ (on-device) เพื่อความปลอดภัยและความรวดเร็ว
Tether AI Research จึงขอแนะนำ BotPsy โมเดลขนาด 0.8B พารามิเตอร์ที่สร้างขึ้นบน Qwen3.5-0.8B เพื่อรองรับ function calling และ agentic workflows โดยเฉพาะ BotPsy ถูกออกแบบมาให้เป็น "ผู้ช่วยส่วนตัว" ที่จัดการงานได้หลากหลาย ตั้งแต่การค้นหาเว็บ การเงิน ธุรกิจ ไปจนถึงการควบคุมอุปกรณ์และจัดการเอกสาร ด้วยขนาดที่เล็กจึงเหมาะสำหรับงานความยากระดับต่ำถึงปานกลาง และให้ประสิทธิภาพระดับ state-of-the-art (SOTA) เมื่อเทียบกับโมเดลในกลุ่มเดียวกัน
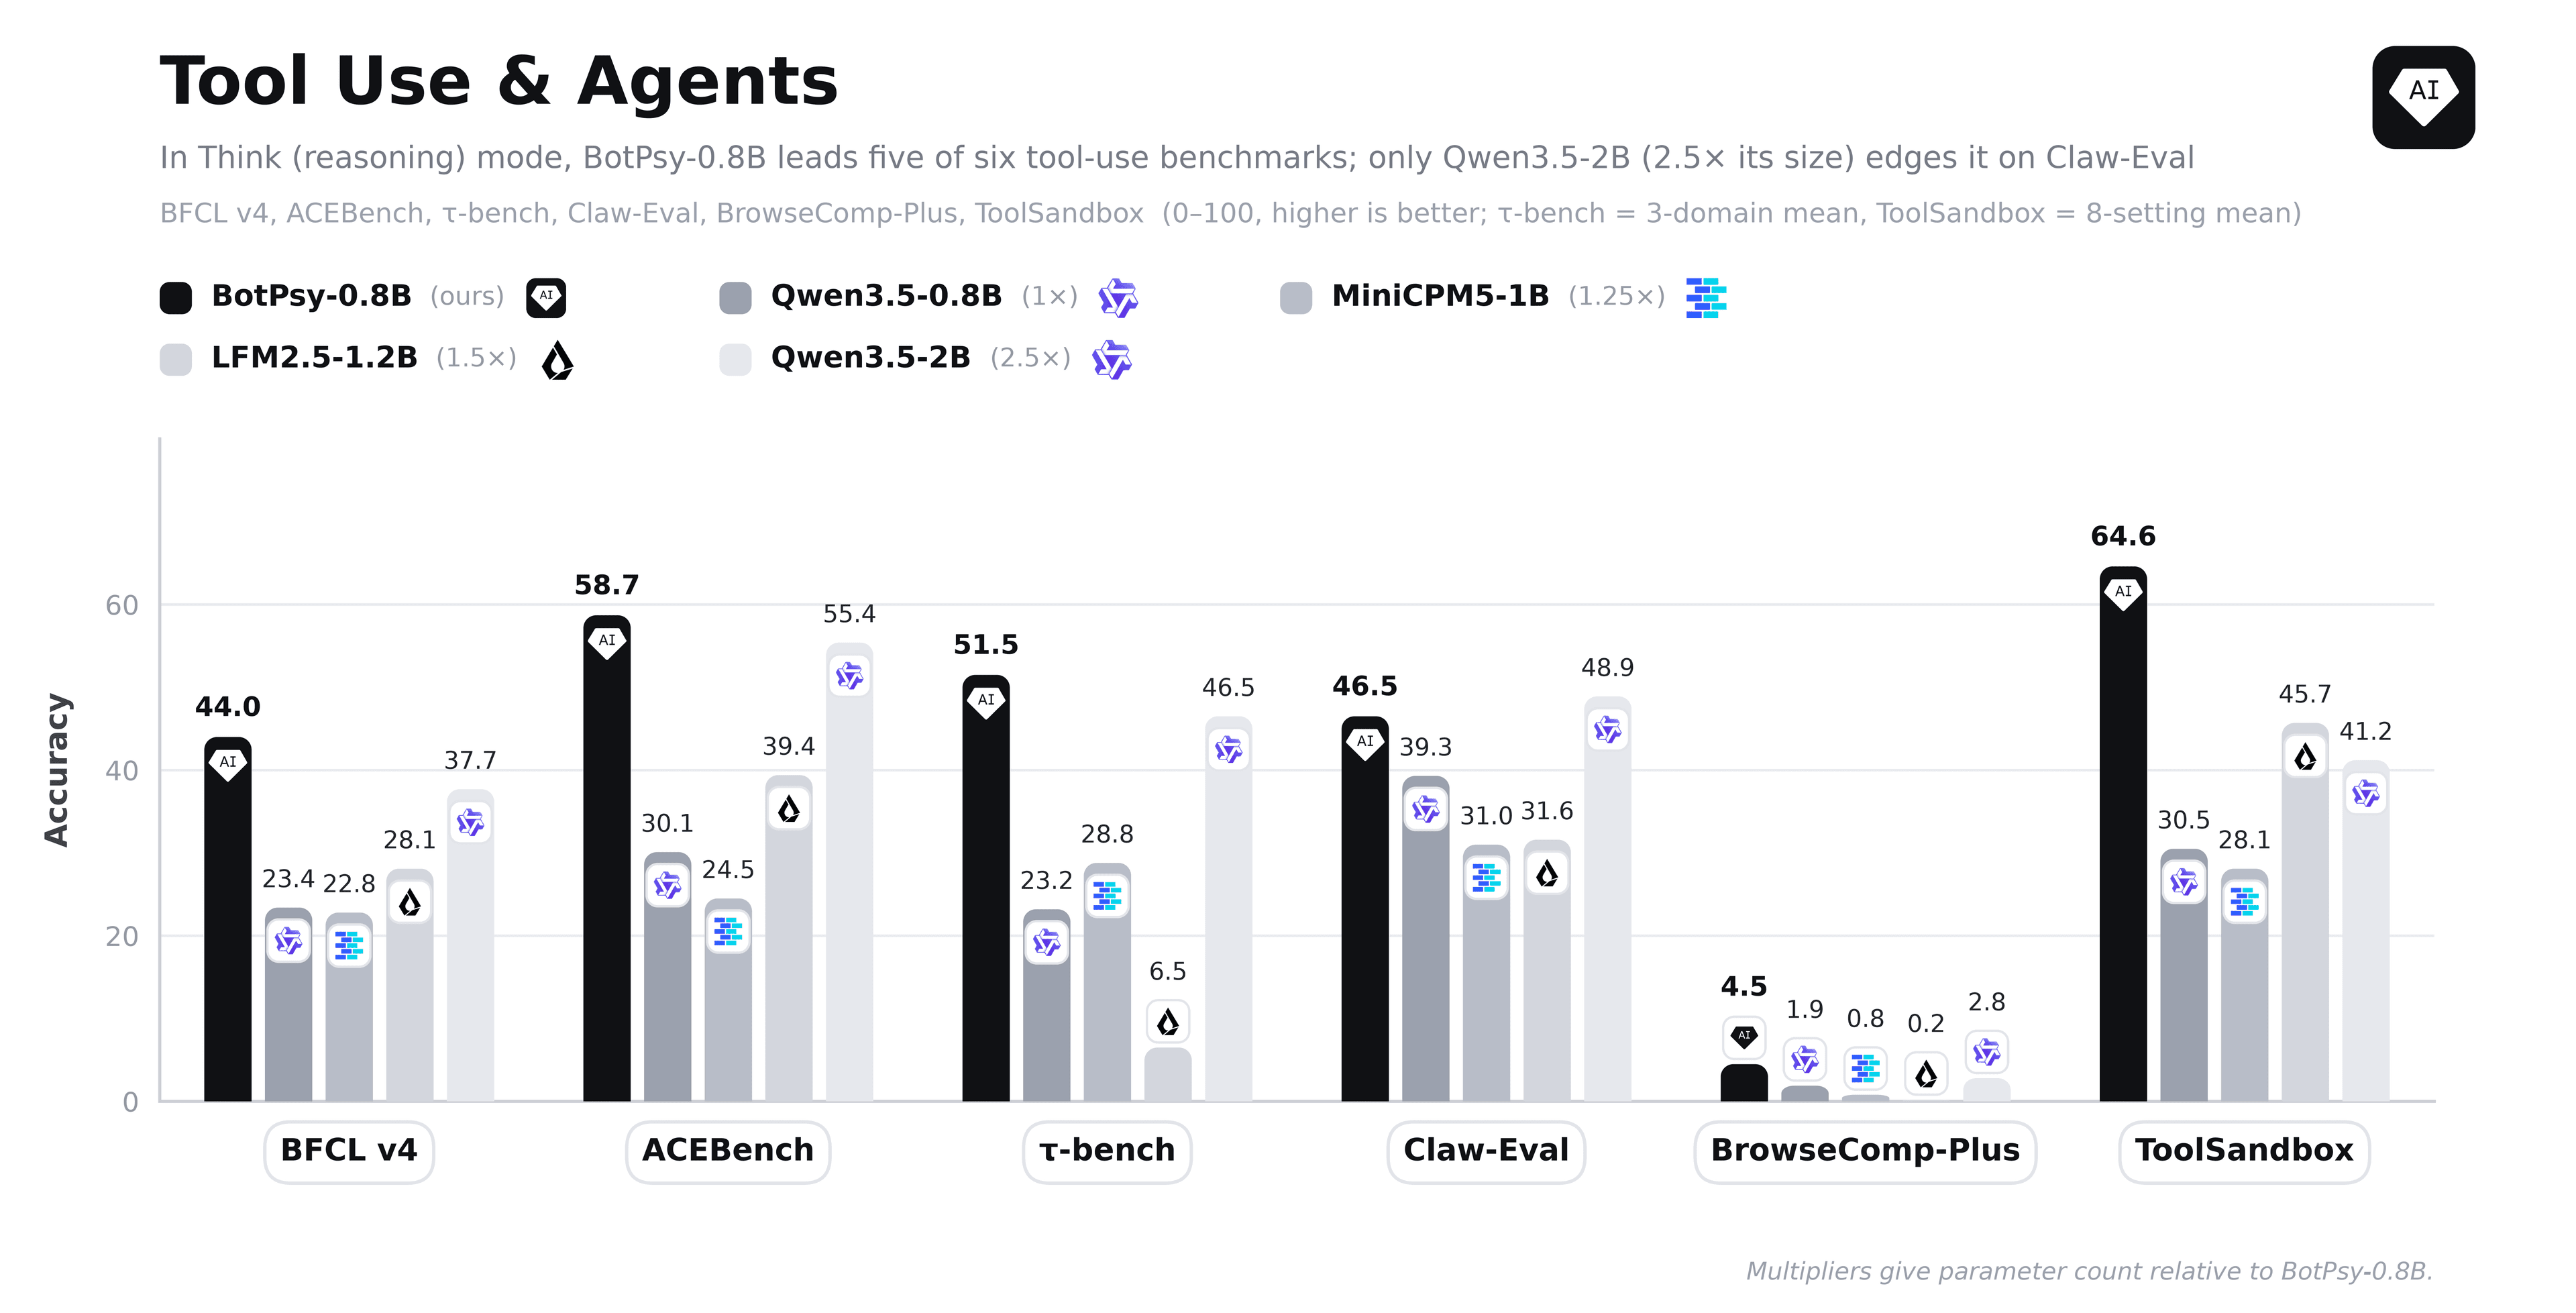
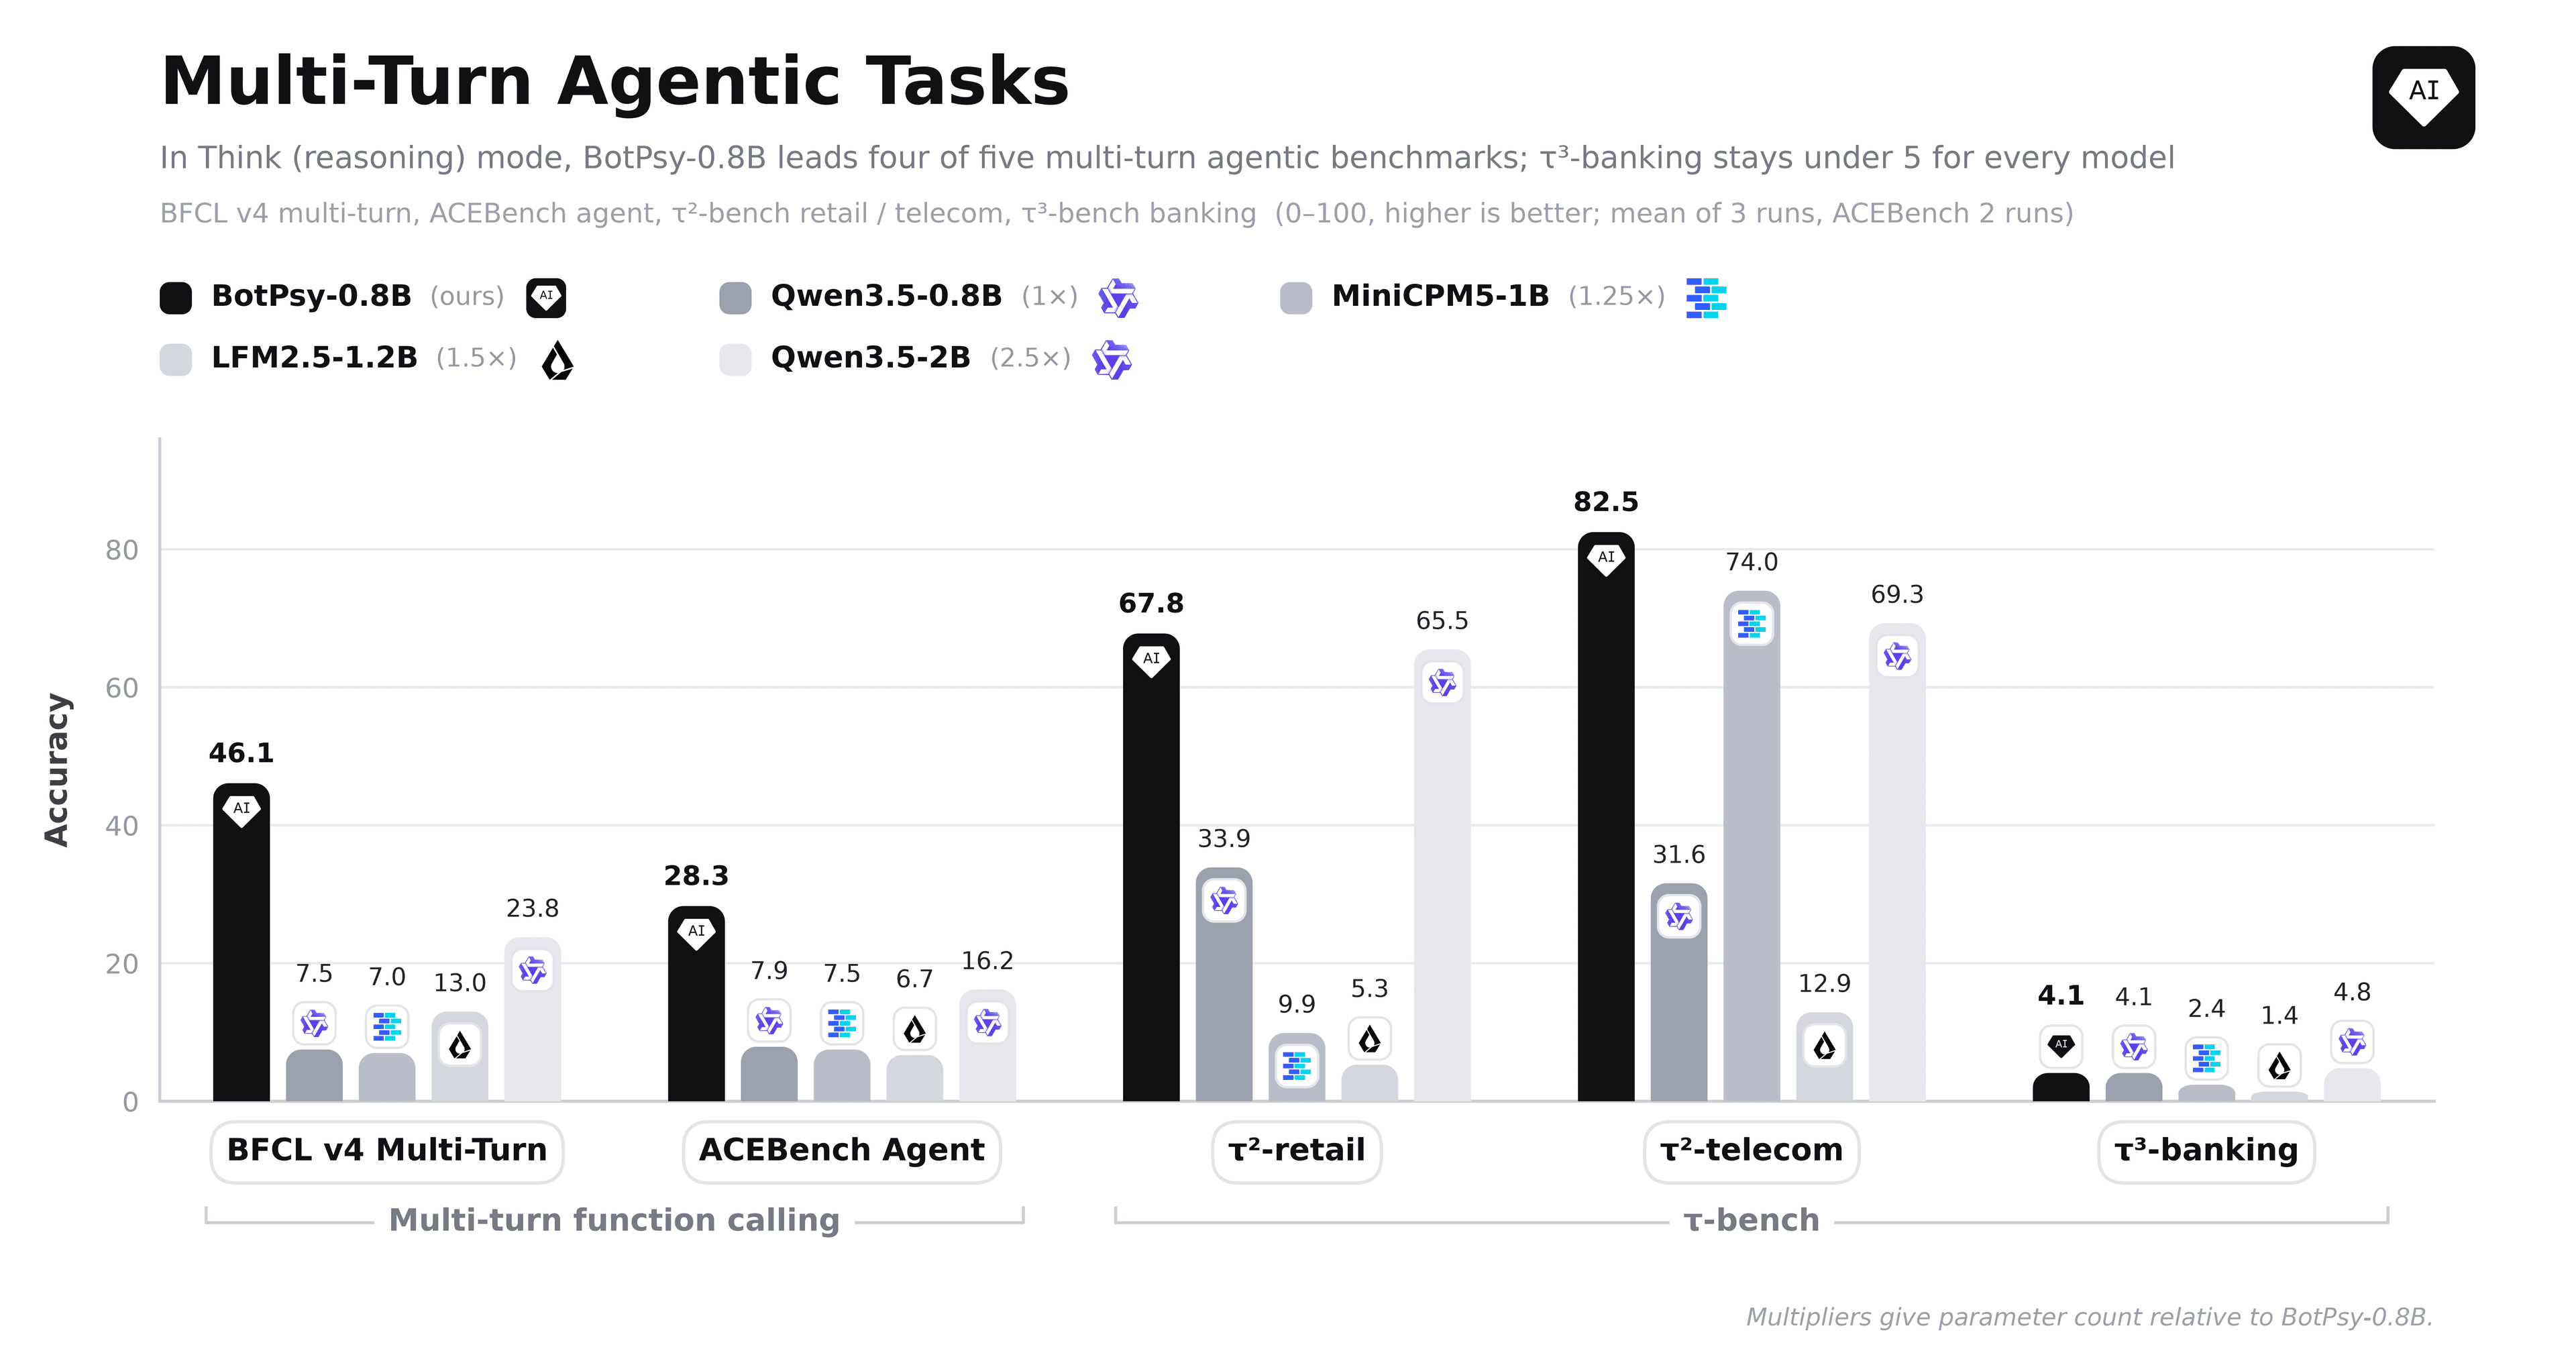
รูปภาพที่ 1: BotPsy-0.8B มีประสิทธิภาพเหนือกว่าโมเดลพื้นฐานอย่างมีนัยสำคัญและเป็นผู้นำใน 5 จาก 6 เบนช์มาร์กด้าน tool-use และ agentic โดยเอาชนะแม้กระทั่ง Qwen3.5-2B-Think ที่มีขนาดใหญ่กว่า 2.5 เท่าในหลายการทดสอบ
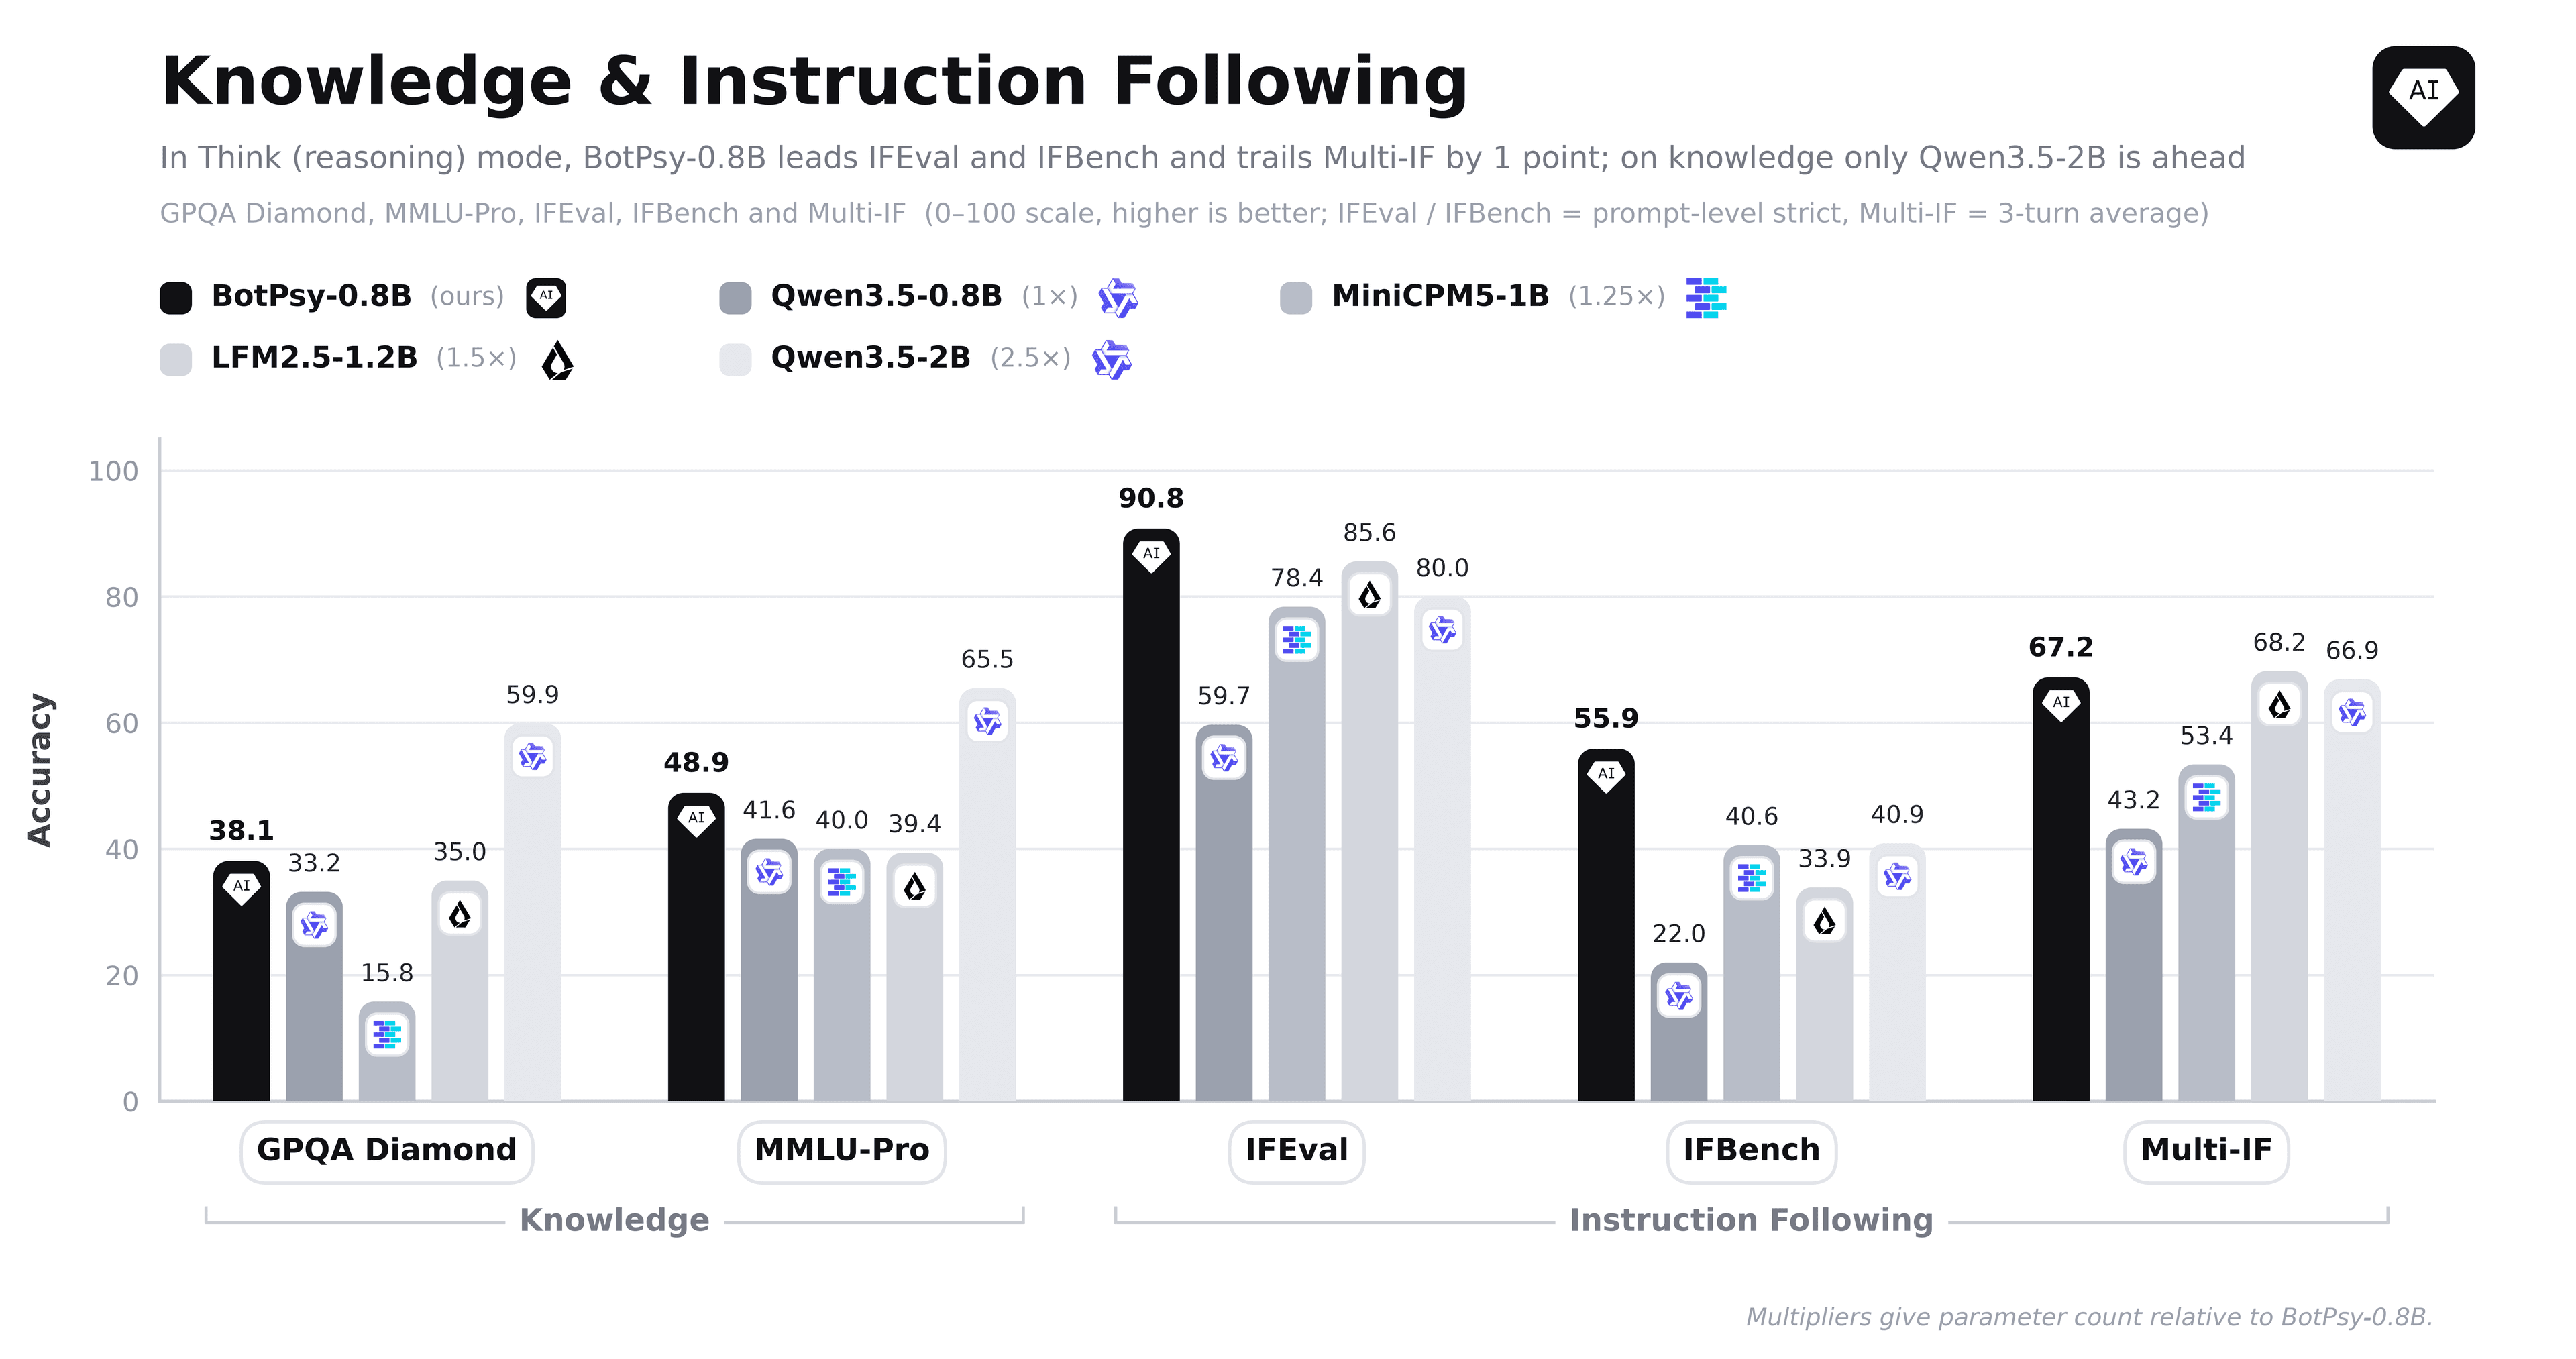
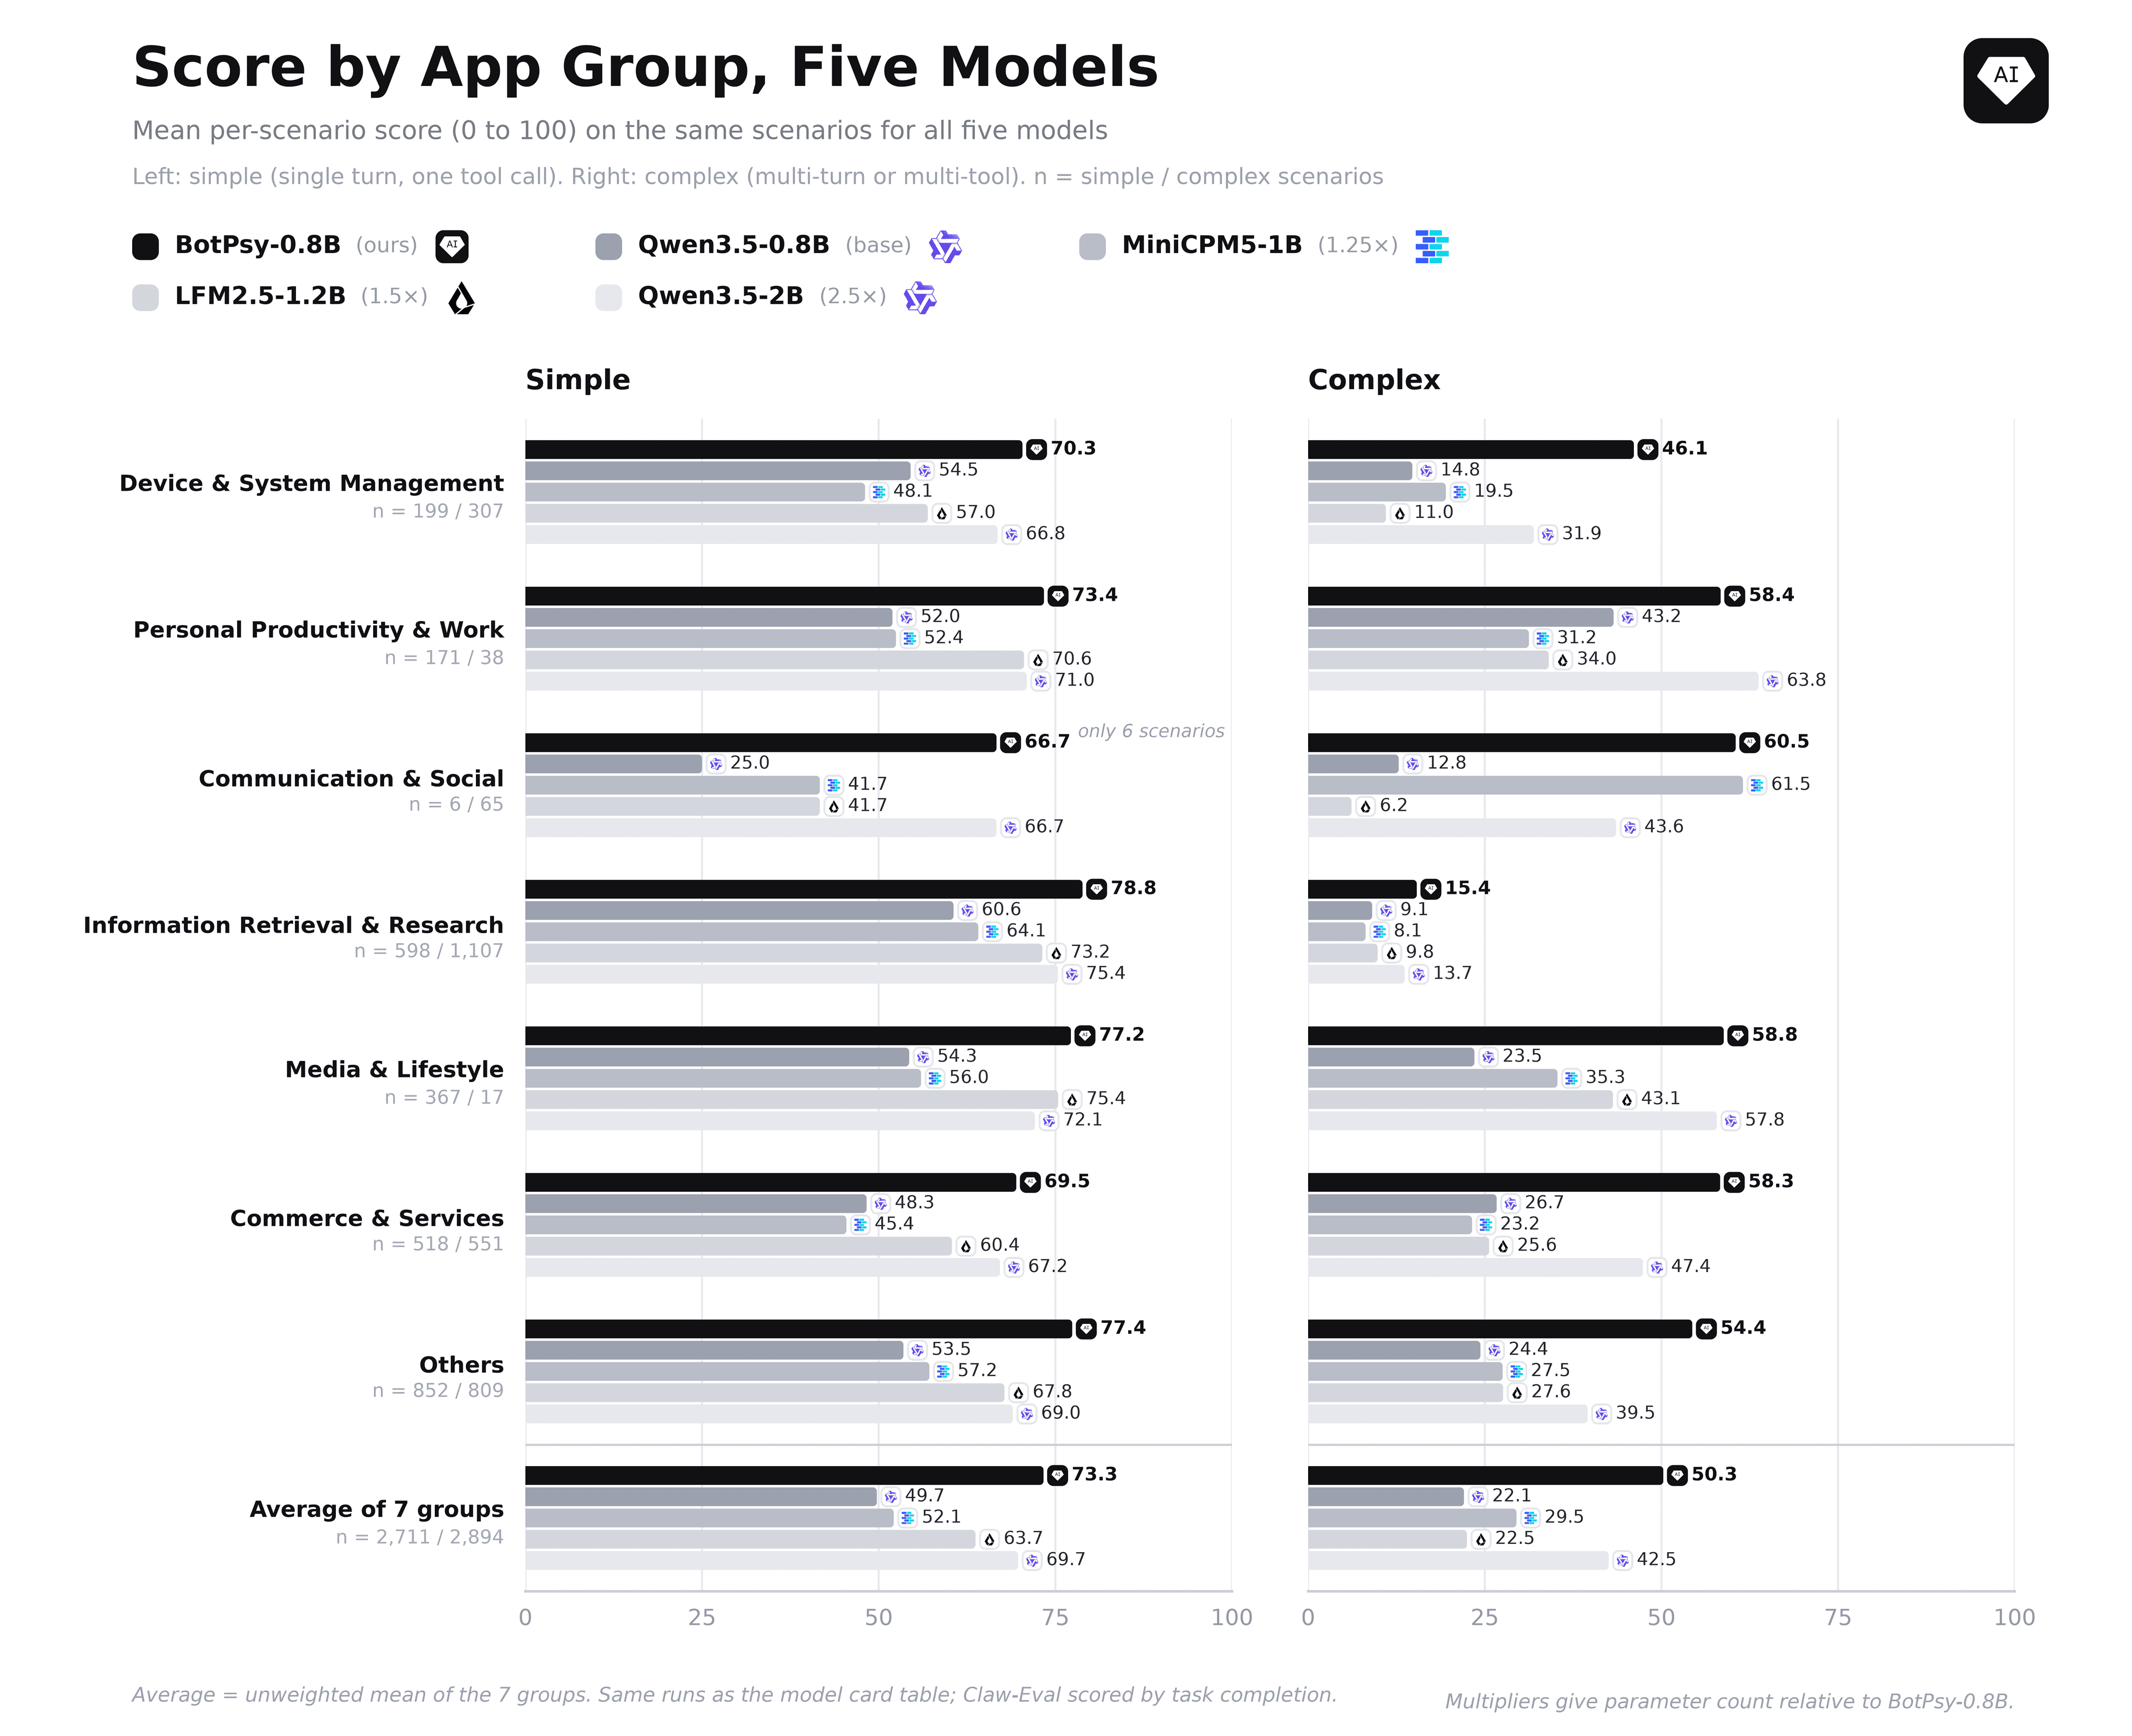
รูปภาพที่ 2: ในด้านความรู้ (Knowledge) การฝึกฝนด้าน tool-use ช่วยรักษาและพัฒนาทักษะทั่วไปของ BotPsy ให้ดีกว่าโมเดลขนาดใกล้เคียงกัน ส่วนด้านการปฏิบัติตามคำสั่ง (Instruction following) BotPsy โดดเด่นมากในงานแบบหลายรอบ (multi-turn) แม้ประสิทธิภาพจะลดลงบ้างเมื่อคำสั่งมีความซับซ้อนสะสมหรือเป็นภาษาที่มีทรัพยากรน้อย
🤗 Model (safetensors) | 📦 GGUFs (bf16, Q8, Q4)
จุดเด่นที่สำคัญ
- ประสิทธิภาพเหนือกว่ารุ่นใหญ่: BotPsy ทำคะแนนเบนช์มาร์กหลักได้สูงกว่า Qwen3.5-2B-Think ใน 5 จาก 6 รายการ เช่น BFCL v4 (44.0 เทียบกับ 37.7) และ ACEBench (58.7 เทียบกับ 55.4)
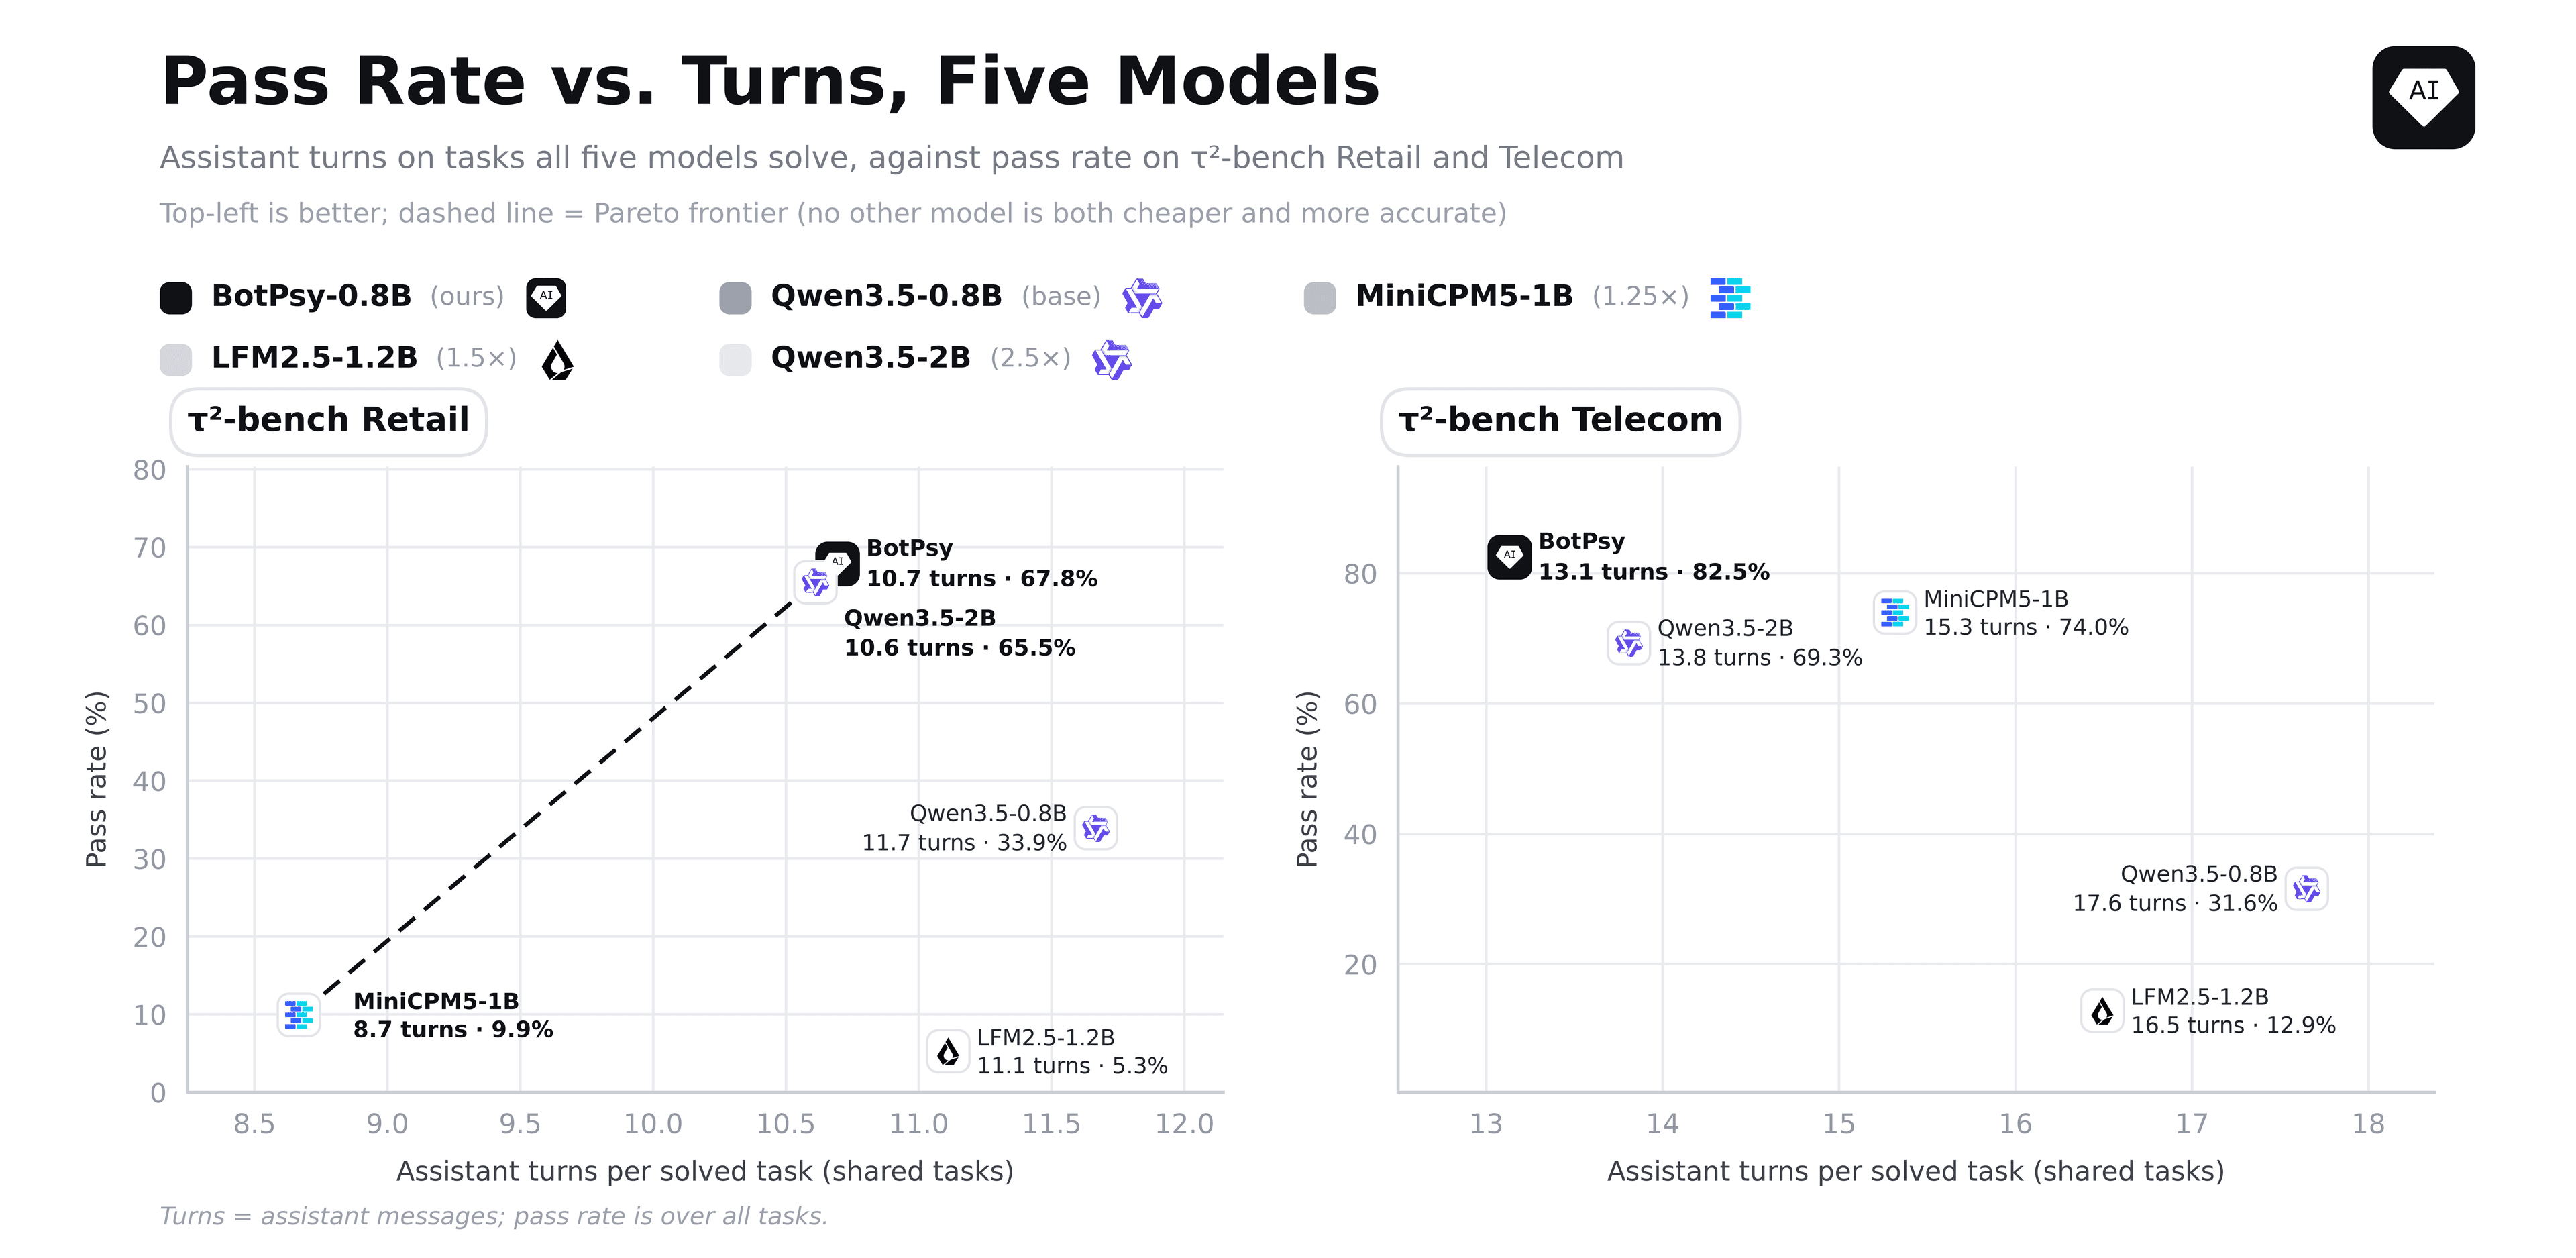
- ความน่าเชื่อถือในงานหลายขั้นตอน: ในการทดสอบ τ²-bench ที่ต้องสนทนากับลูกค้าแบบต่อเนื่อง BotPsy ทำคะแนนด้านโทรคมนาคมได้ถึง 82.5 สูงกว่า Qwen3.5-2B-Think อย่างชัดเจน
- ฉลาดในการเลือกใช้เครื่องมือ: โมเดลมีความสามารถในการตัดสินใจว่าควรเรียกใช้เครื่องมือหรือไม่ โดยได้คะแนนด้านการลดการหลอน (hallucination) สูงถึง 86.1 ใน BFCL v4
- ความปลอดภัยสูง: จากการทำ automated red-teaming พบว่า BotPsy สร้างคำตอบที่ไม่ปลอดภัยเพียง 21% ซึ่งต่ำที่สุดในกลุ่มโมเดลพารามิเตอร์ไม่เกิน 1.2B
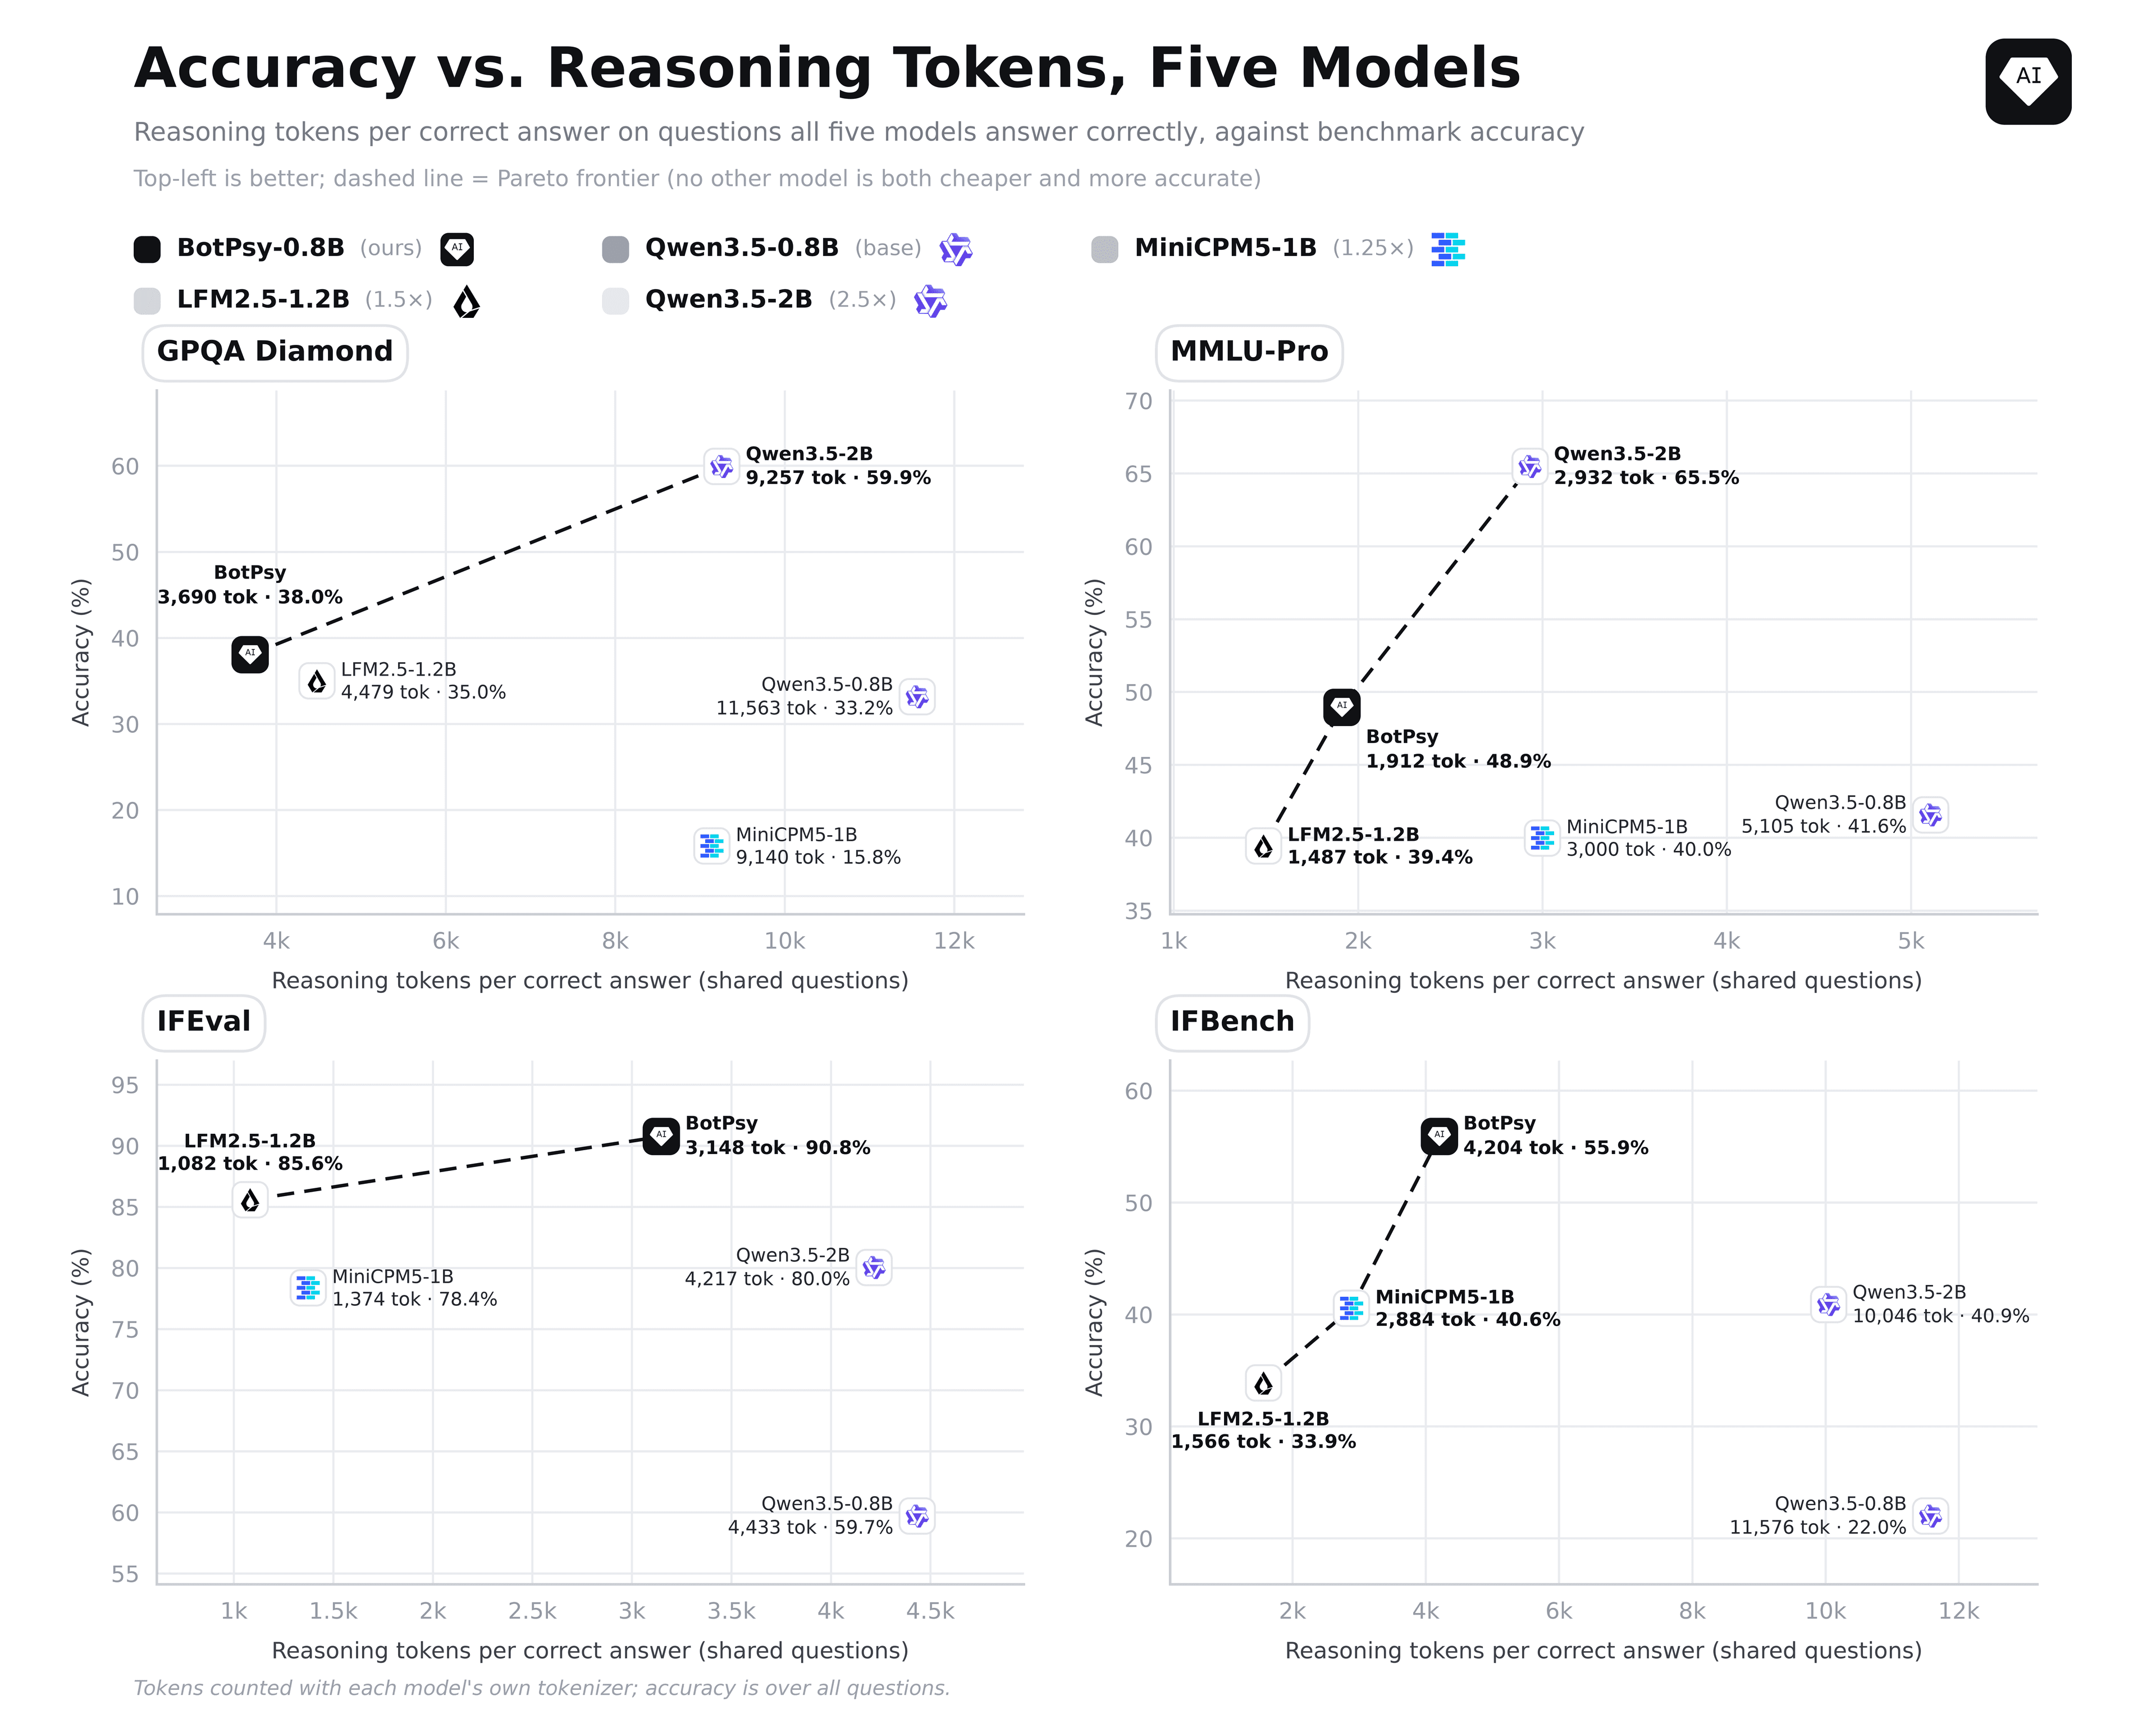
- ประหยัดพลังงานและรวดเร็ว: BotPsy ใช้ reasoning tokens น้อยกว่าโมเดลพื้นฐานถึง 3 เท่าในการหาคำตอบที่ถูกต้อง ช่วยลด latency เมื่อใช้งานบนอุปกรณ์
วิสัยทัศน์ในอนาคต
Tether AI Research มุ่งมั่นพัฒนาให้ BotPsy สามารถเชื่อมต่อกับฮาร์ดแวร์ท้องถิ่นได้หลากหลายขึ้น รวมถึงรองรับการค้นหาแบบ decentralized P2P ผ่าน Hypersearch เพื่อหลีกเลี่ยงการติดตามข้อมูลจากองค์กรใหญ่ นอกจากนี้ยังวางแผนให้เอเจนท์สามารถสื่อสารกันเองได้ (agent-to-agent) ภายใต้เครือข่ายส่วนตัวที่ปลอดภัย เพื่อให้ผู้ใช้ควบคุมชีวิตดิจิทัลได้อย่างสมบูรณ์
ระเบียบวิธีวิจัย
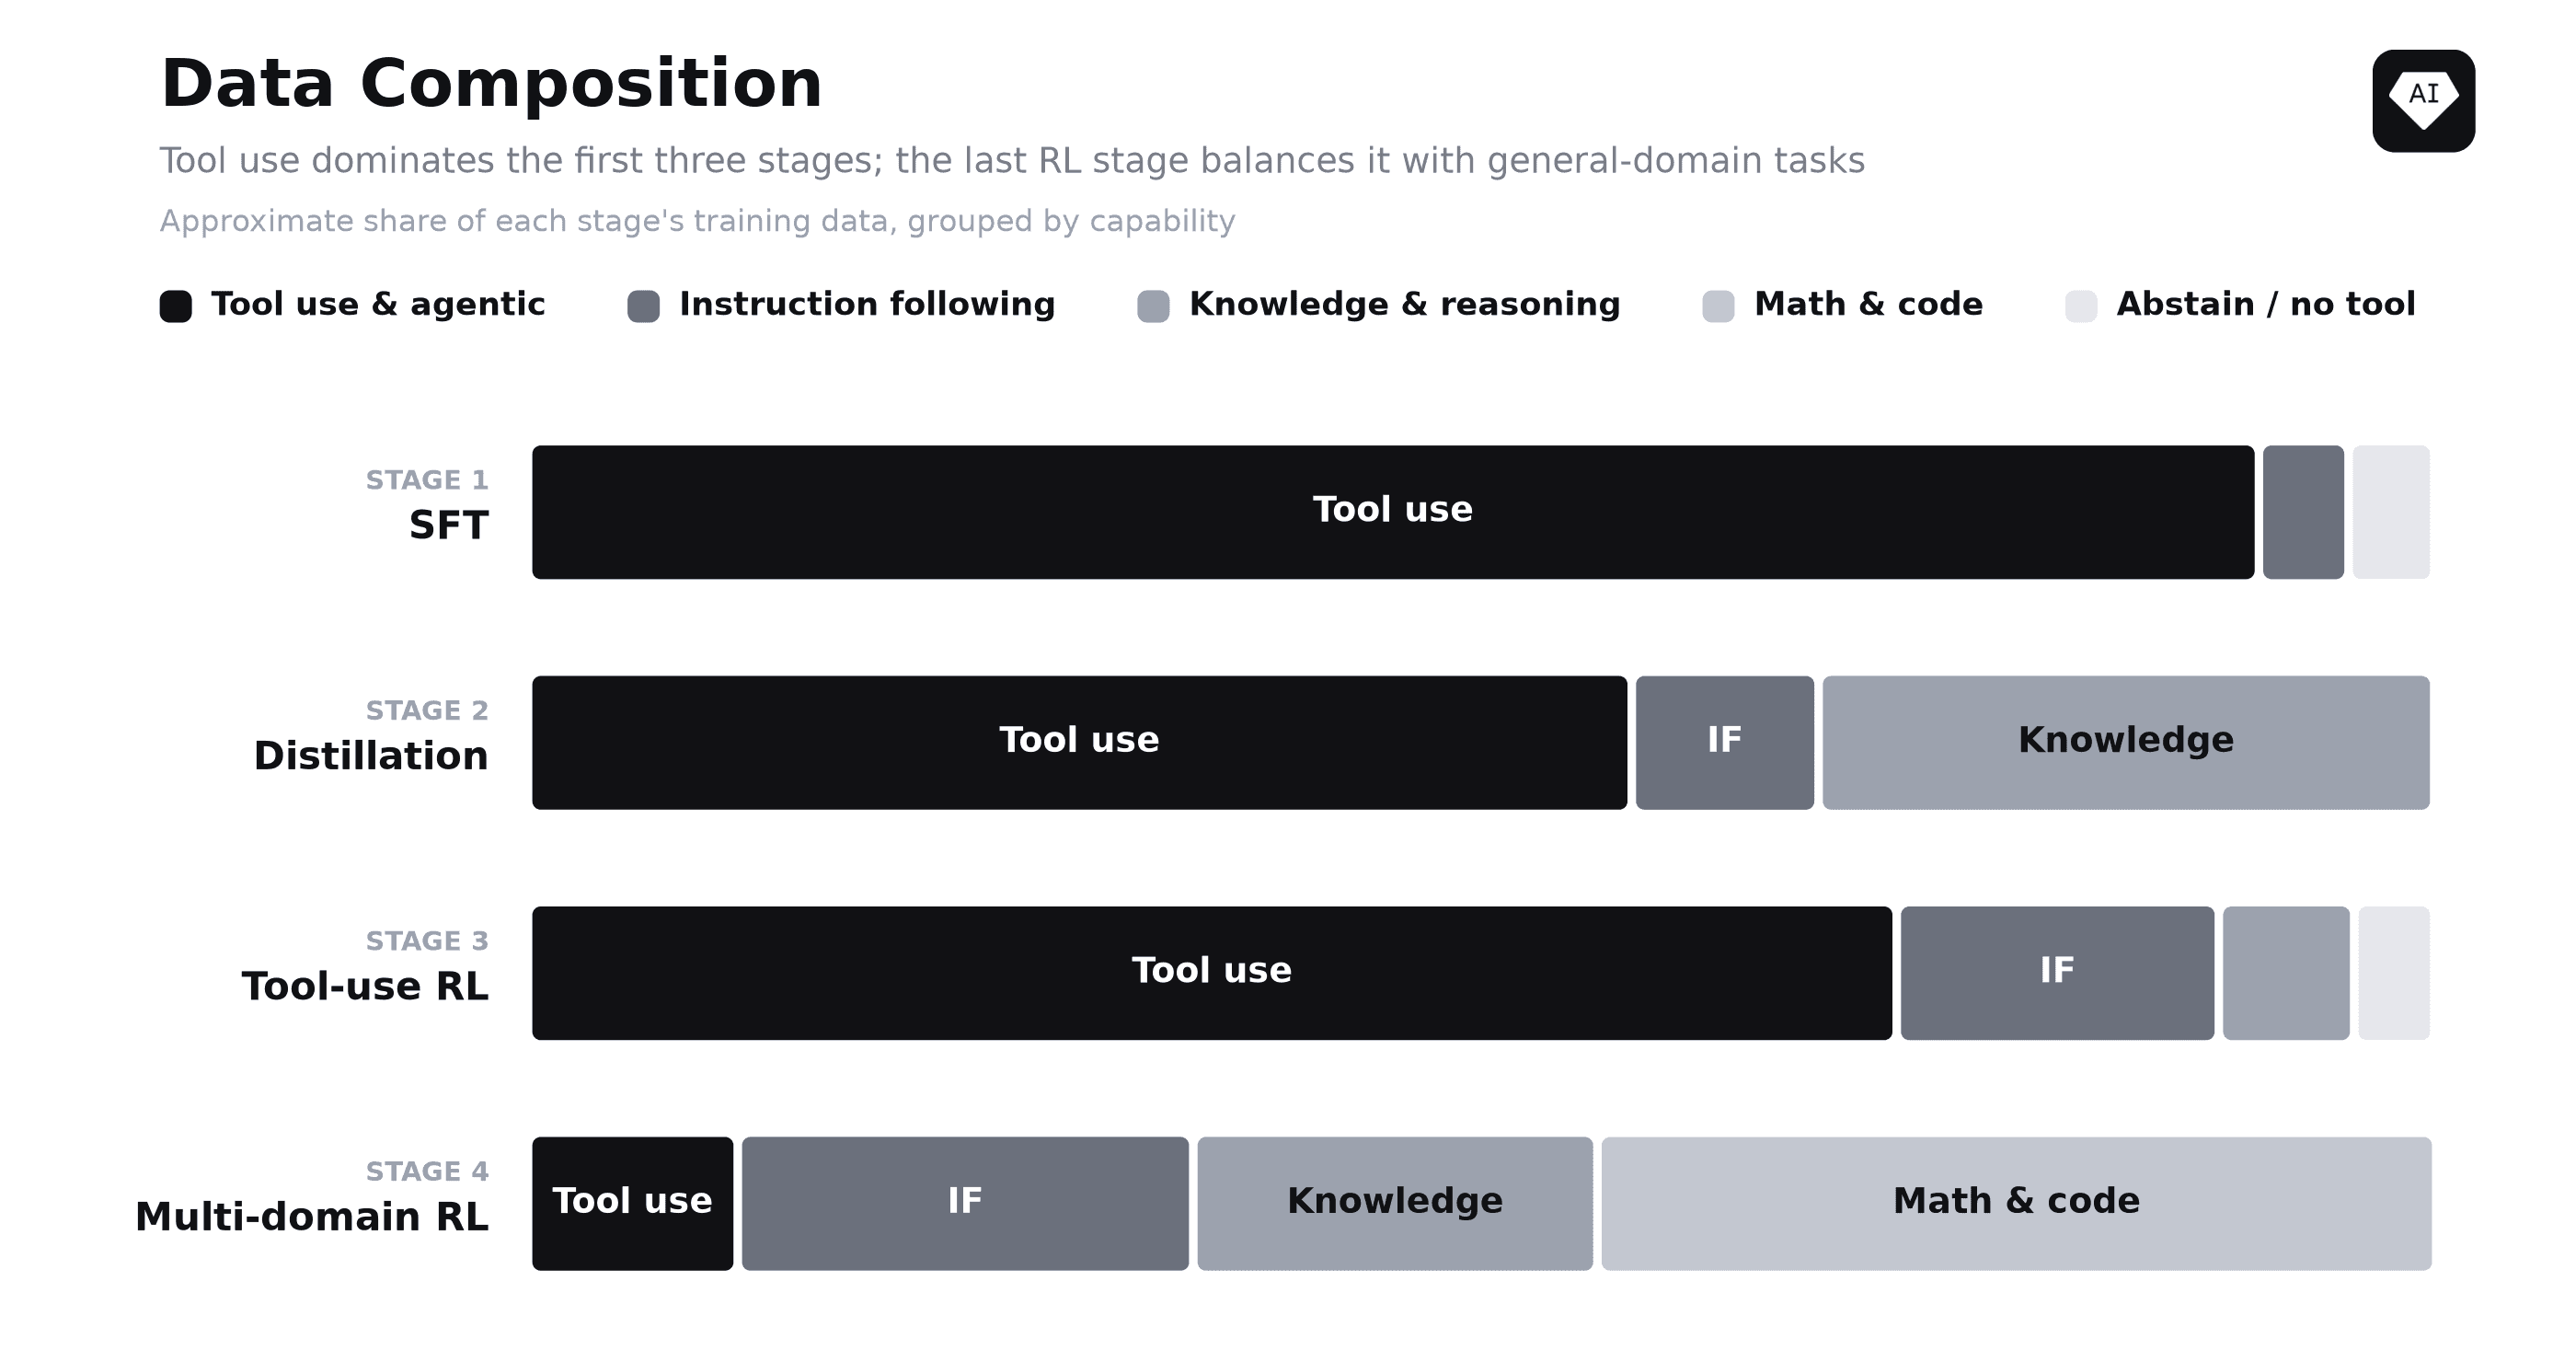
BotPsy ผ่านการฝึกฝน (post-trained) 4 ขั้นตอน: Supervised Fine-Tuning (SFT), Multi-teacher On-Policy Distillation (MOPD) และ Reinforcement Learning (RL) อีกสองรอบ โดยมีโมเดล Qwen3.5-4B จำนวน 3 ตัวทำหน้าที่เป็นครูผู้เชี่ยวชาญช่วยแนะนำในช่วงการเรียนรู้
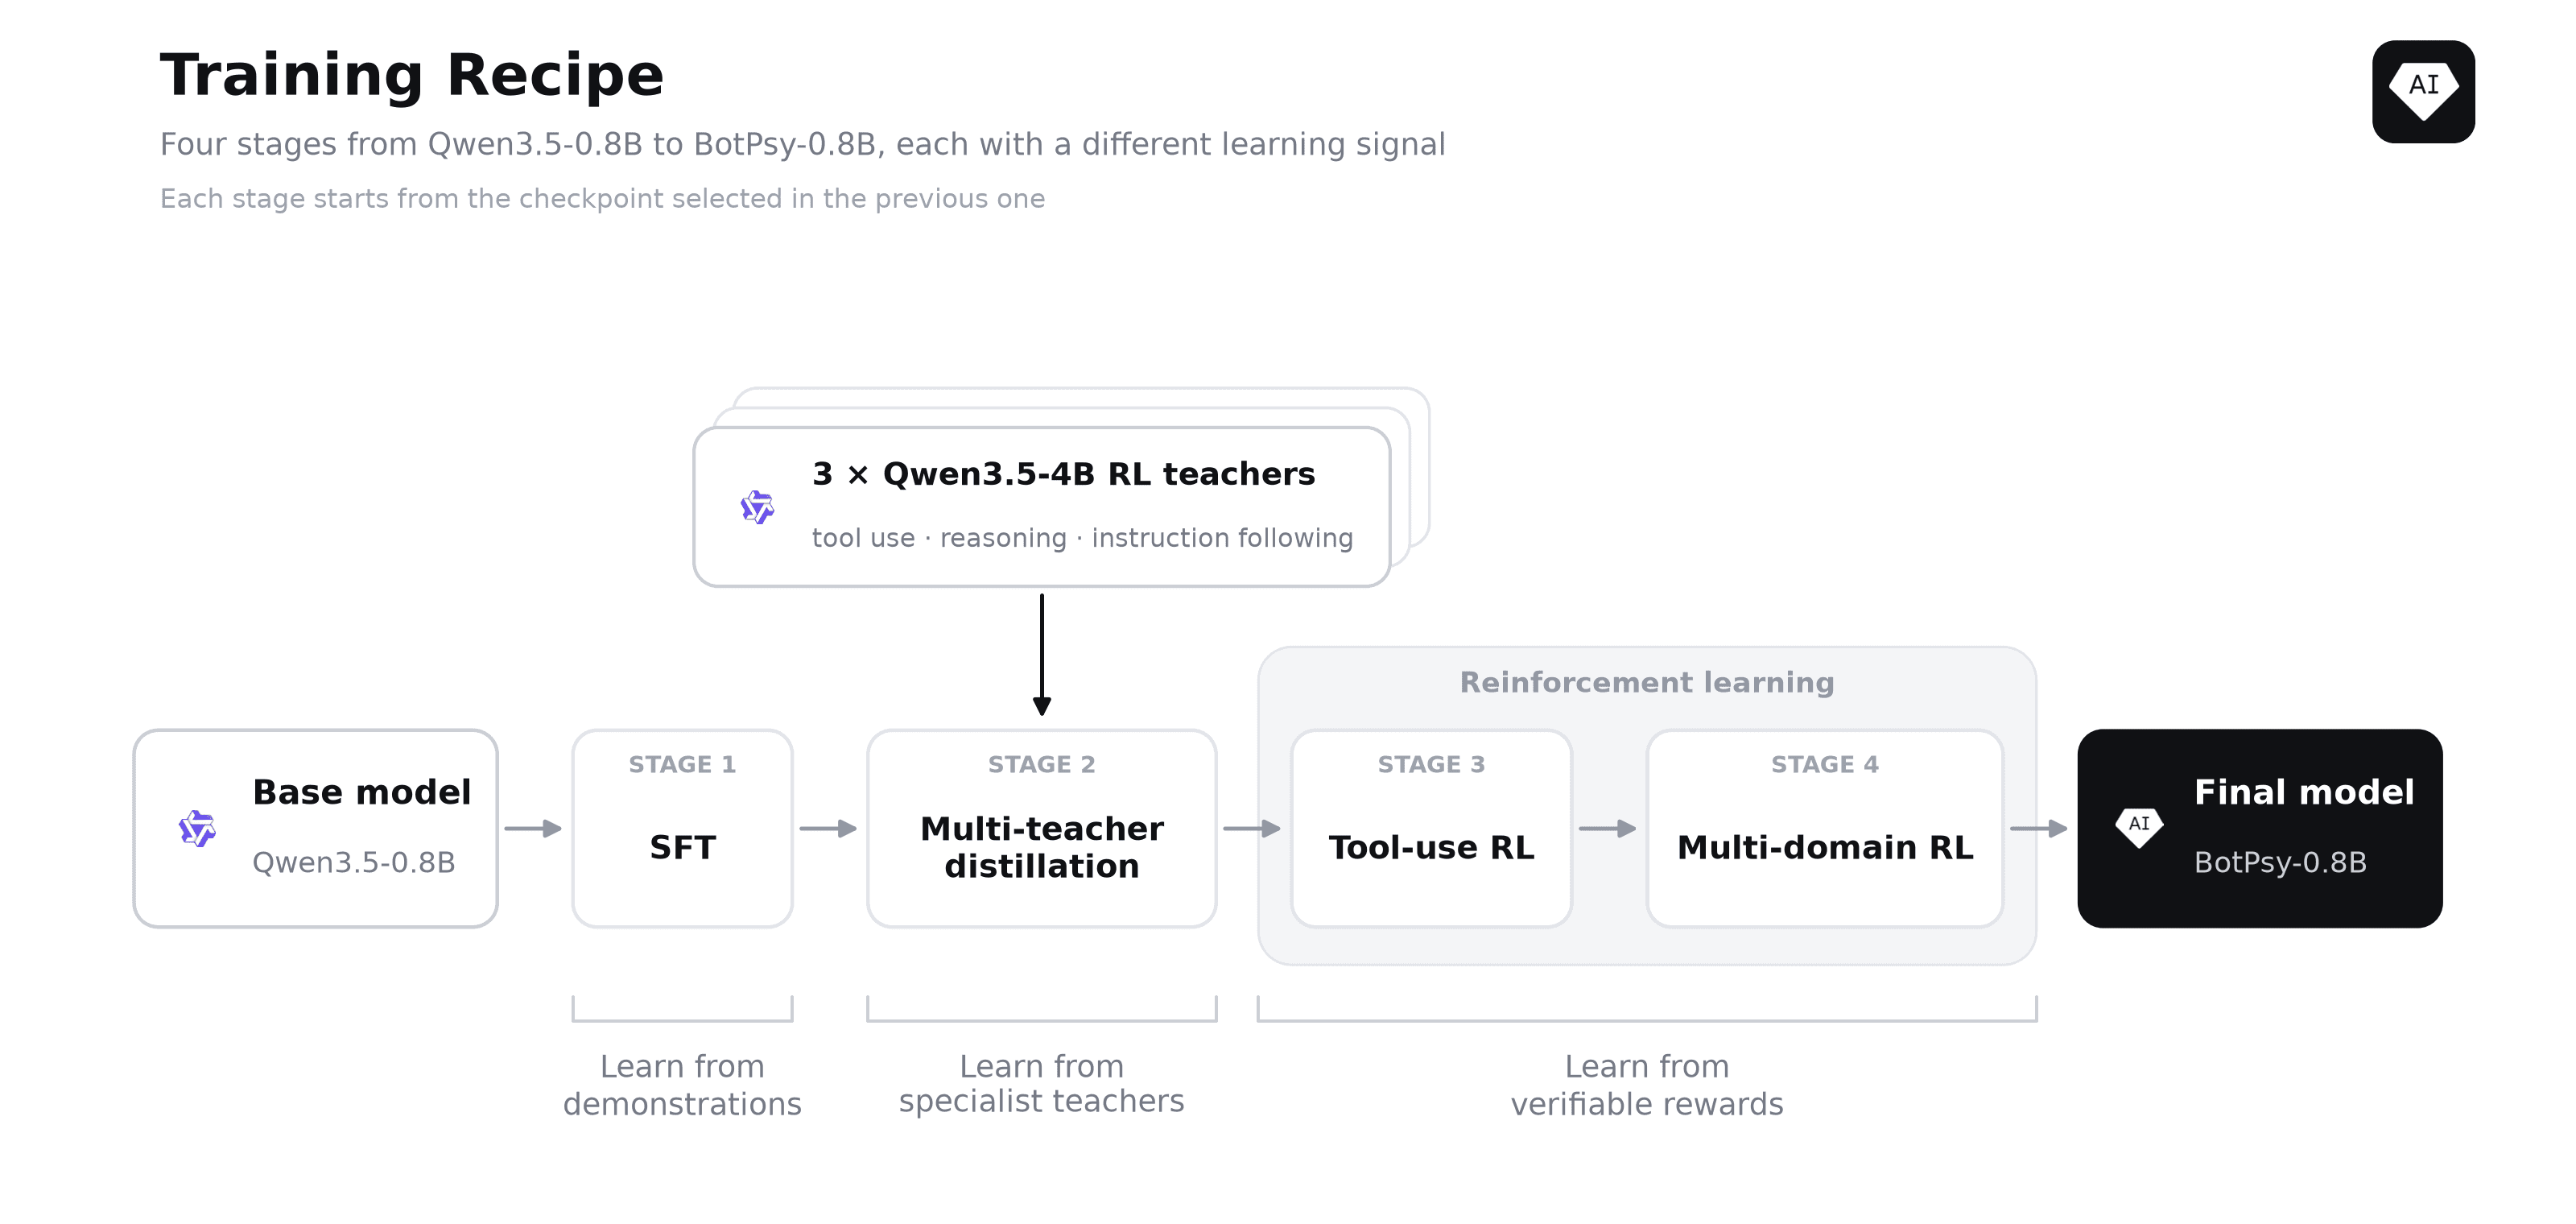
รูปภาพที่ 3: สูตรการฝึกฝน BotPsy ที่ใช้วิธีการเรียนรู้จากทั้งการสาธิต ครูผู้เชี่ยวชาญ และรางวัลจากการเรียกใช้เครื่องมือตามกฎจริง
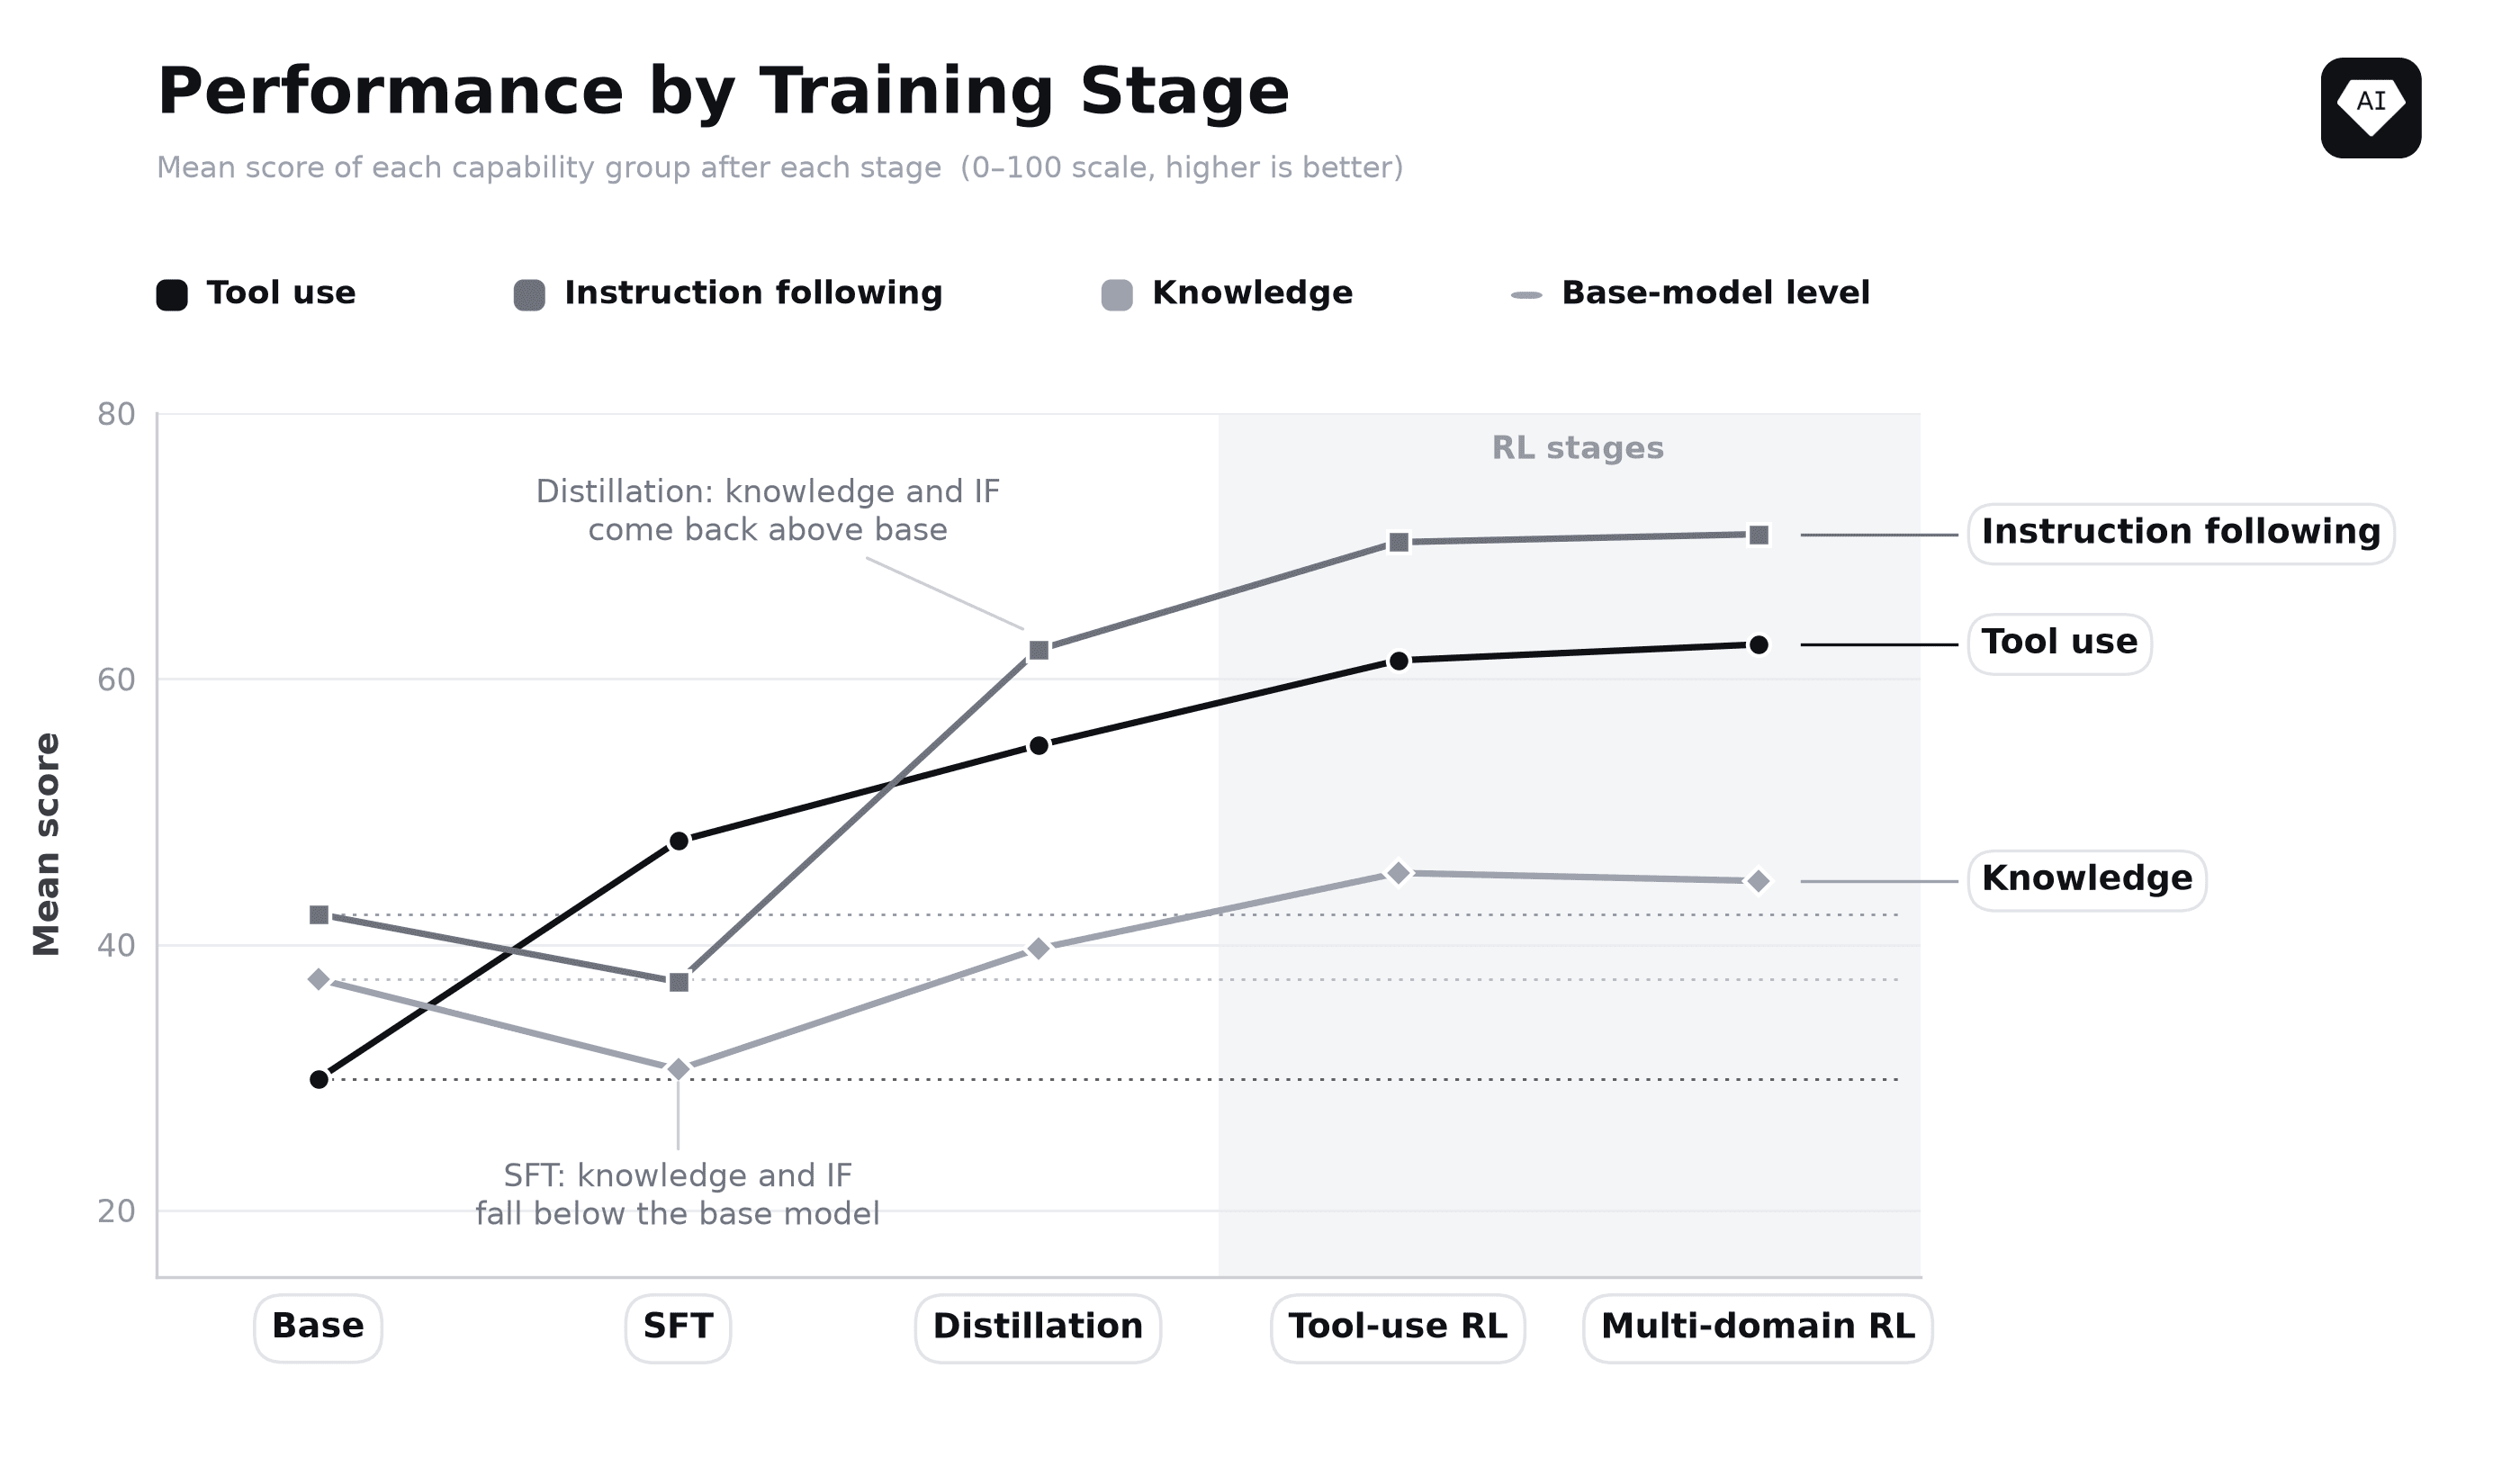
รูปภาพที่ 4: กราฟแสดงผลลัพธ์หลังการฝึกแต่ละขั้น โดยขั้นตอน RL และ Distillation มีส่วนสำคัญอย่างมากในการดึงความสามารถด้านการปฏิบัติตามคำสั่งและความรู้ทั่วไปให้สูงกว่าค่ามาตรฐาน
การใช้งานและข้อจำกัด
BotPsy เหมาะสำหรับการวิจัยและพัฒนาเป็นผู้ช่วยส่วนตัวในงานทั่วไป เช่น จัดการปฏิทิน อีเมล หรือควบคุมอุปกรณ์อัจฉริยะ อย่างไรก็ตาม เนื่องจากเป็นโมเดลขนาดเล็ก จึงยังมีความเสี่ยงที่จะเกิดข้อผิดพลาดได้ และไม่แนะนำให้ใช้ในงานที่มีความเสี่ยงสูง เช่น การตัดสินใจทางการแพทย์หรือการเงินที่สำคัญ
@misc{botpsy2026,
  title  = {BotPsy: On-Device Personal Assistant with a Sub-Billion-Parameter Agentic Language Model},
  author = {{Tether Data, S.A. de C.V. d.b.a. Tether AI Research}},
  year   = {2026},
  note   = {Hugging Face blog}
}
เอกสารอ้างอิง
[1] Yu, Qiying, et al. "DAPO: An Open-Source LLM Reinforcement Learning System at Scale." Advances in Neural Information Processing Systems 38 (2025): 113222-113244.
[2] Zhang, Shaokun, et al. "Nemotron-Research-Tool-N1: Exploring Tool-Using Language Models with Reinforced Reasoning." International Conference on Learning Representations (2026).
[3] Qian, Cheng, et al. "ToolRL: Reward is All Tool Learning Needs." Advances in Neural Information Processing Systems 38 (2025).
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร