
Meta เปิดตัว Muse Realtime Avatar เนรมิตอวตารโต้ตอบได้สมจริง
วันนี้เราขอแนะนำ Muse Realtime Avatar เทคโนโลยีการสร้างตัวตน (embodiment) ระดับแนวหน้า ที่จะเปลี่ยน Muse Realtime Voice ให้กลายเป็นอวตารที่โต้ตอบและแสดงออกทางอารมณ์ได้อย่างสมจริง
ด้วยการกำหนดเงื่อนไขจากสื่ออ้างอิง Muse Realtime Avatar สามารถนำตัวละครใดๆ เข้าสู่การสนทนาสดได้ โดยภาพพอร์ตเทรตภาพนิ่งสามารถตอบสนองผ่านการแสดงออกที่ละเอียดอ่อน ในขณะที่ภาพประกอบเต็มตัวสามารถแสดงท่าทางและเปลี่ยนท่วงท่าขณะพูดได้ แม้แต่สัตว์และวัตถุในชีวิตประจำวันก็สามารถแสดงออกทางอารมณ์ได้โดยไม่สูญเสียเอกลักษณ์เฉพาะตัว ซึ่งรูปลักษณ์และกิริยาท่าทางของอวตารจะมีความต่อเนื่องสอดคล้องกันตลอดการสนทนา
เทคโนโลยีนี้ก้าวข้ามขีดจำกัดของ "ส่วนหัวที่พูดได้" (talking head) แบบเดิม โดย Muse Realtime Avatar ทำให้รูปภาพใดๆ มีชีวิตขึ้นมาได้ในแบบ real time พร้อมการเคลื่อนไหวของใบหน้า มือ และร่างกายที่สื่อสารถึงอารมณ์ได้อย่างเป็นธรรมชาติ
จากความฉลาดสู่การปรากฏตัวแบบ Real-Time
Muse Realtime Voice และ Muse Realtime Avatar รวมตัวกันเป็นระบบสตรีมมิ่งเดียวที่เชื่อมต่อความฉลาด เสียง และการสร้างตัวตนเข้าด้วยกัน โดย Muse Realtime Voice จะทำหน้าที่ให้ความฉลาดในการสนทนาและผลิตกระแส speech tokens (VQs) ที่สื่อสารทั้งเนื้อหาและวิธีการพูด จากนั้นตัวถอดรหัสเสียงจะเปลี่ยน token ให้เป็นคำพูด ในขณะที่ Muse Realtime Avatar จะใช้กระแสข้อมูลเดียวกันเพื่อสร้างการแสดงผลทางภาพที่สอดคล้องกัน ช่วยให้เสียง การเคลื่อนไหวของริมฝีปาก และการแสดงออกทางสีหน้าทำงานประสานกัน (synchronized) อย่างไร้รอยต่อ
Muse Realtime Avatar คือ Diffusion Transformer ที่ขับเคลื่อนด้วยเสียง ซึ่งถูกกำหนดเงื่อนไขด้วยกระแส speech-token, สื่ออ้างอิง และ rolling window ของ video latents ล่าสุด โดยจะสร้างวิดีโอเป็นกลุ่มก้อนขนาดสั้น (causal chunks) เมื่อแต่ละก้อนเสร็จสิ้น latents ที่สร้างขึ้นใหม่จะกลายเป็นบริบทการเคลื่อนไหวสำหรับก้อนถัดไป เพื่อรักษาความต่อเนื่องของรูปลักษณ์และกิริยาท่าทางภายใต้ขอบเขตการคำนวณที่จำกัด ทำให้การสร้างวิดีโอสามารถดำเนินต่อไปได้ตราบเท่าที่การสนทนายังดำเนินอยู่
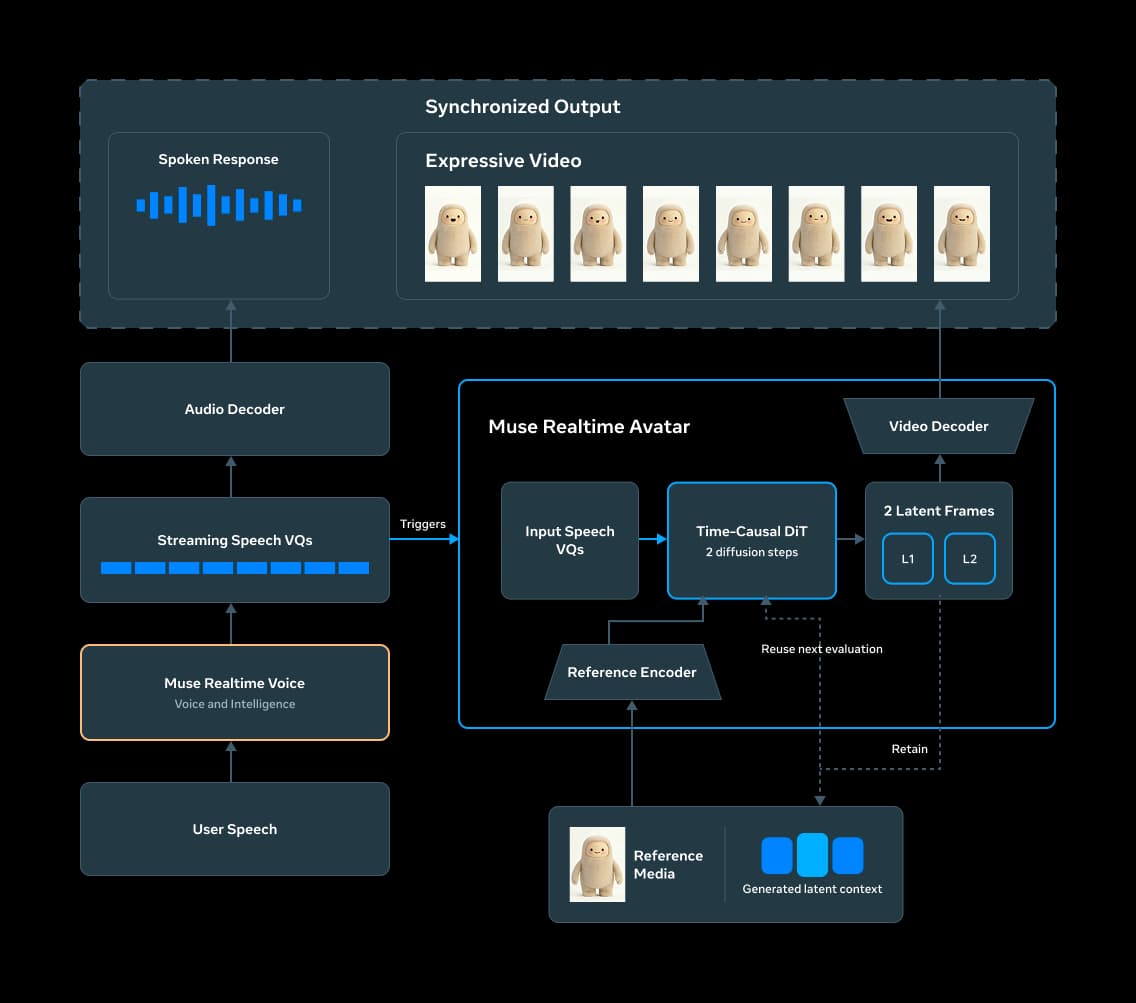
Muse Realtime Avatar เปลี่ยนสตรีมมิ่ง speech VQs ให้เป็นวิดีโอที่สอดประสานกัน โดยส่งต่อบริบทที่สร้างขึ้นเพื่อรักษาความต่อเนื่องตลอดการสนทนา
การสร้างวิดีโอแบบไม่สิ้นสุดในเวลา Real-Time
การสตรีมสดต้องแก้ปัญหาสำคัญสองประการ คือการสร้างวิดีโอให้เร็วพอสำหรับการโต้ตอบแบบ real-time และการรักษาความสอดคล้องทางภาพตลอดการสนทนาโดยไม่เกิดข้อผิดพลาดสะสม
เราเริ่มต้นด้วยโมเดล teacher แบบ bidirectional คุณภาพสูง และสร้างโมเดล student แบบ causal ที่มี KV cache ความยาวคงที่ผ่านกระบวนการ self-forcing และ distribution matching distillation วิธี self-forcing ช่วยให้โมเดล student ฝึกฝนกับบริบทที่สร้างขึ้นเองเพื่อสร้างความต้านทานต่อการเบี่ยงเบน (drift) เมื่อข้อผิดพลาดสะสมตามกาลเวลา ซึ่งเป็นสถานการณ์จริงที่ต้องเจอในระหว่างการอนุมาน (inference)
โมเดล teacher เดิมต้องใช้ขั้นตอนประมวลผลถึง 120 รอบต่อหนึ่งก้อน แต่ด้วยสูตรการปรับแต่งแบบพิเศษ เราได้กลั่นกรอง (distills) กระบวนการดังกล่าวเข้าสู่โมเดล student ที่ทำงานเพียง 2 ขั้นตอนแบบไม่มีการนำทาง (unguided) เทคนิคนี้ช่วยลดภาระการคำนวณลงถึง 60 เท่า ในขณะที่ยังคงรักษาคุณภาพของผลลัพธ์ไว้ได้ใกล้เคียงกับต้นฉบับ
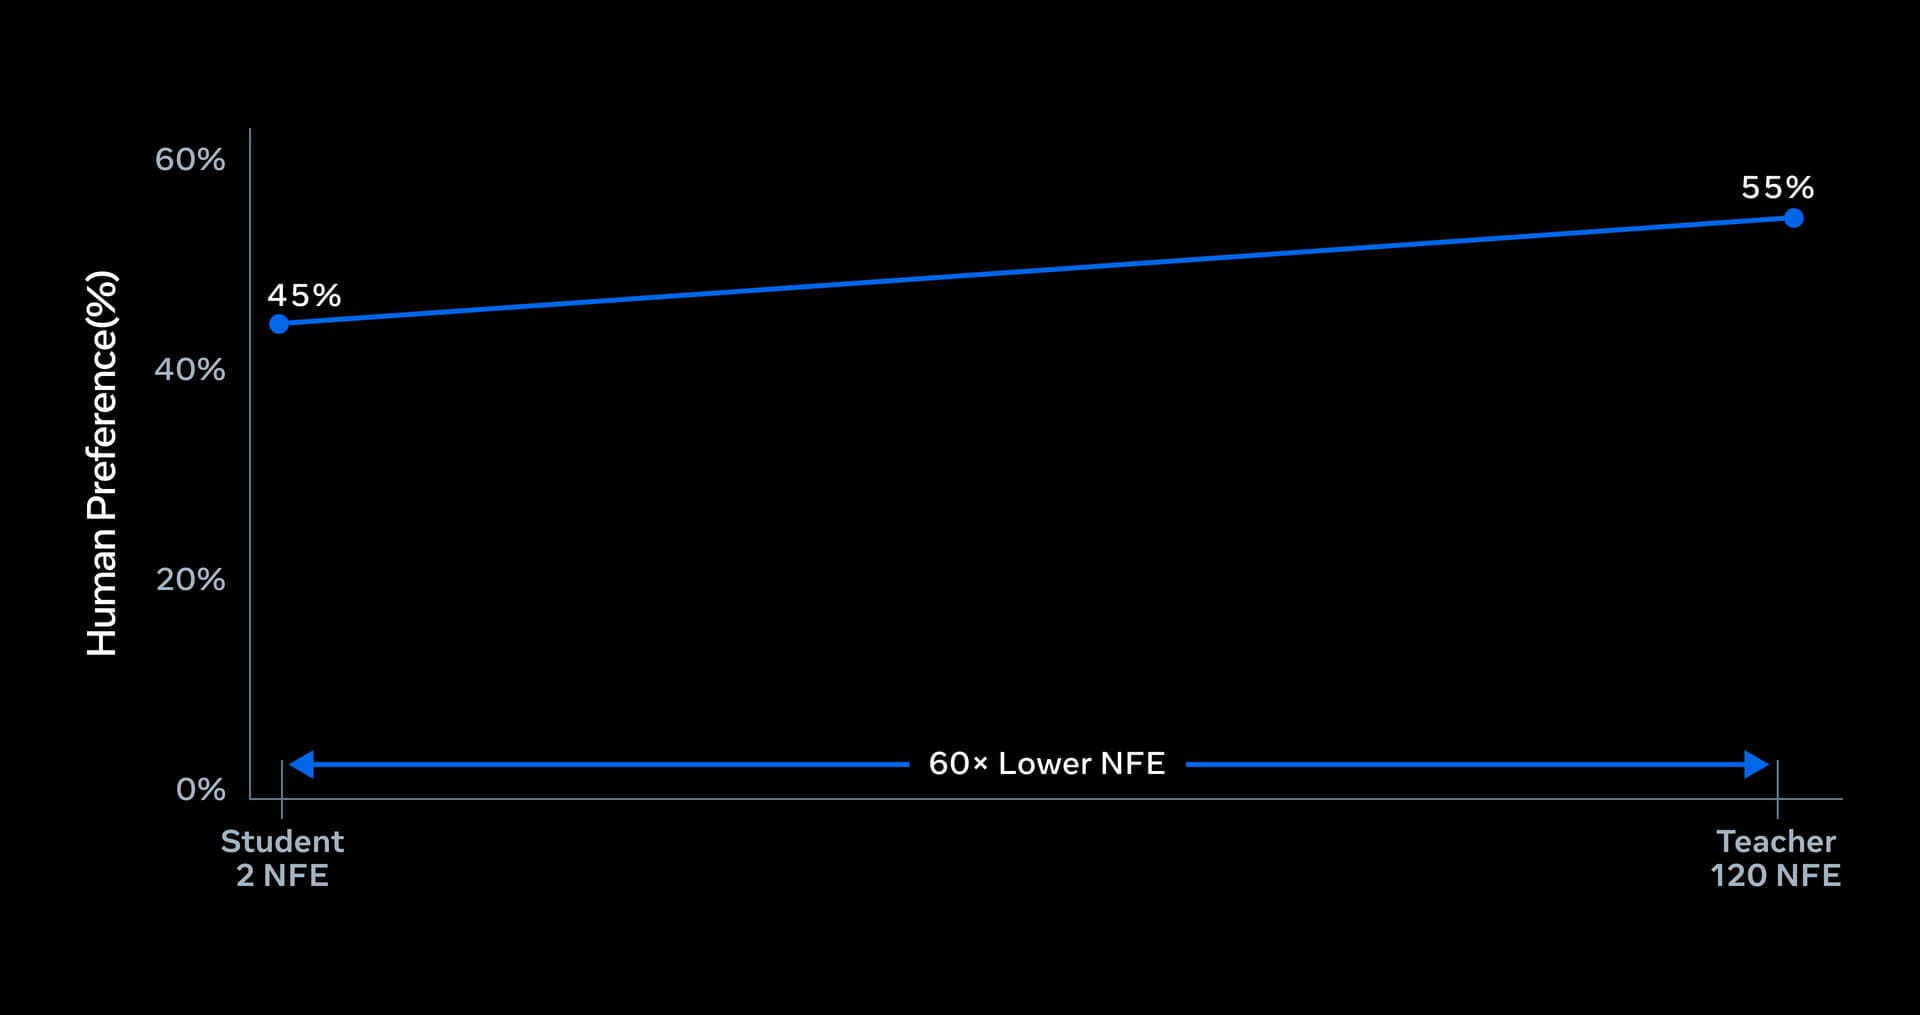
การทำ Distillation ช่วยลดการอนุมานจาก 120 เหลือเพียง 2 neural function evaluations ต่อหนึ่งก้อน ซึ่งลดลง 60 เท่า โดยที่ผู้ใช้งานยังคงให้คะแนนความพึงพอใจในระดับใกล้เคียงเดิม
ประสบการณ์อวตารระดับแนวหน้า เพื่อให้เห็นประสิทธิภาพในการสนทนาสด เราได้เปรียบเทียบกับ Runway Characters และ HeyGen LiveAvatar ซึ่งเป็นระบบอวตารชั้นนำในตลาด โดยให้ผู้ประเมินทดลองสนทนาสดจริงเป็นเวลา 2-3 นาที แล้วเปรียบเทียบคุณภาพในด้านต่างๆ เช่น ความชัดเจนของภาพ, การประสานจังหวะ (synchronization) และความเป็นธรรมชาติของตัวละคร ผลลัพธ์พบว่าผู้ประเมินส่วนใหญ่พึงพอใจใน Muse Realtime Avatar มากกว่าคู่แข่ง
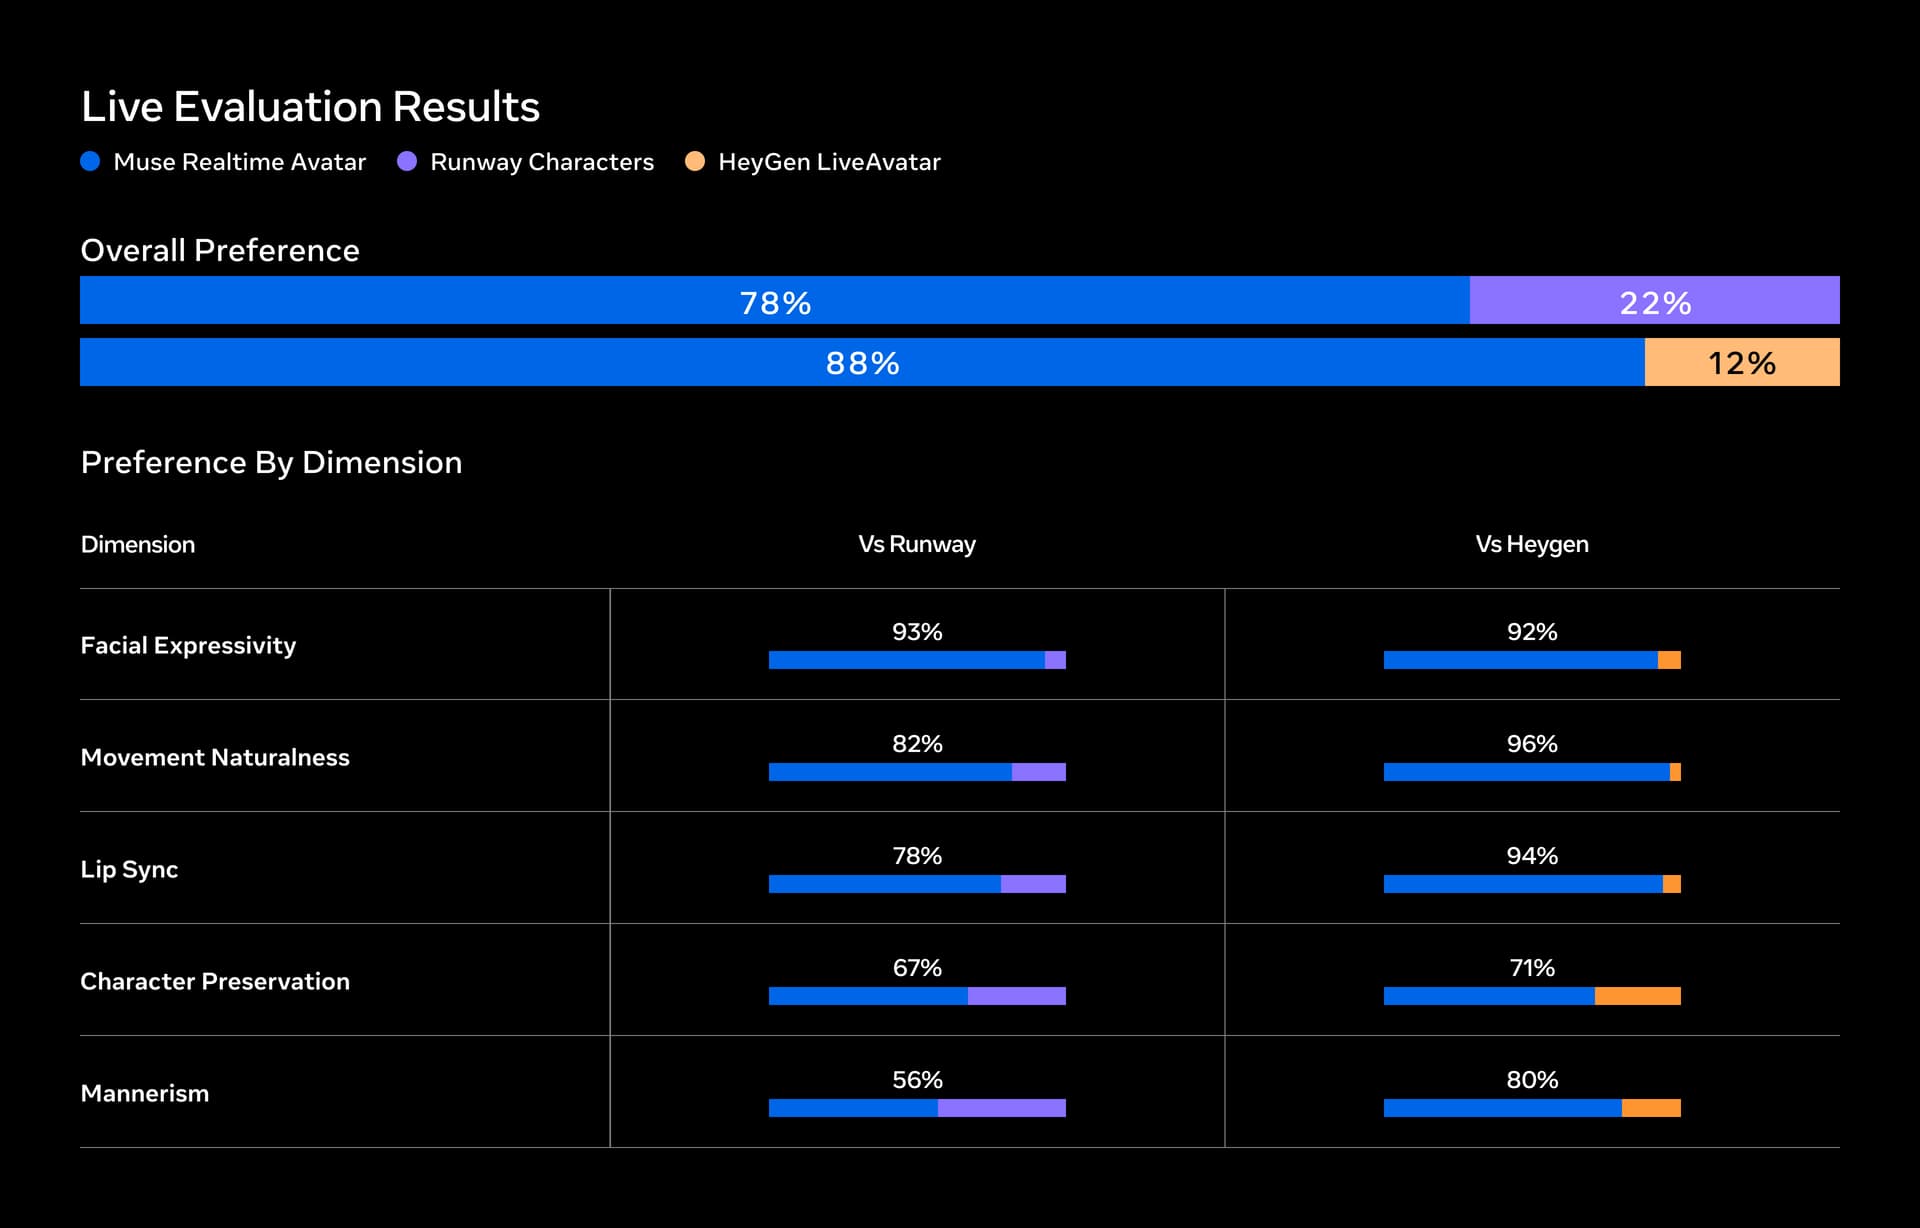
ผู้ประเมินชื่นชอบ Muse Realtime Avatar ในภาพรวมและในทุกมิติที่ได้รับการประเมิน โดยเฉพาะการแสดงออกทางสีหน้าและความเป็นธรรมชาติของการเคลื่อนไหวที่ทำได้โดดเด่น
การให้บริการที่ Latency ต่ำกว่าวินาทีในระดับ Meta Scale
การให้บริการในระดับ Meta scale จำเป็นต้องมีทั้ง latency ที่ต่ำและการรองรับผู้ใช้จำนวนมาก (concurrency) เราจึงได้ออกแบบ real-time AI inference stack ใหม่ทั้งหมด พร้อมเอนจินสั่งทำพิเศษเพื่อการให้บริการวิดีโอแบบ real-time ที่มีประสิทธิภาพสูงสุด
ระบบเลือกใช้ Persistent KV caches ร่วมกับการเข้ารหัสตำแหน่งแบบ memory aware เพื่อนำบริบทกลับมาใช้ใหม่ได้อย่างชาญฉลาด นอกจากนี้ยังมีการใช้ Cache-aware routing และการจัดกลุ่มข้อมูลแบบไดนามิก (latency-aware dynamic batching) เพื่อกระจายภาระงานได้อย่างมีประสิทธิภาพ รวมถึงการใช้ quantization แบบ 4 บิต และเทคนิค NVIDIA CUDA Graph capture เพื่อลดการรับส่งข้อมูลและลดต้นทุนการประมวลผล
Muse Realtime Avatar สามารถสตรีมวิดีโอแนวตั้งขนาด 448x768 ที่ 25 เฟรมต่อวินาที โดยมี latency เพียง 870 มิลลิวินาที (วัดจากสิ้นสุดการพูดจนถึงการตอบสนองแรก) บนระบบ GB200 แต่ละขั้นตอนการสร้างจะผลิตวิดีโอได้นาน 320 มิลลิวินาที ภายในเวลาประมวลผลเพียง 20 มิลลิวินาทีเท่านั้น
การปรับแต่งทั้งหมดช่วยเพิ่มขีดความสามารถในการให้บริการได้ถึง 8 เท่า เมื่อเทียบกับเกณฑ์มาตรฐานเดิม ทำให้สามารถรองรับการสนทนา real-time พร้อมกันได้ถึง 12 เซสชันบนเครื่อง GB200 เพียงเครื่องเดียว
การสร้าง AI ที่มีตัวตนอย่างรับผิดชอบ
เราให้ความสำคัญกับความปลอดภัยเพื่อลดความเสี่ยงจากการใช้งานในทางที่ผิด โดย Muse Realtime Avatar ได้ฝังลายน้ำที่ทนทานและมองไม่เห็นผ่าน Meta Video Seal เพื่อให้ตรวจสอบย้อนกลับได้โดยไม่เพิ่ม latency ให้กับระบบ ทั้งนี้ Muse ออกแบบมาสำหรับผู้ใช้ที่มีอายุ 18 ปีขึ้นไป และตัวอย่างที่แสดงในบล็อกนี้เป็นเพียงการสาธิตความสามารถของโมเดลเท่านั้น
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร