
GPT-6 อัปเกรด Prompt Caching ใหม่ ลดต้นทุนและค่าความหน่วง
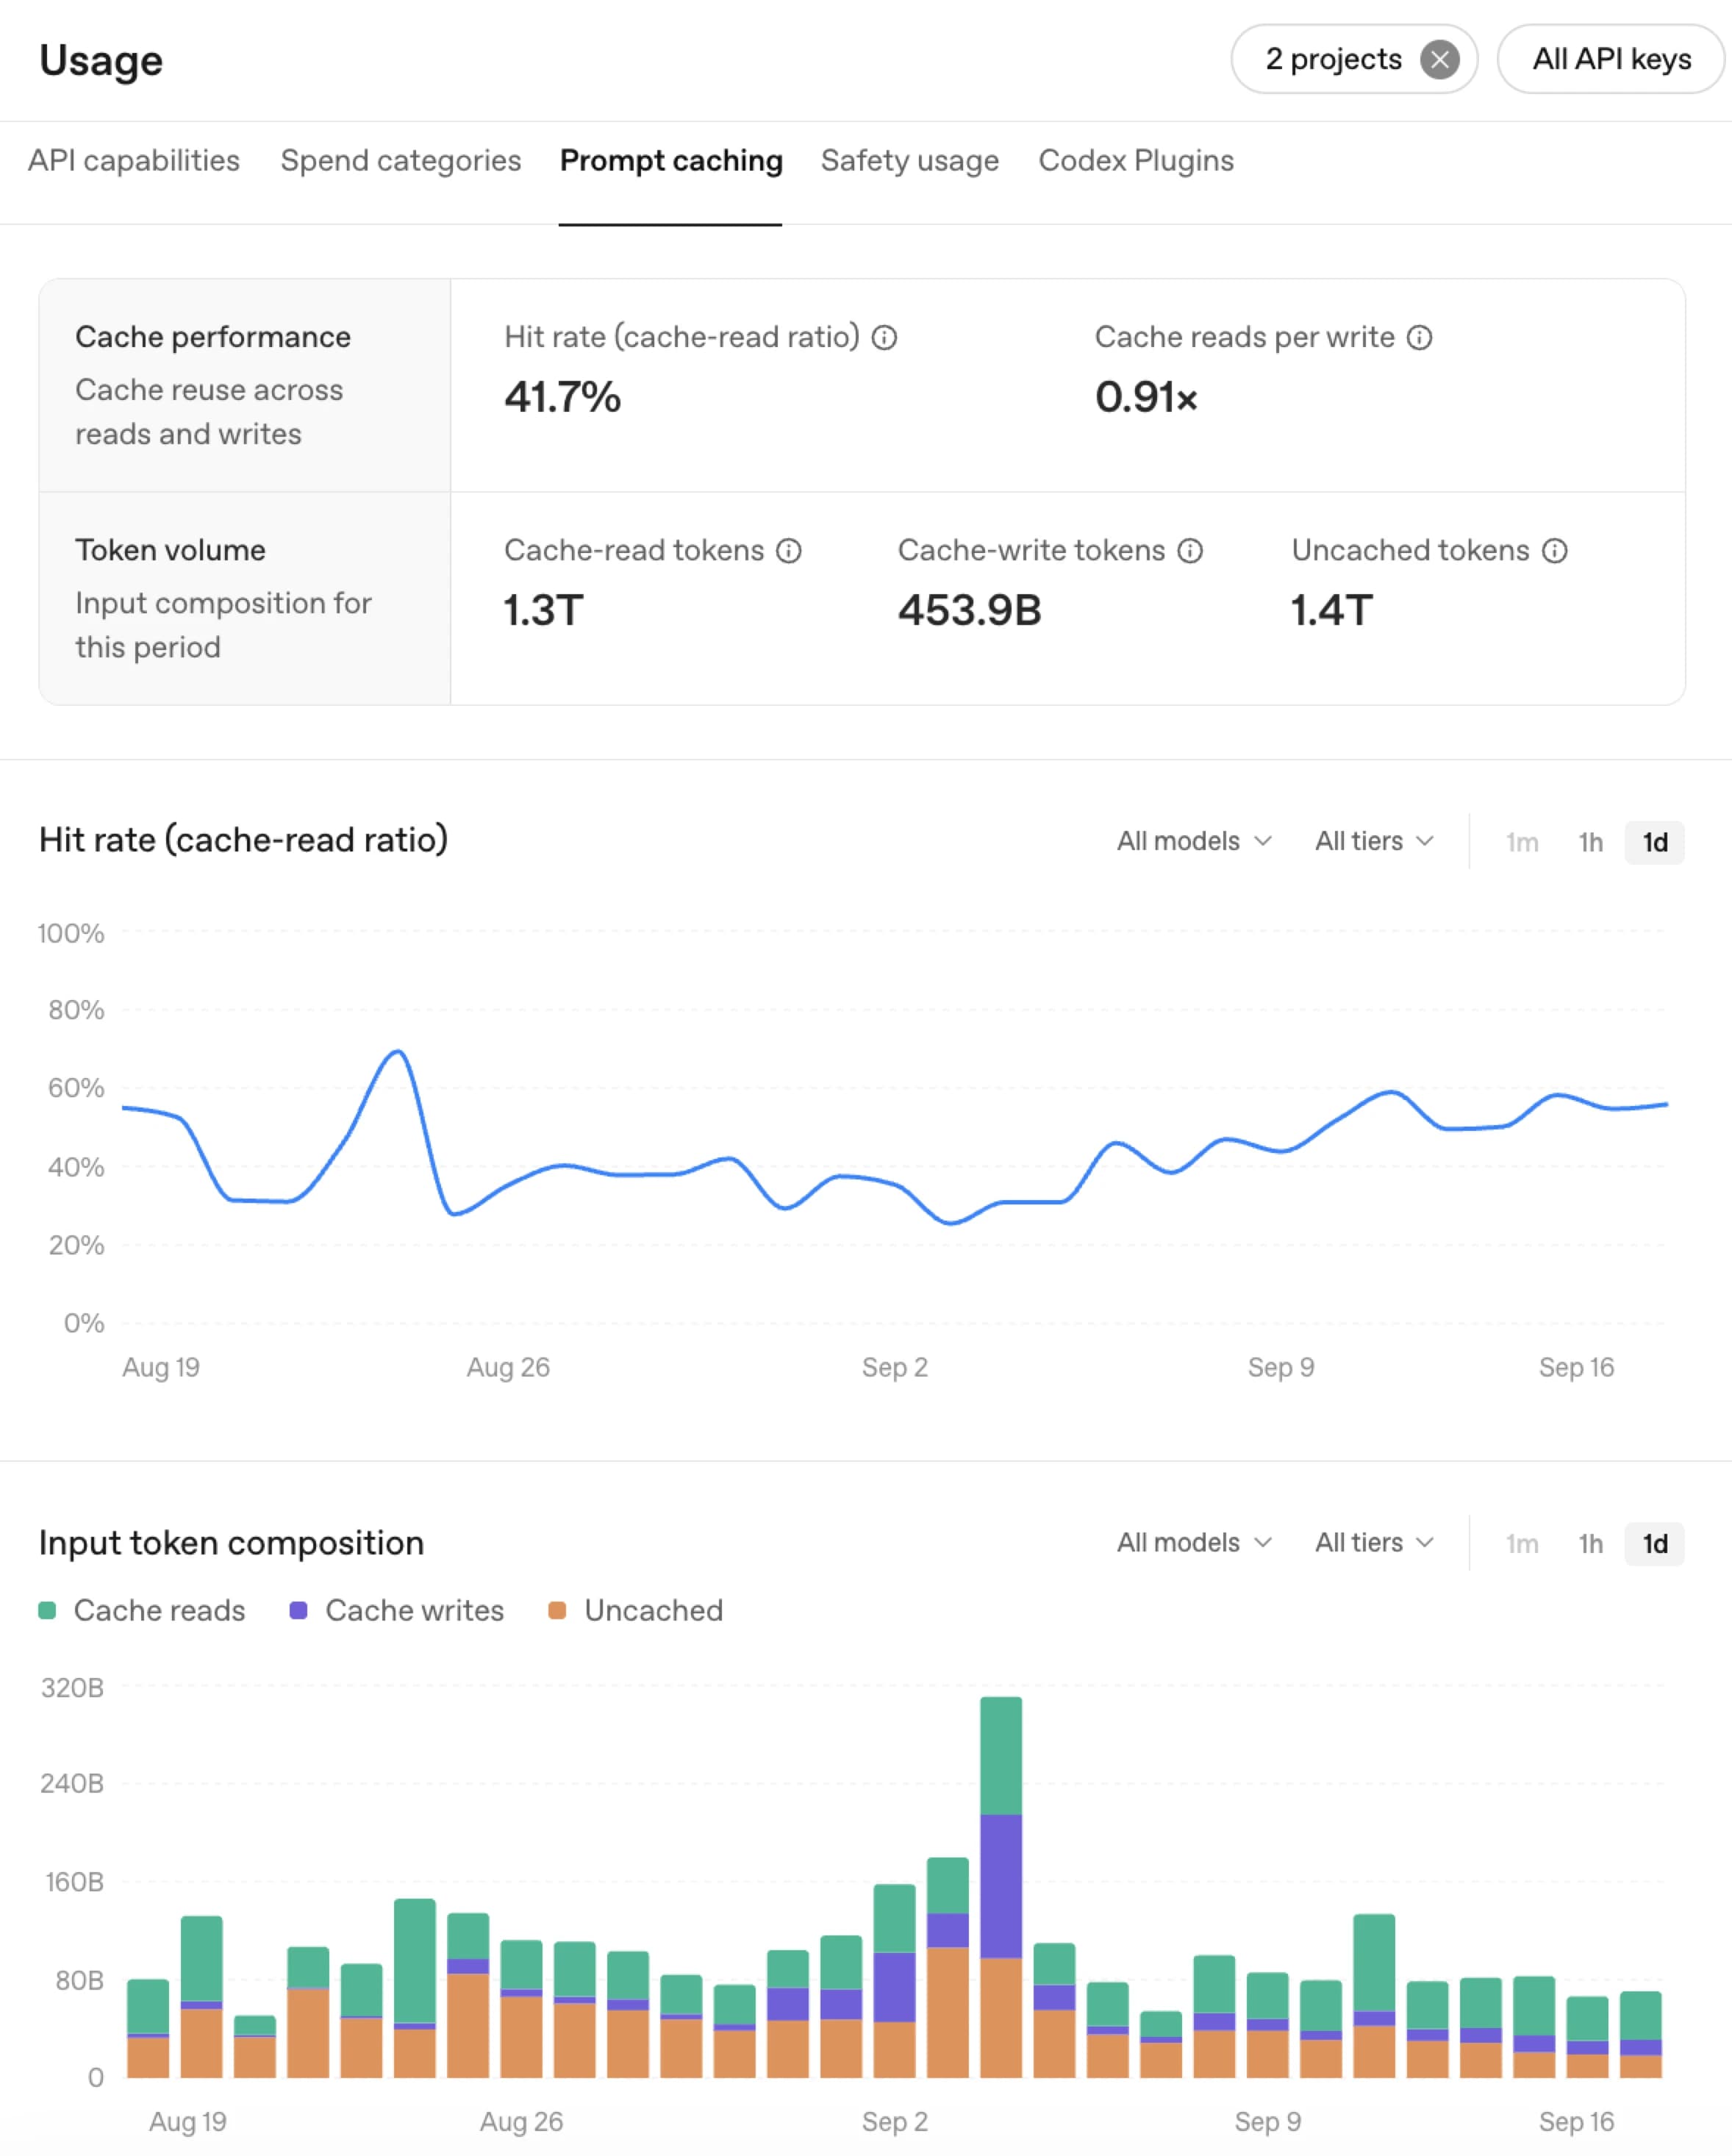
OpenAI ปรับปรุงระบบ Prompt Caching ในตระกูล GPT-6 เพื่อช่วยให้ Persistent Agents ทำงานในโปรเจกต์ซับซ้อน เช่น การ Refactoring โค้ดหรือการสร้างเอกสารวิจัย ได้อย่างมีประสิทธิภาพมากขึ้น โดยระบบจะจัดเก็บ Shared Prefixes ที่เข้าเงื่อนไขไว้ใน Cache นาน 30 นาที เพื่อลดการประมวลผลซ้ำในคำขอ API ที่ต่อเนื่องกัน ซึ่งช่วยลดเวลาการตอบสนองและมอบส่วนลดให้แก่นักพัฒนาสูงสุดถึง 90% สำหรับ Input Tokens ที่ถูกเรียกใช้จาก Cache เพื่อเพิ่มความโปร่งใสในการใช้งาน OpenAI ได้เปิดตัว Prompt Caching Dashboard(opens in a new window) ใหม่ที่ช่วยให้นักพัฒนาสามารถติดตามอัตรา Hit Rate และตรวจสอบองค์ประกอบของ Token ได้อย่างชัดเจน มุมมองข้อมูลเหล่านี้จะช่วยให้ตรวจพบความผิดปกติของประสิทธิภาพการทำ Caching ได้ทันที เมื่อมีการเปลี่ยนแปลงโค้ดหรือการตั้งค่าในแอปพลิเคชัน
ในกรณีที่เกิด Cache Miss ที่ไม่คาดคิด นักพัฒนาสามารถใช้ prompt caching diagnostics tool(opens in a new window) เพื่อเปรียบเทียบคำขอกับการตอบสนองล่าสุด เพื่อระบุว่าการเปลี่ยนแปลงในส่วนใด เช่น โมเดล เครื่องมือ หรือ Input ที่ทำให้ระบบไม่สามารถนำข้อมูลเดิมกลับมาใช้ใหม่ได้ ช่วยให้การปรับแต่งระบบทำได้แม่นยำยิ่งขึ้นเพื่อรักษาอัตรา Cache Hit ให้สูงที่สุด
{
  "prompt_cache_diagnostics": {
    "type": "cache_miss",
    "reason": "tools_changed",
    "comparison_reusable_tokens": 5629,
    "cache_missed_tokens": 5629
  }
}
ฟีเจอร์ใหม่อีกประการคือ การเลือกส่วนที่จะ Cache ผ่านจุดพักแบบกำหนดเอง (Explicit Cache Breakpoints) โดยนักพัฒนาสามารถศึกษาขั้นตอนการใช้งานและระยะเวลาคงอยู่ของข้อมูลได้ที่ prompt caching guide(opens in a new window) ที่ปรับปรุงใหม่ ซึ่งจะอธิบายถึงผลกระทบจากการเปลี่ยนเครื่องมือและ Input ที่มีต่อการนำข้อมูลกลับมาใช้ใหม่
สำหรับโมเดล GPT-6 นักพัฒนาสามารถ change reasoning effort(opens in a new window) หรือปรับระดับความพยายามในการใช้เหตุผลระหว่างการสนทนาได้โดยไม่ทำให้ Cache หลุด ซึ่งทำได้โดยการส่ง configuration_update เพื่อเพิ่มหรือลดระดับความพยายามให้เหมาะสมกับความยากของงานในขณะนั้น โดยที่ยังรักษาบริบทเดิมในระดับ Request-level ไว้ได้อย่างครบถ้วน
นอกจากนี้ การรักษาโครงสร้างของเครื่องมือ (Tool Definitions) ให้คงที่ยังเป็นสิ่งสำคัญ เมื่อความต้องการใช้งานเปลี่ยนไป แนะนำให้ใช้ allowed_tools หรือตั้งค่า tool_choice เป็น none แทนการลบการนิยามเครื่องมือทิ้ง เพื่อให้บริบทเดิมยังคงนำกลับมาใช้ใหม่ได้ โดยสามารถศึกษาแนวทางเพิ่มเติมได้ที่ guidance on managing tool changes(opens in a new window)
สุดท้ายคือกรรมวิธี Prewarm Cache เพื่อลดความหน่วงล่วงหน้า Prewarming(opens in a new window) จะช่วยเตรียมบริบทที่ทราบล่วงหน้า เช่น คำแนะนำที่ใช้ร่วมกันหรือเอกสารอ้างอิง ตั้งแต่ช่วงเริ่มต้นระบบก่อนที่ผู้ใช้จะเริ่มถามคำถามแรก ซึ่งเป็นการย้ายภาระการประมวลผลออกไปจากการรอคอยของผู้ใช้โดยตรง
- ตรวจสอบอัตรา cache hit ได้ใน - Prompt Caching Dashboard(opens in a new window)
- ตรวจสอบการ miss ที่ไม่คาดคิดด้วย - diagnostics tool(opens in a new window)
- ติดตาม - prompt caching guide(opens in a new window)- use Codex(opens in a new window)
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร