
Google เปิดตัว Gemini 3.8 Flash TTS ออกแบบเสียงด้วย Prompt ได้
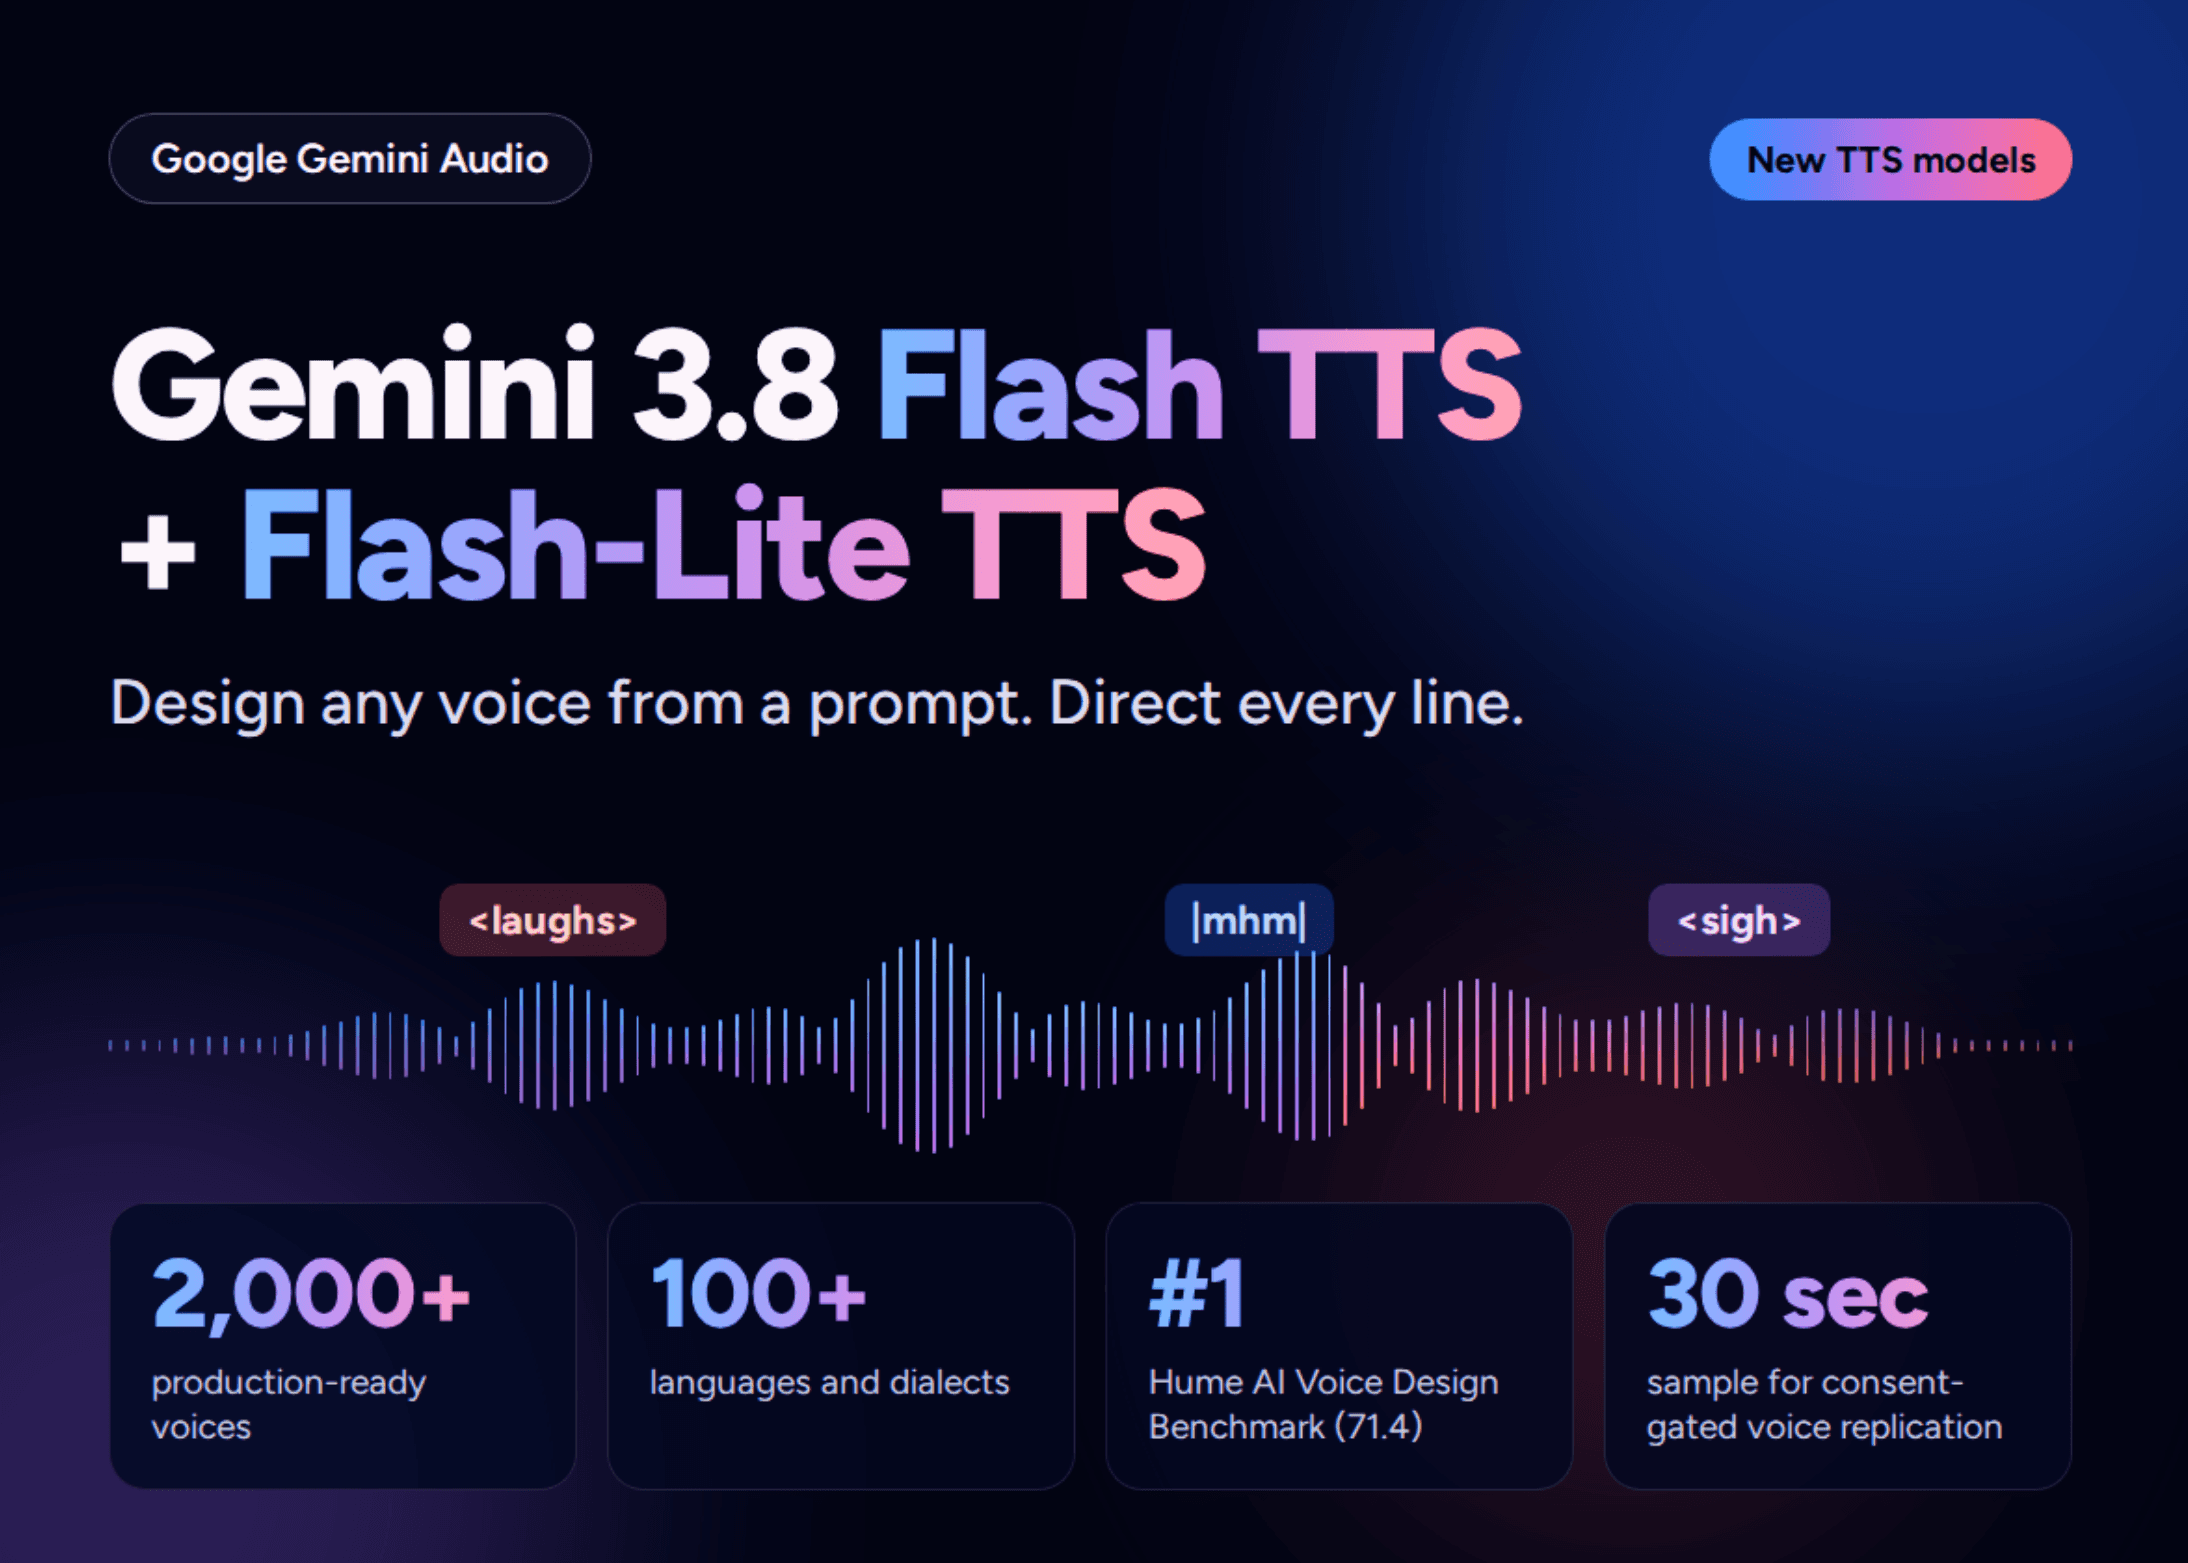
Google เปิดตัว Gemini 3.8 Flash TTS และ Gemini 3.8 Flash-Lite TTS โมเดลสร้างเสียงพูด (Text-to-Speech) สองรุ่นใหม่ล่าสุดในตระกูล Gemini Audio โดยชูจุดเด่นเรื่องการแสดงอารมณ์ที่สมจริงที่สุดเท่าที่เคยมีมา ช่วยให้นักพัฒนาสามารถกำกับการถ่ายทอดเสียงแบบบรรทัดต่อบรรทัดได้ผ่านภาษาธรรมชาติ
ปัจจุบันทั้งสองโมเดลเริ่มเปิดให้ใช้งานแล้วผ่าน Gemini API และ Google AI Studio ในรูปแบบ API เท่านั้น และยังไม่มีแผนปล่อย open weights สำหรับการติดตั้งเอง ส่วนบริการสำหรับองค์กรผ่าน Gemini Enterprise คาดว่าจะตามมาในเร็วๆ นี้
สิ่งที่ Google ส่งมอบ
Google แบ่งระดับโมเดล TTS ออกเป็น 2 เกรด เพื่อตอบโจทย์การใช้งานที่ต่างกัน:
- Gemini 3.8 Flash TTS: ออกแบบมาสำหรับการกำกับเชิงสร้างสรรค์ขั้นสูง เหมาะกับงานที่ต้องการความละเอียด เช่น เกม, หนังสือเสียง, พอดแคสต์ และสื่อเชิงโต้ตอบ โดยควบคุมได้ลึกถึงจังหวะ สำเนียง และการโต้ตอบในบทสนทนา
- Gemini 3.8 Flash-Lite TTS: เน้นความคุ้มค่าและการขยายตัวในปริมาณมาก เหมาะสำหรับการพากย์เสียงทั่วไปและการสร้าง Voice Agents ที่ยังคงความหลากหลายทางอารมณ์ได้ดี
สำหรับการทดสอบใน AI Studio นักพัฒนาสามารถใช้งานผ่านตัวระบุโมเดล gemini-3.8-flash-tts และ gemini-3.8-flash-lite-tts
การออกแบบเสียงจาก Text Prompt
การอัปเดตครั้งนี้ถือเป็นก้าวกระโดดจากเดิมที่มีเพียง 30 เสียง สู่ระบบเสียงขนาดใหญ่ที่ปรับแต่งได้แทบไม่จำกัด โดยมีฟีเจอร์เด่นดังนี้:
- Generative Voice Design: สร้างเสียงใหม่ได้จาก Prompt ที่ระบุบทบาทหรือลักษณะเฉพาะ รองรับกว่า 100 ภาษา เช่น การสร้างเสียงมังกรญี่ปุ่น หรือดีเจชาวเมลเบิร์น
- คลังเสียงสำเร็จรูป: มีเสียงพร้อมใช้มากกว่า 2,000 เสียง ครอบคลุมสำเนียงท้องถิ่นที่หลากหลาย เช่น ภาษาอังกฤษสำเนียงสกอต หรือภาษาสเปนเม็กซิกัน
- การบันทึกและขยายผล: สามารถบันทึกเสียงที่ออกแบบไว้เพื่อนำกลับมาใช้ใหม่ในโปรเจกต์อื่นได้โดยคุณภาพไม่เพี้ยน
การกำกับการแสดงที่สมจริง
โมเดลใหม่รองรับคำสั่งกำกับการแสดงที่แทรกอยู่ในสคริปต์ ช่วยให้เสียงพูดต่อเนื่องหลายชั่วโมงยังคงคุณภาพและจังหวะที่สม่ำเสมอ รองรับการสร้างบทสนทนาแบบ 2 ผู้พูดที่มีเสียงแยกจากกันชัดเจนในสคริปต์เดียว
นอกจากนี้ยังเพิ่มมิติด้วย Vocal Bursts เช่น เสียงหัวเราะ <laughs>, เสียงถอนหายใจ <sigh> หรือการตอบรับขณะฟังอย่าง |mhm| ซึ่งช่วยให้จังหวะการสนทนาดูเป็นธรรมชาติและมีความเป็นมนุษย์มากขึ้น
ระบบความปลอดภัยและการจำลองเสียง
สำหรับการจำลองเสียง (Voice Replication) ระบบต้องการตัวอย่างเสียงเพียง 30 วินาที แต่มีเงื่อนไขด้านความปลอดภัยที่เข้มงวด โดยผู้ใช้งานต้องได้รับความยินยอมจากเจ้าของเสียงและต้องบันทึกเสียงยืนยันตัวตนเพื่อตรวจสอบย้อนกลับได้
ทุกผลลัพธ์เสียงที่สร้างจาก Gemini Audio จะถูกฝังลายน้ำ SynthID ซึ่งมองไม่เห็นแต่ตรวจสอบได้ รวมถึงมีการใช้ Content Credentials ตามมาตรฐาน C2PA เพื่อระบุแหล่งที่มาของเนื้อหา ตามแนวทางใน Gemini 3.8 Audio model card
ผลการทดสอบ Benchmark
จากการทดสอบประสิทธิภาพ Gemini 3.8 Flash TTS สามารถคว้าอันดับ 1 ใน Hume AI Voice Design Benchmark ด้วยคะแนน 71.4 และขึ้นนำเป็นอันดับหนึ่งในด้านการจำลองสำเนียงด้วยคะแนน 60.8 ตามรายงานของ Hume AI
นอกจากนี้ ทั้งสองรุ่นยังครองตำแหน่งสูงสุดในการทดสอบภาษาอื่นๆ เช่น ญี่ปุ่น, เวียดนาม และอาหรับ รวมถึงได้รับความนิยมสูงจากการทดสอบแบบ Blind Preference ใน Voice Arena อีกด้วย
ประเด็นสำคัญ
- เปิดตัวโมเดลแยกตามการใช้งาน: Flash สำหรับงานครีเอทีฟ และ Flash-Lite สำหรับงานสเกลใหญ่
- รองรับการออกแบบเสียงผ่าน Prompt มากกว่า 100 ภาษา
- เพิ่มคลังเสียงจาก 30 เสียง เป็นมากกว่า 2,000 เสียง
- ระบบจำลองเสียงมีความปลอดภัยสูง ต้องใช้เสียงยินยอมตัวจริงเท่านั้น
- คว้าอันดับ 1 ในการทดสอบประสิทธิภาพการออกแบบเสียงระดับโลก
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร