
เร่งสปีดจำลองหุ่นยนต์ด้วย NVIDIA Warp และ MJWarp บน GPU
MuJoCo แบบดั้งเดิมช่วยให้การจำลองหุ่นยนต์ robot simulation บน CPU ทำได้อย่างรวดเร็วสำหรับการทดสอบและควบคุม แต่เมื่อภาระงานด้านการเรียนรู้ (learning workloads) เพิ่มขึ้น ความท้าทายจึงเปลี่ยนจากความเร็วในการรันโลก (world) เดียว ไปเป็นการรันหลายโลกพร้อมกันให้ได้มากที่สุด การเร่งความเร็วด้วย GPU จึงเข้ามาตอบโจทย์นี้โดยการประมวลผลเป็นชุดขนาดใหญ่ (large batches) พร้อมเก็บข้อมูลไว้ใกล้กับอุปกรณ์
MuJoCo Warp (MJWarp) พัฒนาขึ้นบน NVIDIA Warp เพื่อย้ายโมเดล MuJoCo เข้าสู่โหมดการทำงานระดับ GPU ในบทความนี้ เราจะสาธิตการย้ายแขนกล SO-101 จากระบบเดิมไปยังสภาพแวดล้อม MJWarp ที่ทำงานขนานกันได้สูงสุดถึง 2,048 โลก พร้อมเจาะลึกเทคโนโลยีที่ทำให้การเปลี่ยนผ่านนี้เป็นไปได้
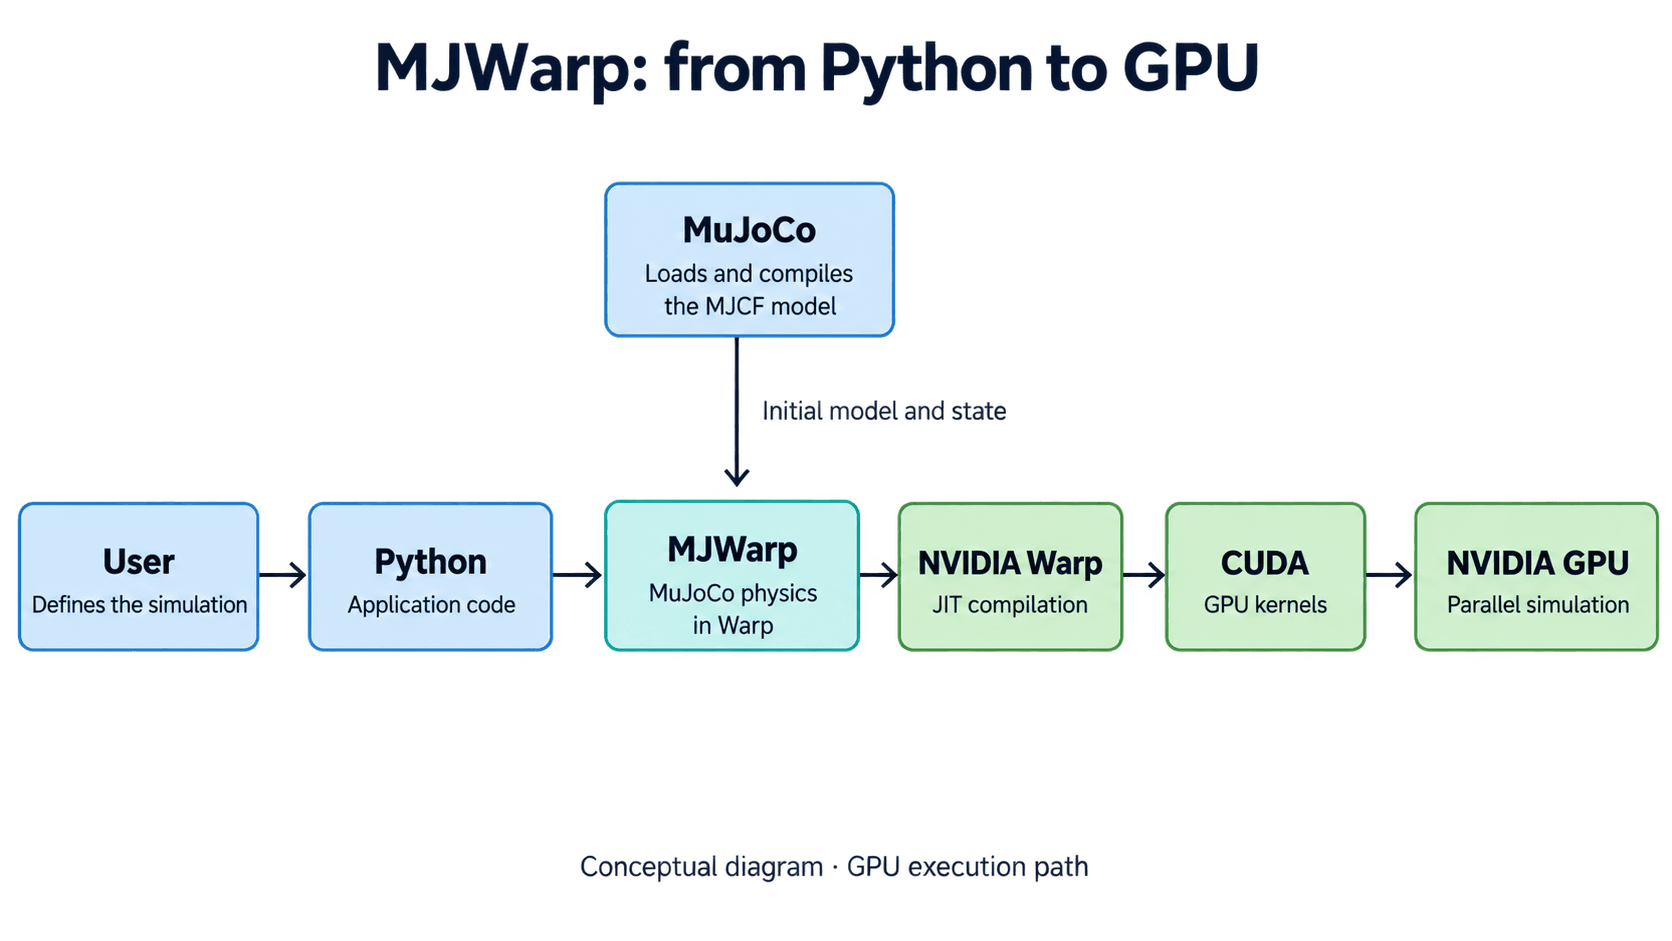
รูปที่ 1. วิธีที่ MJWarp เชื่อมต่อ Python กับการจำลองบน GPU โดย MuJoCo จะโหลดและคอมไพล์โมเดล MJCF; MJWarp จะนำฟิสิกส์ไปใช้ใน NVIDIA Warp ซึ่งจะคอมไพล์ CUDA kernels เพื่อประมวลผลสถานะการจำลองบน NVIDIA GPU
บทความนี้เป็นส่วนที่สองของชุดบทความ State of Simulation for Physical AI โดยจะเน้นการเตรียมและขยายขนาดสภาพแวดล้อมจำลอง ส่วนรายละเอียดเรื่องการฝึกนโยบาย (policy) ผ่าน Newton และ Isaac Lab จะมีการนำเสนอในลำดับถัดไป
การประกอบเข้าด้วยกัน
| เลเยอร์ | บทบาทใน stack |
|---|---|
| NVIDIA Warp | ภาษา kernel ของ Python: รองรับ SIMT, autodiff และทำงานร่วมกับ PyTorch/JAX |
| MJWarp | ฟิสิกส์ MuJoCo บน Warp: ใช้ไฟล์ MJCF เดิมได้ทันที เพื่อเพิ่ม throughput บน GPU |
| ฉากของคุณ (SO-101) | ทรัพยากรจาก Menagerie หรือ Robot Studio ที่คุ้นเคย |
| ถัดไป (Newton / Isaac Lab) | Multi-solver API, ระบบเซ็นเซอร์ และลูปการฝึก |
ตารางช่วยตัดสินใจเลือกใช้งาน:
| หากคุณต้องการ… | ให้เลือกใช้… |
|---|---|
| ควบคุมหุ่นยนต์ตัวเดียว หรือ MPC | MuJoCo CPU |
| Throughput สูงสุดบน MuJoCo | MJWarp (หรือ mjlab) |
| การฝึกด้วย JAX | MuJoCo Playground / MJX (impl='warp') |
| การรวมระบบหลาย Solver | Newton (ติดตามได้ในบทความถัดไป) |
เริ่มต้นด้วย NVIDIA Warp Kernel
NVIDIA Warp เป็นเฟรมเวิร์ก Python สำหรับเขียน kernel ประสิทธิภาพสูงที่เร่งความเร็วด้วย GPU ช่วยให้นักพัฒนาเขียนโค้ดในรูปแบบ Python และคอมไพล์เป็นภาษาเนทีฟเพื่อรันบน CUDA ได้ทันที โดยภาษา kernel จะเป็นส่วนย่อยของ Python ที่เน้นประสิทธิภาพเป็นหลัก
ตัวอย่าง kernel ขนาดเล็กสำหรับคำนวณตำแหน่งจุดภายใต้แรงโน้มถ่วง โดยใช้ logical thread จัดการหนึ่งจุด ทำให้ขยายขนาดจากสองจุดไปสู่หลายล้านจุดได้อย่างง่ายดาย:
import numpy as np
import warp as wp

@wp.kernel
def integrate(
   positions: wp.array[wp.vec3],
   velocities: wp.array[wp.vec3],
   dt: float,
):
   i = wp.tid()
   velocities[i] += wp.vec3(0.0, 0.0, -9.81) * dt
   positions[i] += velocities[i] * dt

wp.init()
device = "cuda:0" if wp.is_cuda_available() else "cpu"
start = np.array([[0.0, 0.0, 0.5], [0.2, 0.0, 0.5]], dtype=np.float32)
positions = wp.array(start, dtype=wp.vec3, device=device)
velocities = wp.zeros_like(positions)

wp.launch(
   integrate,
   dim=len(start),
   inputs=[positions, velocities, 0.01],
   device=device,
)
wp.synchronize_device(device)
print(positions.numpy())
จุดเด่นของ Warp สำหรับงานหุ่นยนต์:
- การขนานงานที่ชัดเจน (Explicit parallel work): ใช้
wp.tid()ระบุหน่วยประมวลผลสำหรับหุ่นยนต์หรือโลกแต่ละใบ - Device arrays: ข้อมูลจะอาศัยอยู่ใน GPU โดยตรง และสามารถแชร์ไปยัง PyTorch หรือ JAX ผ่าน DLPack ได้โดยไม่ต้องคัดลอกข้อมูลซ้ำซ้อน
- CUDA Graphs: รองรับการบันทึกชุดคำสั่ง (graph capture) เพื่อลดภาระการส่งคำสั่งซ้ำๆ ช่วยเพิ่มประสิทธิภาพการรันให้สูงสุด
นอกจากนี้ Warp ยังรองรับ การหาอนุพันธ์ (Differentiability) ผ่าน wp.Tape สำหรับงานฟิสิกส์ที่ต้องใช้ gradient และรองรับ การรันแบบแน่นอน (Deterministic execution) ในเวอร์ชัน 1.15 ซึ่งช่วยให้ผลลัพธ์จากการจำลองมีความแม่นยำและทำซ้ำได้ในการทดสอบระดับสูง
MuJoCo Warp (MJWarp) คืออะไร?
ในการจำลองหุ่นยนต์ "โลก" (world) คือสำเนาสถานะของฉากนั้นๆ MuJoCo บน CPU เหมาะสำหรับการรันไม่กี่โลกเพื่อการพัฒนา แต่ MJWarp จะย้ายสถานะทั้งหมดไปไว้บน NVIDIA GPU ทำให้การเรียก mjw.step เพียงครั้งเดียวสามารถขยับโลกหลายพันใบไปข้างหน้าพร้อมกันได้
จุดเด่นไม่ใช่ความเร็วของโลกใบเดียว (Latency) แต่คือจำนวนโลกทั้งหมดที่ประมวลผลได้ต่อวินาที (Aggregate throughput) ซึ่งจำเป็นอย่างยิ่งสำหรับการเรียนรู้แบบเสริมกำลัง (Reinforcement Learning) ที่ต้องการปริมาณประสบการณ์มหาศาล
การใช้งานเบื้องต้นและการปรับจูน
การเปลี่ยนมาใช้ MJWarp มีความใกล้เคียงกับ API เดิมมาก เช่นการใช้ mjw.put_model แทน MjModel หรือ mjw.step แทน mj_step โดยต้องกำหนดพารามิเตอร์สำคัญอย่าง nworld (จำนวนโลก) และ nconmax (จำนวนการสัมผัสสูงสุดต่อโลก) ให้เหมาะสมกับขนาดหน่วยความจำ GPU เพื่อประสิทธิภาพสูงสุด แนะนำให้ใช้ CUDA graph capture เพื่อบันทึกขั้นตอนการทำงานและรันซ้ำโดยลด Overhead รวมถึงการปรับจูนค่า Solver เพื่อให้ได้ผลลัพธ์ที่แม่นยำที่สุดตามเอกสารประกอบของ MJWarp
ขั้นตอนการย้ายฉากไปยัง MJWarp
- สร้างพื้นฐานบน CPU: เริ่มจากสร้างฉากด้วยไฟล์ MJCF ปกติ เช่น ฉากแขนกล SO-101 หยิบกล่องสีแดงไปวางบนกล่องสีน้ำเงิน
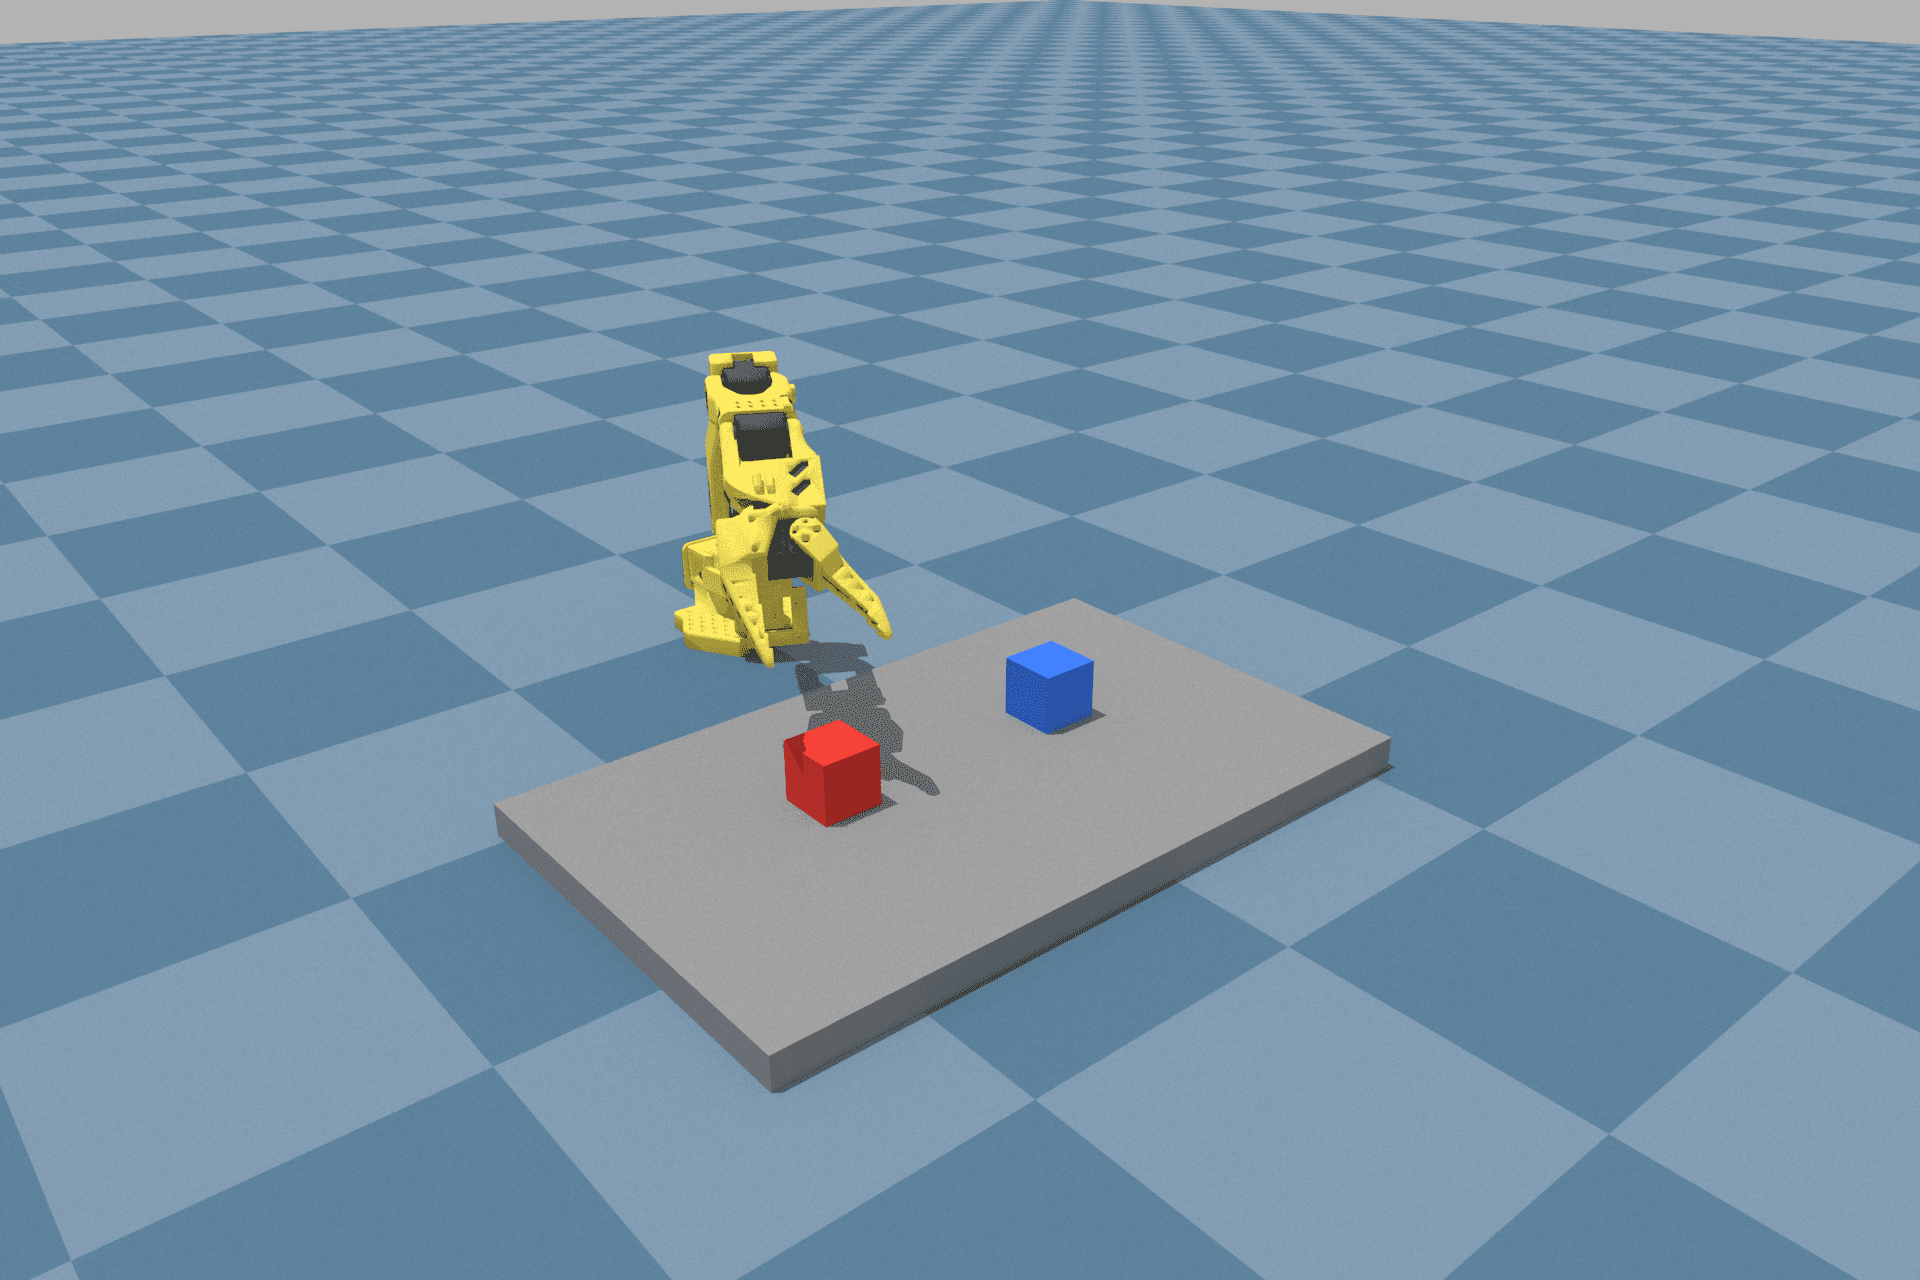
รูปที่ 2. ฉากหยิบและวางของ SO-101 บน MuJoCo CPU สำหรับใช้เป็นตัวเปรียบเทียบความถูกต้องกับ MJWarp
-
ตรวจสอบความเท่าเทียมบน GPU: เริ่มต้นรันเพียง 1 โลกบน GPU เพื่อเปรียบเทียบผลลัพธ์กับ CPU โดยใช้การส่งข้อมูลผ่าน
wp.copyและตรวจสอบความแม่นยำของวิถีการเคลื่อนที่ -
ขยายขนาดเป็น 2,048 โลก: เมื่อยืนยันความถูกต้องแล้ว ให้ขยาย
nworldเป็นขนาดที่ต้องการ โดยใช้np.tileเพื่อจำลองสถานะเริ่มต้นเดียวกันให้ทุกโลก และใช้ CUDA Graphs ในการรันชุดข้อมูลขนาดใหญ่นี้
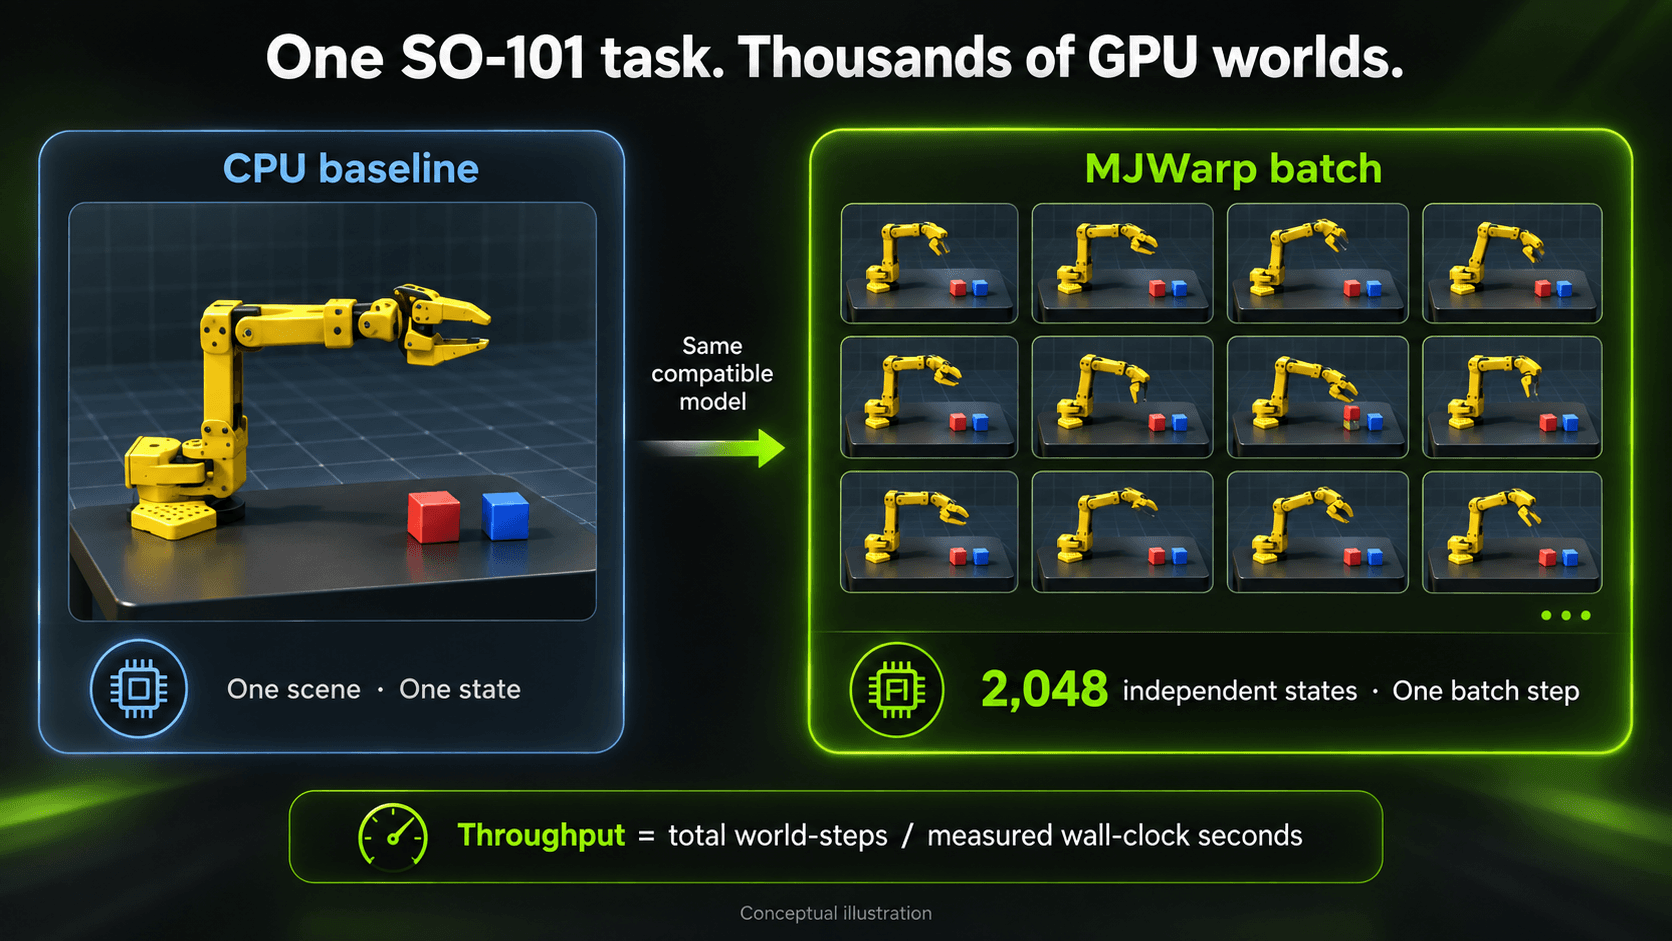
รูปที่ 3. การขยายงานจาก 1 โลกบน CPU ไปสู่ 2,048 โลกบน GPU โดยใช้ MJWarp เพื่อเพิ่ม throughput รวมให้สูงสุด
- การวัดผล: เนื่องจากการทำงานบน GPU เป็นแบบ Asynchronous การวัดเวลาต้องทำการ Synchronize อุปกรณ์ก่อนและหลังเสมอ เพื่อให้ได้ค่า Throughput (world-steps/second) ที่แท้จริง
บทสรุปและขั้นตอนต่อไป
การใช้งาน Warp และ MJWarp ช่วยลดคอขวดในการจำลองฟิสิกส์สำหรับ AI ลงอย่างมาก ในบทความถัดไป เราจะนำฉาก SO-101 นี้เข้าสู่ Newton เพื่อใช้งานฟังก์ชันขั้นสูง เช่น ระบบเซ็นเซอร์ และการเชื่อมต่อกับ Isaac Lab ต่อไป
สำหรับผู้ที่สนใจสามารถเริ่มต้นได้ง่ายๆ ผ่าน pip install mujoco-warp และศึกษาต่อใน Colab tutorial ของโปรเจกต์ได้ทันที
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร