
เปิดตัว DaisyRose-27B โมเดลสาย Agent ประสิทธิภาพสูงจาก RadixArk
RadixArk ประกาศเปิดตัว DaisyRose-27B โมเดลรุ่นแรกของค่ายที่พัฒนาต่อยอดจาก Qwen3.8-27B โดยใช้เทคนิคการฝึกฝนแบบ reinforcement learning ผ่านเฟรมเวิร์ก Miles มุ่งเน้นการเพิ่มประสิทธิภาพในงานประเภท long-horizon agent ซึ่งต้องอาศัยการทำงานต่อเนื่องยาวนาน
กระบวนการฝึกฝนใช้เวลา 18 วัน บน GPU NVIDIA H200 จำนวน 144 ตัว โดยใช้ชุดข้อมูลคุณภาพสูงที่คัดสรรมาเพียง 1,200 งาน แต่ครอบคลุมเซสชันยาวสูงสุดถึง 1M tokens ส่งผลให้ DaisyRose-27B มีคะแนน pass@1 บน Terminal-Bench 4.1 ก้าวกระโดดจาก 5.6% เป็น 12.0% พร้อมแสดงศักยภาพที่โดดเด่นขึ้นในด้านการให้เหตุผล (reasoning), การปฏิบัติตามคำสั่ง และการเขียนโค้ด
ผู้ที่สนใจสามารถใช้งาน checkpoints ภายใต้ใบอนุญาต Apache 2.0 ได้ที่นี่:
โมเดลยังคงโครงสร้างสถาปัตยกรรมเดิมของ Qwen3.8-27B รวมถึง tokenizer และ 256K-token context window สำหรับการใช้งานทั่วไป โดยในส่วนการฝึกฝนระยะยาวได้ใช้ระบบ harness summarization เพื่อช่วยจัดการเส้นทางการประมวลผลที่หลากหลาย สามารถดูรายละเอียดเพิ่มเติมได้ที่ model card
Run DaisyRose-27B
ทางผู้พัฒนาแนะนำให้รัน DaisyRose-27B ด้วย SGLang และระบบ DSpark speculative decoding โดยสามารถศึกษาแนวทางการตั้งค่าสำหรับ GPU รุ่นต่างๆ ได้ที่ SGLang cookbook
เมื่อเริ่มเซิร์ฟเวอร์ด้วยชื่อโมเดล DaisyRose-27B บนพอร์ต 30000 แล้ว สามารถเรียกใช้งานผ่าน OpenAI Python client ได้ดังนี้:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:30000/v1",
    api_key="none",
)

response = client.chat.completions.create(
    model="DaisyRose-27B",
    messages=[
        {
            "role": "user",
            "content": "How many positive divisors does 360 have?",
        }
    ],
    temperature=1.0,
    top_p=0.95,
    extra_body={"top_k": 20, "min_p": 0.0},
)

print(response.choices[0].message.reasoning_content)
print(response.choices[0].message.content)
จุดเด่นของโมเดลนี้คือกระบวนการคิดก่อนตอบ โดยผลลัพธ์การให้เหตุผลจะถูกส่งกลับมาใน reasoning_content ส่วนคำตอบสุดท้ายจะอยู่ใน content ตามมาตรฐาน model card’s quickstart
Benchmark results
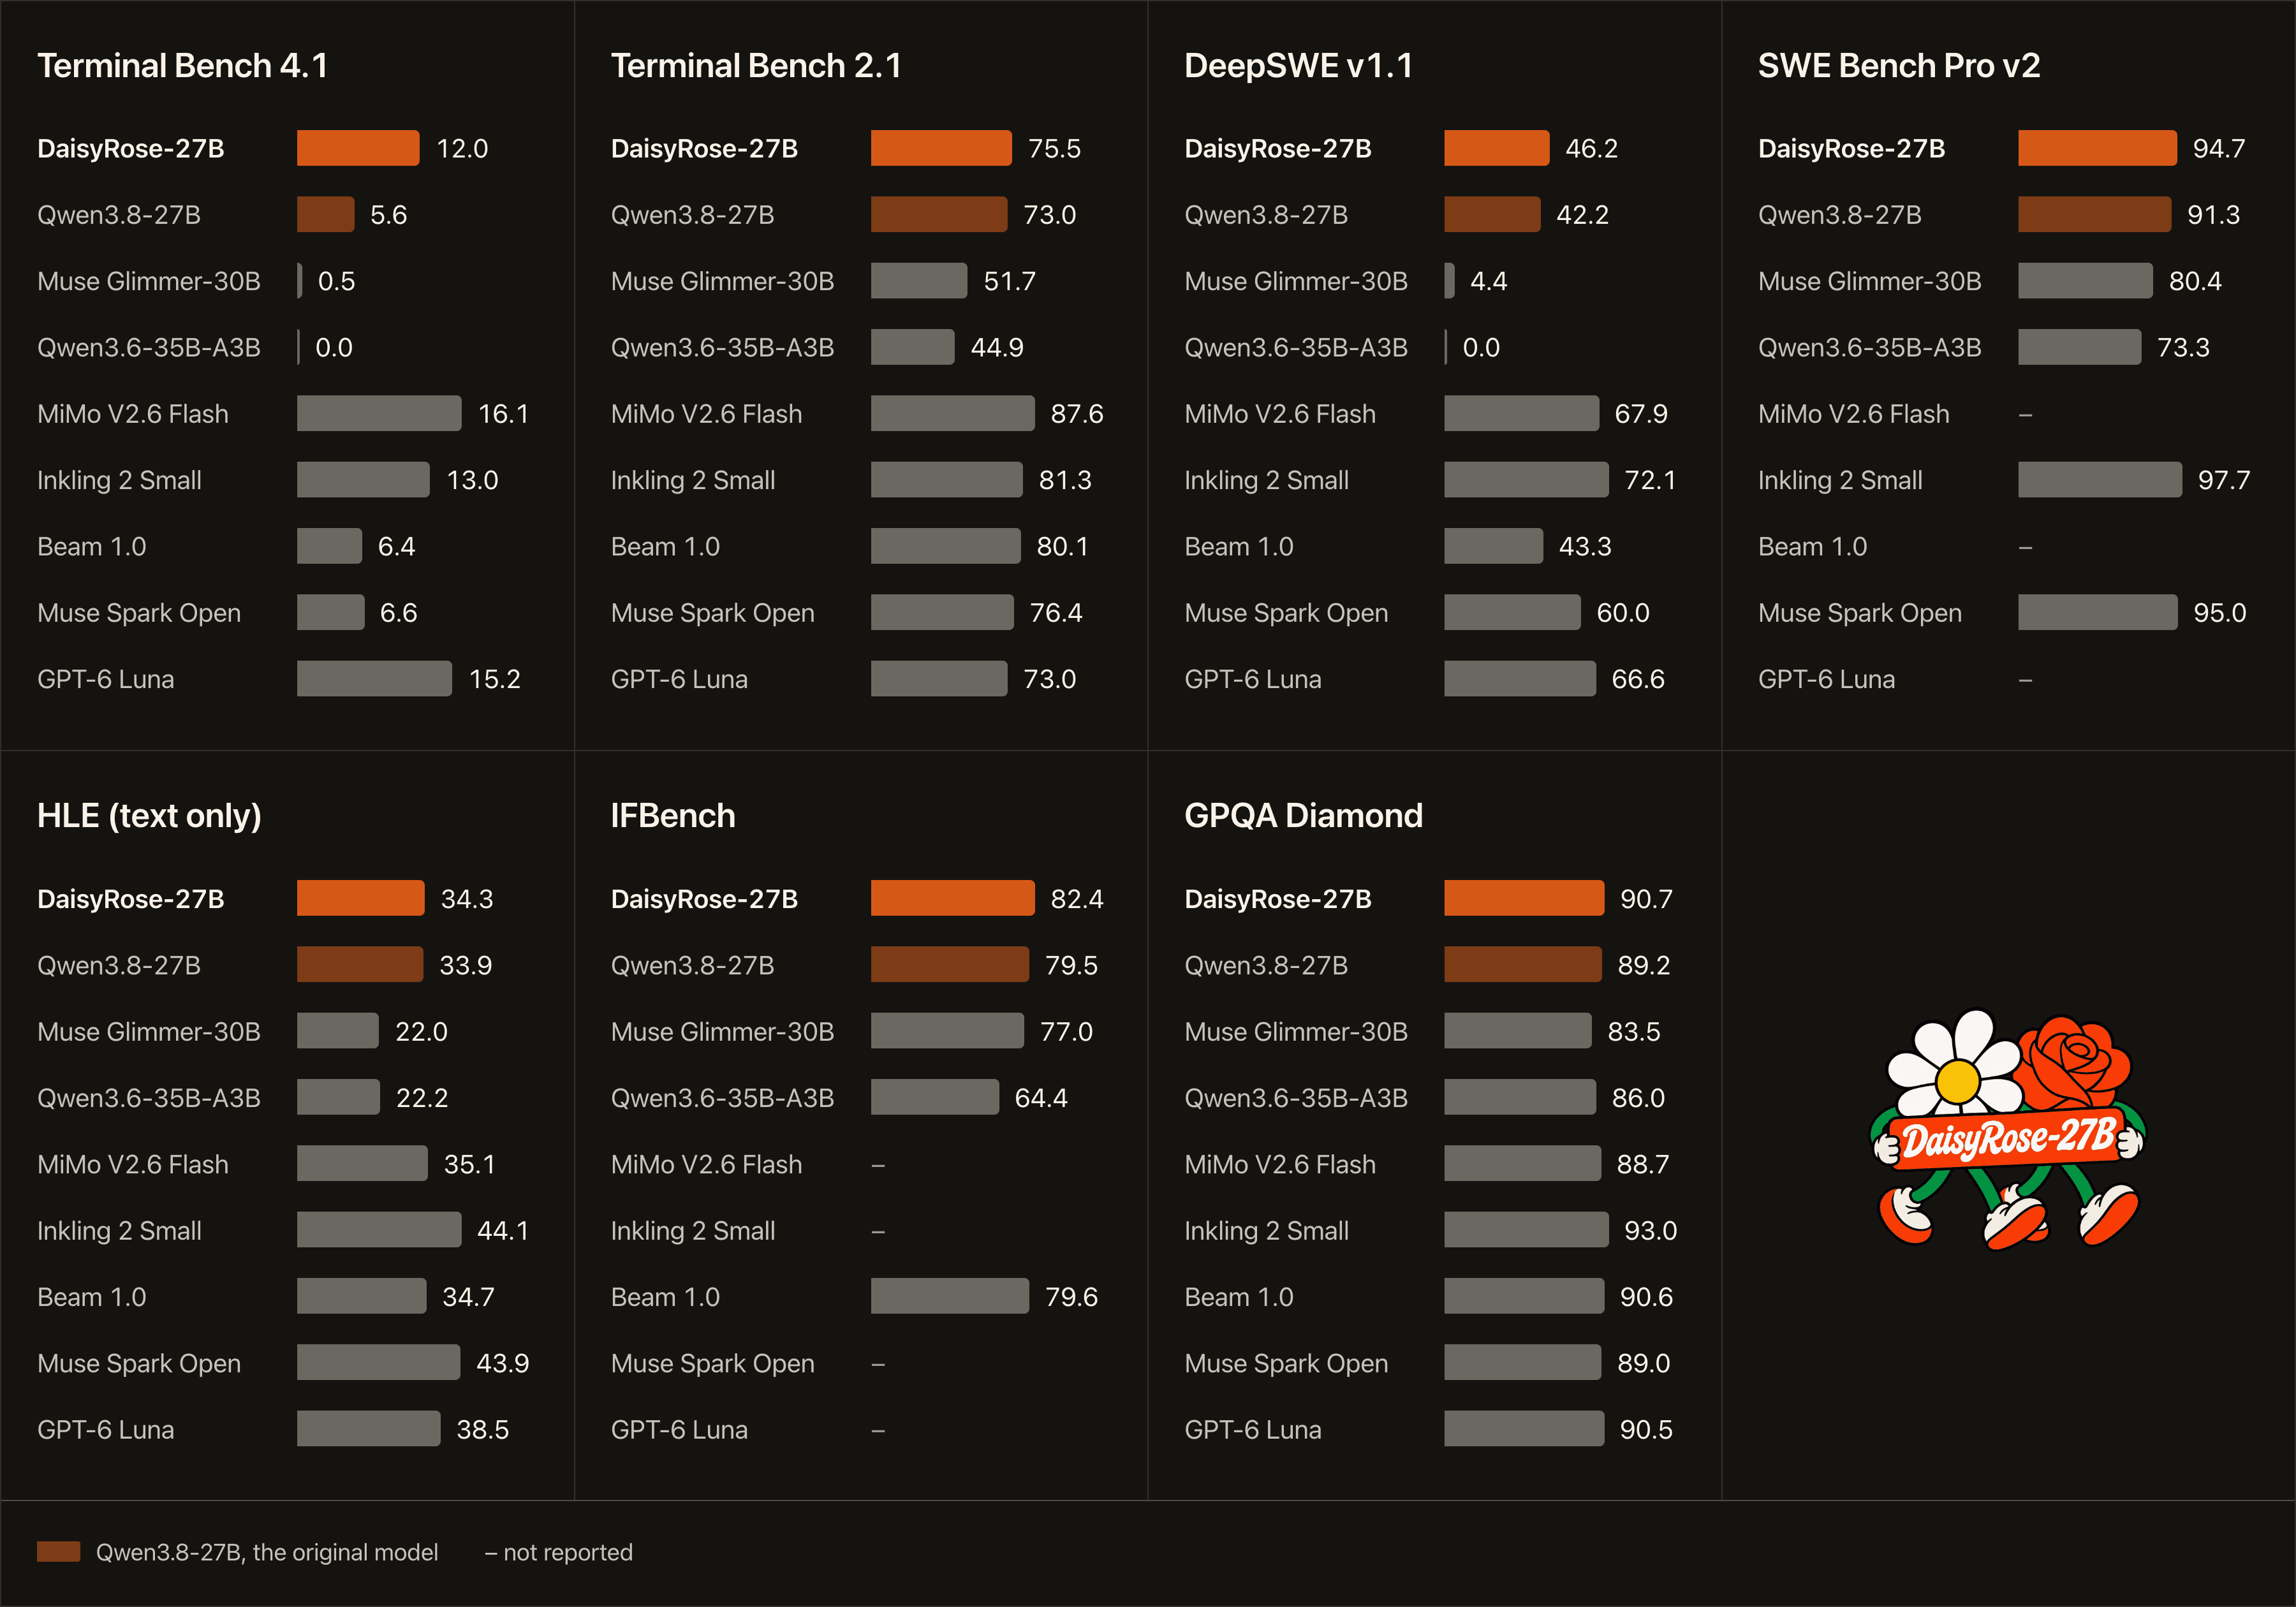
| Benchmark | Qwen3.8-27B | DaisyRose-27B |
|---|---|---|
| Terminal Bench 4.1 | 5.6 | 12.0 |
| Terminal Bench 2.1 | 73.0 | 75.5 |
| DeepSWE v1.1 | 42.2 | 46.2 |
| SWE Bench Pro v2 | 91.3 | 94.7 |
| HLE (text-only) | 33.9 | 34.3 |
| IFBench | 79.5 | 82.4 |
| GPQA Diamond | 89.2 | 90.7 |
DaisyRose-27B ทำคะแนนชนะโมเดลต้นฉบับได้ในทุกหัวข้อการทดสอบ โดยความสำเร็จนี้เกิดจากองค์ประกอบหลัก 3 ส่วน ได้แก่ การออกแบบงานฝึกฝนที่แม่นยำ, ระบบ backend ที่ทรงพลัง และสภาพแวดล้อม sandbox ที่เสถียร
High-quality training data
RadixArk ร่วมมือกับ Eigent AI ในการคัดเลือกงานฝึกฝน 1,200 รายการจากฐานข้อมูลมหาศาล โดยเน้นเกณฑ์สามด้านคือ: มุ่งแก้จุดบกพร่องที่โมเดลเดิมเคยพลาด, งานต้องมีความซับซ้อนหลายขั้นตอนที่สัมพันธ์กัน (อาจใช้เวลาสูงถึง 1.5 ชั่วโมงต่อรอบ) และระบบการให้รางวัลที่ต้องมั่นใจว่าโมเดลแก้ปัญหาได้จริง ไม่ใช่การเดาสุ่ม
Efficient training backend
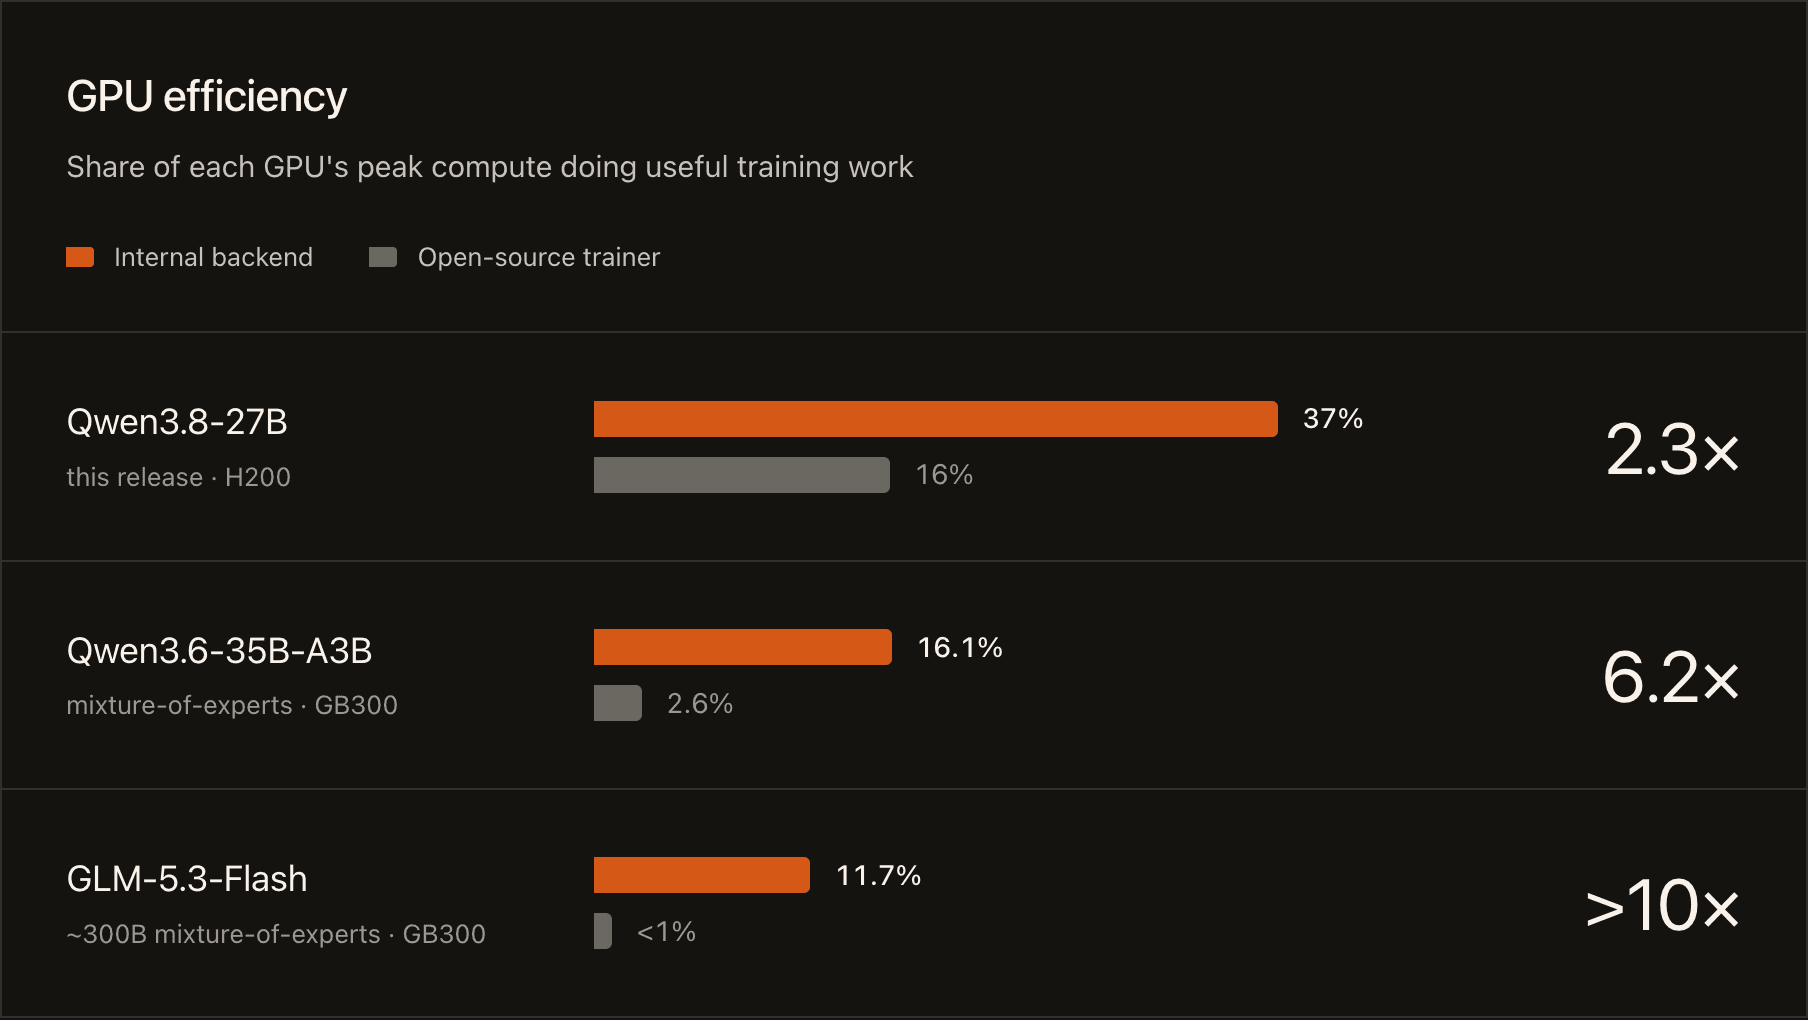
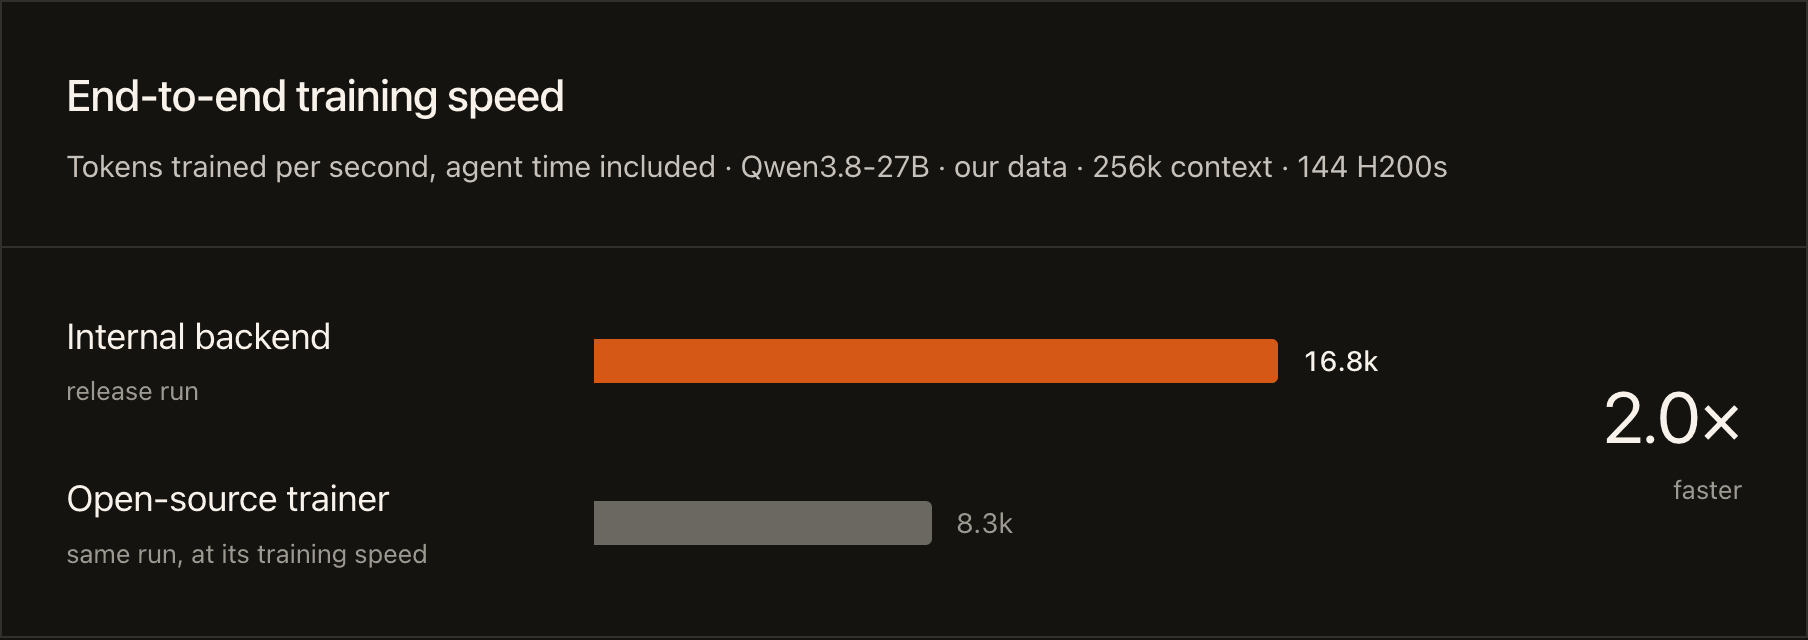
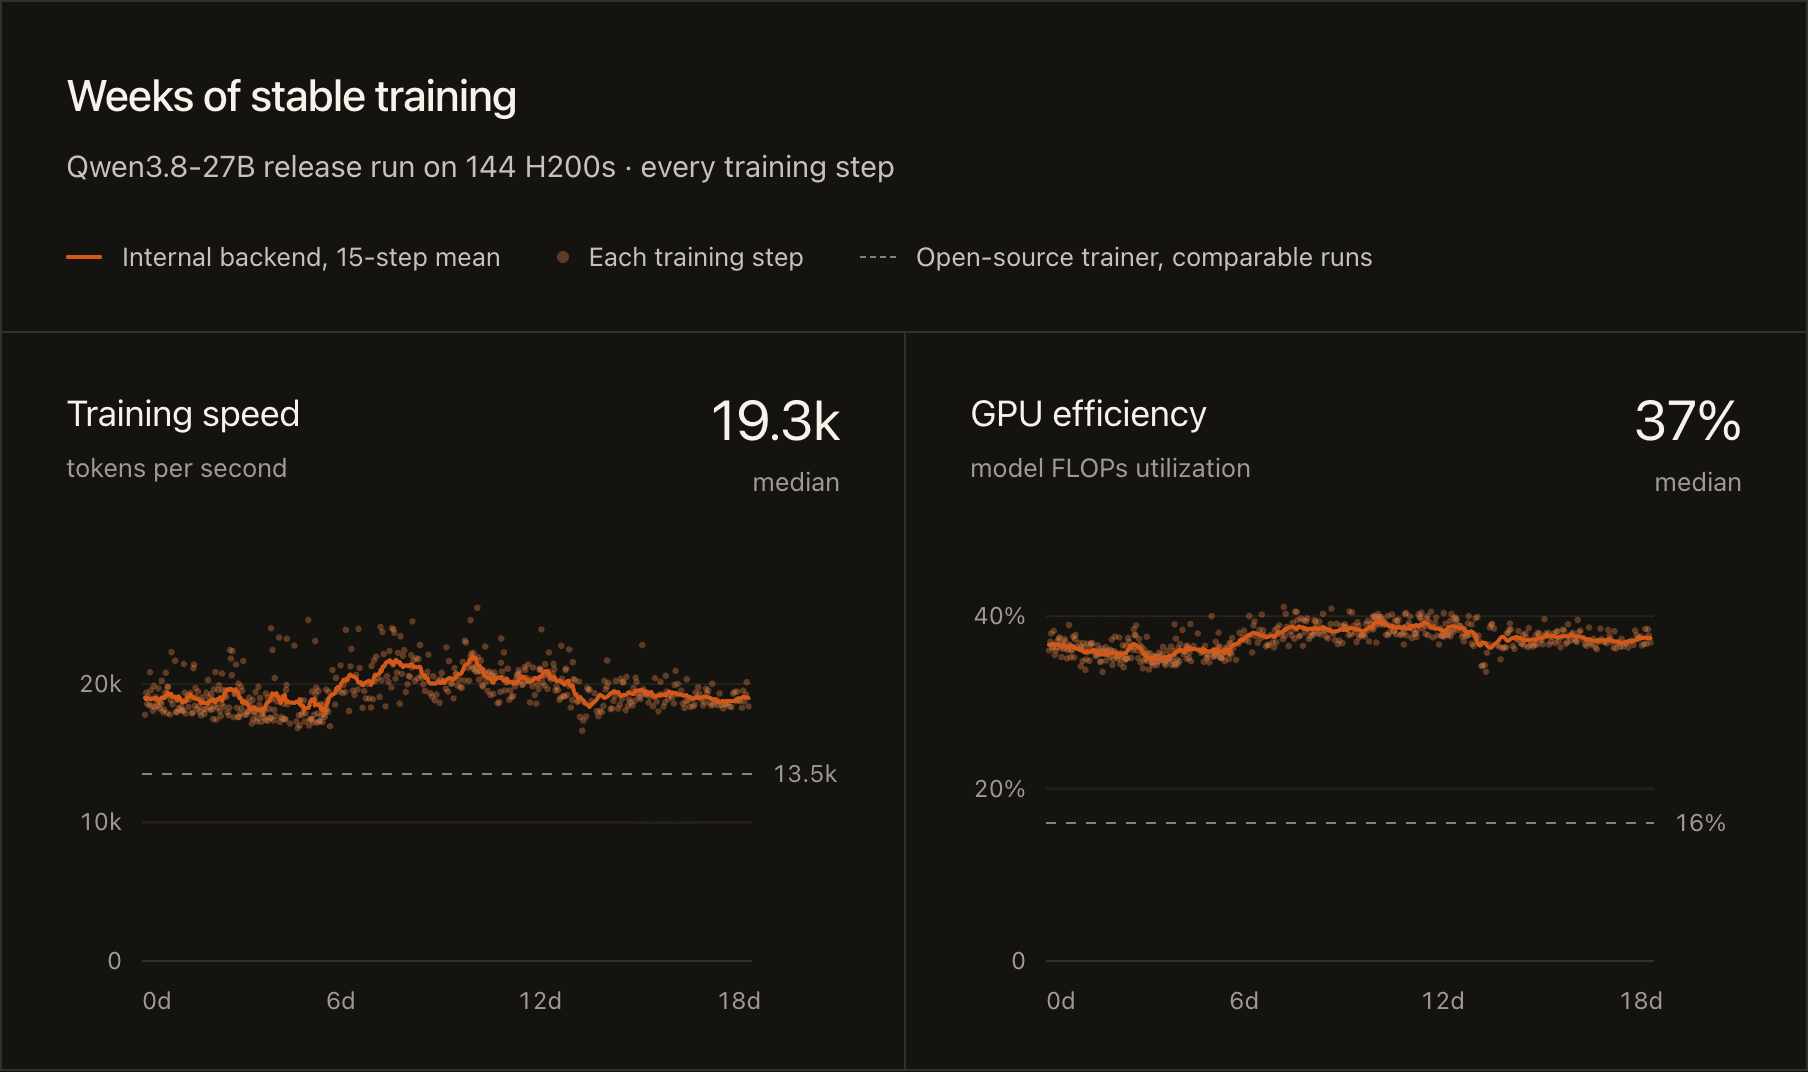
การฝึกฝนผ่าน Miles ในโหมดอะซิงโครนัสช่วยให้ระบบทำงานได้โดยไม่ต้องรอกัน โดยแบ่งหน้าที่ให้ GPU 128 ตัวรัน inference และอีก 16 ตัวทำหน้าที่เป็น trainer ส่งผลให้ ต้นทุนการฝึกฝนลดลงถึง 57% และใช้พลังงาน GPU ได้อย่างมีประสิทธิภาพ (MFU) สูงกว่าเครื่องมือโอเพนซอร์สทั่วไปถึงเท่าตัว
นอกจากนี้ ระบบยังทำงานได้เร็วขึ้น 2 เท่า โดยสามารถประมวลผลได้ 16,800 tokens ต่อวินาที และมีความเสถียรสูงแม้ต้องรันต่อเนื่องเป็นเวลาหลายสัปดาห์ รวมการใช้งานกว่า 63,000 GPU-hours
Robust sandbox service
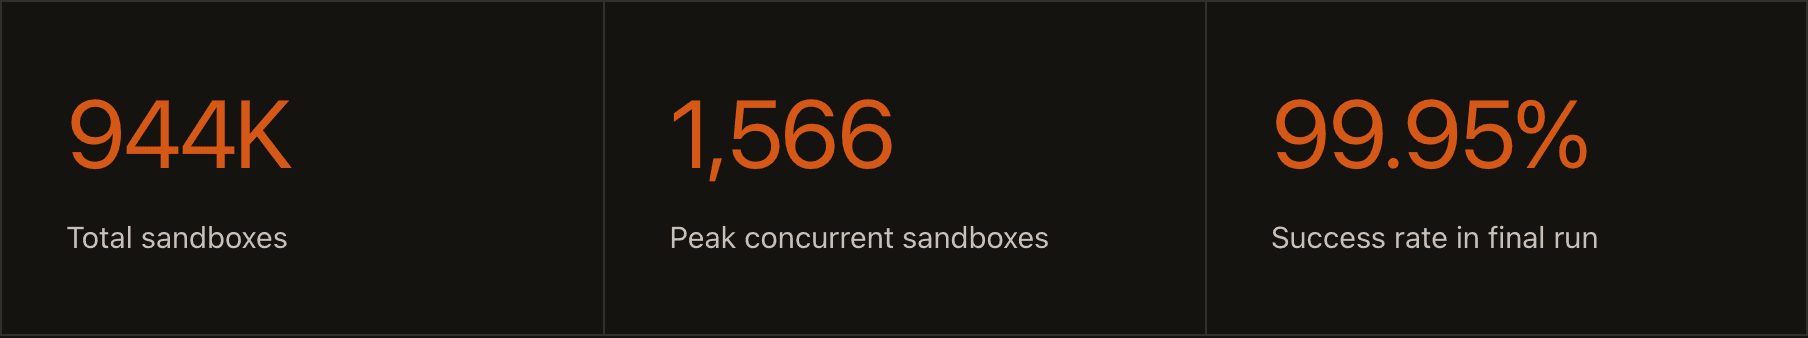
ระบบ sandbox ที่ใช้รันคำสั่งและประเมินผลสร้างขึ้นบนโครงการ AgentENV ซึ่งรองรับการรันพร้อมกันสูงสุดถึง 1,566 ครั้ง และมีอัตราความสำเร็จในการสร้างสภาพแวดล้อมสูงถึง 99.95% ในช่วงท้ายของโครงการ นอกจากนี้ยังช่วยลดค่าใช้จ่ายโครงสร้างพื้นฐานคลาวด์ลงได้ราว 80% ผ่านการจัดการหน่วยความจำที่ยืดหยุ่น
Try the model or train your own
คุณสามารถดาวน์โหลด DaisyRose-27B มาใช้งานได้ทันที หรือใช้เฟรมเวิร์ก Miles เพื่อฝึกฝนโมเดล agent ของคุณเอง และสามารถแบ่งปันผลลัพธ์การใช้งานได้ในแท็บ Community ของหน้าโมเดล
เรียบเรียงจาก บทความต้นฉบับของ RadixArk
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร