
รู้จัก Decision Models ปฏิวัติการตัดสินใจใน Hugging Face
Large Language Models (LLMs) โดดเด่นอย่างมากในการสร้างข้อความ ไม่ว่าจะเป็นการตอบคำถาม เขียนโค้ด หรือการให้เหตุผล แต่ในโลกของความเป็นจริง ไม่ใช่ทุกปัญหาที่จำเป็นต้องแก้ไขด้วยการสร้างข้อความเสมอไป
ลองพิจารณาระบบบริการลูกค้าที่ได้รับข้อความว่า "ฉันถูกเรียกเก็บเงินสองครั้งสำหรับค่าสมัครสมาชิก ฉันต้องการเงินคืนวันนี้" ระบบจำเป็นต้องระบุว่าทีมใดควรจัดการ มีความเร่งด่วนเพียงใด และลูกค้าต้องการเงินคืนหรือไม่ แม้เราจะสั่งให้ LLM ส่งคำตอบกลับมาเป็น JSON ได้ แต่มันอาจไม่ใช่ทางเลือกที่มีประสิทธิภาพที่สุด
llama cli -hf ggml-org/gemma-4-e4b-it-GGUF:Q4_0

> We have the following customer support ticket, "I was charged twice for my subscription. I need a refund today.", which team should handle the request, how urgent it is, and whether the customer is requesting a refund. Give the answers in JSON.

[Start thinking]
...
[end thinking]
{
"team_to_handle": "Billing",
"urgency": "High",
"request_refund": true
}จะเป็นอย่างไรถ้าโมเดลสามารถประเมินตัวเลือกและส่งคืนค่าความน่าจะเป็น (probability distribution) ของตัวเลือกเหล่านั้นได้โดยตรง โดยไม่ต้องเสียเวลาสร้างข้อความแม้แต่โทเคนเดียว?
from transformers import pipeline

decide = pipeline("decision", model="autotrust/GEV-26B-Decide")
decision = decide(
    {
        "state": "I was charged twice for my order and want a refund.",
        "questions": {
            "department": {
                "type": "choice",
                "instructions": "Which team should handle this?",
                "criteria": {
                    "billing": "Payments and refunds",
                    "technical": "Bugs and technical issues",
                    "sales": "Pricing and subscriptions"
                }
            },
        }
    }
)
นี่คือแนวคิดสำคัญเบื้องหลัง decision models
decision models คืออะไร?
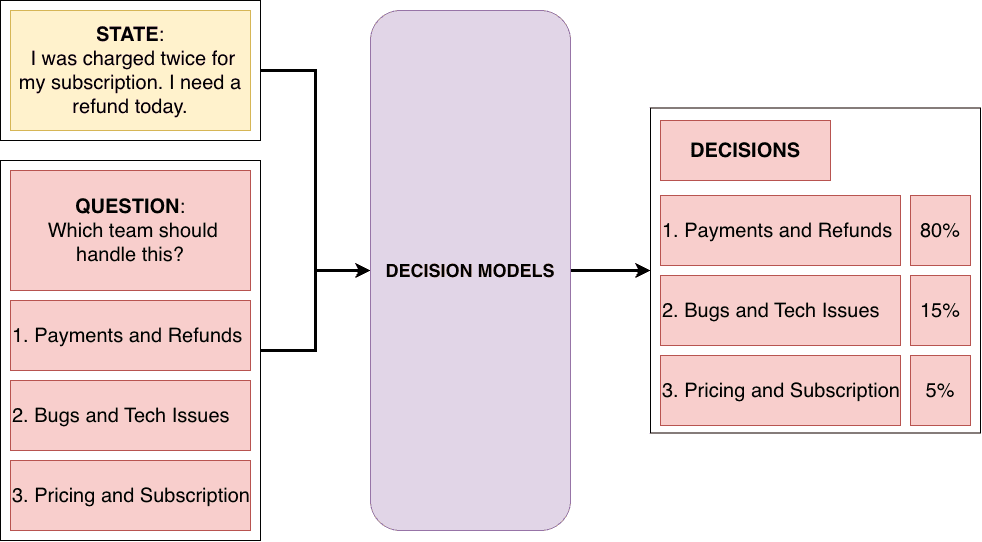
decision model จะรับบริบทอินพุต (state) และประเมินคำถามด้วยชุดคำตอบที่กำหนดไว้ล่วงหน้า (primitives) จากนั้นจะส่งคืนผลการตัดสินใจที่มีโครงสร้างพร้อมค่าความน่าจะเป็น แทนที่จะรอให้โมเดลสร้างคำตอบทีละโทเคน เราให้มันกำหนดค่าความน่าจะเป็นให้กับสิ่งที่ระบบของเราเข้าใจอยู่แล้ว
TypeSafe AI ได้แนะนำ Jev โดยอธิบายว่าเป็น System One model ซึ่งได้แรงบันดาลใจจากแนวคิดการคิดที่รวดเร็วและใช้สัญชาตญาณ (System 1) ต่างจากการคิดที่ช้าและไตร่ตรอง (System 2)
อย่างไรก็ตาม ชุมชนตัดสินใจใช้คำว่า decision model เพื่ออธิบายบทบาทเชิงคำนวณที่ชัดเจนกว่า (ผลการสำรวจบน twitter เพื่อตัดสินใจชื่อเรียก) โดยมีอินเทอร์เฟซพื้นฐานคือ:
State + Questions + Allowed Answers → Decisions + Probabilitiesทำไมไม่ใช้ LLMs สำหรับทุกอย่าง?
แม้เราจะบังคับให้ LLM ส่งผลลัพธ์เป็น JSON ได้ แต่แนวทางนี้มีข้อเสียหลายประการ เช่น ไม่มีการรับประกันว่าโมเดลจะทำตาม schema ที่สั่งได้ 100%, การใช้เทคนิค Constrained decoding แม้จะช่วยคุมโครงสร้างได้แต่ก็เพิ่มภาระการประมวลผล และที่สำคัญที่สุดคือ เมื่อเราต้องการเพียงการเลือกจากตัวเลือกที่กำหนด การทำ autoregressive decoding หรือการสร้างข้อความทีละโทเคนนั้นถือเป็นขั้นตอนที่เกินความจำเป็น
ความต่างจากโมเดล Classification ทั่วไป
ในระบบ Traditional classification เอาต์พุตถูกฝังอยู่ใน classification head หากต้องการเพิ่มแผนกใหม่ เช่น "Legal" เราจำเป็นต้องรื้อถอนและ retrain โมเดลใหม่ทั้งหมด
ส่วน Zero-shot classification ช่วยแก้ปัญหานี้โดยให้เรากำหนดเลเบลได้ขณะทำ inference แต่ decision models ก้าวไปไกลกว่านั้นด้วยการรองรับคำถามหลากหลายประเภทในอินพุตเดียว ไม่ว่าจะเป็นการเลือก (choice), การให้คะแนน (score) หรือการตัดสินใจใช่/ไม่ใช่ (noul) พร้อมระบบจัดการความน่าจะเป็นที่เป็นมาตรฐาน
| คุณสมบัติ | Classification | Zero-shot classification | Decision model |
|---|---|---|---|
| ความน่าจะเป็นเหนือตัวเลือก | ใช่ | ใช่ | ใช่ |
| เลเบลถูกกำหนดขณะ inference | ไม่ | ใช่ | ใช่ |
| คำถามที่มีประเภทหลากหลาย | ไม่ | ไม่ | ใช่ |
| การให้คะแนนแบบเรียงลำดับ | เฉพาะเจาะจงต่องาน | ต้องปรับเปลี่ยน | มี Primitives พื้นฐาน |
Primitives พื้นฐานของ Decision Model
ในการส่งคำขอไปยังโมเดล จะประกอบด้วย 2 ส่วนคือ State (ข้อมูลที่ให้ประเมิน) และ Questions (สิ่งที่เราอยากรู้) โดยมีรูปแบบคำตอบพื้นฐาน 3 ประเภท:
- Choice: การเลือกหนึ่งจากหลายตัวเลือก โดยโมเดลจะใช้ softmax เพื่อกระจายค่าความน่าจะเป็นให้กับแต่ละตัวเลือก
- Score: การประเมินบนมาตราส่วนที่เรียงลำดับไว้ (เช่น 0-2) โดยผลลัพธ์จะคำนวณจากค่าคาดหมาย (Expected Value) ของความน่าจะเป็นในแต่ละระดับ
- Noul: (มาจาก Bernoulli) เป็นการตอบคำถามแบบไบนารี (ใช่/ไม่ใช่) โดยโมเดลจะส่งคืนค่าพารามิเตอร์ความน่าจะเป็นโดยตรง
นอกจากนี้ยังมีฟิลด์ confidence เพื่อบอกว่าโมเดลมีความมั่นใจในคำตอบนั้นมากน้อยเพียงใดเมื่อเทียบกับตัวเลือกอื่นๆ
Decision models ในระบบนิเวศของ Hugging Face
Hugging Face ตั้งเป้าสร้างอินเทอร์เฟซมาตรฐานเพื่อให้เครื่องมือต่างๆ ทำงานร่วมกันได้ ไม่ว่าจะเป็น:
- Transformers: รองรับคลาส
DecisionPipelineและAutoModelForDecisionแล้ว รวมถึงรองรับ endpoint/v1/systemoneสำหรับการให้บริการ - llama.cpp: รองรับการรัน decision model ผ่าน API รูปแบบเดียวกัน
- Hugging Face Hub: เพิ่มแท็ก
decision-modelเพื่อให้ค้นหาโมเดลที่เข้ากันได้ง่ายขึ้น - การฝึกฝน: สามารถทำ fine-tune ได้ผ่าน
TrainerAPI หรือใช้เครื่องมืออย่าง Unsloth เพื่อเปลี่ยน LLM ทั่วไปให้กลายเป็น decision model
สรุปแล้ว decision models คือการยกระดับให้การตัดสินใจและค่าความน่าจะเป็นกลายเป็นผลลัพธ์หลัก (First-class output) ของซอฟต์แวร์ ช่วยให้การพัฒนาแอปพลิเคชัน AI มีความน่าเชื่อถือ รวดเร็ว และประหยัดทรัพยากรมากขึ้น
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร