
วิธีใช้ Scikit-LLM รวมการแปลภาษาเข้ากับ Scikit-Learn Pipeline
บทนำ
การทำ Text classification ในบางสถานการณ์จำเป็นต้องจัดการกับข้อความดิบที่เขียนมาหลากหลายภาษา ซึ่งถือเป็นความท้าทายที่ต้องปรับข้อมูลขาเข้าทั้งหมดให้เป็นภาษาเดียวกันก่อนส่งไปยังโมเดลปลายทาง
โชคดีที่ Scikit-LLM ไม่เพียงแต่ช่วยให้การสร้าง pipeline ด้วย large language models (LLMs) สำหรับงานอย่าง zero-shot and few-shot classification ทำได้ง่ายขึ้นเท่านั้น แต่มันยังมี custom classes ที่ออกแบบมาเพื่อปรับแต่งโมเดลสำหรับงานเฉพาะทาง เช่น การแปลภาษา (translation) อีกด้วย
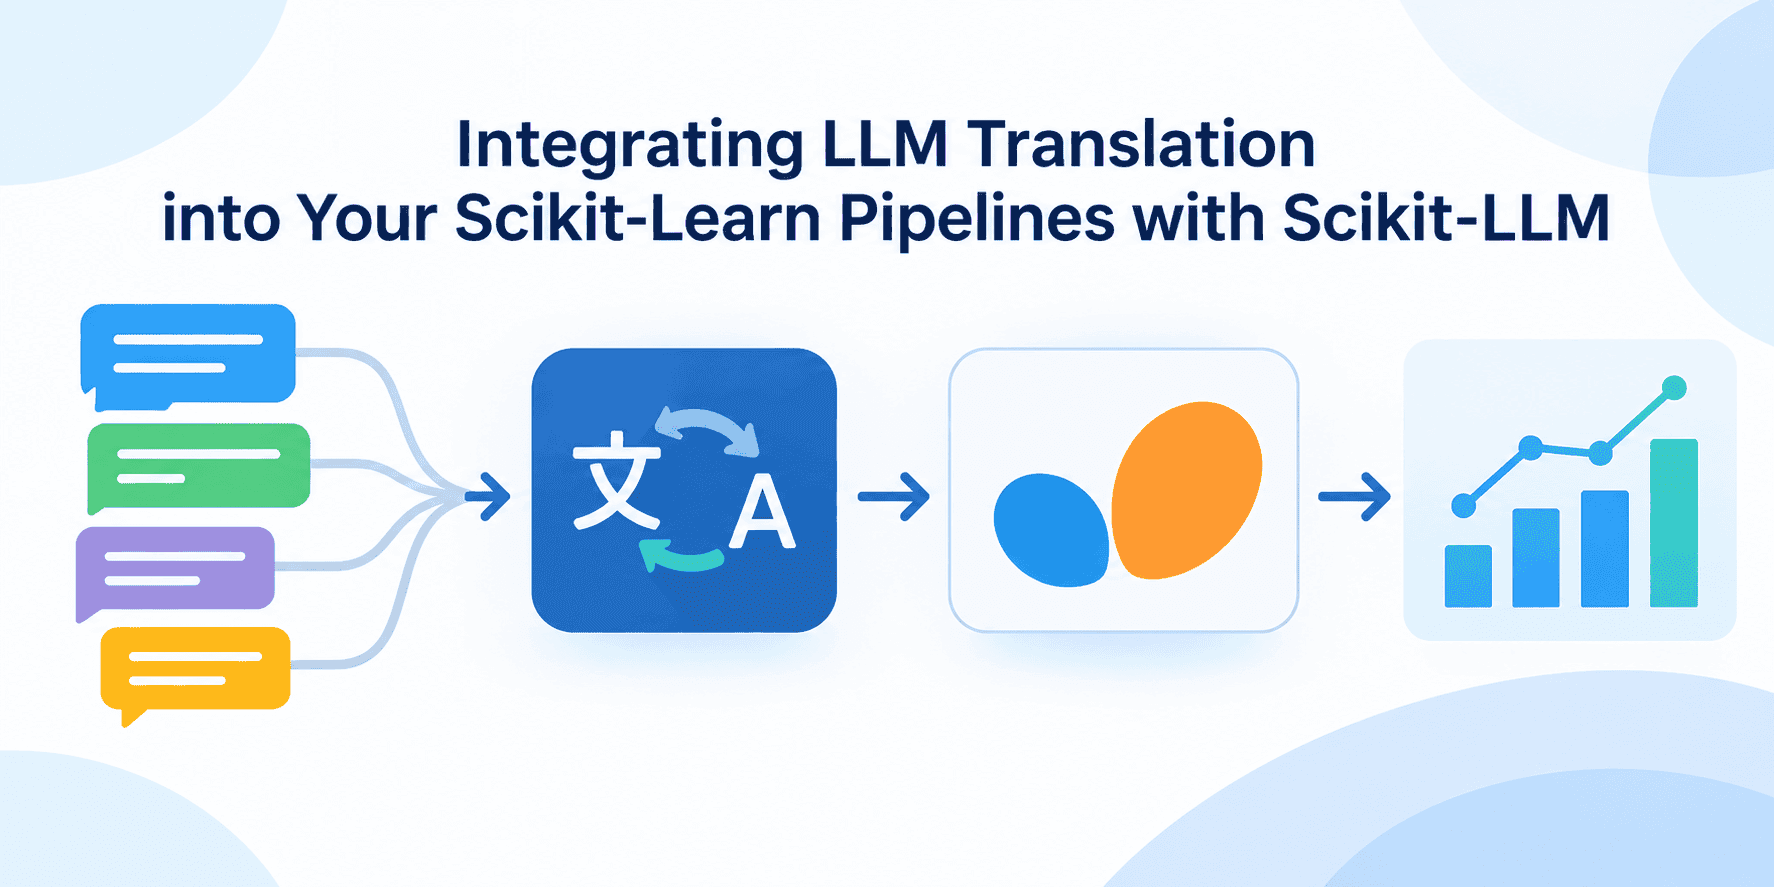
บทความนี้จะแสดงวิธีการสร้าง scikit-learn pipeline สำหรับ multilingual text classification ซึ่งประกอบด้วยสองขั้นตอนหลักคือการแปลภาษาและการจำแนกประเภทแบบ zero-shot โดยทั้งคู่จะถูกจัดการด้วยโมเดลใน Scikit-LLM ซึ่งมีข้อดีดังนี้:
- ใช้การให้เหตุผลเชิงความหมาย (semantic reasoning) จาก LLM แทนที่การจับคู่คำสำคัญแบบเดิม ช่วยให้จำแนกข้อความได้แม่นยำขึ้น
- รวมข้อความขาเข้าให้เป็นภาษาเดียวกัน ทำให้โมเดลปลายทางเพียงตัวเดียวทำงานได้อย่างมีประสิทธิภาพ
- แก้ปัญหาการขาดแคลนข้อมูลเริ่มต้น (cold-start data) โดยใช้เพียงชื่อหมวดหมู่ (class labels) และตัวอย่างเพียงเล็กน้อย ก็สามารถเริ่มใช้งานได้ทันทีโดยไม่ต้องฝึกอบรมโมเดลใหม่
การสร้าง Multilingual Translation และ Zero-Shot Classification Pipeline
คุณสามารถรันตัวอย่างนี้บน Google Colab โดยใช้ API ของ Groq เพื่อใช้งานโมเดลฟรี ขั้นแรกให้ไปที่ เว็บไซต์ Groq เพื่อสร้าง API key แล้วนำไปใส่ในฟีเจอร์ "Secrets" ของ Colab โดยตั้งชื่อตัวแปรว่า GROQ_API_KEY
จากนั้น เริ่มต้นด้วยการติดตั้ง Scikit-LLM ใน notebook ของคุณ:
!pip install scikit-llm -qขั้นตอนต่อมาคือการกำหนดค่าสภาพแวดล้อมเพื่อให้ Scikit-LLM เรียกใช้งานผ่าน API ของ Groq ซึ่งจะช่วยหลีกเลี่ยงค่าใช้จ่ายต่อ token โดยใช้โมเดลประสิทธิภาพสูงที่เปิดให้ใช้ฟรี ดังนี้:
from google.colab import userdata
from skllm.config import SKLLMConfig

# Retrieving API key and route to a free-tier OpenAI-compatible endpoint (e.g. Groq)
groq_key = userdata.get('GROQ_API_KEY')
SKLLMConfig.set_gpt_url("https://api.groq.com/openai/v1")
SKLLMConfig.set_openai_key(groq_key)
ถัดไปคือการกำหนดข้อมูลสำหรับการฝึกอบรม เนื่องจากเราใช้ zero-shot LLM classifier เราจึงไม่จำเป็นต้องมีชุดข้อมูลจำนวนมากหรือต้องแปลงข้อความให้เป็นตัวเลขด้วย vectorizer เพียงแค่กำหนดชื่อหมวดหมู่ที่ต้องการให้โมเดลจดจำ และใส่ตัวอย่างเพียงเล็กน้อยเพื่อให้สอดคล้องกับเมธอด fit() ของ scikit-learn:
# 1. MULTILINGUAL TRAINING DATA
# Adding a few labeled examples in mixed languages and multiple topics
X_multilingual_texts = [
    # Energy
    "La technologie des panneaux solaires a vu son efficacité augmenter de 15%.", # French (Solar)
    "Neue Batteriespeicher für Windenergie werden immer wirtschaftlicher.", # German (Wind/Battery)

# Finance
    "Los mercados financieros sufrieron una fuerte caída hoy tras la subida de tipos.", # Spanish (Markets)
    "Les actions technologiques ont rebondi grâce à de solides rapports sur les bénéfices.", # French (Stocks/Earnings)

# Healthcare
    "Die klinische Studie für das neue Medikament reduzierte die Schwellung um 40%.", # German (Medication/Trial)
    "Un ensayo reciente demostró que la vacuna es muy eficaz para prevenir infecciones.", # Spanish (Vaccine)
]

y_labels = ["Energy", "Energy", "Finance", "Finance", "Healthcare", "Healthcare"]
ส่วนสำคัญที่สุดคือการนิยาม pipeline แบบสองขั้นตอน โดยใช้ GPTTranslator สำหรับการแปลเป็นภาษากลาง และ ZeroShotGPTClassifier สำหรับการจำแนกประเภท ทั้งสองขั้นตอนสามารถเลือกใช้โมเดลเดียวกันจาก Groq เช่น "custom_url::llama-3.1-8b-instant" เพื่อทำงานร่วมกันในระบบเดียว
from sklearn.pipeline import Pipeline
from skllm.models.gpt.text2text.translation import GPTTranslator
from skllm.models.gpt.classification.zero_shot import ZeroShotGPTClassifier

# 2. THE TRANSLATION AND ZERO-SHOT CLASSIFICATION PIPELINE
# A scikit-learn-based pipeline that contains two Scikit-LLM-wrapped models
text_pipeline = Pipeline([
    ('translator', GPTTranslator(
        model="custom_url::openai/gpt-oss-20b",
        output_language="English"
    )),
    ('classifier', ZeroShotGPTClassifier(
        model="custom_url::openai/gpt-oss-20b"
    ))
])

# 3. FITTING THE CLASSIFIER
y_labels_unique = ["Energy", "Finance", "Healthcare"]
X_placeholder = [""] * len(y_labels_unique)

text_pipeline.fit(X_placeholder, y_labels_unique)
ก่อนจะนำไปใช้งานจริง เราสามารถตรวจสอบความถูกต้องของการแปลภาษาที่เกิดขึ้นใน pipeline ได้ผ่านคำสั่ง transform เพื่อให้มั่นใจว่าข้อมูลที่ถูกส่งไปยังโมเดลจำแนกประเภทนั้นมีความหมายที่ถูกต้องตรงตามต้นฉบับ
# Accessing the 'translator' step to transform the training data
train_translations = text_pipeline.named_steps['translator'].transform(X_multilingual_texts)

print("--- TRAINING DATA TRANSLATIONS ---")
for label, original, translated in zip(y_labels, X_multilingual_texts, train_translations):
    print(f"[{label.upper()}]\nOriginal: {original}\nTranslated: {translated}\n")
เมื่อผลการแปลออกมาน่าพอใจ เราก็สามารถส่งข้อมูลชุดใหม่ที่มีความหลากหลายทางภาษาเข้าไปใน pipeline เพื่อให้ระบบทำการแปลและจำแนกประเภทโดยอัตโนมัติ ซึ่งจะเห็นได้ว่าโมเดลสามารถระบุหมวดหมู่ได้อย่างแม่นยำแม้ข้อความต้นฉบับจะเป็นภาษาอิตาลีหรือโปรตุเกสก็ตาม
# 4. PREDICTING ON UNSEEN DATA
X_new_multilingual = [
    "Un nuovo vaccino antinfluenzale ha mostrato un'efficacia dell'85% negli studi clinici, promettendo difese immunitarie più forti.", # Italian (Healthcare)
    "I ricercatori hanno sviluppato una batteria agli ioni di sodio che immagazzina l'energia eolica in eccesso in modo molto economico.", # Italian (Energy)
    "As ações de tecnologia se recuperaram no final do pregão, impulsionadas por fortes relatórios de lucros corporativos." # Portuguese (Finance)
]

predictions = text_pipeline.predict(X_new_multilingual)
new_translations = text_pipeline.named_steps['translator'].transform(X_new_multilingual)
สรุป
การใช้งาน Scikit-LLM ช่วยให้เราสามารถผสานพลังของ LLM เข้ากับโครงสร้างของ scikit-learn pipeline ได้อย่างลงตัว ทำให้การจัดการกับข้อมูลหลายภาษาไม่ใช่เรื่องยากอีกต่อไป อีกทั้งยังเป็นวิธีที่รวดเร็ว ประหยัดทรัพยากร และมีประสิทธิภาพสูงสำหรับงานจำแนกประเภทข้อความในปัจจุบัน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร