
ProvenanceGuard ระบบตรวจสอบแหล่งที่มาข้อมูลสำหรับ MCP Agent
ปัจจุบัน AI Agent ที่ขับเคลื่อนด้วยโมเดลภาษาขนาดใหญ่ (LLM) และทำงานผ่านเครื่องมือต่างๆ ไม่ได้อ่านข้อมูลจากข้อความเพียงแหล่งเดียวอีกต่อไป แต่สามารถดึงข้อมูลผ่านโปรโตคอล Model Context Protocol (MCP) เพื่อเรียกใช้เครื่องมือค้นหา ตรวจสอบประวัติผู้ป่วย สอบถามฐานข้อมูล และนำข้อมูลทั้งหมดมารวมกันเพื่อสร้างคำตอบเดียว
การรวบรวมข้อมูลจากหลายแหล่งนี้ ทำให้การตรวจสอบความถูกต้องของข้อเท็จจริงมีความซับซ้อนขึ้นมาก ระบบตรวจสอบส่วนใหญ่ในปัจจุบัน ตั้งแต่ RAGAS faithfulness ไปจนถึง MiniCheck, AlignScore และ SummaC มักตรวจสอบแค่ว่าข้ออ้างนั้นมีหลักฐานรองรับหรือไม่หลังจากรวมข้อมูลแล้ว ซึ่งระบบทั่วไปเหล่านี้จะไม่สามารถระบุได้ว่าเครื่องมือ MCP ใดที่เป็นแหล่งที่มาของข้ออ้างนั้นๆ หรือตรงกับแหล่งที่มาที่ระบุไว้ในคำตอบหรือไม่
งานวิจัยล่าสุดของเรา ProvenanceGuard: Source-Aware Factuality Verification for MCP-Based LLM Agents (สามารถอ่านได้บน Hugging Face หรือ arXiv) จึงถูกพัฒนาขึ้นเพื่อปิดช่องว่างดังกล่าว โดยเรามุ่งเน้นไปที่การแก้ปัญหา "การปะปนข้อมูลข้ามแหล่ง" (cross-source conflation) ซึ่งเป็นกรณีที่ข้ออ้างนั้นเป็นความจริงในชุดข้อมูล แต่ระบบกลับอ้างอิงไปยังแหล่งข้อมูลที่ผิด ทำให้ตัวตรวจสอบทั่วไปที่ไม่คำนึงถึงแหล่งที่มาปล่อยผ่านไปได้ แต่ระบบที่ตรวจสอบแหล่งที่มาอย่าง ProvenanceGuard จะตรวจพบข้อผิดพลาดนี้
ปัญหา: ข้อเท็จจริงถูกต้อง แต่มาจากแหล่งข้อมูลที่ผิด
ตัวอย่างเช่น เอเจนต์สนับสนุนลูกค้าที่ตอบว่า "ตามบันทึกบัญชี แผนนี้รวมหน้าต่างการคืนเงินภายใน 30 วัน" แม้เงื่อนไขนี้จะเป็นจริงแต่ถูกระบุไว้ในเอกสารนโยบายไม่ใช่บันทึกบัญชีที่คำตอบอ้างถึง การอ้างอิงแหล่งที่มาเช่นนี้ถือว่าผิดพลาด ซึ่งในสภาพแวดล้อมที่อ่อนไหวต่อข้อมูล ความเสียหายจากการอ้างอิงแหล่งข้อมูลผิดอาจร้ายแรงพอๆ กับการกุข้อเท็จจริงขึ้นมาเอง เช่นเดียวกับในเอเจนต์ทางการแพทย์ที่ข้อมูลการจ่ายยาของผู้ป่วยจากเครื่องมือประวัติอาจถูกเข้าใจผิดว่าเป็นข้อค้นพบจากเอกสารวิชาการ
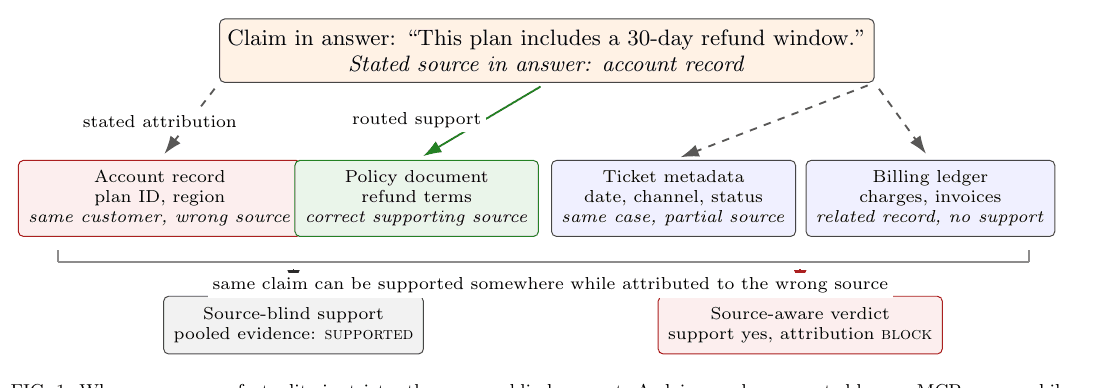
ข้ออ้างอาจมีแหล่งข้อมูล MCP รองรับ แต่ตัวคำตอบกลับอ้างอิงไปอีกแหล่งหนึ่ง การประเมินแบบทั่วไปจะมองเห็นข้อมูลในภาพรวมแล้วปล่อยให้ผ่าน แต่ ProvenanceGuard จะตรวจสอบแยกกันว่าแหล่งข้อมูลที่รองรับนั้นตรงกับที่ระบุในคำตอบจริงหรือไม่ แหล่งที่มา: รูปที่ 1 ในงานวิจัย
ด้วยเหตุนี้ คะแนนความซื่อสัตย์ต่อข้อมูล (faithfulness scores) เพียงอย่างเดียวจึงไม่เพียงพอสำหรับเอเจนต์ MCP เนื่องจากคำตอบมักมีการระบุที่มา (provenance) ทั้งแบบชัดเจนและโดยนัย ซึ่ง ProvenanceGuard จะช่วยรักษาความเชื่อมโยงระหว่างข้ออ้างและแหล่งข้อมูลนี้ไว้เพื่อตรวจสอบ
สิ่งที่ ProvenanceGuard ทำ
ProvenanceGuard ทำหน้าที่เป็นชั้นตรวจสอบหลังการสร้างคำตอบ (post-generation verification layer) บนเอเจนต์ MCP แบบกล่องดำ (black-box) โดยจะทำงานหลังจากเอเจนต์สร้างคำตอบเสร็จสิ้น และรักษาอัตลักษณ์ของแหล่งข้อมูล (source identity) ไว้ตลอดกระบวนการแทนที่จะยุบรวมข้อมูลเข้าด้วยกัน ระบบจะอ่านร่องรอยการทำงาน (trace) ของ MCP ที่บันทึกไว้ ทั้งผลลัพธ์เครื่องมือและ ID แหล่งที่มา โดยไม่ต้องฝึกฝนเอเจนต์ใหม่
จากนั้นระบบจะทำงาน 5 ขั้นตอนตามลำดับ ได้แก่ แยกคำตอบออกเป็นข้ออ้างย่อย, ค้นหาแหล่งที่มาที่เกี่ยวข้องที่สุด, ตรวจสอบการรองรับของข้อมูล, เปรียบเทียบแหล่งที่มากับที่ระบุในคำตอบ และแสดงผลการตัดสินใจว่าจะอนุญาตหรือบล็อกคำตอบนั้นในระดับสากล
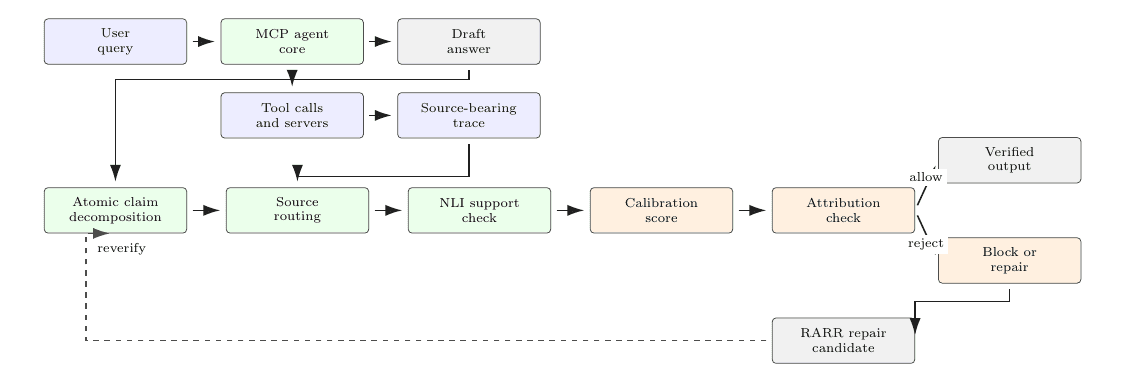
ขั้นตอนการตรวจสอบที่รักษาอัตลักษณ์ของแหล่งข้อมูลผ่านการแยกย่อย การกำหนดเส้นทาง การให้คะแนน การตรวจสอบการอ้างอิง และการแก้ไข โดยคำตอบที่ถูกบล็อกจะถูกส่งไปแก้ไขในรูปแบบ RARR และตรวจสอบซ้ำได้ แหล่งที่มา: รูปที่ 2 ในงานวิจัย
ในการทดลองของงานวิจัย เราเลือกใช้โมเดลแบบประมวลผลภายในเครื่อง (local model) เพื่อให้สามารถตรวจสอบข้อมูลออฟไลน์ได้อย่างปลอดภัย ได้แก่ MiniLM สำหรับค้นหาแหล่งข้อมูล, DeBERTa NLI verifier model สำหรับตรวจสอบการรองรับ และใช้โมเดลภาษาท้องถิ่นแยกข้ออ้าง
นอกจากนี้ยังมีการตรวจสอบตัวเลข วันที่ และรหัสอย่างเข้มงวดเพื่อป้องกันไม่ให้ข้อความที่ฟังดูน่าเชื่อถือแต่ไม่มีข้อมูลจริงผ่านไปได้ หากคำตอบถูกบล็อก ระบบจะใช้กระบวนการแก้ไขรูปแบบ RARR หรือใช้คำตอบสำรองที่ปลอดภัย (safe fallback) ก่อนจะตรวจสอบใหม่อีกครั้ง
ทั้งนี้ โมเดลต่างๆ ที่กล่าวมาเป็นเพียงระบบที่เราใช้ประเมิน ไม่ใช่ข้อกำหนดบังคับของ ProvenanceGuard เพราะผู้ใช้งานสามารถปรับเปลี่ยนไปใช้โมเดลบนคลาวด์ได้ตามต้องการ แต่อาจต้องทดสอบและปรับเทียบระบบใหม่ ผลลัพธ์ของเรามาจากโครงสร้างแบบท้องถิ่น ซึ่งเน้นนโยบายการตัดสินใจแบบระมัดระวัง เหมาะสำหรับงานที่อ่อนไหวต่อข้อมูลและให้ความสำคัญกับความถูกต้องของแหล่งที่มามากกว่าความเร็วในการตอบสนอง
ผลลัพธ์การทดสอบ
เราได้ทดสอบ ProvenanceGuard กับเอเจนต์ทางการแพทย์ที่ใช้บันทึกผู้ป่วยและบทความวิจัยรวม 281 รายการ เนื่องจากข้อมูลผู้ป่วยและงานวิจัยทั่วไปไม่สามารถปะปนกันได้ สำหรับการทดสอบหลัก ผู้เชี่ยวชาญได้ตรวจสอบข้ออ้าง 361 ข้อจาก 40 คำตอบที่แยกไว้
ผลการทดสอบพบว่า จาก 139 ข้ออ้างที่ผู้เชี่ยวชาญเห็นว่าไม่ควรผ่าน ProvenanceGuard สามารถตรวจจับได้ถึง 138 ข้ออ้าง และหลุดไปเพียงข้อเดียว นอกจากนี้ยังกักข้ออ้างอีก 67 ข้อที่ได้รับการสนับสนุนเพื่อส่งไปตรวจสอบซ้ำ ซึ่งสะท้อนถึงการตั้งค่าที่เน้นความปลอดภัยเป็นหลัก ยิ่งไปกว่านั้น ระบบยังสามารถเลือกแหล่งข้อมูลที่ถูกต้องได้แม่นยำถึง 86%
เมื่อเปรียบเทียบกับตัวตรวจสอบอื่นอีก 4 ตัว ProvenanceGuard ได้คะแนนสูงสุดในการตรวจจับข้ออ้างที่ควรถูกบล็อก และยังเหนือกว่าตรงที่สามารถบันทึกความเชื่อมโยงระหว่างข้ออ้างกับเครื่องมือที่เป็นแหล่งที่มาได้ ทำให้ผู้ตรวจสามารถตรวจสอบย้อนกลับได้ง่าย
| Verifier | Reject/block F1 | Emits claim-to-source ID |
|---|---|---|
| ProvenanceGuard (ours) | 0.802 | Yes |
| MiniCheck | 0.783 | No |
| RAGAS Faithfulness | 0.758 | No |
| AlignScore | 0.662 | No |
| SummaC-ZS | 0.436 | No |
ตัวชี้วัดการสนับสนุนแบบไบนารีบนแพ็กเก็ตข้ออ้างชุดเดียวกันที่แยกไว้ ProvenanceGuard มีคะแนนเท่ากับหรือชนะ baseline แบบไม่ตระหนักถึงแหล่งที่มาในการบล็อก ในขณะเดียวกันก็สร้างคำตัดสินแหล่งที่มาต่อข้ออ้างด้วย แหล่งที่มา: บทคัดย่อของงานวิจัยและตารางที่ III
การตรวจสอบข้ออ้างเมื่อแหล่งที่มาดูคล้ายกัน
ในการทดสอบที่ยากขึ้นกับแหล่งข้อมูลที่คล้ายกัน ProvenanceGuard ได้คะแนน F1 ที่ 0.846 ในการตัดสินใจบล็อกข้ออ้าง แต่ระบุแหล่งที่มาแม่นยำ 50.3% ซึ่งชี้ว่าการแยกแยะแหล่งข้อมูลที่ใกล้เคียงกันยังคงเป็นจุดที่ต้องพัฒนาต่อ นอกจากนี้ ในการทดสอบควบคุมการแกล้งเปลี่ยนชื่อแหล่งข้อมูล 50 กรณี ระบบสามารถตรวจจับการสลับแหล่งข้อมูลได้ครบทั้ง 50 กรณี
การแก้ไขคำตอบที่ถูกบล็อก
เมื่อเชื่อมต่อกับลูปการแก้ไขของ RARR ระบบสามารถแก้ไขคำตอบที่ถูกบล็อกได้ทั้งหมด 173 คำตอบ โดย 144 คำตอบจบลงด้วยข้อความสำรอง (fallback text) เพื่อหลีกเลี่ยงการกุข้อมูลขึ้นมาใหม่ สำหรับกรณีทดสอบแบบหลายแหล่งข้อมูล ระบบแก้ไขคำตอบได้ทั้งหมด 59 คำตอบ และมีข้อความสำรองเพียง 2 รายการเท่านั้น โดยมีค่าใช้จ่ายส่วนเกิน (overhead) ด้านเวลาต่ำมาก เพียงประมาณครึ่งวินาทีต่อคำตอบบนระบบท้องถิ่น
ทำไมสิ่งนี้จึงเหมาะกับ Multiverse Computing
เมื่อเอเจนต์เปลี่ยนผ่านจากระบบ RAG แบบข้อความเดี่ยวไปสู่ระบบ MCP แบบหลายเครื่องมือ ความถูกต้องของแหล่งที่มาจึงกลายเป็นสิ่งสำคัญ ProvenanceGuard ช่วยให้เห็นความเชื่อมโยงนี้อย่างชัดเจนในระดับรายข้ออ้าง สำหรับ Multiverse Computing นี่คือวิธีตรวจสอบเอเจนต์โดยยังคงรักษาความปลอดภัยของข้อมูลไว้ได้ในสภาพแวดล้อมที่ควบคุม
ปัจจุบันแนวคิดนี้ได้รับการนำไปใช้แล้วใน NVIDIA NVFlow สำหรับเอเจนต์ทางการเงิน เพื่อตรวจสอบคำตอบกับข้อมูลจาก SEC โดยไม่มีการเปลี่ยนข้อมูลเดิม นอกจากนี้ ProvenanceGuard ยังได้รับเลือกให้ นำเสนอเป็นโปสเตอร์ที่งาน Agentic AI Summit 2026 ที่ UC Berkeley อีกด้วย
สำหรับผู้ที่ต้องการรายละเอียดทางเทคนิคฉบับเต็ม สามารถอ่านงานวิจัยฉบับเต็มได้บน Hugging Face หรือติดต่อทีมงานของเราเพื่อหารือเกี่ยวกับการนำระบบไปใช้งาน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร