
Google เปิดซอร์ส RRSI เฟรมเวิร์กอัปเกรดเอเย่นต์ AI โดยไม่ Overfitting
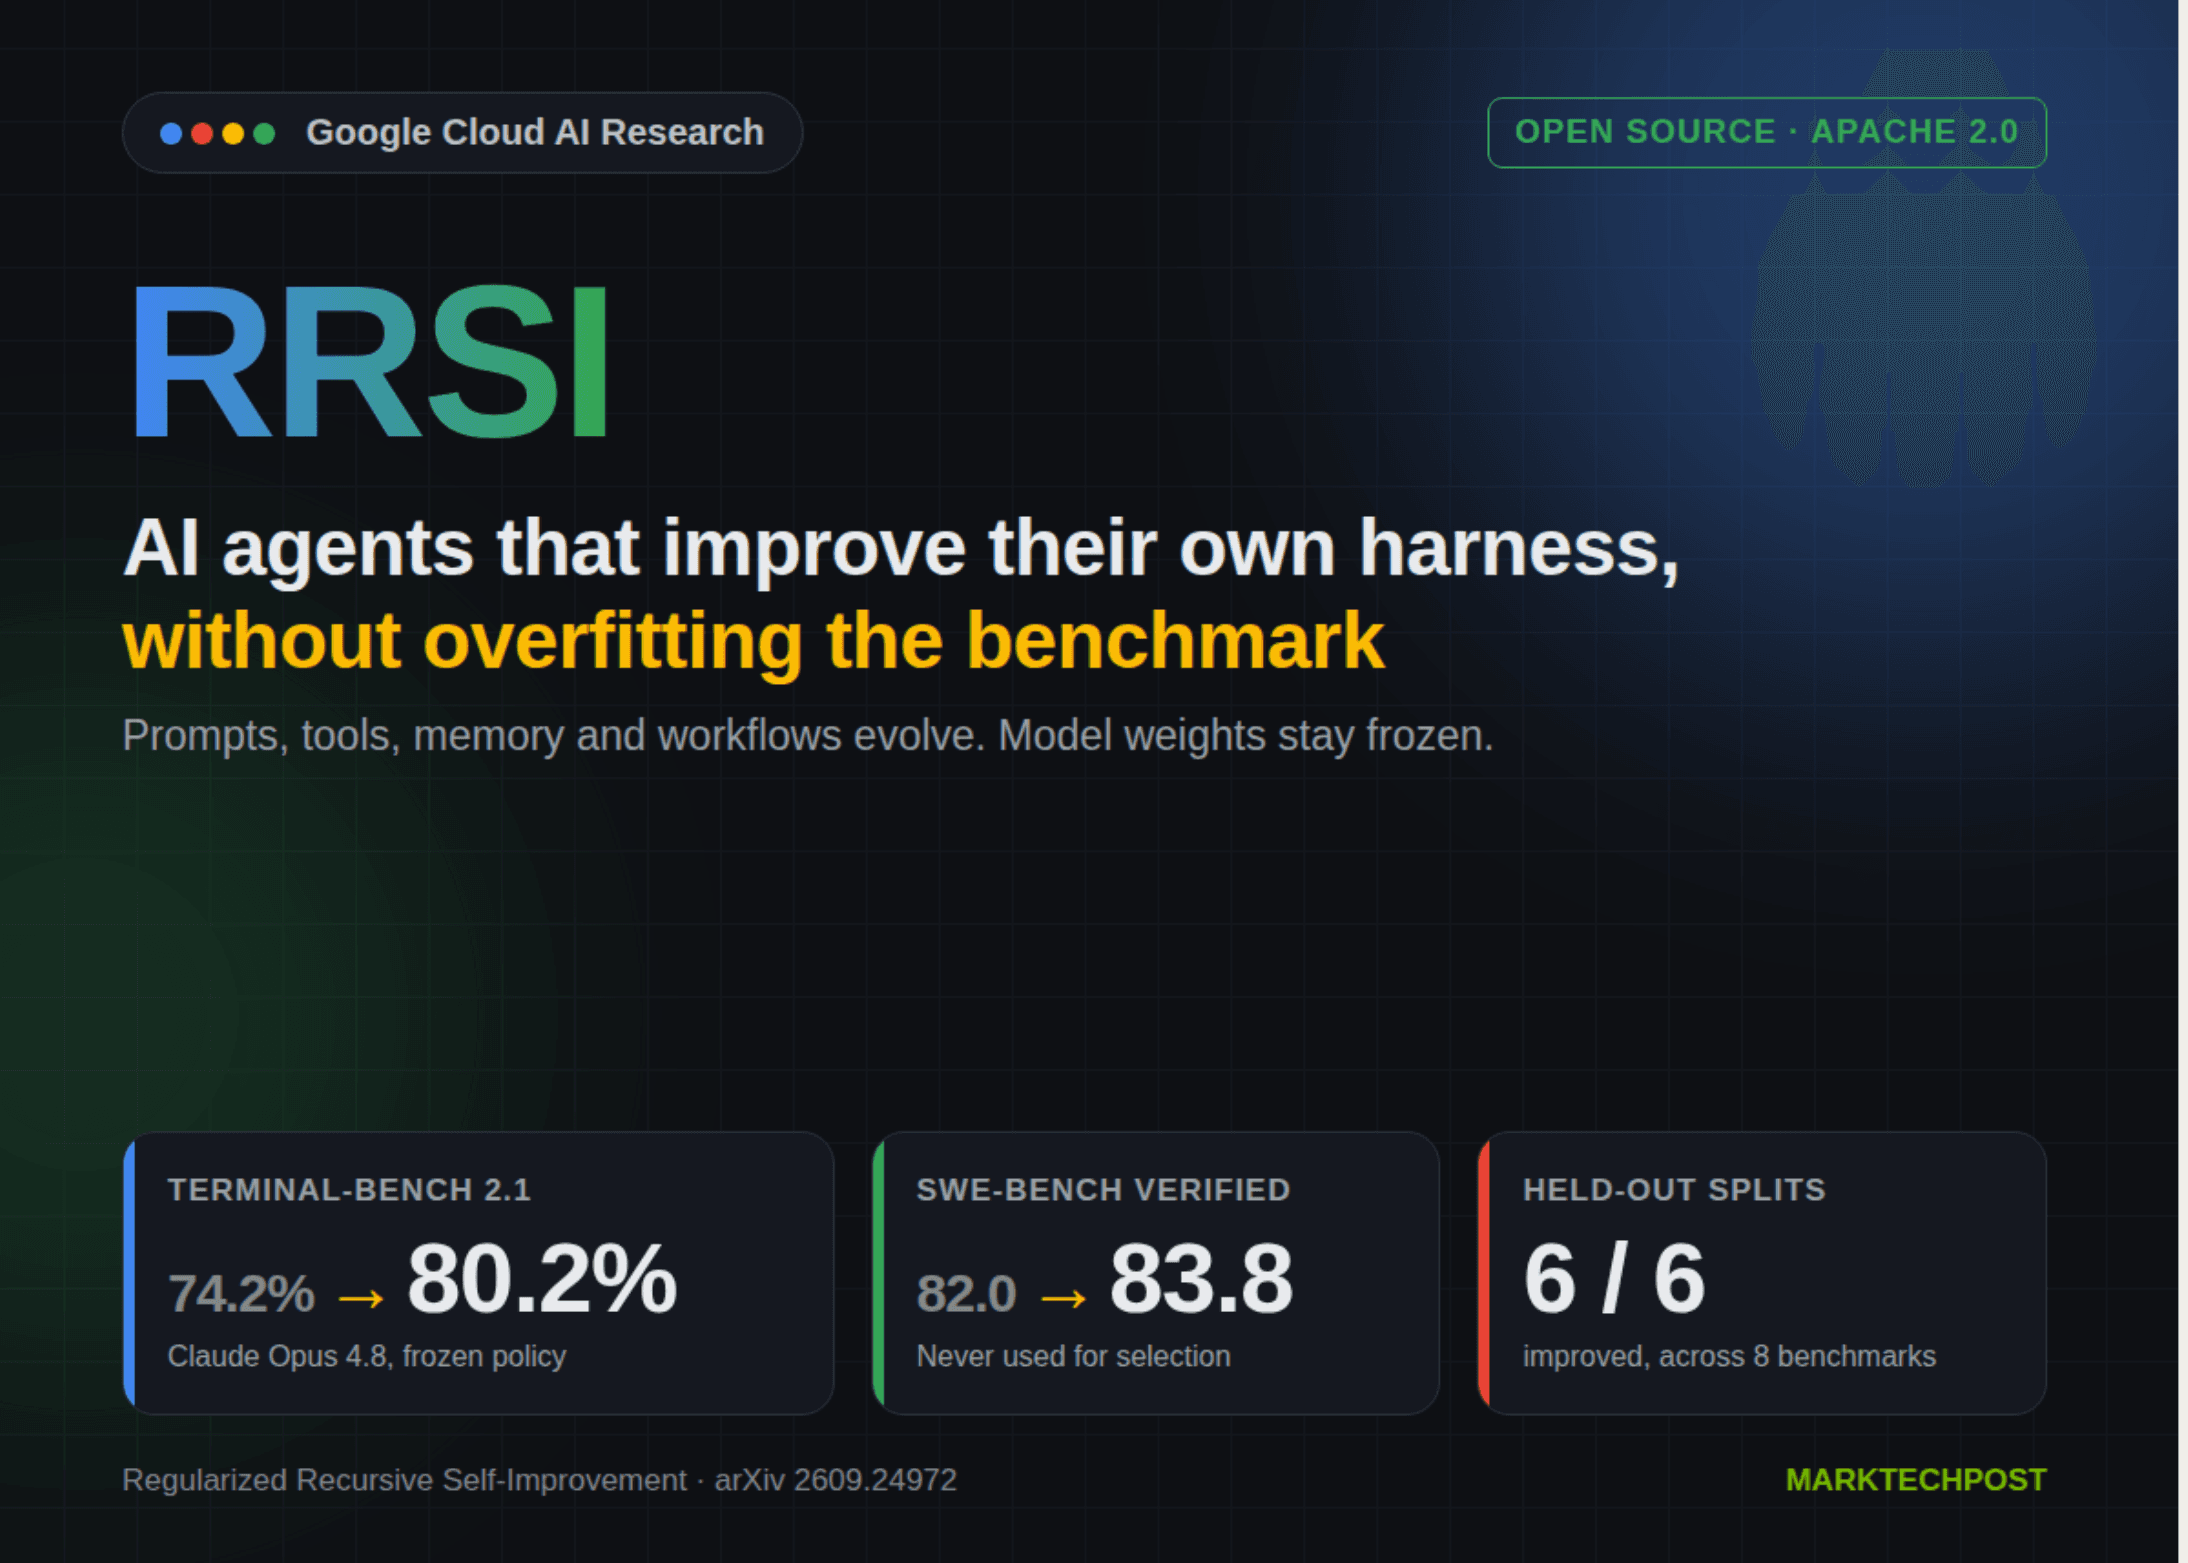
Google Cloud AI Research ร่วมมือกับมหาวิทยาลัยชั้นนำอย่าง UNC-Chapel Hill, Stanford และ Washington University ใน St. Louis เปิดตัว RRSI (Regularized Recursive Self-Improvement) เฟรมเวิร์กที่ช่วยให้เอเย่นต์ LLM สามารถเขียนระบบสนับสนุน (harness) ของตนเองขึ้นใหม่ได้
ความโดดเด่นของ RRSI คือการอนุญาตให้ AI ปรับปรุงทั้ง prompts, เครื่องมือ, หน่วยความจำ, ลำดับการควบคุม (control flow) และเอเย่นต์ย่อยได้โดยตรง โดยที่ Model weights ไม่มีการเปลี่ยนแปลงใดๆ ซึ่ง RRSI จะคอยควบคุมลูปการพัฒนาตัวเอง เพื่อให้ประสิทธิภาพที่เพิ่มขึ้นนั้นสามารถใช้งานได้จริงกับทุกเกณฑ์มาตรฐาน (benchmarks) ไม่ใช่แค่การจดจำข้อสอบ
ปัจจุบันโครงการนี้เปิดให้ใช้งานในรูปแบบเฟรมเวิร์กเพื่องานวิจัยภายใต้สัญญาอนุญาต ซอร์สโค้ดเป็น Apache 2.0 รองรับ Python 3.10+ และใช้งานร่วมกับ model string ของ LiteLLM ได้ทุกรุ่น โดยค่าเริ่มต้นถูกตั้งค่าไว้ที่ Claude Opus 4.8 บน Vertex AI
ทำไมการปรับปรุงระบบสนับสนุนด้วยตนเองถึงเกิด Overfitting โดยปกติแล้ว ลูปการวิวัฒนาการของระบบสนับสนุนจะทำการแก้ไขและให้คะแนนบนชุดข้อมูล (evolve set) ที่ตายตัว ทำให้เกิดการใช้งานซ้ำจนระบบจดจำคำตอบได้ งานวิจัย RRSI ระบุปัญหาหลักไว้ 3 ด้าน คือ การปรับแต่งเฉพาะเจาะจงกับเกณฑ์มาตรฐาน (benchmark-specific fitting), การไล่ตามเสียงรบกวน (noise chasing) และการสะสมความซับซ้อนเกินความจำเป็น (complexity accumulation)
RRSI ทำงานอย่างไร
RRSI แก้ไขปัญหาข้างต้นด้วยการควบคุม (regularize) ทิศทางการค้นหาและปรับปรุงระบบในทุกส่วนประกอบ ดังนี้
ฝั่งการเสนอ (Proposal side)
- งบประมาณการแก้ไขแบบ Annealed: ใช้ตารางเวลาแบบ cosine เพื่ออนุญาตให้แก้ไขหลายจุดพร้อมกันได้ในรอบแรกๆ ก่อนจะจำกัดให้เหลือการเปลี่ยนเพียงจุดเดียวในรอบหลัง เพื่อให้ระบุสาเหตุของประสิทธิภาพที่เปลี่ยนไปได้อย่างชัดเจน
- เครดิตที่ตระหนักถึงหลักฐาน (Evidence-aware credit): มีการบันทึกประวัติการแก้ไข ทั้งสมมติฐาน ผลต่าง (diff) และต้นทุนที่เปลี่ยนไป เพื่อป้องกันไม่ให้ระบบลองใช้วิธีที่พิสูจน์แล้วว่าไม่ได้ผลซ้ำอีก
- การสำรวจที่มีโครงสร้าง (Structured exploration): หากความก้าวหน้าหยุดชะงัก งบประมาณจะถูกโยกไปใช้กับส่วนประกอบที่ยังไม่เคยถูกปรับปรุง
ฝั่งการเลือก (Selection side)
- ตัวตรวจสอบการรั่วไหล (Leakage critic): ทำหน้าที่ปฏิเสธชื่อของงานหรือคำตอบเฉพาะของเกณฑ์มาตรฐานก่อนเริ่มให้คะแนน เพื่อป้องกันการจดจำข้อสอบ
- ระดับพื้นฐานที่ปรับตามเสียงรบกวน (Noise-adjusted floor): กำหนดให้ประสิทธิภาพที่เพิ่มขึ้นต้องสูงกว่าค่าความแปรปรวนปกติของระบบเดิม
- กฎด้านต้นทุน (Cost rule): การใช้โทเค็น (inference tokens) ที่เพิ่มขึ้นต้องแลกมาด้วยประสิทธิภาพที่วัดได้ว่าดีขึ้นจริงอย่างคุ้มค่า
- การตัดส่วนเกิน (Pruning): ส่วนประกอบใดที่หยุดสร้างผลลัพธ์เชิงบวกจะถูกคัดออกทันที
ทีมวิจัยเปรียบเทียบกลไกเหล่านี้กับตัวควบคุมทางสถิติคลาสสิก โดยงบประมาณการแก้ไขเทียบได้กับ L0, การตัดส่วนเกินเทียบได้กับ Lasso (L1) และกฎด้านต้นทุนเทียบได้กับ Ridge (L2)
ผลลัพธ์จาก 8 เกณฑ์มาตรฐาน
จากการทดสอบพบว่า Terminal-Bench 2.1 (ชุด evolve) มีประสิทธิภาพเพิ่มจาก 74.2% เป็น 80.2% ส่วน SWE-bench Verified ซึ่งเป็นชุดที่ไม่เคยถูกใช้ในการเลือกมาก่อน เพิ่มขึ้นจาก 82.0% เป็น 83.8%
นอกจากนี้ในชุดข้อมูลภายนอก (Out of distribution) ระบบยังมีคะแนนดีขึ้นอย่างชัดเจน เช่น JobBench +4.7 คะแนน และ APEX-Agents +3.7 คะแนน ในขณะที่การใช้ Gemini 3.5 Flash พบว่าคะแนน Terminal-Bench 2.1 พุ่งจาก 64.6 เป็น 78.7
ในด้านประสิทธิภาพการใช้ทรัพยากร RRSI ช่วยลดการใช้โทเค็นลงได้ 30-36% เมื่อเทียบกับกระบวนการวิวัฒนาการแบบที่ไม่มีการควบคุม ซึ่งช่วยให้ระบบมีน้ำหนักเบาและประหยัดค่าใช้จ่ายมากขึ้น
RRSI เปรียบเทียบกับคู่แข่งที่ใกล้เคียงที่สุด
ข้อมูลจากตารางที่ 1 ในเอกสารวิจัย แสดงการเปรียบเทียบโดยใช้นโยบายและงบประมาณที่เท่ากันทุกวิธี
| คุณสมบัติ | RRSI | Meta-Harness | AHE | TTHE | HarnessX |
|---|---|---|---|---|---|
| แนวคิดหลัก | การเสนอและการเลือกแบบควบคุม (Regularized) | ผู้เสนอแบบเอเย่นต์เหนือโค้ดและร่องรอยการประเมิน | ลูปที่ขับเคลื่อนด้วยการทำนายที่ตรวจสอบแล้ว | พัฒนาระหว่างเวลาทดสอบโดยไม่มีป้ายกำกับทอง | โครงสร้างโมดูลาร์และการปรับตัวตามร่องรอย |
| Model weights | คงที่ (Frozen) | คงที่ | คงที่ | คงที่ | คงที่ |
| กฎด้านต้นทุนและการตัดส่วนเกิน | มี | ไม่มี* | ไม่มี* | ไม่มี* | ไม่มี* |
| คะแนน evolve ของ Harvey LAB | 90.5 | 93.0 | 90.7 | 91.1 | 91.8 |
| ค่าเฉลี่ย OOD (H0 = 39.7) | 43.6 | 40.6 | 39.2 | 38.0 | 39.7 |
RRSI เป็นเพียงวิธีเดียวที่มีค่าเฉลี่ย OOD สูงกว่าเกณฑ์มาตรฐาน H0 อย่างมีนัยสำคัญ แม้คะแนนในชุด evolve จะไม่ได้สูงที่สุดก็ตาม
คำอธิบายเชิงโต้ตอบ
RRSI ควบคุมการปรับปรุงตัวเองของเอเย่นต์อย่างไร
Proposer จะอ่านบันทึกการแก้ไขทั้งหมดและคอยคุมงบประมาณ
Leakage critic ทำหน้าที่กรองส่วนต่าง (diff) ก่อนส่งไปให้คะแนน
Evaluate จะทำการรันบนชุดข้อมูลวิวัฒนาการ (evolve set)
Gate ตรวจสอบผ่านเกณฑ์ Noise floor และกฎด้านต้นทุน
Harness H เมื่อระบบได้รับการยอมรับ จะเข้าสู่ขั้นตอนการตัดส่วนเกิน (pruning) เพื่อความเรียบง่าย
สูตรการคำนวณงบประมาณ: t+1t= ⌈ bmin+ (bmax− bmin) · ½(1 + cos(πt / T)) ⌉ โดยใน RRSI ค่าความแปรปรวน (δ) จะถูกประมาณการจากระบบฐานเดิม ส่วนค่าถ่วงน้ำหนักต้นทุน (β) จะถูกปรับจูนให้เหมาะสมก่อนคงค่าไว้
เอกสาร RRSI · GitHub · หน้าโครงการ
เริ่มต้นการใช้งาน
git clone https://github.com/google-research/rrsi.git && cd rrsi
piv install -e ".[dev]"
python3 rrsi.py --domain coding baseline
python3 rrsi.py --domain coding run
ในการทำงานแต่ละรอบ ระบบจะร่างผู้สมัคร 2 รายใน git worktrees แยกกัน จากนั้นจะประเมินและเลือกผู้ชนะเพื่อทำการ fast-forward สาขาโค้ดต่อไป สำหรับโดเมนการเขียนโค้ดจำเป็นต้องมี Docker และ harbor ติดตั้งไว้ด้วย
สรุปประเด็นสำคัญ
- RRSI ปรับปรุงองค์ประกอบรอบตัวโมเดล (Harness) โดยไม่ต้องแก้ไขน้ำหนักของ LLM
- ใช้ระบบควบคุม 4 ชั้น: ตัวตรวจสอบการรั่วไหล, ระดับเสียงรบกวนพื้นฐาน, กฎด้านต้นทุน และการตัดส่วนเกิน
- ประสิทธิภาพในงานโค้ดดิ้ง (Terminal-Bench 2.1) เพิ่มขึ้นเป็น 80.2% ด้วยโมเดล Claude Opus 4.8
- เป็นโครงการโอเพนซอร์สในระดับงานวิจัยของ Google ไม่ใช่ผลิตภัณฑ์ทางการค้าเต็มรูปแบบ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร