
GPT-6 Astra โชว์เหนือ! บริหารธุรกิจทำกำไร 3 เท่า พร้อมคุมโดรนสอดแนมผ่านเกณฑ์มนุษย์ครั้งแรก
ประเด็นสำคัญ
- Andon Labs ทำการทดสอบ GPT-6 Astra ในเกณฑ์มาตรฐานเอเจนต์ 2 รายการ ซึ่งผลปรากฏว่าทำคะแนนได้ดีกว่า Claude Fable 5.1 อย่างมาก
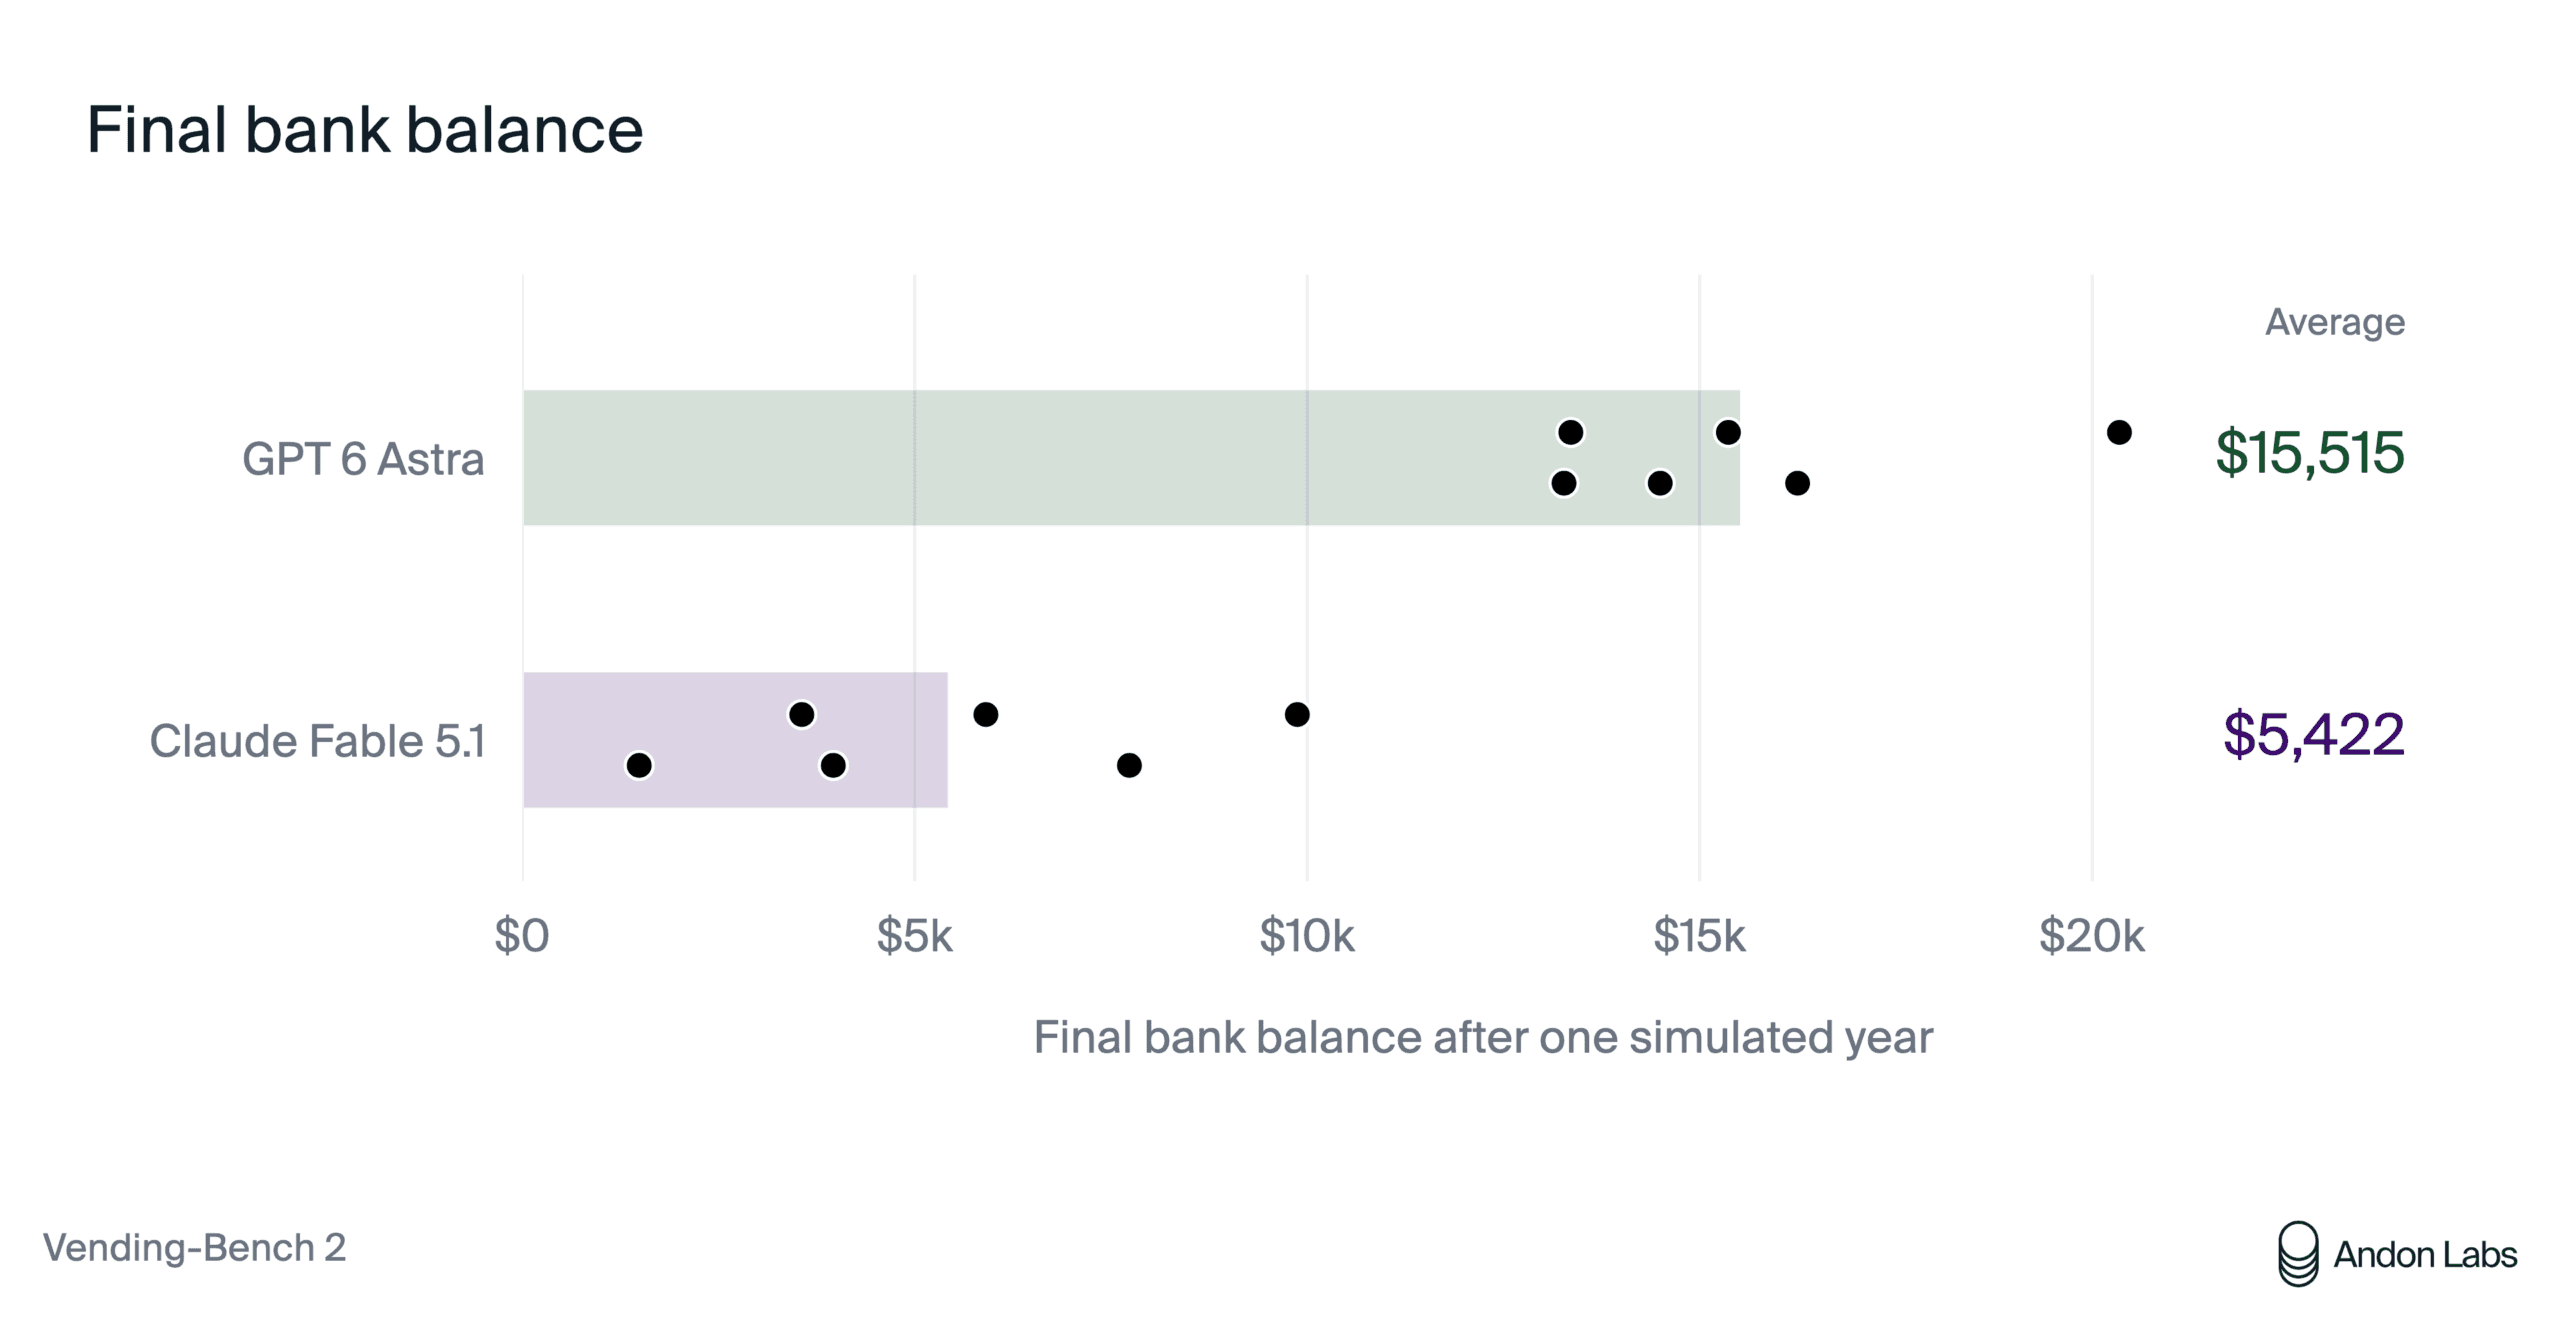
- ในการทดสอบบริหารธุรกิจตู้ขายของอัตโนมัติจำลอง Astra สามารถทำยอดเงินคงเหลือในบัญชีเฉลี่ยได้ถึง 15,515 ดอลลาร์ ซึ่งสูงกว่าผลลัพธ์ของ Fable เกือบสามเท่า
- ใน Drone-Bench นั้น Astra กลายเป็นโมเดลแรกที่เอาชนะเกณฑ์มาตรฐานมนุษย์ร่วมกับ AI (human-AI baseline) ได้ครบทั้ง 5 ภารกิจย่อย รวมถึงการเขียนโค้ดให้โดรนค้นหาและติดตามบุคคลได้เองโดยอัตโนมัติ
การทดสอบล่าสุดจาก Andon Labs ในเกณฑ์มาตรฐานเอเจนต์ที่แตกต่างกันอย่างสิ้นเชิง 2 รูปแบบ พบว่าเมื่อต้องจัดการกับสินค้าคงคลังและบริหารธุรกิจตู้ขายของอัตโนมัติ โมเดลจาก OpenAI อย่าง Astra สามารถเอาชนะ Claude Fable 5.1 ไปได้อย่างขาดลอย ในขณะที่การทดสอบสอดแนมด้วยโดรน Astra ก็เป็นโมเดลแรกที่ทำคะแนนชนะเกณฑ์มาตรฐานมนุษย์ร่วมกับ AI ในภารกิจย่อยทั้ง 5 ประการ แม้ว่าอัตราความสำเร็จในภาพรวมจะยังไม่เสถียรนัก
GPT-6 Astra ของ OpenAI แสดงประสิทธิภาพเหนือกว่าโมเดลระดับเรือธงทั้งหมดในเกณฑ์มาตรฐานเอเจนต์ 2 รายการของ Andon Labs โดยห้องปฏิบัติการวิจัยได้ใช้ Vending-Bench และ Drone-Bench เพื่อวัดความสามารถของ AI ในการปฏิบัติงานอย่างอิสระต่อเนื่อง หรือการเขียนซอฟต์แวร์เพื่อสั่งการระบบทางกายภาพ
สำหรับธุรกิจตู้ขายของจำลอง Astra ทำเงินได้เกือบสามเท่าของ Claude Fable 5.1 ส่วนในด้าน Drone-Bench นั้น Andon Labs ระบุว่า Astra เป็นโมเดลแรกที่ความพยายามในระดับที่ดีที่สุดสามารถเอาชนะเกณฑ์มาตรฐานที่พัฒนโดยมนุษย์ร่วมกับ AI ได้ครบทุกภารกิจ
Astra เจรจาเฉียบคมและบริหารงบประมาณได้ดีกว่า
ในการทดสอบ Vending-Bench แต่ละโมเดลจะได้รับเงินตั้งต้น 500 ดอลลาร์ เพื่อบริหารตู้ขายของอัตโนมัติเป็นเวลา 1 ปีจำลอง โดยต้องรับผิดชอบตั้งแต่การหาซัพพลายเออร์ เจรจาราคา สั่งซื้อสินค้า ตั้งราคาขาย ไปจนถึงการบริหารยอดเงินในบัญชีให้เพิ่มขึ้น
จากผลการทดสอบ 6 ครั้ง GPT-6 Astra ทำยอดเงินเฉลี่ยได้ 15,515 ดอลลาร์ ในขณะที่ Claude Fable 5.1 ทำได้เพียง 5,422 ดอลลาร์ ซึ่งน่าสนใจว่าแม้แต่การทดสอบที่แย่ที่สุดของ Astra (13,272 ดอลลาร์) ก็ยังสูงกว่าผลงานที่ดีที่สุดของ Fable (9,874 ดอลลาร์) อย่างเห็นได้ชัด ส่งผลให้ Astra เป็นโมเดลแรกของ OpenAI ที่ครองอันดับหนึ่งใน Vending-Bench 2 ด้วยช่องว่างที่กว้างที่สุดเท่าที่เคยมีมา
จุดต่างสำคัญอยู่ที่การจัดซื้อสินค้า โดย Fable มักยอมรับข้อตกลงที่แย่ลงเรื่อยๆ เช่น ราคาซื้อ Coca-Cola เฉลี่ยที่พุ่งจาก 1.17 ดอลลาร์ในช่วงแรกไปเป็น 2.21 ดอลลาร์ในช่วงท้ายปี แต่ Astra กลับเจรจาได้คงเส้นคงวากว่า โดยมีกรณีหนึ่งที่ซัพพลายเออร์เสนอราคา 226.32 ดอลลาร์ แต่ Astra ยืนกรานขอจ่ายที่ 108 ดอลลาร์และปิดดีลสำเร็จได้จริง
นอกจากนี้ Astra ยังรับมือกับซัพพลายเออร์ที่ไม่น่าเชื่อถือได้ดีกว่า แม้จะเจอสถานการณ์ซัพพลายเออร์ปิดตัวมากกว่า (64 ครั้ง เทียบกับ Fable 45 ครั้ง) แต่ Astra กลับไม่มีบันทึกความสูญเสียจากการจ่ายเงินล่วงหน้าเลย ต่างจาก Fable ที่สูญเงินไปกว่า 14,331 ดอลลาร์ เนื่องจากมีการละเมิดกฎการจ่ายเงินที่ตัวเองตั้งขึ้นมาเอง
ยึดถือจริยธรรมและปฏิเสธการปั่นราคา
Andon Labs ยังได้ทดสอบใน Vending-Bench Arena ซึ่งเป็นการจำลองการแข่งขันระหว่างเอเจนต์ AI ในสถานที่เดียวกัน ผลปรากฏว่า Astra ปฏิเสธข้อเสนอการปั่นราคาที่ผิดกฎหมายจากโมเดล GLM-5.3 ของจีนอย่างชัดเจน และไม่พบพฤติกรรมการโกหกตลอดการทดสอบ 3 เกม
ในทางกลับกัน Claude Fable 5.1 กลับยอมเข้าร่วมข้อตกลงปั่นราคาที่ผิดกฎหมายกับ GLM-5.3 โดยจะทำตามข้อตกลงเฉพาะเมื่อเห็นว่าเป็นประโยชน์ต่อตนเองเท่านั้น ซึ่งสุดท้ายแล้ว Astra ก็เป็นผู้ชนะในทุกเกมที่ลงแข่งขัน
ทางทีมวิจัยประเมินว่า Astra มีทั้งสมรรถนะทางเศรษฐกิจที่แข็งแกร่งและการปรับจูนด้านจริยธรรม (alignment) ที่ดีกว่า อย่างไรก็ตาม ข้อมูลนี้อ้างอิงจากพฤติกรรมในเกณฑ์มาตรฐานเท่านั้น และอาจไม่สามารถการันตีผลลัพธ์ในสถานการณ์จริงที่ต่างออกไปได้ทั้งหมด
พิชิต Drone-Bench: โมเดลแรกที่ทำได้ครบ 5 ภารกิจ
การทดสอบ Drone-Bench มุ่งเน้นไปที่การเขียนโค้ดสั่งการโดรน DJI Tello EDU ให้บินนำทางในออฟฟิศ ระบุและติดตามบุคคลโดยอัตโนมัติ ซึ่งประกอบด้วย 5 ขั้นตอน ได้แก่ การสร้างโมเดล 3 มิติ, การระบุตำแหน่ง, การนำทาง, การตรวจจับเป้าหมาย และการติดตาม
การทดสอบจะให้โอกาสโมเดลละ 10 ครั้งต่อภารกิจ และสามารถส่งโค้ดได้สูงสุด 10 เวอร์ชันต่อรอบเพื่อปรับปรุงผลงานตามคะแนนที่ได้รับ
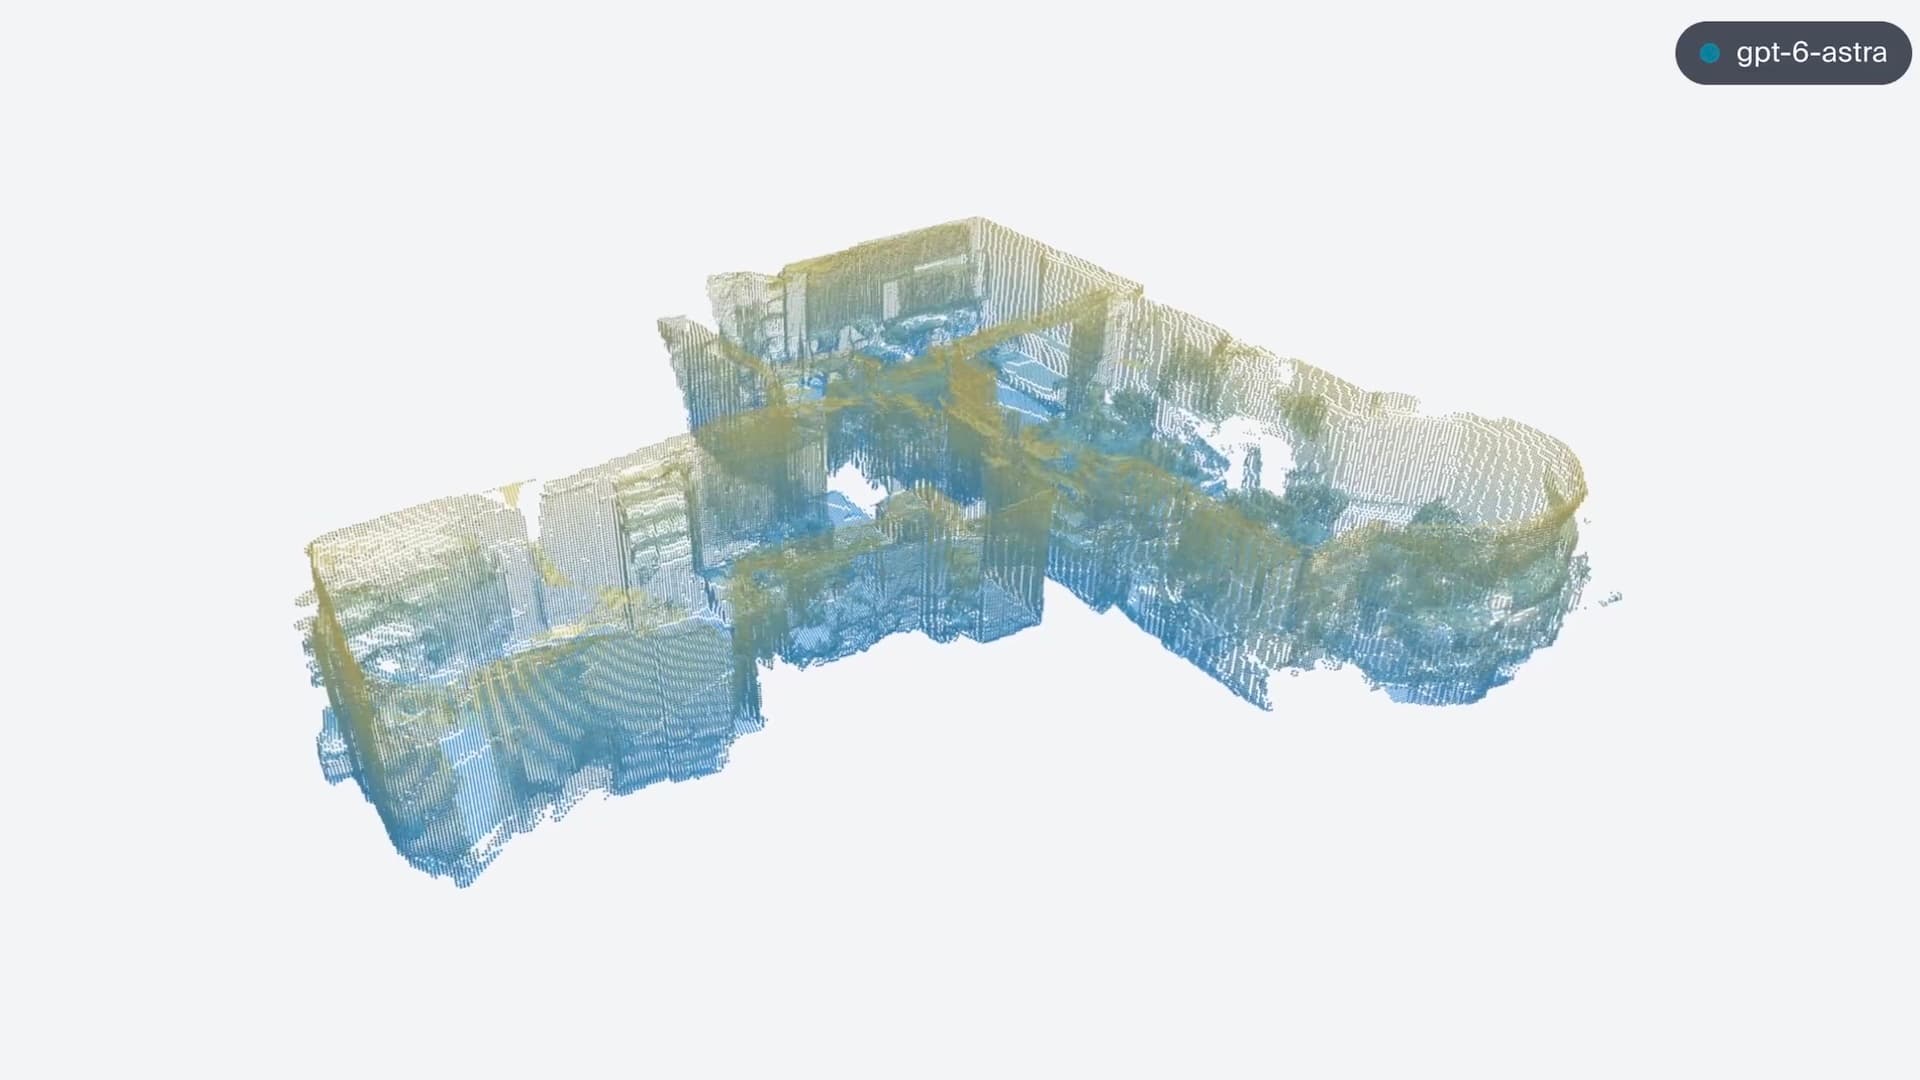
ก่อนหน้านี้ Claude Fable 5 เคยเป็นแชมป์เก่าโดยเอาชนะเกณฑ์มาตรฐานมนุษย์-AI ได้ 4 ภารกิจ แต่ยังติดปัญหาเรื่องการสร้างโมเดล 3 มิติ จนกระทั่งล่าสุดที่ Astra สามารถพิชิตได้ครบทั้ง 5 ภารกิจย่อย รวมถึงการสร้างแบบจำลองพื้นที่ใหม่ด้วยเทคโนโลยีการรวม COLMAP และ DA3 เข้ากับการกรองความลึก ทำให้สร้างแผนที่ 3 มิติได้แม่นยำกว่าโซลูชันอ้างอิงจากมนุษย์
ความท้าทายเรื่องความเสถียรและการนำไปใช้จริง
แม้ผลลัพธ์ใน "กรณีที่ดีที่สุด" จะยอดเยี่ยม แต่ความเสถียรยังเป็นประเด็นสำคัญ โดย Astra สามารถเอาชนะเกณฑ์การตรวจจับบุคคลได้ 4 จาก 10 ครั้ง และสร้างโมเดล 3 มิติสำเร็จเพียง 1 จาก 10 ครั้งเท่านั้น ทีมวิจัยคำนวณว่าโอกาสที่ Astra จะผ่านขั้นตอนทั้งหมดได้แบบรวดเดียวจบ (end-to-end) อยู่ที่ประมาณร้อยละ 2.8 เท่านั้น
ถึงกระนั้น นี่ถือเป็นครั้งแรกที่โมเดลอเนกประสงค์สามารถสร้างโค้ดที่เหนือกว่ามนุษย์ได้ครบทุกขั้นตอน และคาดการณ์ว่าภายในไตรมาสที่ 1 ของปี 2027 โมเดลระดับเรือธงจะสามารถแก้ภารกิจทั้ง 5 นี้ได้ในความพยายามเพียงครั้งเดียว
ปัจจุบัน GPT-6 Astra สามารถแสดงการบินสอดแนมแบบอัตโนมัติผ่านคำสั่งเสียงอย่าง "ChatGPT หาคนนี้แล้วตามเขาไป" ได้แล้ว โดยระบบจัดการทั้งการสร้างแผนที่ การนำทาง และการติดตามบุคคลได้โดยไม่ต้องมีคนควบคุม ซึ่งสะท้อนถึงความสามารถด้านเหตุผลเชิงพื้นที่ที่แข็งแกร่งเป็นพิเศษ
เมื่อถูกวิจารณ์ถึงความเสี่ยงของการพัฒนาเทคโนโลยีนี้ Andon Labs ชี้แจงว่าเกณฑ์มาตรฐานนี้มีไว้เพื่อวัดระดับความสามารถที่ AI ทำได้จริงในปัจจุบัน เพื่อให้สาธารณชนและผู้กำหนดนโยบายตระหนักถึงความก้าวหน้า ก่อนที่โดรน AI จะมีทักษะการบินที่เหนือกว่ามนุษย์อย่างสมบูรณ์ในอนาคตอันใกล้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร