
การบริหารจัดการ GPU: เหตุผลที่ GPU ว่างเปล่าเปรียบเสมือนเครื่องบินที่จอดนิ่งสนิท
อัตราการใช้งาน (Utilization) ไม่ใช่แค่ความฉลาด: ข้อจำกัดที่แท้จริงลำดับถัดไปของ AI
อุตสาหกรรมการบินได้เรียนรู้บทเรียนอันล้ำค่าว่า ตัวบ่งชี้ความอยู่รอดของธุรกิจที่ดีที่สุดคือ ระยะเวลาที่เครื่องบินแต่ละลำจอดอยู่บนพื้นดินในแต่ละวัน
เหตุผลสำคัญมาจากโครงสร้างต้นทุนที่เพิ่มขึ้นตามเวลาในปฏิทิน ไม่ว่าจะเป็นการจัดหาเงินทุน ค่าเสื่อมราคา ประกันภัย การบำรุงรักษา และสัญญาจ้างลูกเรือ แต่รายได้จะเกิดขึ้นเฉพาะในช่วงเวลาบินเท่านั้น ทุกชั่วโมงที่เสียไปบนพื้นจึงทำให้ผลผลิตหดตัวลงในขณะที่ต้นทุนยังเดินหน้าต่อไป วินัยในการหมุนเวียนเครื่องบิน (Turnaround) และการวางแผนที่แม่นยำจึงสะท้อนออกมาผ่านตัวเลขการใช้งานเพียงตัวเดียวนี้
การมีฝูงบินที่ใหญ่กว่าอาจช่วยเพิ่มความจุได้ แต่สายการบินสองแห่งที่มีขนาดฝูงบินเท่ากันในเส้นทางเดียวกัน อาจมีผลประกอบการต่างกันอย่างสิ้นเชิง ซึ่งช่องว่างนี้เกิดจากการวัดผลประสิทธิภาพการใช้งานมากกว่าขนาดของฝูงบินที่มี
Enterprise AI กำลังเผชิญกับโครงสร้างแบบเดียวกัน GPU มีต้นทุนพอกพูนตามชั่วโมงปฏิทิน ทั้งค่าเสื่อมและพลังงาน ไม่ว่าจะถูกใช้งานหรือไม่ก็ตาม ผลผลิตจะเกิดขึ้นตามชั่วโมงการประมวลผล (Compute hour) เท่านั้น สองบริษัทที่มีงบประมาณ GPU เท่ากันจะเริ่มมีความแตกต่างกันตามความสามารถในการทำให้ฮาร์ดแวร์นั้นทำสิ่งที่มีประโยชน์ อัตราการใช้งาน (Utilization) จึงกลายเป็นข้อจำกัดที่แท้จริงที่อุตสาหกรรมกำลังเผชิญอยู่ในปัจจุบัน
คอขวดเปลี่ยนจากโมเดลมาสู่การประมวลผล
ความขาดแคลนไม่ได้หายไปเมื่อ AI ขยายตัว แต่พุ่งเป้าไปที่ทรัพยากรอื่นแทน ในยุคแรก Enterprise AI วัดกันที่คุณภาพและขนาดของโมเดล แต่ในปัจจุบัน Production AI ต้องรันบนฮาร์ดแวร์เฉพาะทางอย่าง GPU ซึ่งมีราคาแพงและมีปริมาณจำกัดอย่างยิ่ง
ในปี 2020 ซูเปอร์คอมพิวเตอร์ที่ Microsoft สร้างให้ OpenAI ดูเหมือนจะเป็นจุดสูงสุดของฮาร์ดแวร์ แต่หกปีให้หลัง ตัวเลขนั้นกลายเป็นเพียงจุดเริ่มต้น ปัจจุบันแล็บระดับโลกอย่าง Anthropic หรือ Meta ต้องทำข้อตกลงใช้งานระดับหลายกิกะวัตต์จากผู้ให้บริการหลายรายพร้อมกันเพื่อกระจายความเสี่ยง เนื่องจากไม่มีแหล่งทรัพยากรเดียวที่เพียงพอต่อความต้องการ
สำหรับองค์กรที่ใช้งานผ่าน API ปัญหาหลักคือเรื่องราคาที่เพิ่มขึ้นเป็นเส้นตรงตามจำนวน Token ที่ใช้ ทำให้เศรษฐศาสตร์ของระบบต้นแบบ (PoC) ต่างจากระดับการใช้งานจริง (Production) อย่างสิ้นเชิง องค์กรจึงเริ่มหันมาจัดหา GPU เองเพื่อเปลี่ยนต้นทุนผันแปรเป็นต้นทุนคงที่ (Fixed capital)
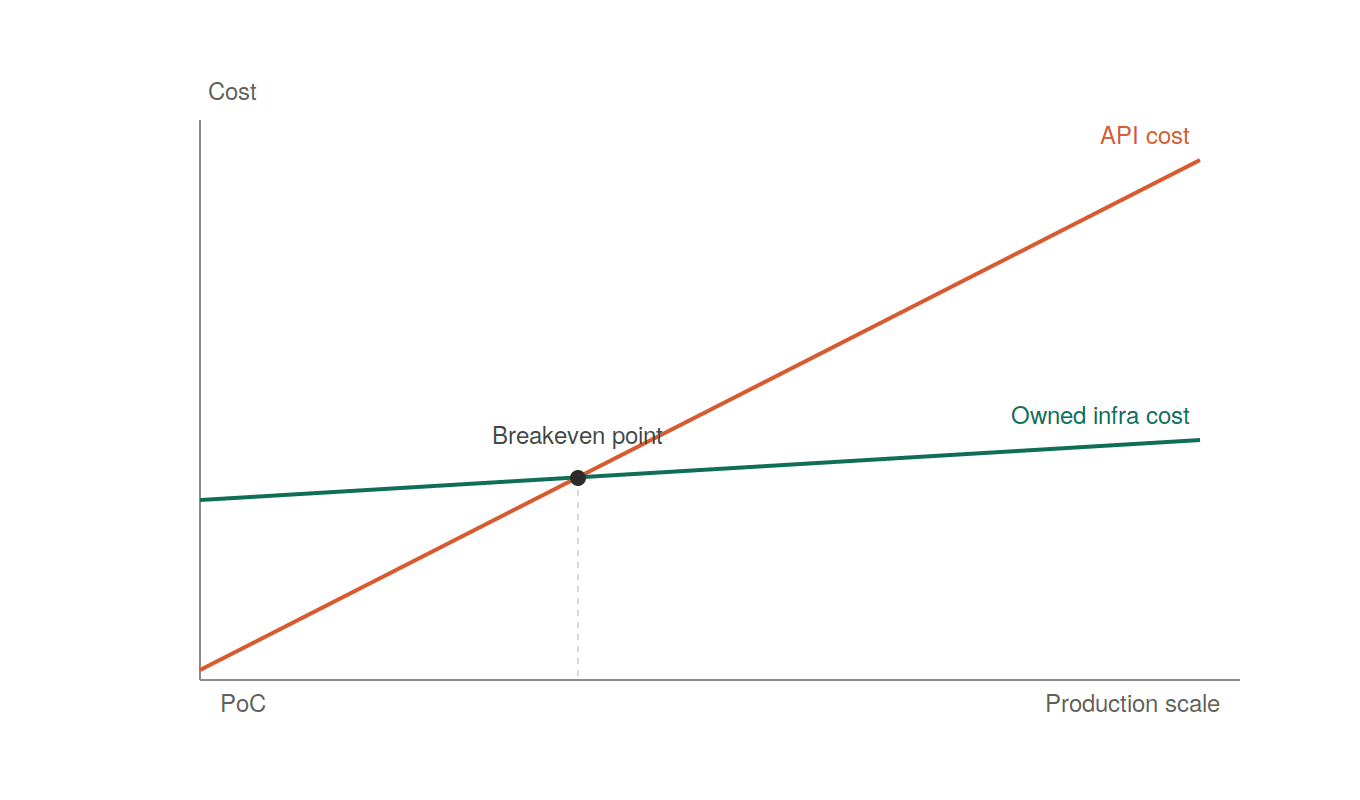
ต้นทุน API จะสูงขึ้นตามการใช้งาน ในขณะที่โครงสร้างพื้นฐานที่เป็นเจ้าเองจะมีราคาใกล้เคียงค่าคงที่ เมื่อผ่านจุดคุ้มทุนไปแล้ว ข้อได้เปรียบจะพลิกกลับด้าน
การเปลี่ยนแปลงนี้ทำให้ GPU กลายเป็นโครงสร้างพื้นฐานที่ต้องรองรับช่วงที่มีความต้องการสูงสุด (Demand peaks) ซึ่งมักหมายถึงการจัดหาทรัพยากรไว้เกินความต้องการจริง คำถามสำคัญจึงเปลี่ยนจาก "จะหาฮาร์ดแวร์ได้ที่ไหน" เป็น "จะทำให้พวกมันทำงานตลอดเวลาได้อย่างไร" เพราะการทำให้เครื่องไม่ต้องจอดแช่บนพื้นคือตัวตัดสินความคุ้มค่าที่แท้จริง
ทำไมคลัสเตอร์ที่ดูไม่ว่าง แต่ยังเสียความจุโดยเปล่าประโยชน์
แม้ GPU จะทำงานต่อเนื่อง แต่ความต้องการใช้งานจริงไม่ได้สม่ำเสมอ โครงสร้างพื้นฐานมักถูกสำรองไว้สำหรับช่วงงานล้น (Peak) ทำให้มีความจุส่วนเกินมหาศาลนอกช่วงเวลาดังกล่าว ยิ่งไปกว่านั้น งาน AI ในปัจจุบันมีความหลากหลายสูง ตั้งแต่ Inference, Training ไปจนถึง Fine-tuning และ Quantization
งานแต่ละประเภทต้องการทรัพยากรต่างกัน เช่น Real-time inference เน้น Latency ต่ำ แต่งานแบบ Batch เน้น Throughput ความไม่สอดคล้องกันนี้ทำให้ตัวจัดการคิว (Scheduler) ทำงานได้ยาก คลัสเตอร์อาจรายงานการใช้งานสูง แต่ในความจริงงานในคิวอาจกำลังรอ "รูปแบบ GPU" ที่เหมาะสมซึ่งกำลังจมอยู่กับงานประเภทอื่นที่ต่างกันสิ้นเชิง
ความแตกต่างนี้ทำให้การจัดการทรัพยากร (Orchestration) ของ GPU ยากกว่าการจัดตารางบิน เพราะ GPU ที่ว่างอาจรองรับได้เฉพาะเวิร์กโหลดที่มีคุณสมบัติหน่วยความจำและระยะเวลาที่เฉพาะเจาะจงเท่านั้น การซื้อ GPU เพิ่มจึงไม่ใช่การแก้ปัญหาที่ต้นเหตุเสมอไป หากการจัดสรรทรัพยากรยังไม่มีประสิทธิภาพเพียงพอ
ความฉลาดขยับเข้าไปอยู่ในโครงสร้างพื้นฐาน
การเพิ่ม ROI ของ GPU ให้สูงสุดต้องใช้การบริหารจัดการโครงสร้างพื้นฐาน (GPU Management) ที่แข็งขัน ซึ่งทำหน้าที่เป็นชั้นของการจัดการ (Orchestration layer) ระหว่างเวิร์กโหลดและฮาร์ดแวร์ เพื่อตัดสินใจว่างานใดควรทำบน GPU ตัวไหนและในเวลาใด
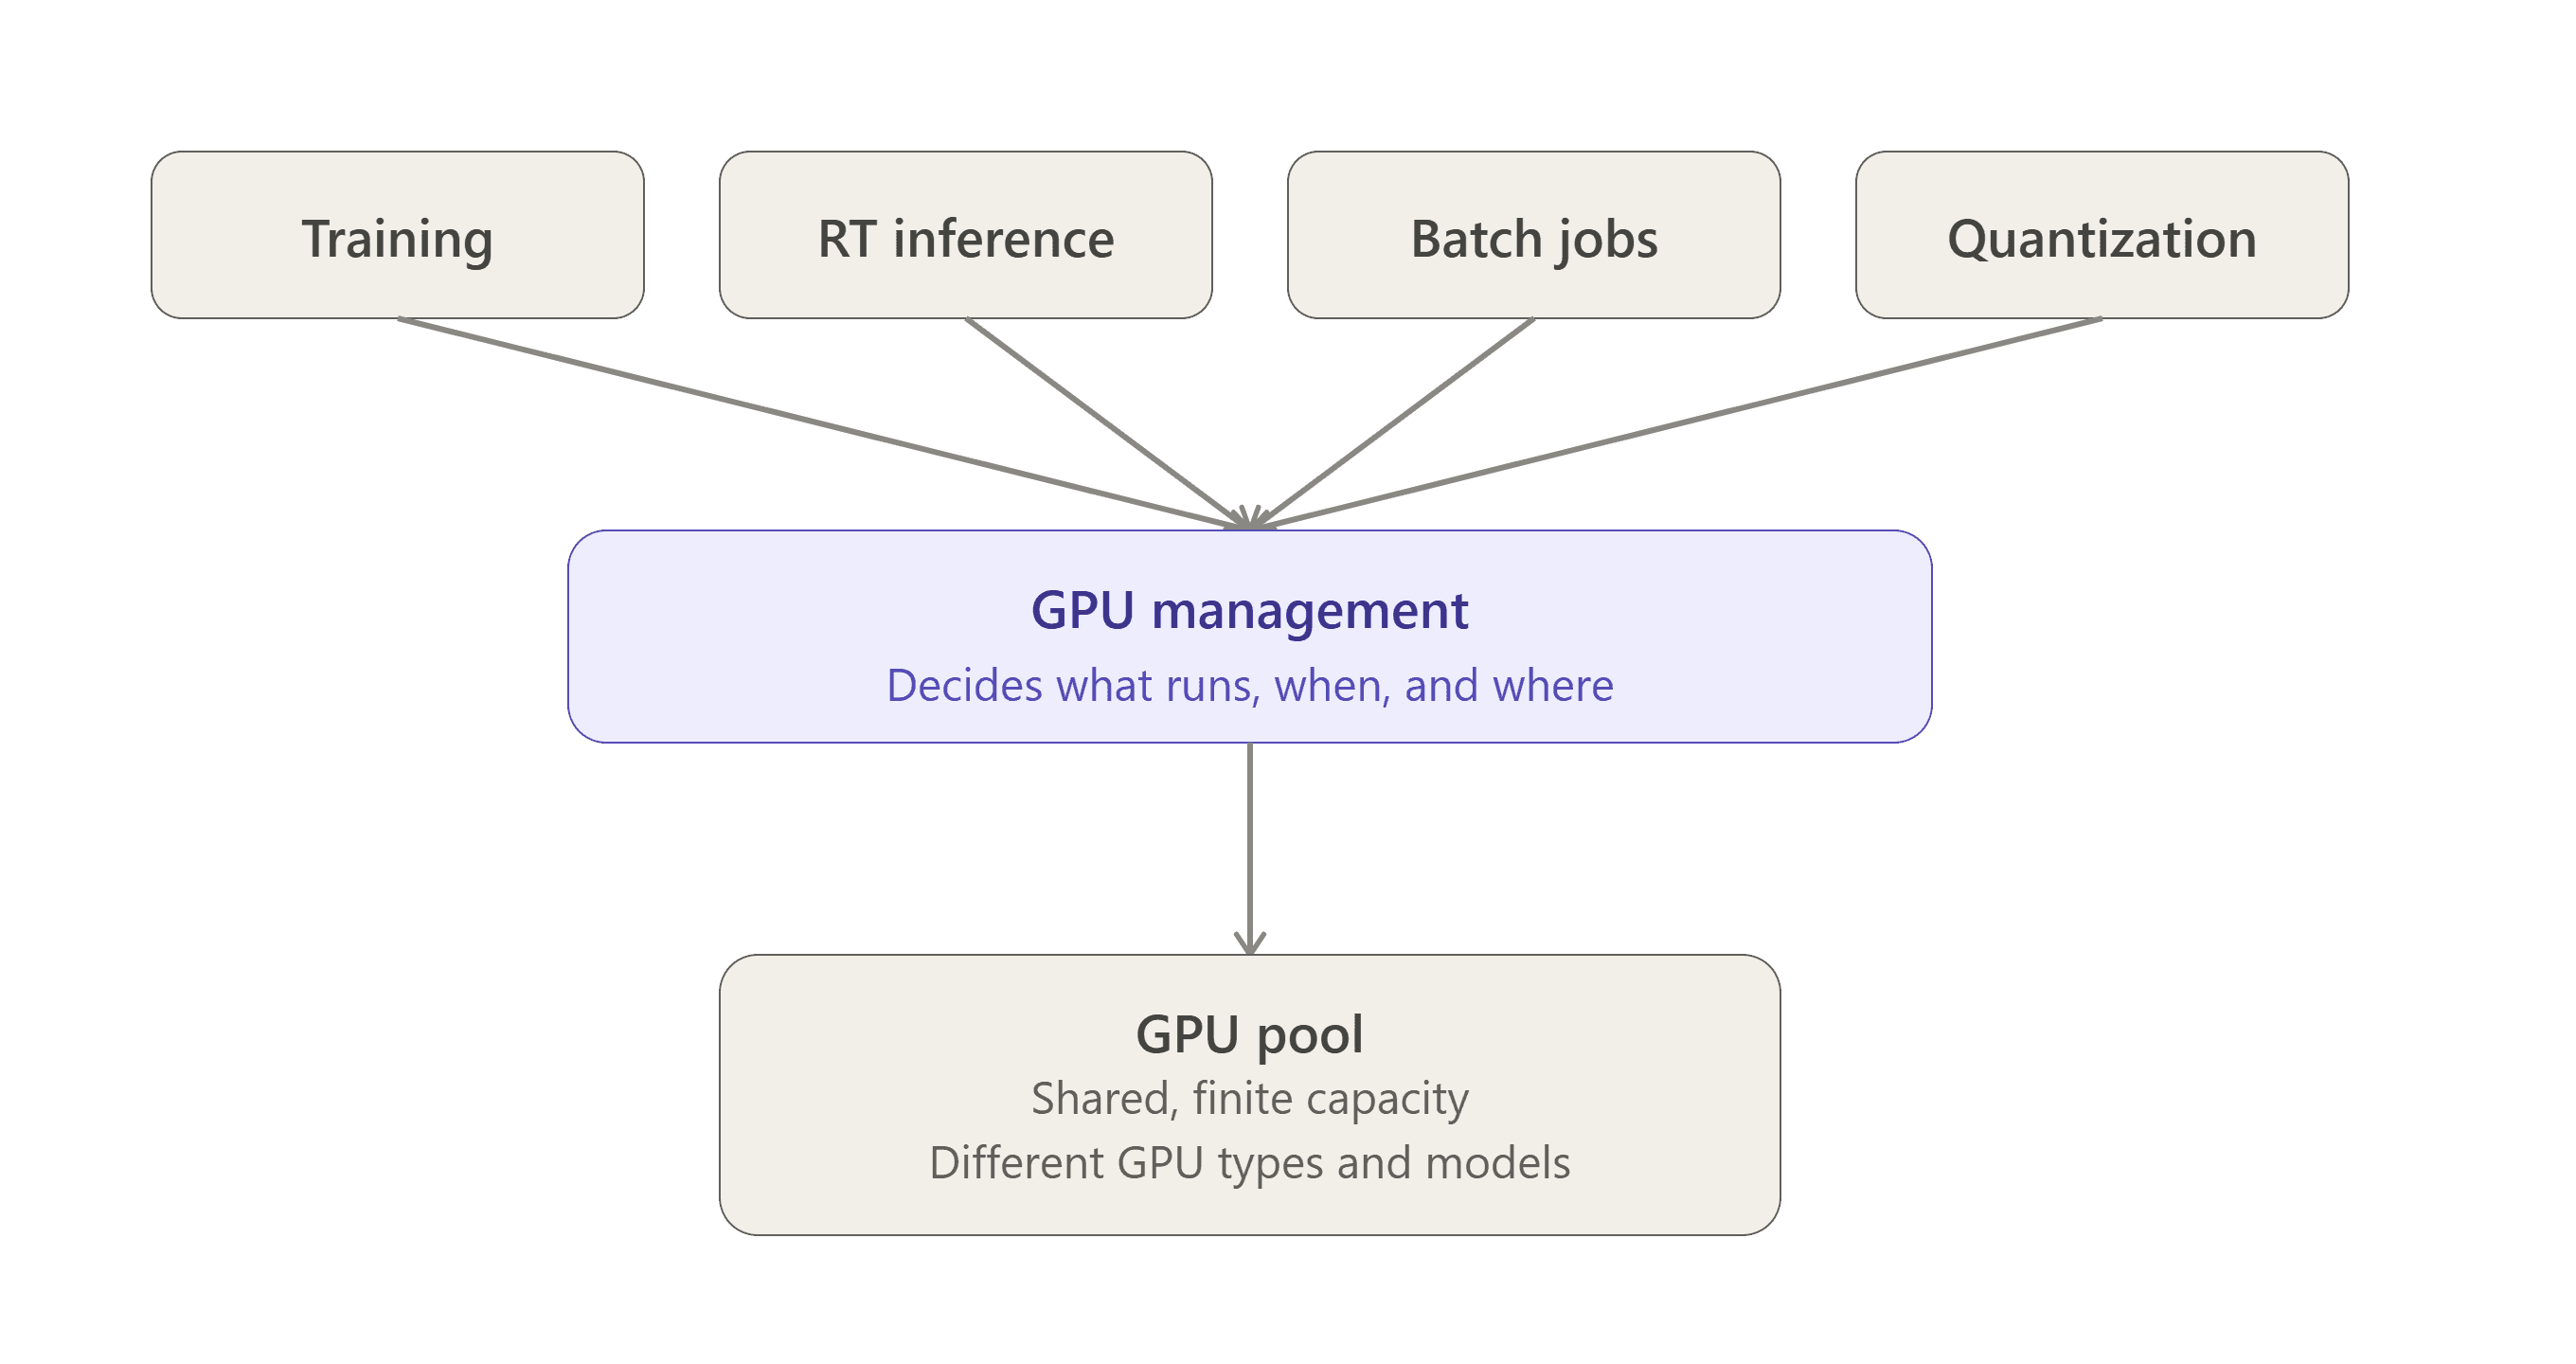
ความฉลาดไม่ได้หยุดอยู่ที่ขอบเขตของโมเดลเท่านั้น ชั้นการจัดการกำลังตัดสินใจจัดสรรทรัพยากรแบบเรียลไทม์ ซึ่งตัวโมเดลเองไม่มีทางมองเห็นได้
ความฉลาดที่เคยอยู่ในตัวโมเดลเพียงอย่างเดียว กำลังขยับเข้ามาอยู่ในชั้นโครงสร้างพื้นฐานที่ต้องตัดสินใจแบบนาทีต่อนาที การทำให้ GPU "ไม่ว่าง" ไม่ใช่เป้าหมายสูงสุด เพราะความยุ่งนั้นอาจมาจากการรันงานความสำคัญต่ำ แต่การเพิ่มผลตอบแทนสูงสุดจากทรัพยากรที่มีต่างหากคือหัวใจสำคัญ ซึ่งต้องอาศัยระบบอัตโนมัติที่แม่นยำในการจัดการแทนมนุษย์
การสร้างความเฉพาะทางช่วยคืนความจุ; การบริหารจัดการคือการนำความจุนั้นไปใช้
ความเฉพาะทาง (Specialization) และการบริหารจัดการ (Orchestration) คือสองด้านของเหรียญเดียวกัน โมเดลเฉพาะงานที่มีขนาดเล็กสามารถทำงานได้โดยใช้ทรัพยากรเพียงบางส่วน ช่วยคืนความจุให้กับคลัสเตอร์ แต่ความจุนั้นจะมีประโยชน์ต่อเมื่อมีระบบที่คอยจัดสรรงานอื่นเข้าไปแทนที่ทันที
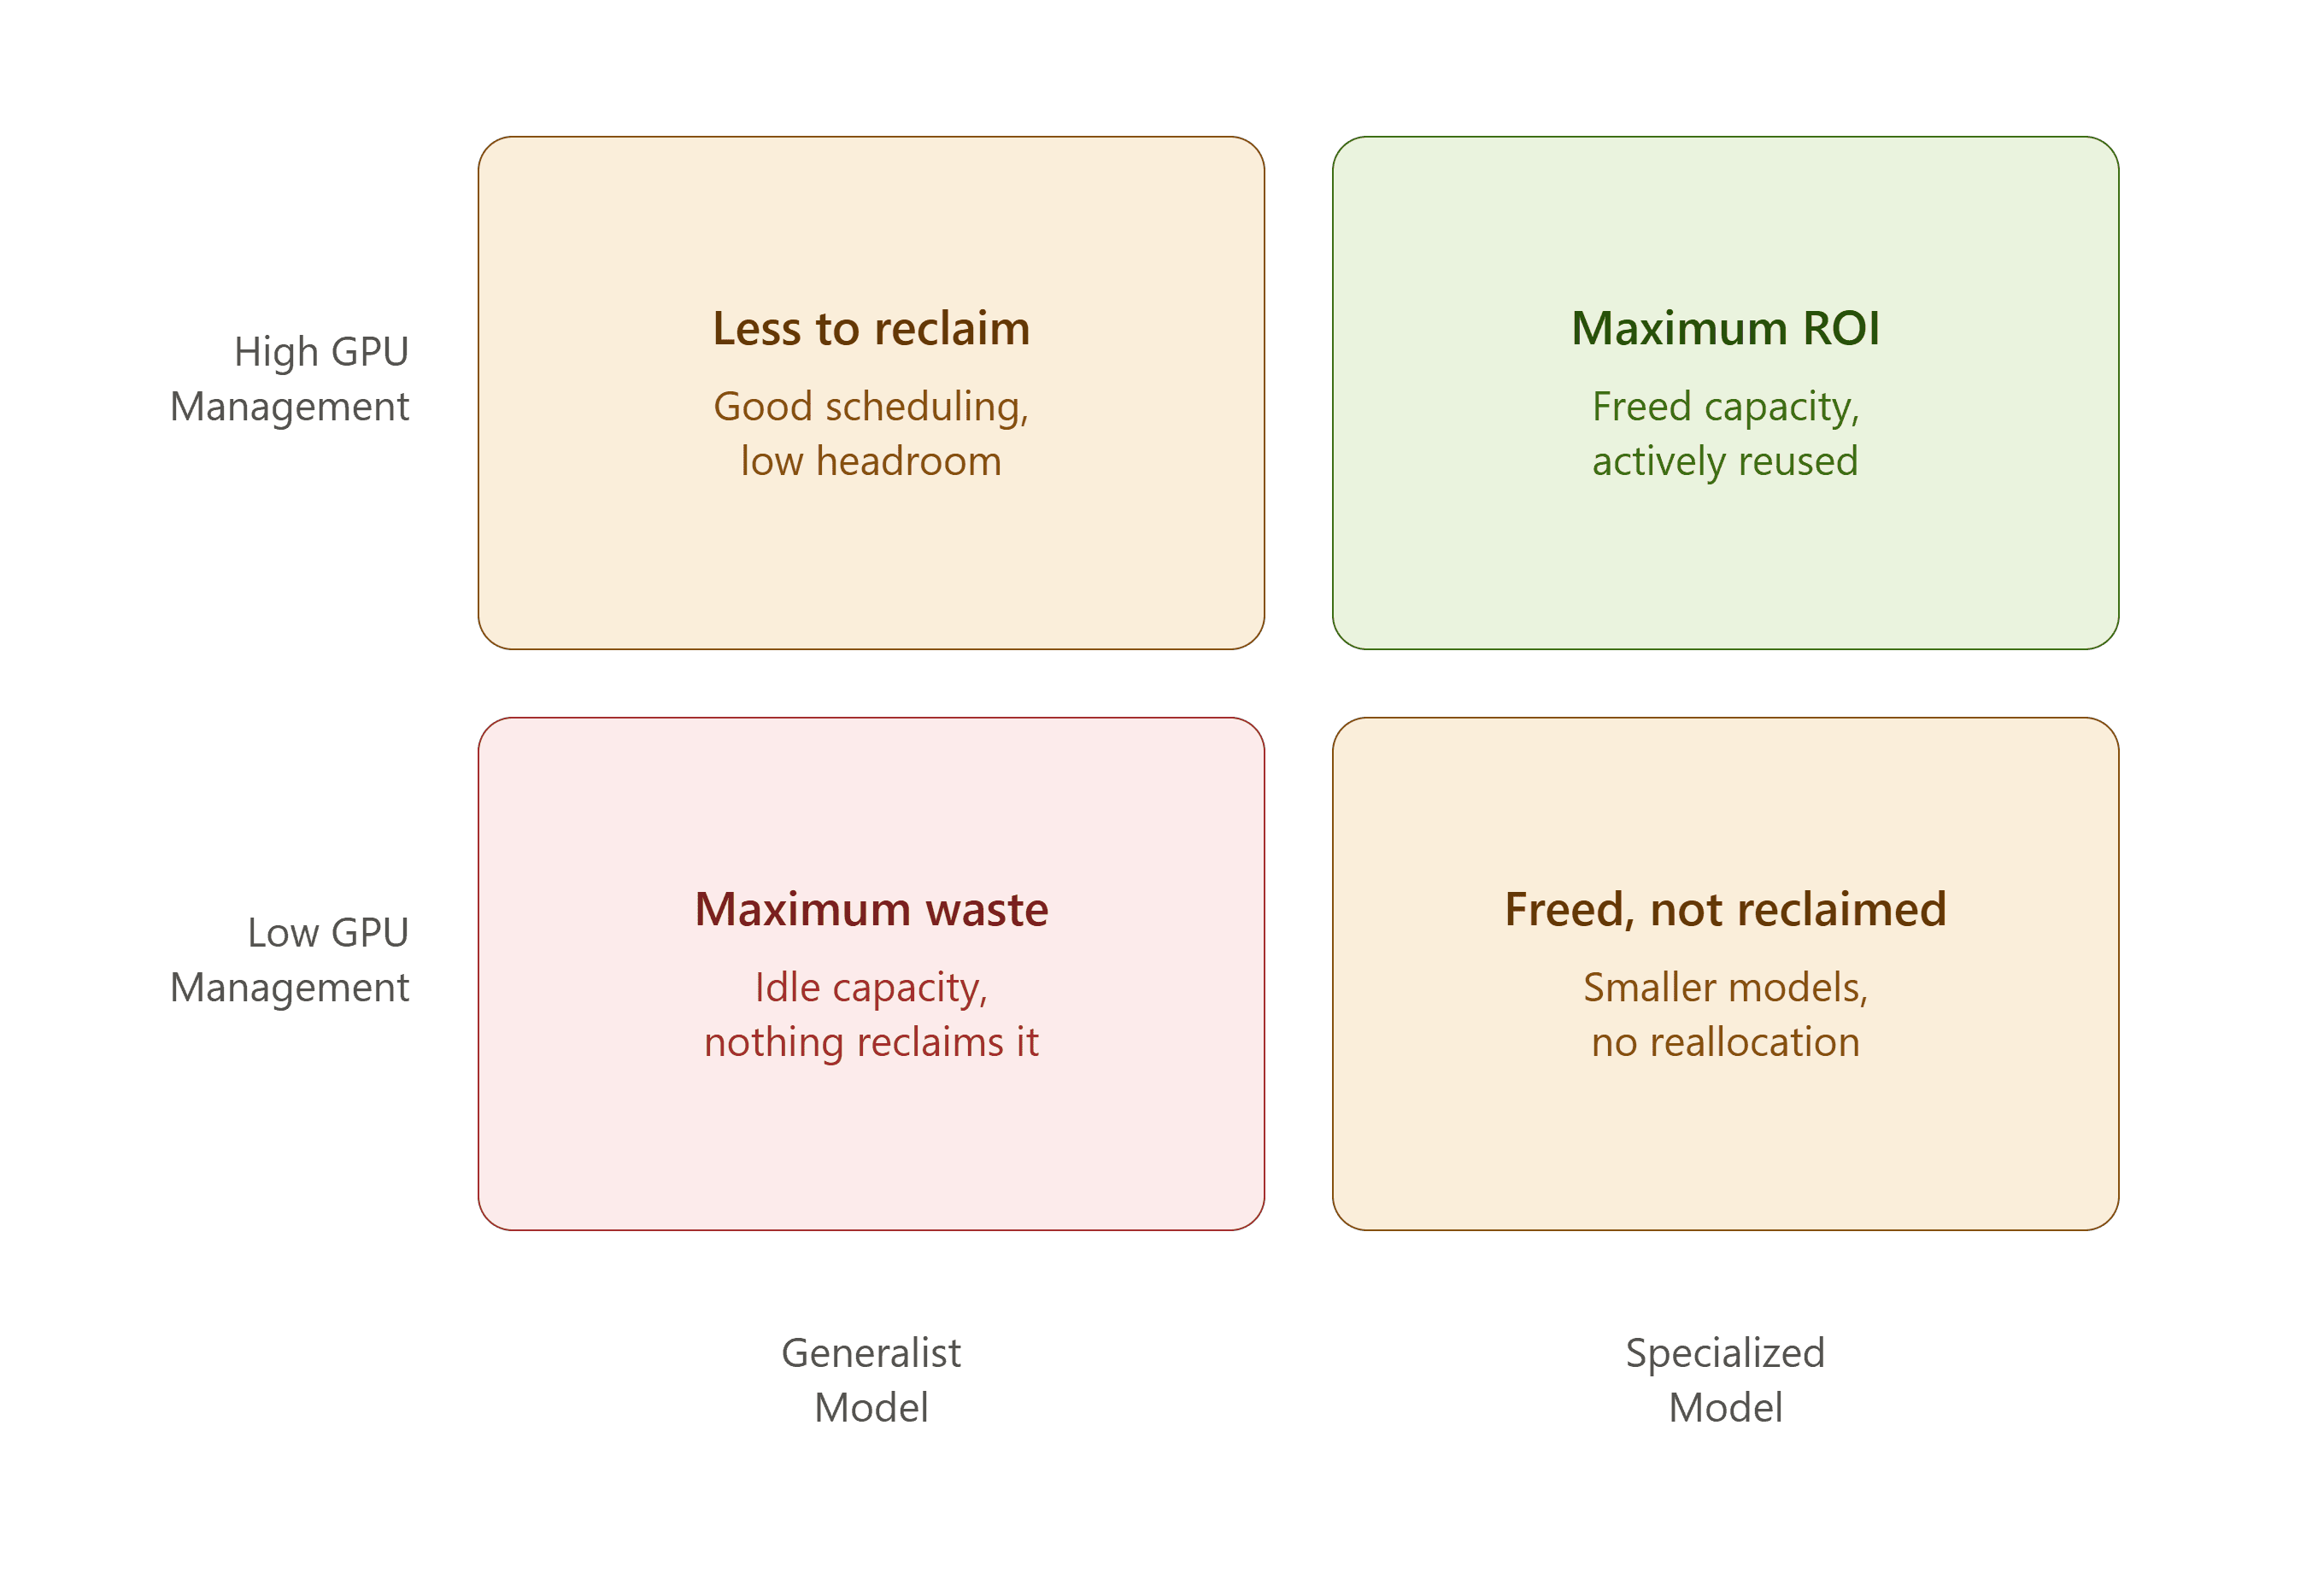
ความเฉพาะทางที่ปราศจากการบริหารจัดการทรัพยากร จะเป็นการปลดปล่อยความจุที่ไม่มีใครนำกลับมาใช้ การบริหารจัดการที่ปราศจากความเฉพาะทาง จะมีความจุเหลือให้ดึงกลับมาใช้น้อยกว่า ไม่มีทางลัดใดที่ทำงานได้สมบูรณ์โดยลำพัง
การสร้างความเฉพาะทางโดยไม่มีการจัดการคือความสูญเสียในอีกรูปแบบหนึ่ง ในขณะที่การจัดการโดยไม่มีความเฉพาะทางก็จะมีศักยภาพที่ดึงกลับมาใช้ได้น้อย สถาปัตยกรรมโมเดลและการบริหารจัดการ GPU จึงต้องทำงานร่วมกัน ทางหนึ่งลดทรัพยากรที่ต้องใช้ อีกทางหนึ่งตัดสินใจว่าส่วนต่างที่เหลือควรไปอยู่ที่ใด
แม้ฝูงบินที่ใหญ่กว่าจะได้เปรียบ แต่ผู้ชนะในสมรภูมิ Enterprise AI คือองค์กรที่ใช้งานสิ่งที่ตนมีได้เต็มประสิทธิภาพที่สุด โมเดลเฉพาะทางและการจัดการ GPU จะเป็นกลยุทธ์สำคัญที่กำหนดจังหวะการแข่งขันในทศวรรษหน้า
อ่านเพิ่มเติม
- Newer Models, Same Advantage — แม้จะมีสถาปัตยกรรมใหม่ แต่ DharmaOCR ยังคงมีประสิทธิภาพเหนือกว่าผ่านความเฉพาะทางในโดเมนและการฝึกฝนที่ตรงเป้าหมาย
- Why Specialization Is Inevitable — รากฐานทางทฤษฎีว่าด้วยความเฉพาะทาง เมื่อทรัพยากรจำกัด สิ่งที่เหมาสมที่สุด (Fit) จะชนะความกว้าง (Breadth)
- Specialization Beats Scale: A Strategic Variable Most AI Procurement Decisions Overlook — บทวิเคราะห์ว่าทำไมความเฉพาะทางจึงมีประสิทธิภาพเหนือกว่าในทางปฏิบัติ และเหตุใดปัจจัยนี้จึงมักถูกมองข้ามในการจัดซื้อ AI
- Text Degeneration: A Production Failure Mode That Most Benchmarks Do Not Track — รูปแบบความล้มเหลวที่เกิดขึ้นเมื่อโมเดลภาษาสื่อสารนอกขอบเขตประสิทธิภาพ
- Direct Preference Optimization Beyond Chatbots — การประยุกต์ใช้เทคนิค Preference optimization ในโดเมนเฉพาะทางนอกเหนือจากแชทบอท
สำรวจ Dharma AI บน Hugging Face เพื่อ ทดลองเล่นเดโมแบบโต้ตอบของเรา, ดาวน์โหลดโมเดลโอเพนซอร์สของเรา และค้นพบว่าระบบ AI เฉพาะทางมีประสิทธิภาพเหนือกว่าโมเดลอเนกประสงค์ในการใช้งานจริงระดับองค์กรได้อย่างไร
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร