
H Company เปิดตัว NeoMME โมเดล Single-Tower ประสิทธิภาพสูง ตัด Vision Tower และ Decoder ออกเพื่อความเร็ว
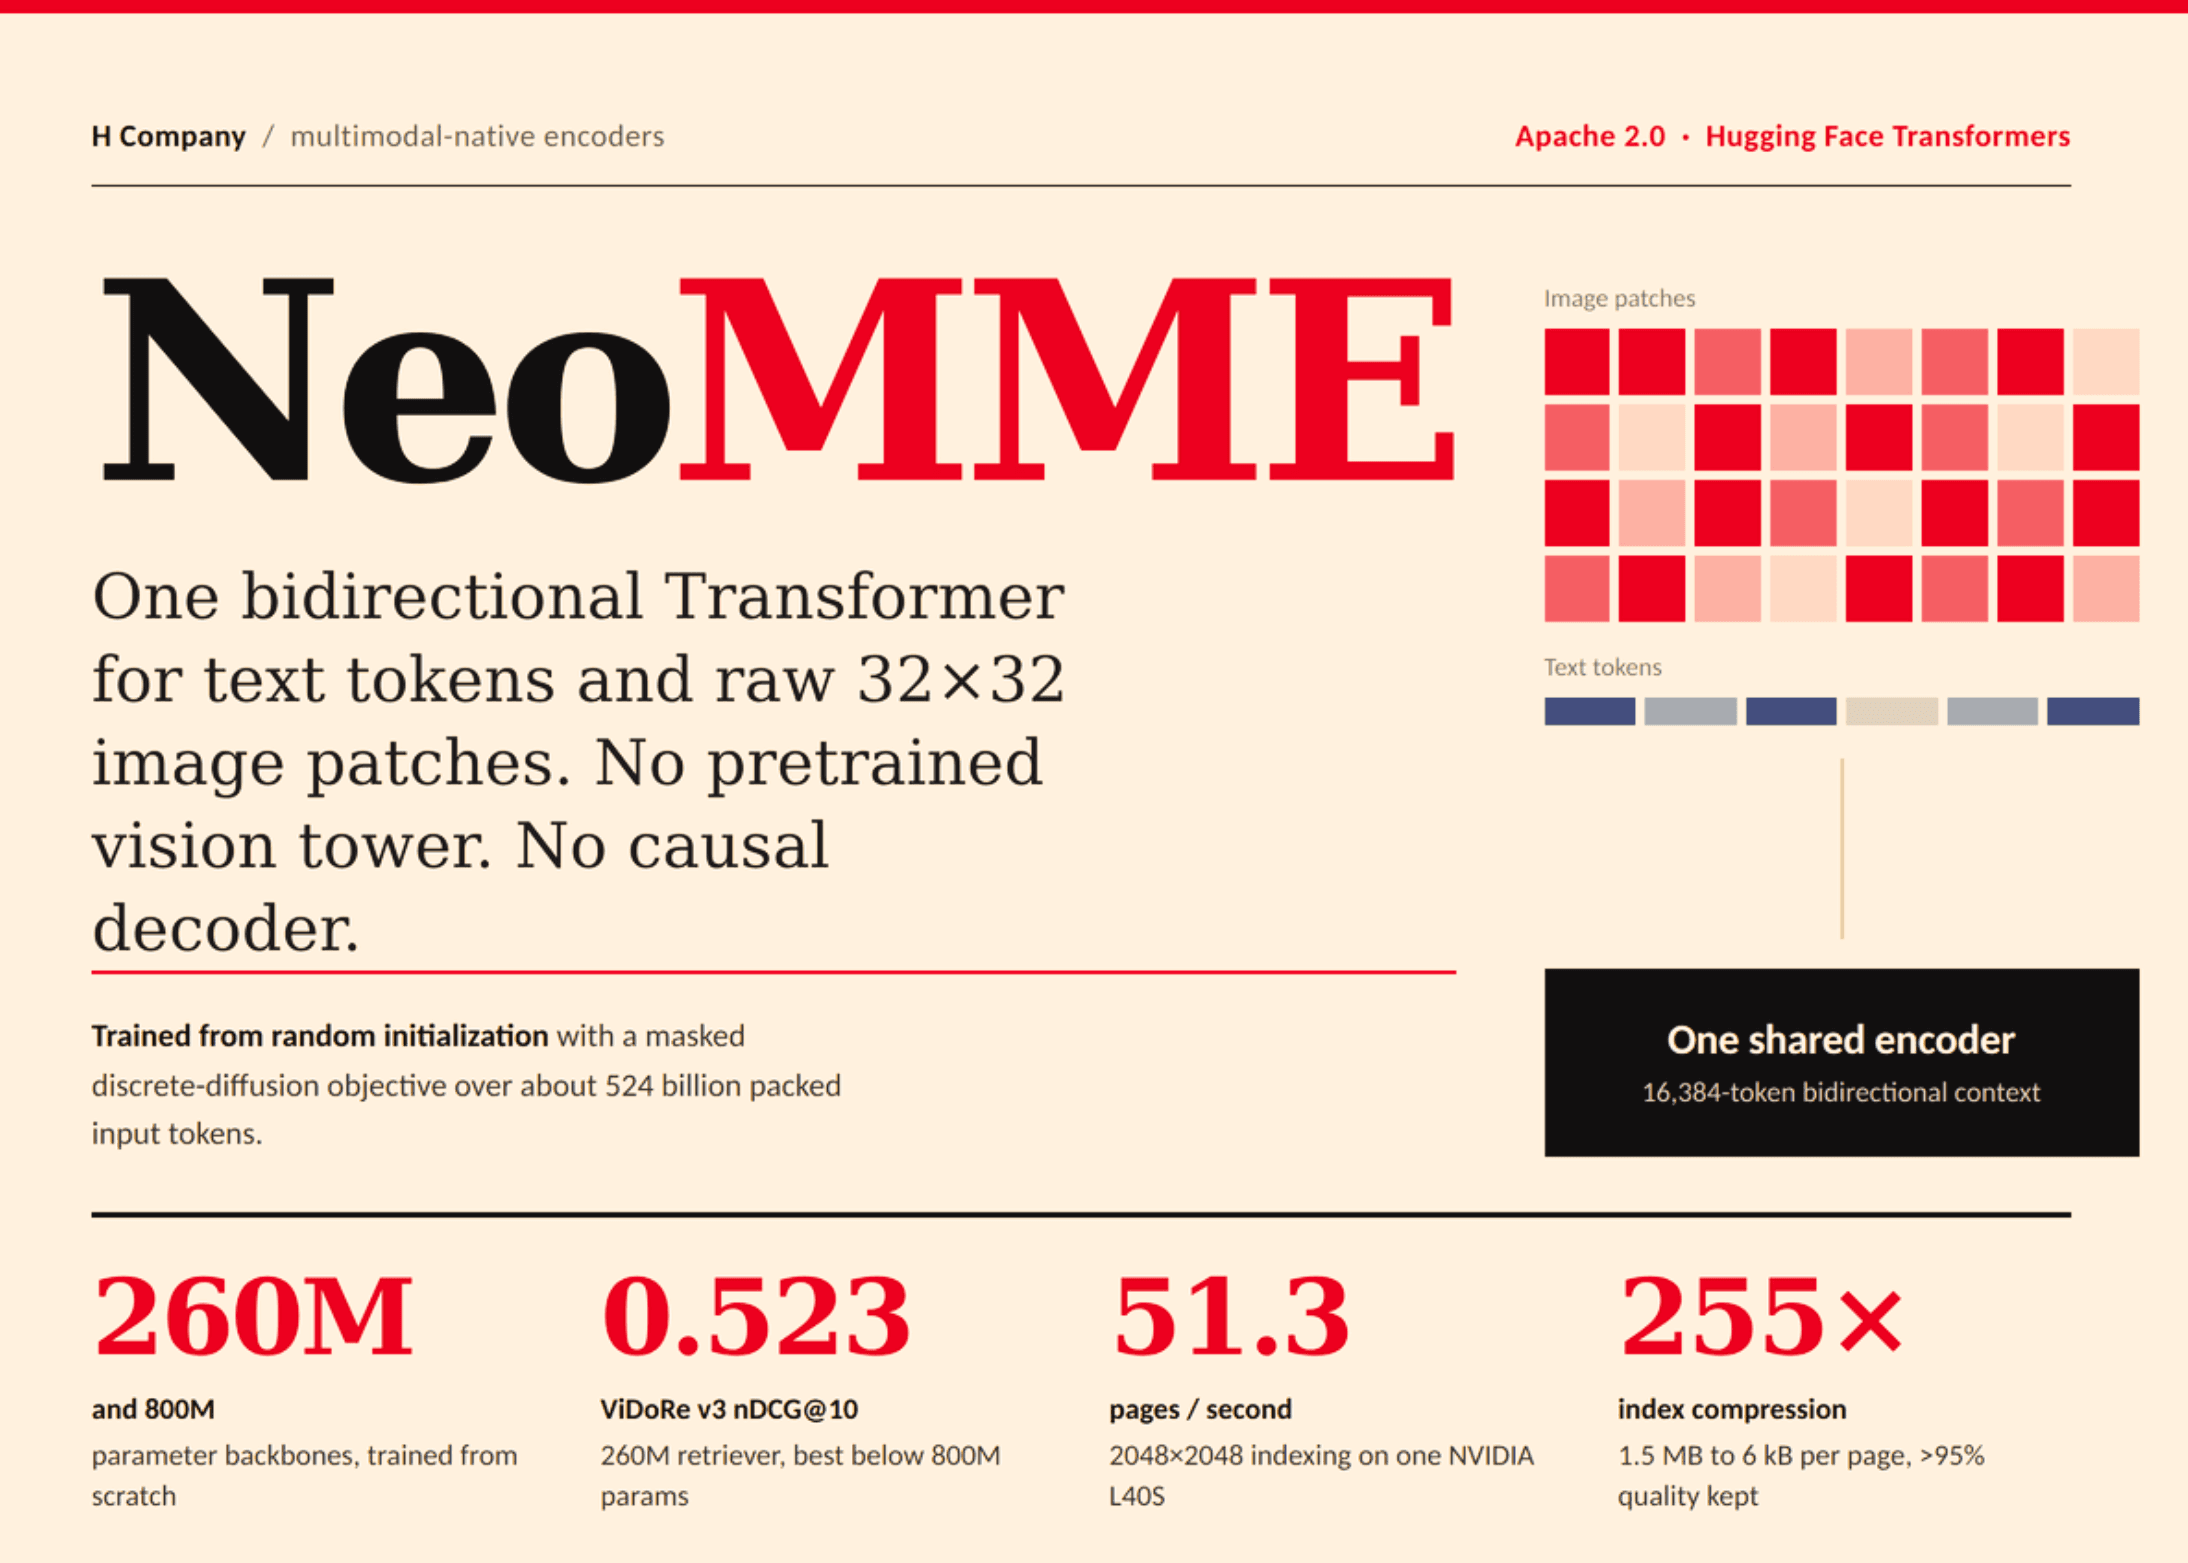
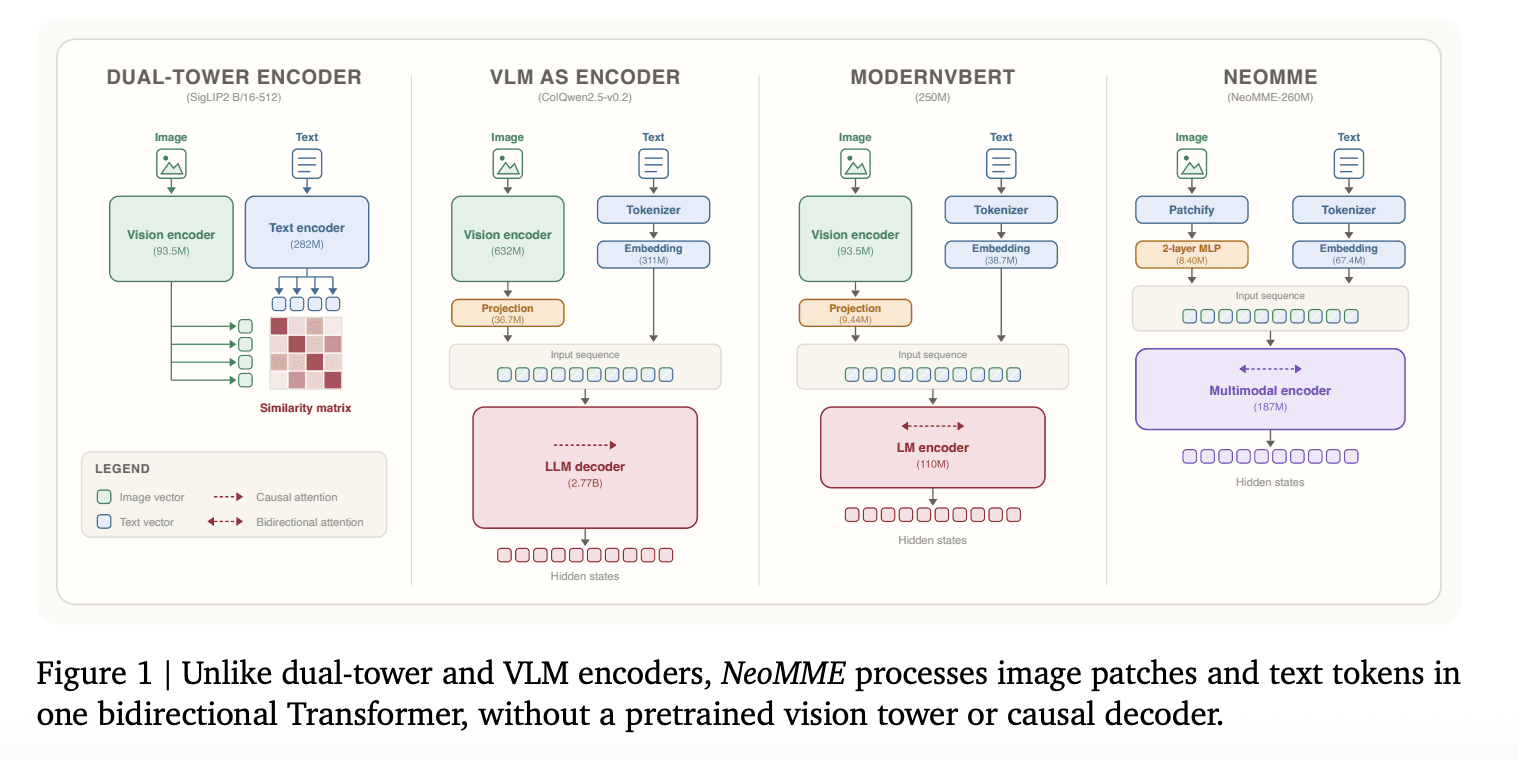
ระบบดึงข้อมูลเอกสารภาพ (visual document retrievers) ส่วนใหญ่ในปัจจุบัน มักเป็นการดัดแปลงโมเดล ColPali หรือนำโมเดล generative vision-language มาใช้เป็น encoder ทำให้ยังต้องแบกภาระจาก vision tower และ causal decoder ที่ไม่ได้ใช้งานจริง ซึ่งส่งผลเสียต่อประสิทธิภาพด้านพารามิเตอร์และการคำนวณในงานที่ต้องการเพียงการแสดงแทนข้อมูล (representations)
H Company จึงได้เปิดตัว NeoMME ซึ่งเป็นตระกูล bidirectional encoders ขนาด 260M และ 800M ที่ตัดองค์ประกอบส่วนเกินเหล่านั้นออกไป โดยใช้ Transformer เพียงตัวเดียวประมวลผลทั้งข้อความหลายภาษาและภาพ RGB ดิบขนาด 32×32 ผ่านเลเยอร์เดียวกัน ซึ่งโมเดล NeoMME-Retriever รุ่น 260M สามารถทำคะแนน nDCG@10 ได้ถึง 0.523 บน ViDoRe v3
โมเดลนี้พร้อมใช้งานจริงภายใต้สัญญาอนุญาต Apache 2.0 และรองรับใน Hugging Face Transformers ทันที โดยรุ่น 260M สามารถทำดัชนีข้อมูลได้เร็วถึง 51.3 หน้าต่อวินาทีบน NVIDIA L40S เพียงตัวเดียว และใช้เวลาเข้ารหัสคำค้นหาเพียง 78.3 ms เมื่อทำงานบน CPU
https://arxiv.org/pdf/2609.01657
หนึ่ง Tower สอง Modalities
โครงสร้างของ NeoMME ใช้การฝังตัวข้อความแบบแยกองค์ประกอบ (factorized embedding) สไตล์ ALBERT ส่วนรูปภาพจะถูกแบ่งเป็น patch ขนาด 32×32 และฉายผ่าน MLP แบบ 2 เลเยอร์ที่ฝึกใหม่ทั้งหมด โดยไม่มีโมดูล patch-merging หรือ SigLIP2 tower เข้ามาเกี่ยวข้อง
โมเดลรองรับ context สูงสุด 16,384 token ซึ่งเพียงพอสำหรับภาพความละเอียด 4K UHD จำนวน 2 ภาพ ตัวสถาปัตยกรรมใช้เทคโนโลยีสมัยใหม่ครบครัน ทั้ง grouped-query attention, gated attention และ 2D rotary position embeddings โดยรุ่น 260M มีพารามิเตอร์จริงอยู่ที่ 262,937,906 และรุ่น 800M อยู่ที่ 793,715,032 พารามิเตอร์
ในส่วนของ Tokenizer ใช้แบบ BPE ที่รองรับ 131,072 รายการ ซึ่งจากการทดสอบใน 14 ภาษาผ่าน FLORES-200 พบว่าสามารถสร้าง token ได้มีประสิทธิภาพกว่า ModernBERT ถึง 44.4%
ฝึกฝนในฐานะ masked diffusion denoiser
การฝึกล่วงหน้าใช้เทคนิค discrete masked diffusion โดยกำหนดเงื่อนไขตามภาพที่มองเห็น และสุ่มอัตราความเสียหายของข้อความเพื่อบังคับให้โมเดลต้องเรียนรู้ข้อมูลจากหน้าเอกสารจริง ช่วยกำจัดปัญหาการใช้ทางลัดจากภาษาเพียงอย่างเดียว (language-only shortcut)
ผลการทดสอบยืนยันว่าวิธีนี้ได้ผลดีเยี่ยม โดยการมองเห็นหน้าเอกสารช่วยเพิ่มความแม่นยำในการคาดเดา token ที่ถูกปิดไว้ได้ถึง 38-40 จุด การฝึกฝนนี้ใช้ข้อมูลมหาศาลกว่า 5.24 แสนล้าน token บนระบบประมวลผล H100 จำนวน 16 ถึง 32 ตัว
ผลลัพธ์การดึงข้อมูล
NeoMME-Retriever มาพร้อมหัวดึงข้อมูลสองแบบคือ dense head และ late-interaction head ซึ่งทำงานร่วมกันในการประมวลผลเพียงครั้งเดียว บน ViDoRe v3 รุ่น 260M ทำคะแนนได้สูสีกับ ColQwen2.5-v0.2 ที่มีขนาดใหญ่กว่าถึง 14 เท่า
อย่างไรก็ตาม การดึงข้อมูลแบบข้อความล้วนยังเป็นจุดที่ต้องพัฒนา โดยบน BEIR-15 ระบบทำคะแนนได้ 0.48-0.51 ตามหลัง LateOn ซึ่งผู้พัฒนาชี้แจงว่าเป็นเพราะขนาดของข้อมูลที่ใช้ฝึกสอนในส่วนของข้อความยังมีปริมาณน้อยกว่าเมื่อเทียบกับโมเดลคู่แข่ง
พื้นที่จัดเก็บและความเร็ว
จุดเด่นสำคัญคือการประหยัดพื้นที่จัดเก็บดัชนี (index) โดยปกติหน้าเอกสารหนึ่งหน้าจะใช้พื้นที่ 1.5 MB แต่เมื่อใช้เทคนิค Hierarchical token pooling ร่วมกับการทำ quantization แบบ binary จะสามารถลดขนาดเหลือเพียง 6.0 kB ต่อหน้า หรือลดลงถึง 255.5 เท่า โดยที่ยังคงประสิทธิภาพการทำงานไว้ได้กว่า 95%
ด้านความเร็วในการประมวลผล NeoMME-260M ทำได้เหนือกว่า ColModernVBERT ถึง 1.97 เท่า ในการจัดการอินพุตความละเอียดสูง ซึ่งพิสูจน์ให้เห็นว่าการออกแบบสถาปัตยกรรมที่เรียบง่ายแต่ตรงจุดสามารถสร้างความแตกต่างได้อย่างมหาศาตุ
Interactive explainer
ประเด็นสำคัญ
- ใช้ Transformer แบบ bidirectional ตัวเดียวจัดการทั้งข้อความและภาพโดยไม่ต้องพึ่ง vision tower หรือ decoder
- รุ่น 260M ทำคะแนนชนะทุกโมเดลในกลุ่มขนาดต่ำกว่า 800M บน ViDoRe v3
- ให้ประสิทธิภาพใกล้เคียงโมเดลขนาด 3.75B ในขณะที่มีขนาดเล็กกว่าถึง 14.4 เท่า
- เทคนิค Token pooling และ quantization ช่วยลดขนาดดัชนีจาก 1.5 MB เหลือเพียง 6 kB ต่อหน้า
- จุดที่ต้องพัฒนาต่อคือการดึงข้อมูลข้อความล้วนและการปรับใช้กับภาพถ่ายธรรมชาติที่ยังคงเป็นจุดอ่อน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร