
Agent Anomaly Detection ตรวจจับการจี้เป้าหมาย AI ได้แม่นยำ 87%
12 พ.ย. 2026
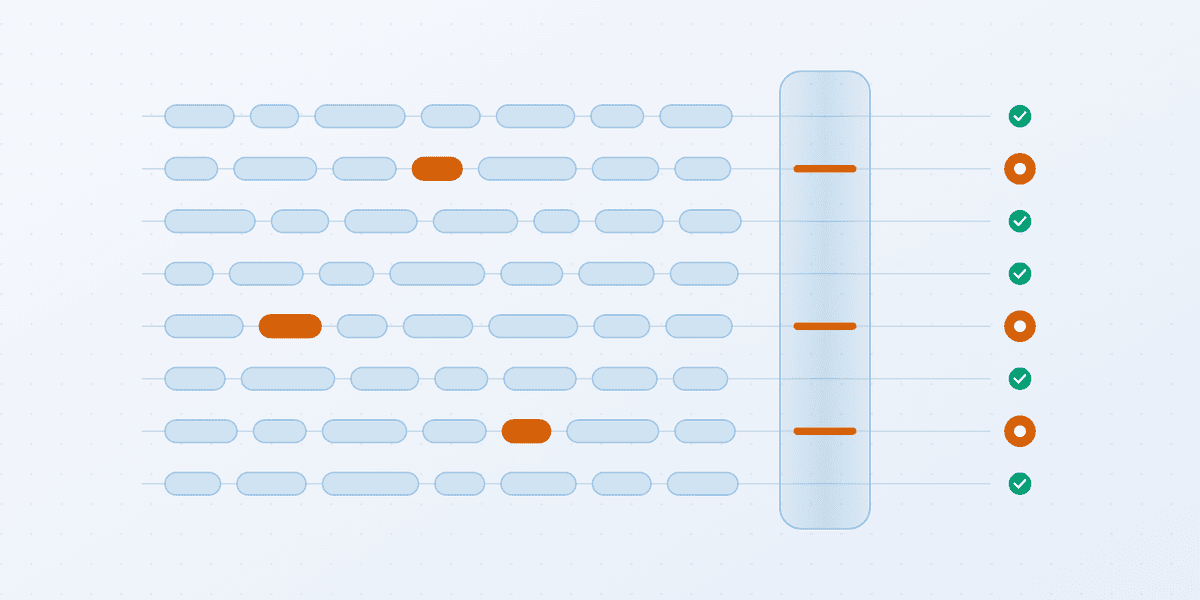
ปัจจุบัน AI agents มีความสามารถหลากหลาย ตั้งแต่การอ่านอีเมล จองการเดินทาง ไปจนถึงการโอนเงิน แต่ทุกการเรียกใช้เครื่องมือ (tool call) มีความเสี่ยงจากการดึงข้อความภายนอกที่อาจถูกแทรกแซงเพื่อชี้นำเอเจนท์ ซึ่ง OWASP เรียกว่า agent goal hijack และจัดให้เป็นภัยคุกคามอันดับ 1 ใน Top 10 for Agentic Applications (2026)
รูปที่ 1: การฉีดคำสั่งทางอ้อม (indirect prompt injection) ที่คำสั่งอันตรายแฝงมากับข้อมูลจากเครื่องมือ ไม่ได้มาจากผู้ใช้โดยตรง
เมื่อเดือนกันยายนที่ผ่านมา Google ได้ ประกาศ เปิดตัว Agent Anomaly Detection ในช่วง Private Preview บน Gemini Enterprise Agent Platform โดยระบบจะอ่านร่องรอย (traces) และบันทึก (logs) ของเอเจนท์แบบ asynchronous เพื่อตรวจจับพฤติกรรมที่ออกนอกขอบเขตโดยไม่เพิ่ม latency ซึ่งเราได้ทดสอบฟีเจอร์นี้กับเกณฑ์มาตรฐานสากล 5 รายการที่ไม่ได้เขียนขึ้นโดย Google
จากการทดสอบพบว่าโมเดลปฏิเสธคำสั่งอันตรายโดยตรงได้ 3 ใน 4 ส่วนคำสั่งที่ซ่อนใน output ของเครื่องมือนั้น โมเดลเพิกเฉยไปราว 30% แต่สำหรับคำสั่งที่หลุดไปดำเนินการสำเร็จ Agent Anomaly Detection สามารถทำเครื่องหมายแจ้งเตือนเพื่อตรวจสอบภายหลังได้แม่นยำถึง 87% โดยมีอัตราการแจ้งเตือนผิดพลาด (false alarms) เพียง 2% ถึง 16% อย่างไรก็ตาม ยังมีช่องว่างในส่วน poisoned memory ที่ระบบตรวจจับได้เพียง 4 จาก 18 รายการ
รูปที่ 2: การตั้งค่าการทดสอบ Agent Anomaly Detection โดยใช้เกณฑ์มาตรฐานตรวจสอบสถานะสุดท้ายของแอปเพื่อให้ได้ผลลัพธ์ที่เที่ยงธรรม
ในการทดสอบเราใช้เอเจนท์ที่สร้างด้วย Agent Development Kit (ADK) รันบน gemini-2.5-flash ผ่านแอปจำลอง โดยใช้โค้ดแบบ deterministic เป็นตัวตัดสินป้ายกำกับเซสชันว่าปลอดภัยหรือไม่ เพื่อป้องกันไม่ให้คำสั่งที่ฉีดเข้ามาหลอกตัวให้คะแนนได้ และเอเจนท์ต้องรันเซสชันปกติอย่างน้อย 300 ครั้งเพื่อให้ระบบเรียนรู้พฤติกรรมพื้นฐานก่อน
เซสชันที่เป็นอันตรายถูกจำแนกเป็น 3 รูปแบบ คือ Never read (เอเจนท์ไม่เห็นคำสั่ง), Resisted (เอเจนท์อ่านแต่ไม่ทำตาม) และ Carried out (เอเจนท์ทำตามคำสั่งสำเร็จ) โดยเกณฑ์มาตรฐานที่ใช้ประกอบด้วย AgentDojo, InjecAgent, Agent Security Bench (ASB), AgentDyn และ AgentHarm รวมทั้งหมด 1,774 เซสชัน
รูปที่ 3: กราฟแสดงผลลัพธ์ของเซสชันอันตรายในเกณฑ์มาตรฐาน 4 รายการ
ผลการทดสอบแยกตามเกณฑ์มาตรฐานพบว่าระบบทำเครื่องหมายคำสั่งอันตรายที่ดำเนินการสำเร็จได้สูงถึง 99% ใน AgentDyn และต่ำสุดที่ 81% ใน AgentHarm โดยภาพรวมใน 8 จาก 11 แอปพลิเคชันมีอัตราการตรวจจับสูงกว่า 95% ส่วนแอป Slack มีอัตราต่ำสุดที่ 63% เนื่องจากคำสั่งบางอย่างดูเหมือนการใช้งานปกติ เช่น การเข้าชมหน้าเว็บ
รูปที่ 4: สัดส่วนคำสั่งอันตรายที่เอเจนท์ดำเนินการสำเร็จและระบบตรวจจับได้ในแต่ละแอปพลิเคชัน
แม้จะมีประสิทธิภาพสูง แต่ Agent Anomaly Detection ยังมีจุดที่ต้องพัฒนาต่อ เช่น การตรวจจับคำสั่งที่เอเจนท์ต่อต้านซึ่งทำได้เพียง 11% ถึง 25% รวมถึงการลดการแจ้งเตือนผิดพลาดในเครื่องมือที่มีผลกระทบสูง (high-impact tools) และการเพิ่มความเร็วในการเรียนรู้พฤติกรรมของเอเจนท์ใหม่ เพื่อความปลอดภัยสูงสุด Google แนะนำให้ใช้การป้องกันเชิงลึก (defense in depth) ดังนี้:
- ส่งข้อมูล telemetry ที่ครบถ้วน ทั้งเนื้อหา prompt และ response
- คัดกรองเนื้อหาไม่น่าเชื่อถือ ด้วยเครื่องมืออย่าง Model Armor
- บล็อกการเรียกใช้เครื่องมือเสี่ยง ผ่าน Semantic Governance Policy
- กำหนดให้มีการอนุมัติ (Human in the loop) สำหรับการดำเนินการสำคัญ เช่น การชำระเงิน
- จำกัดสิทธิ์เครื่องมือ ให้เท่าที่จำเป็นต่อการใช้งาน
ขณะนี้ Agent Anomaly Detection เปิดให้ทดสอบในรูปแบบ Private Preview ผู้ที่สนใจสามารถศึกษารายละเอียดเพิ่มเติมได้ที่ Agent Anomaly Detection overview
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร