
LLMON ภาษา Markup แบบ Native ใหม่ล่าสุดสำหรับ Granite 4.1
LLM จำเป็นต้องพึ่งพาบริบท (context) เพื่อสร้างชุด token ถัดไป แต่เมื่อผ่านการใช้งานที่ยาวนาน บริบทเหล่านั้นมักเต็มไปด้วยข้อมูลหลายประเภทที่ปะปนกัน ทั้งบทสนทนาเก่า ข้อมูลที่ดึงมา และข้อกำหนดต่างๆ ซึ่งส่วนใหญ่ถูกเข้ารหัสในรูปแบบ JSON ที่ไม่ได้ออกแบบมาเพื่อให้ LLM ย่อยข้อมูลได้ง่าย
ปัญหานี้ทำให้ LLM โดยเฉพาะรุ่นขนาดเล็กมีความเปราะบางและอาจเกิดความผิดพลาดที่ไม่คาดคิด รวมถึงการขาดโครงสร้างที่ชัดเจนยังเปิดช่องโหว่ให้ผู้ไม่หวังดีทำการโจมตีในรูปแบบ prompt injections ได้ เพื่อแก้ไขข้อจำกัดดังกล่าว เราจึงได้พัฒนา LLMON (LLM Object Notation ออกเสียงว่า "เลมอน") ซึ่งเป็นภาษา markup แบบ LLM-native เพื่อสื่อสารโครงสร้างและอรรถศาสตร์ (semantics) ไปยังโมเดลอย่างชัดเจน โดยใช้ special-token ที่สำรองไว้เป็นตัวคั่น ช่วยให้โมเดลระบุโครงสร้างข้อมูลและการซ้อนกัน (nesting) ได้อย่างไม่คลุมเครือ เปรียบได้กับการเรียกใช้ฟังก์ชันและส่ง argument ในภาษาโปรแกรม
วันนี้เรากำลังเปิดตัวโมเดลรุ่น experimental preview สองรุ่นที่ต่อยอดจาก Granite 4.1 base models ได้แก่ granite-4.1-3b-LLMON-preview และ granite-4.1-8b-LLMON-preview พร้อมกับปล่อย GitHub repo ที่รวมเครื่องมือและตัวอย่าง workflow ไว้ให้ใช้งาน
สิ่งที่ทำได้:
- ป้องกัน Indirect prompt injections ที่แฝงมากับข้อมูลผู้ใช้ได้เกือบ 100% ในบาง benchmark เนื่องจากโมเดลแยกคำสั่งออกจากข้อมูลอย่างเด็ดขาด
- ลดการดึงข้อความที่ไม่เกี่ยวข้องหรือบทสนทนาเก่ามาตอบคำถาม เพราะแต่ละคำสั่งจะถูกผูกไว้กับข้อมูลที่เจาะจงเท่านั้น
- รองรับการใช้งานร่วมกับ Mellea ซึ่งช่วยทำ LLMONizing การเรียกใช้ LLM โดยอัตโนมัติ
- มีเครื่องมือแปลง JSON เป็น LLMON ได้โดยไม่สูญเสียข้อมูล และรองรับการ tune LoRA เพื่อกำหนด tag เฉพาะทางตามความต้องการ
ทำไมไม่ใช่ JSON?
JSON ถูกออกแบบมาเพื่อ parser ไม่ใช่สำหรับ causal language models เนื่องจากตัว tokenizer ไม่ได้ถูกจำกัดให้เคารพไวยากรณ์ของ JSON ทำให้เครื่องหมายต่างๆ เช่น อัญประกาศหรือวงเล็บ อาจถูกโมเดลตีความผิดพลาดได้ง่าย โดยเฉพาะในโครงสร้างที่ซ้อนกันลึกๆ
ในทางกลับกัน LLMON ใช้ลักษณะที่คล้าย XML แต่ใช้ special token เป็นตัวคั่นโครงสร้างแทนตัวอักษรปกติ ทำให้โครงสร้างและเนื้อหาใช้ vocabulary ที่แยกจากกันชัดเจน โมเดลจึงไม่ต้องคอยติดตามลำดับชั้นที่ซับซ้อนในระยะยาว ทั้งนี้เรายังมี conversion tools เพื่อช่วยแปลงข้อมูลระหว่าง JSON และ LLMON ให้ทำงานได้สะดวกขึ้น
LLMON เกี่ยวข้องกับ chat templates อย่างไร?
LLMON ไม่ได้มาแทนที่ chat templates แต่เข้ามาช่วยเสริมความแข็งแกร่ง โดยจะระบุว่าแต่ละองค์ประกอบมีความสัมพันธ์กันอย่างไร โมเดลรุ่น preview นี้มาพร้อม chat template ของตัวเอง ซึ่งสามารถใช้งานผ่าน apply_chat_template ได้ตามปกติ
ความแตกต่างคือในหนึ่ง turn สามารถระบุส่วนต่างๆ และกำหนดค่า exec เป็น True หรือ False ได้ โดยส่วนที่เป็น True จะถูกนำไปประมวลผลใน block exec ด้านล่างของ output เพื่อระบุว่าต้องรันคำสั่งใดกับข้อมูลชุดไหน ดังตัวอย่างโค้ดนี้:
messages = [ { "role": "user",
"instruction": [{ "value": "Write a short paragraph about", "exec": True }],
"data": [{ "value": "IBM Company", "exec": True }],
"requirement": [ {"value": "Use less than 10 words", "exec": True},
{"value": "Do not use commas", "exec": True}]
} ]
``` ซึ่งโมเดลจะได้รับข้อมูลในรูปแบบโครงสร้างที่มี tag กำกับชัดเจน ทำให้โมเดลไม่ต้องคาดเดาเองว่าส่วนใดคืองาน ส่วนใดคือข้อมูล หรือส่วนใดคือข้อจำกัด
### วิธีที่ LLMON จัดการกับการโจมตีแบบ prompt injection
Indirect prompt injection มักซ่อนคำสั่งอันตรายไว้ในข้อมูล เช่น เอกสารที่ดึงมาหรือผลลัพธ์จากเครื่องมือ จากการทดสอบด้วย benchmark [OPI](https://arxiv.org/abs/2310.12815) พบว่า LLMON มีความทนทาน (robustness) สูงกว่าโมเดลทั่วไปอย่างมาก
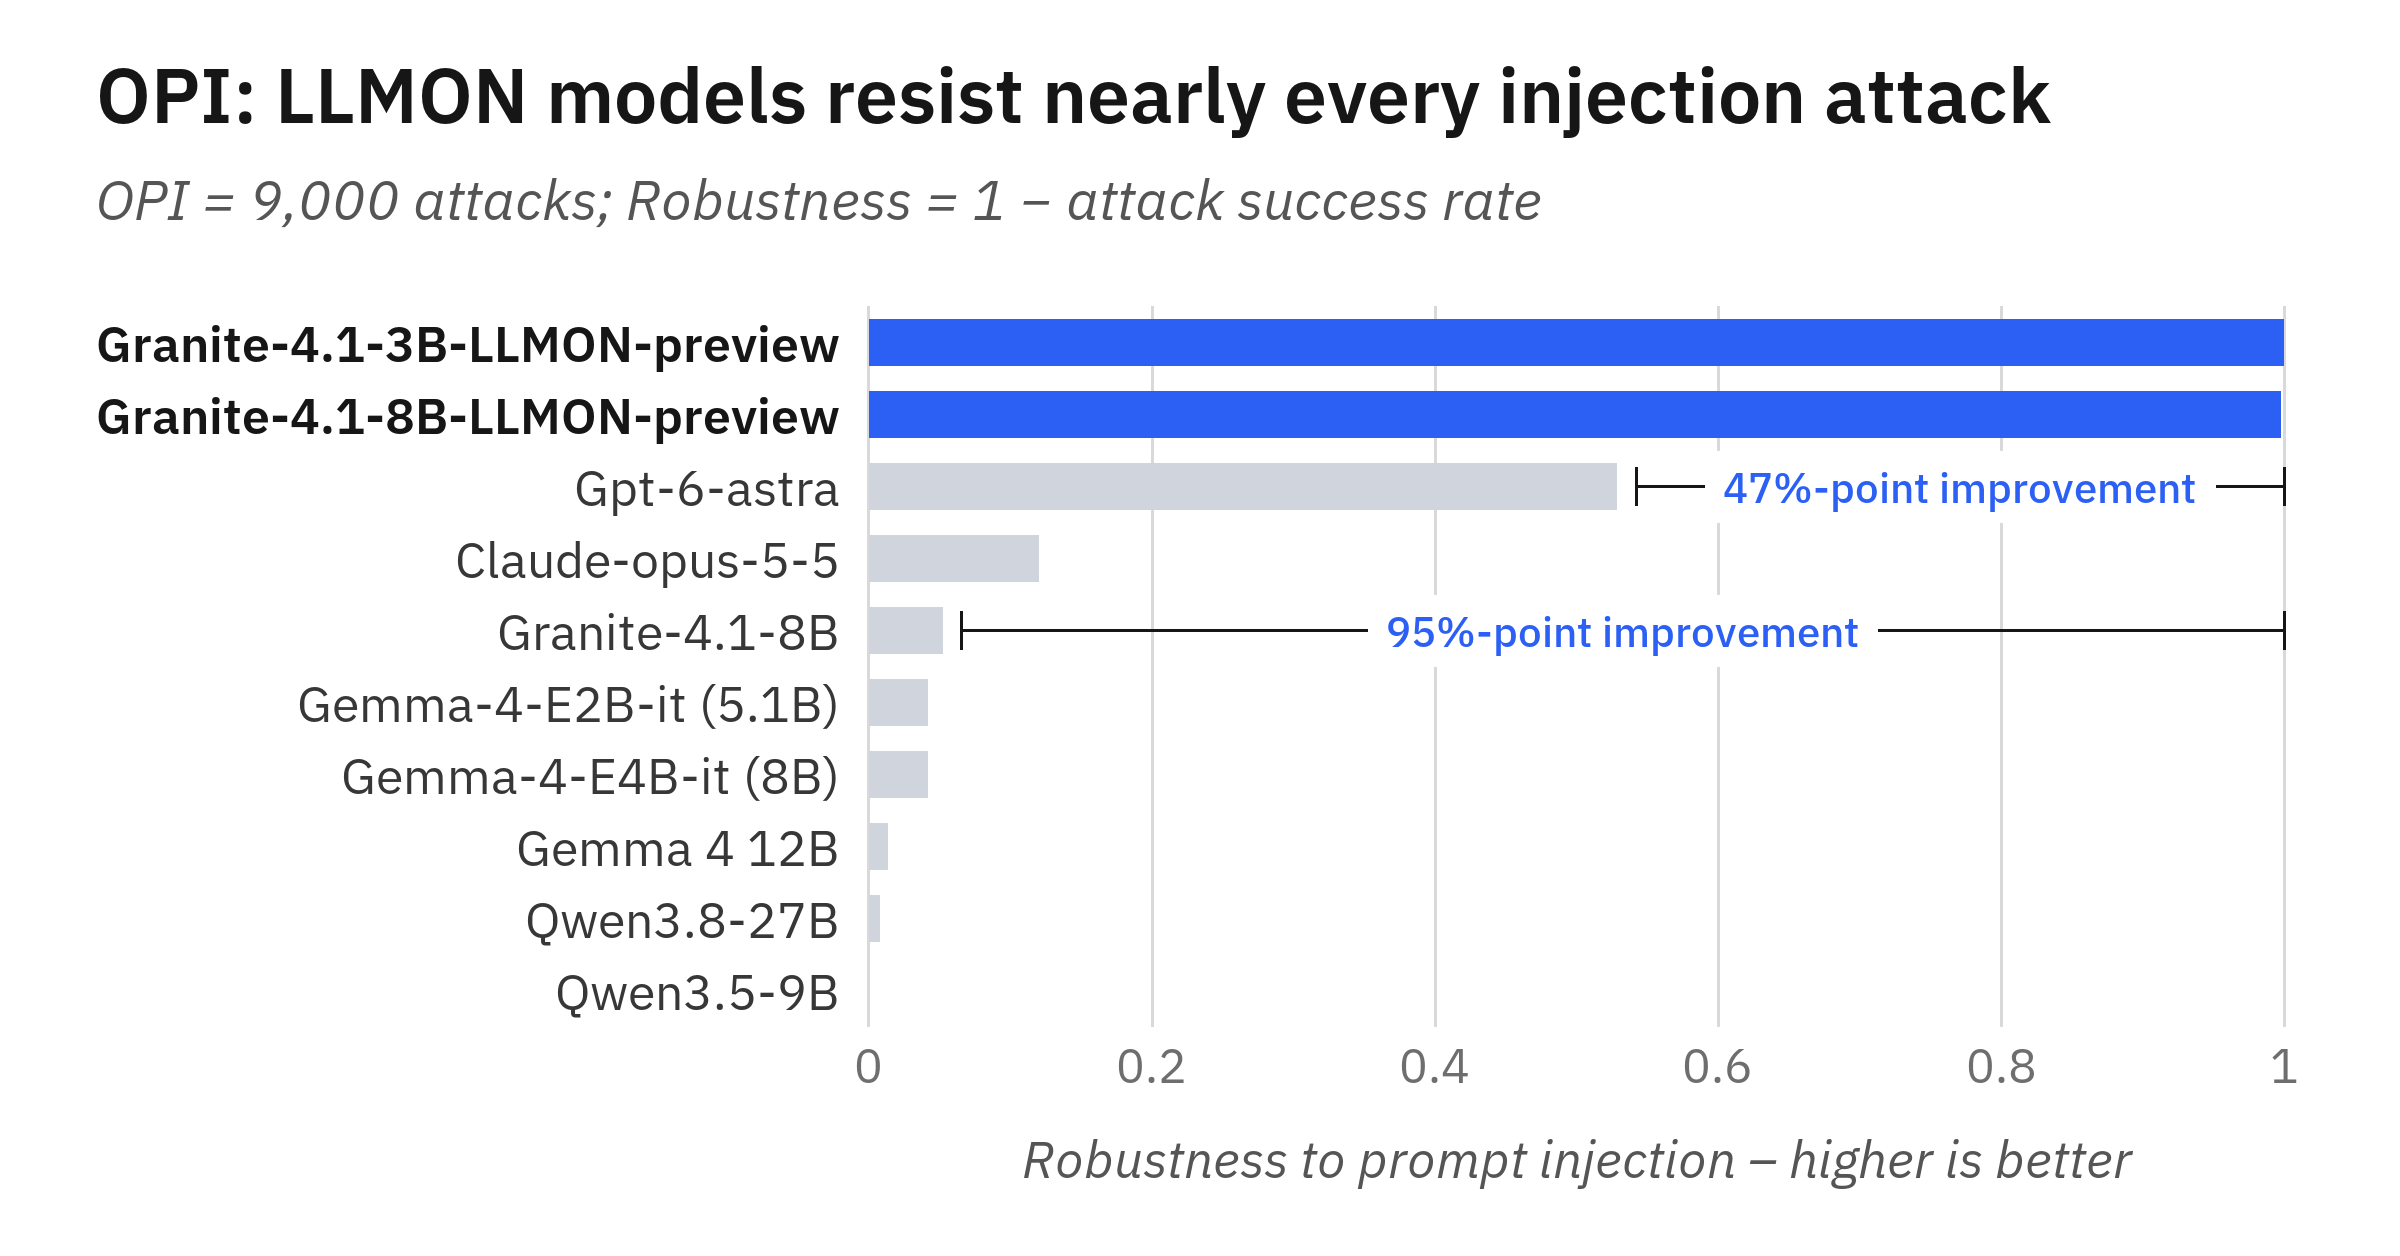
ขณะที่โมเดลทั่วไปมักหลงเชื่อคำสั่งที่ถูกฉีดเข้ามา แต่ LLMON สามารถหลีกเลี่ยงการโจมตีได้ดีกว่า frontier model ถึง 47% และดีกว่า open-source model ทั่วไปถึง 95% ซึ่งเรากำลังพัฒนาต่อยอดเพื่อป้องกันการโจมตีแบบ adaptive ที่อาจเกิดขึ้นในบทสนทนาหลาย turn
### ความสามารถทั่วไป
ความปลอดภัยที่เพิ่มขึ้นไม่ได้ทำให้ประสิทธิภาพลดลง ในการทดสอบมาตรฐาน LLMON ทำงานได้เทียบเท่ากับ Granite 4.1 Instruct models เดิมทุกประการ
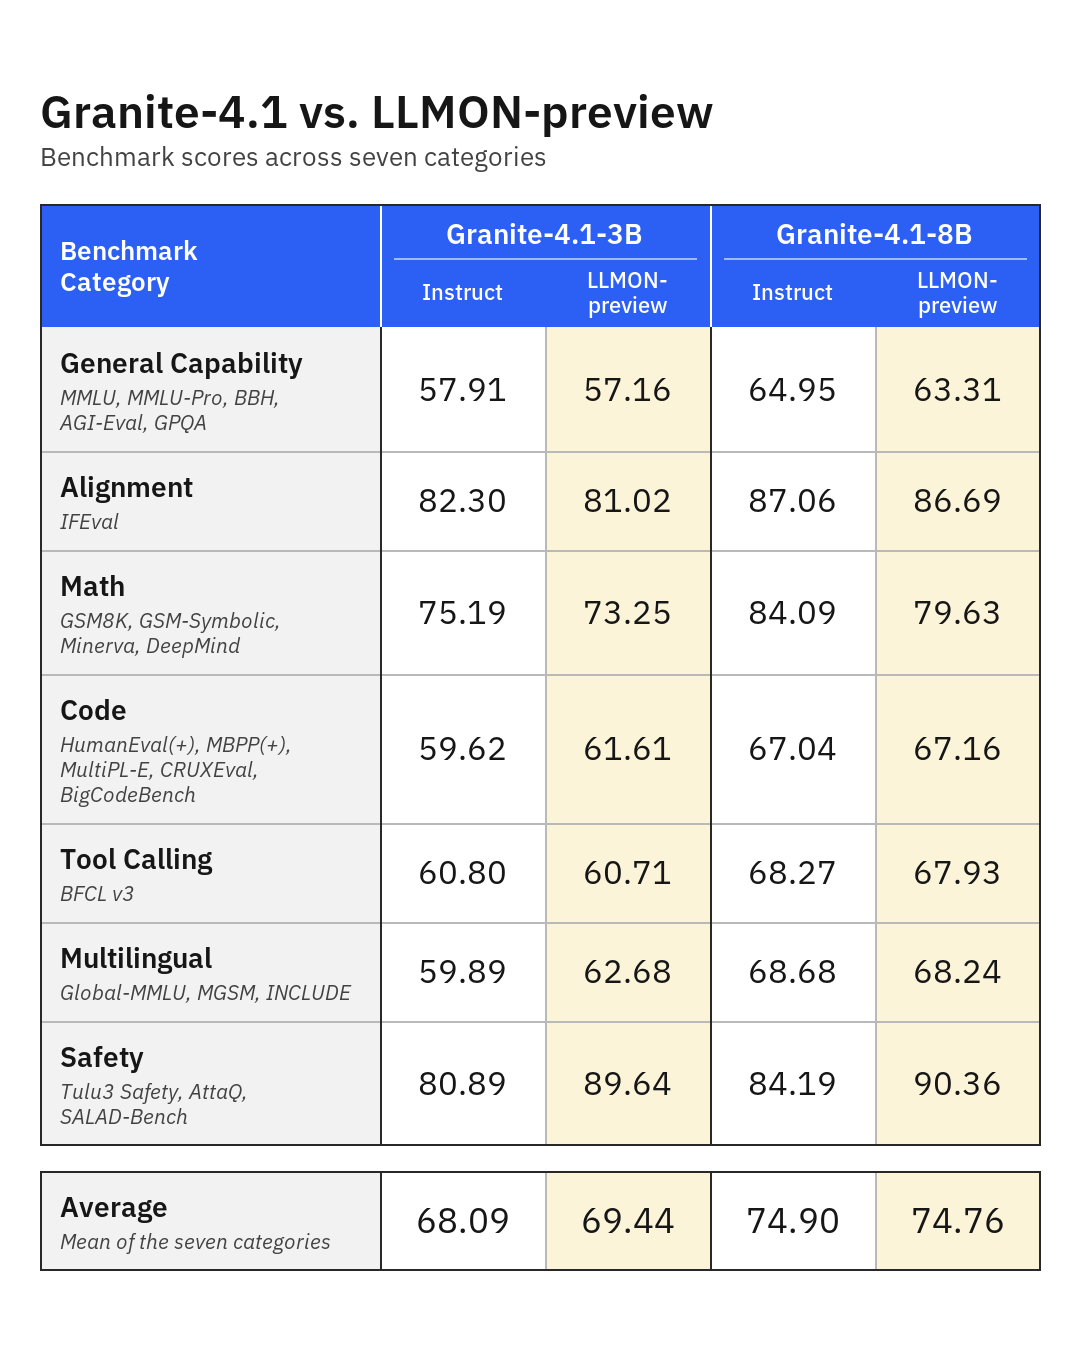
ผู้ที่ใช้งาน Granite 4.1 รุ่น 3B หรือ 8B อยู่แล้ว สามารถเปลี่ยนมาใช้ LLMON preview ได้ทันทีเพื่อความปลอดภัยที่สูงขึ้น โดยไม่จำเป็นต้องเปลี่ยน pipeline การทำงานทั้งหมด เพียงแค่ระบุชื่อส่วนต่างๆ ให้ชัดเจน chat template จะจัดการแปลงเป็น block LLMON ให้โดยอัตโนมัติ
### เราฝึกฝนโมเดลอย่างไร
เราเริ่มต้นฝึกจาก checkpoint ของ [Granite 4.1](https://huggingface.co/ibm-granite/granite-4.1-8b-base) base models โดยใช้กระบวนการ re-serialize คลังข้อมูลเดิมให้เป็นรูปแบบ LLMON เพื่อให้โมเดลเรียนรู้การทำตาม execution block และละเลยข้อมูลที่ไม่เกี่ยวข้อง
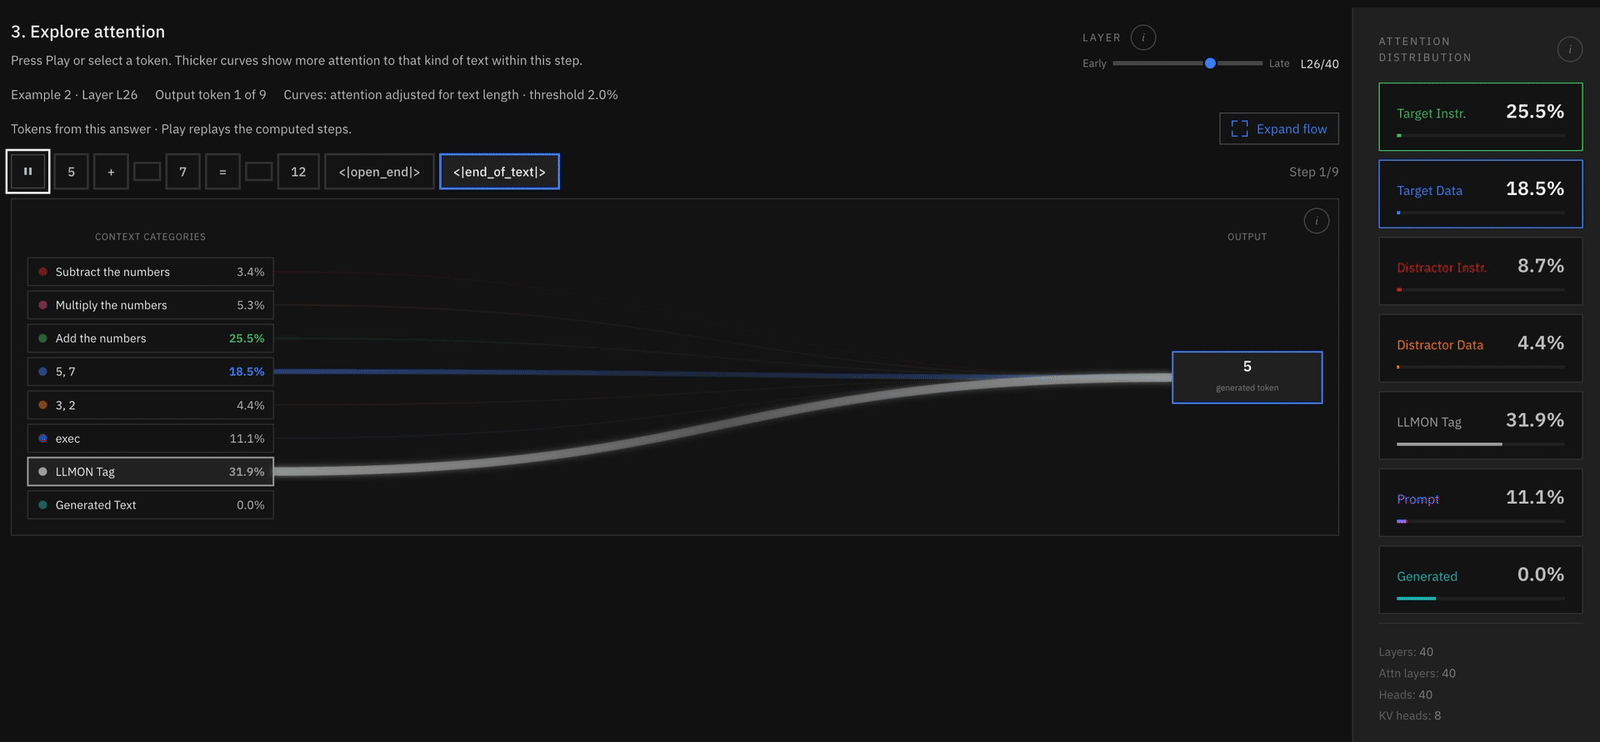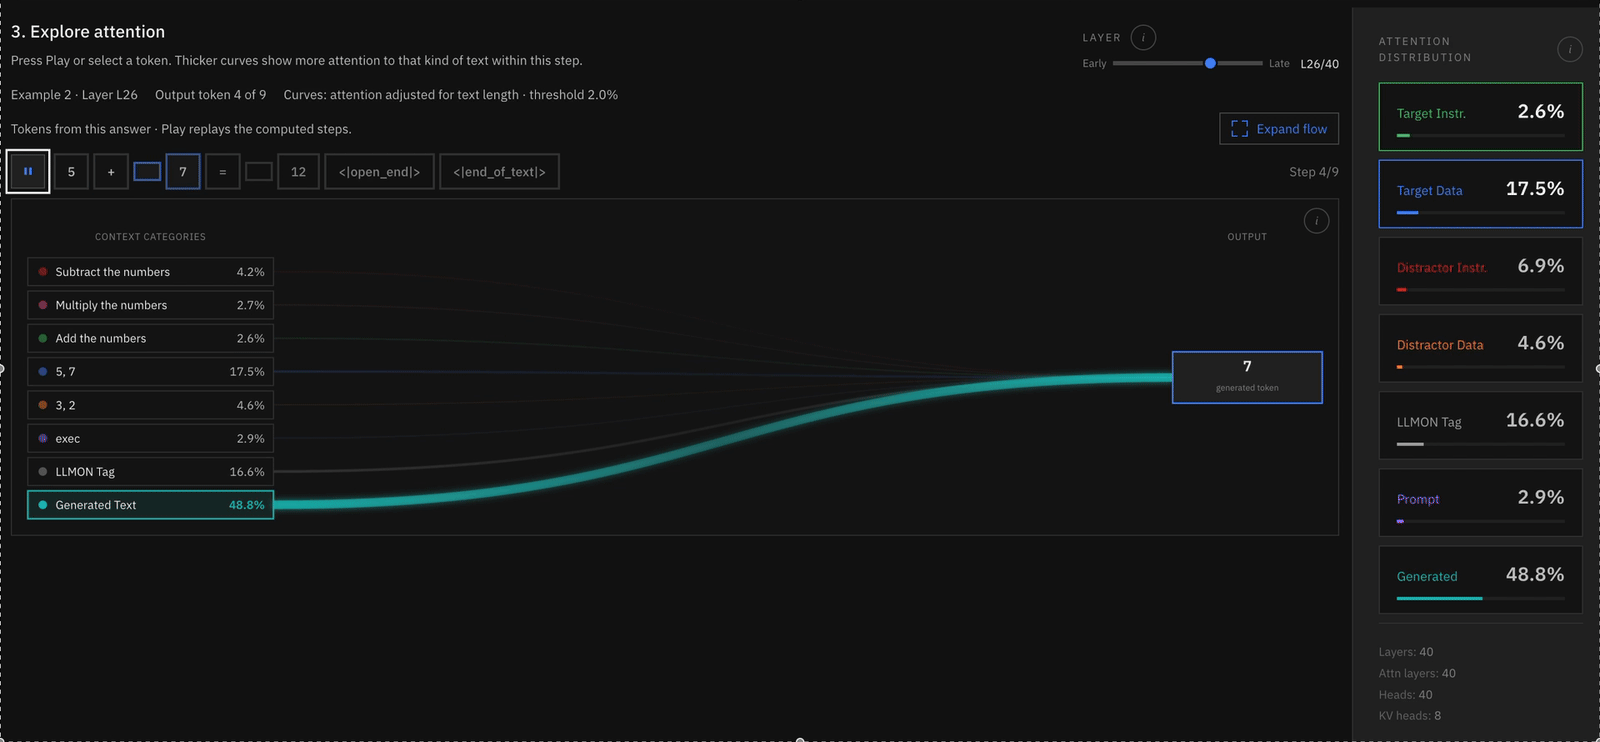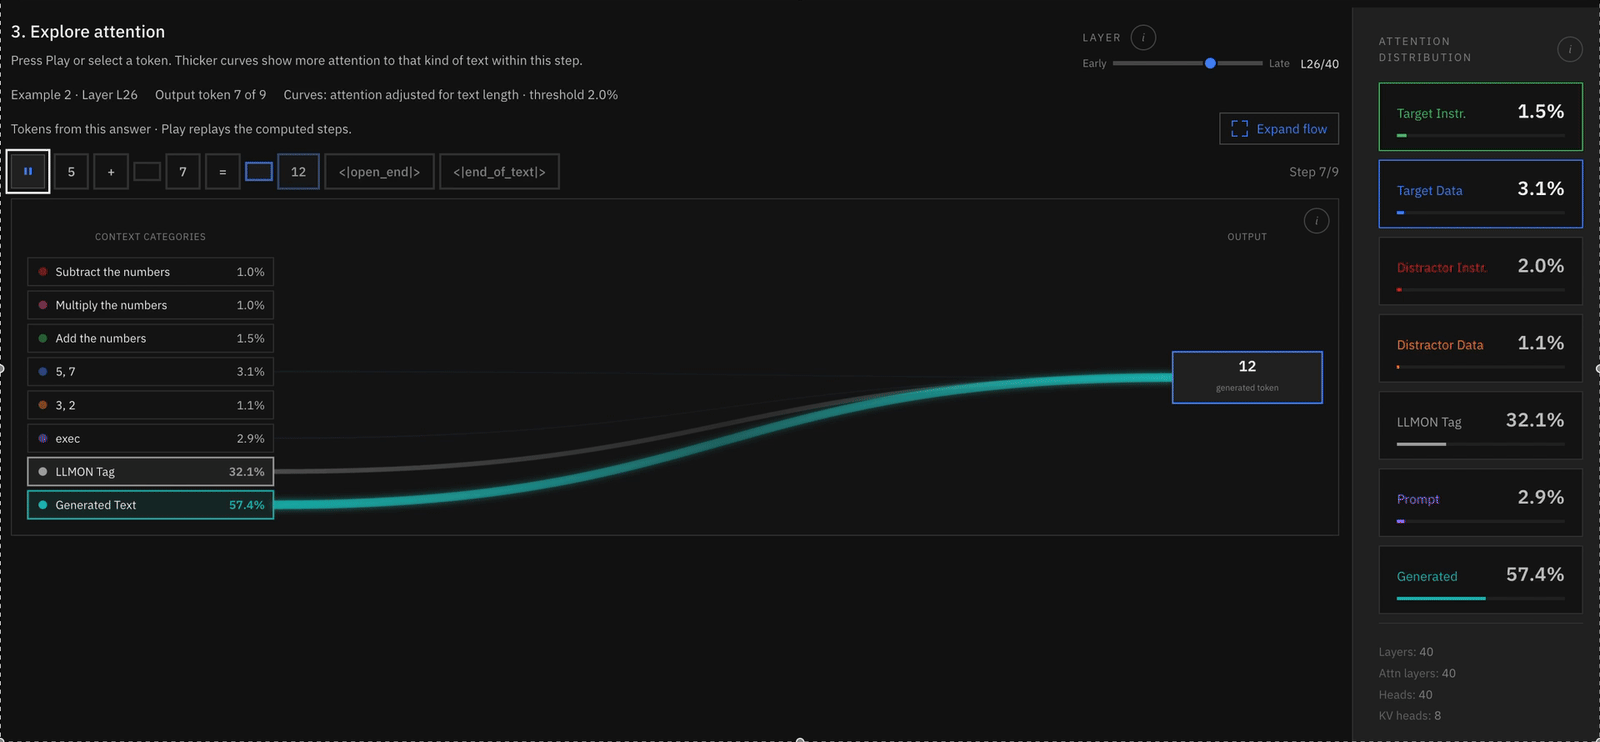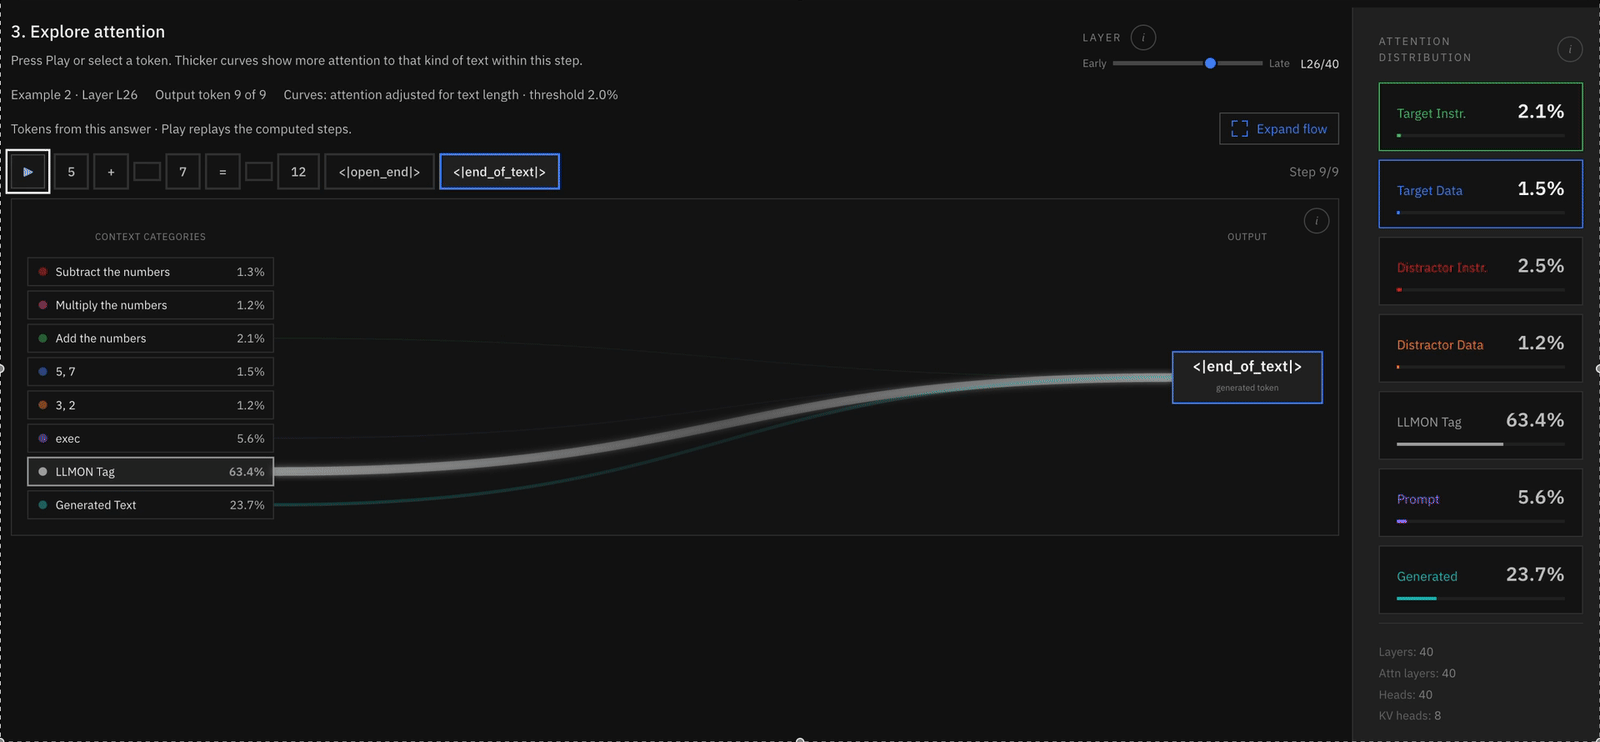
กระบวนการนี้รวมถึงการทำ reinforcement learning ด้วย GRPO 5 ขั้นตอน ครอบคลุมทั้งการให้เหตุผล, RLHF และคณิตศาสตร์ ปิดท้ายด้วย DPO เพื่อปรับปรุงการตอบสนองต่อการพยายามโจมตี ผลลัพธ์ที่ได้คือโมเดลจะมองคำสั่งใน execution block เป็นอำนาจหลัก (authoritative) ส่วนข้อมูลอื่นๆ จะถูกมองเป็นเพียงเนื้อหาสำหรับอ่านเท่านั้น หากต้องการดูการทำงานของ attention layers สามารถเข้าไปชมได้ที่ [LLMON Attention Visualization](https://huggingface.co/spaces/ibm-granite/LLMON-Attention-Visualization)
### นำ vocabulary ของคุณมาเอง (ScienceWorld)
LLMON มีความยืดหยุ่นสูง ผู้ใช้สามารถกำหนดชื่อ tag และโครงสร้างที่เหมาะกับโดเมนงานของตนเองได้ ดังเช่นการทดสอบใน ScienceWorld ที่เราได้กำหนด vocabulary เฉพาะทางเพื่อแก้ภารกิจวิทยาศาสตร์ และทำการ tune LoRA จนโมเดลสามารถดำเนินการตามขั้นตอนได้อย่างถูกต้อง สามารถศึกษาวิธีการได้จาก [notebook นี้](https://github.com/generative-computing/llmon/blob/main/llmon/examples/lora-finetuning/byo-vocab_LoRA_scienceworld.ipynb)
### ทดลองใช้ได้วันนี้
ปัจจุบันเป็นรุ่น experimental preview ที่เหมาะสำหรับการประเมินผล แต่ยังไม่แนะนำให้ใช้ในระดับ production
- Models: [3B-LLMON-preview](https://huggingface.co/ibm-granite/granite-4.1-3b-llmon-preview) & [8B-LLMON-preview](https://huggingface.co/ibm-granite/granite-4.1-8b-llmon-preview)
- Visualization Demo: [LLMON Attention Visualization](https://huggingface.co/spaces/ibm-granite/LLMON-Attention-Visualization)
- Repo: [LLMON](https://github.com/generative-computing/llmon) / [Mellea](https://github.com/generative-computing/mellea)
- Papers: [2610.38120](https://arxiv.org/abs/2610.38120), [2603.22519](https://arxiv.org/abs/2603.22519)ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร