
คู่มือประเมิน LLM ก่อนใช้งานจริง: ถอดบทเรียนจากระบบ Secret Scanning ของ GitHub
โมเดลภาษาขนาดใหญ่ (LLM) อาจทำคะแนนได้ดีเยี่ยมในเกณฑ์มาตรฐาน (Benchmark) ที่สะอาดหมดจด แต่เมื่อต้องเผชิญกับข้อมูลจริงในสภาพแวดล้อม Production กลับมักประสบปัญหาที่ไม่คาดคิด
แม้ชุดข้อมูลที่คัดสรรมาจะมีประโยชน์ในช่วงสร้างต้นแบบเพื่อเปรียบเทียบโมเดลหรือทดสอบ Prompt เบื้องต้น แต่เมื่อระบบขยับเข้าใกล้การใช้งานจริง โจทย์ของการประเมินจะเปลี่ยนไปทันที เนื่องจากข้อมูลนำเข้าจริงมักมีความคลุมเครือ บริบทขาดหาย หรือมีกรณีขอบเขต (Edge cases) ที่ไม่ปรากฏในเกณฑ์มาตรฐาน ซึ่งอาจกลายเป็นสาเหตุหลักของความล้มเหลวในระบบจริง
GitHub พบความท้าทายเหล่านี้ขณะพัฒนาระบบ LLM เพื่อลดผลบวกปลอม (False positives) ในฟีเจอร์ Secret Scanning ซึ่งทำหน้าที่ตรวจจับรหัสลับ เช่น Token หรือ Key ที่หลุดไปใน Repository การแจ้งเตือนที่ผิดพลาดทำให้นักพัฒนาเสียเวลา เราจึงต้องสร้างระบบประเมินที่มั่นใจได้ว่า LLM จะช่วยลดการแจ้งเตือนรบกวน โดยที่ยังคงความสามารถในการตรวจจับความเสี่ยง (Recall) ได้อย่างครบถ้วน
บทความนี้จะแบ่งปันแนวทางปฏิบัติที่ช่วยให้เราก้าวข้ามจากตัวต้นแบบไปสู่การใช้งานจริง ซึ่งสามารถประยุกต์ใช้ได้กับระบบ LLM ในทุกด้าน ตั้งแต่การวิเคราะห์โค้ด ความปลอดภัย ไปจนถึงการวิเคราะห์ข้อมูล
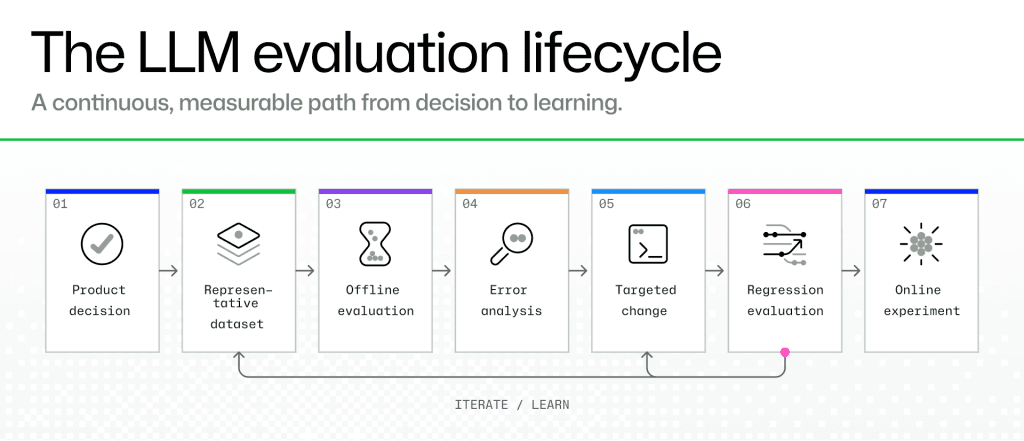
1. เริ่มต้นด้วยการตัดสินใจด้านผลิตภัณฑ์ ไม่ใช่ตัวโมเดล
เมื่อระบบ LLM ทำงานได้ไม่ดี สัญชาตญาณแรกของทีมมักเป็นการแก้ Prompt หรือเปลี่ยนโมเดล แต่สิ่งที่ควรทำก่อนคือการนิยามว่าเป้าหมายของผลิตภัณฑ์คืออะไร สำหรับระบบ Secret Scanning เราตั้งคำถามว่าระบบสามารถลดผลบวกปลอมได้โดยที่ยังรักษาความปลอดภัย (Recall) ในระดับที่ยอมรับได้หรือไม่
ในการทำงานจริง การหลุดรอดของรหัสลับส่งผลร้ายแรงกว่าการแจ้งเตือนเกิน ดังนั้น Precision และ Recall จึงไม่ใช่ตัวชี้วัดที่แทนกันได้โดยตรง เราจึงจัดระเบียบเกณฑ์การประเมินออกเป็น 3 ระดับ เพื่อให้เห็นภาพชัดเจนก่อนตัดสินใจทางธุรกิจ:
- ผลลัพธ์หลัก (Primary outcome): วัดประโยชน์ที่ผู้ใช้จะได้รับ เช่น การลดผลบวกปลอมและค่า Precision
- ข้อจำกัดด้านความปลอดภัย (Safety constraint): ป้องกันความเสี่ยงที่ยอมรับไม่ได้ เช่น ค่า Recall ที่ต้องไม่ลดลงจนอันตราย
- เกราะป้องกันการทำงาน (Operational guardrails): ดูความเหมาะสมในการใช้งานจริง เช่น Latency, ต้นทุน และความเสถียร
2. ปฏิบัติต่อการประเมินแบบออฟไลน์เหมือนการทดสอบการรวมระบบ (Integration testing)
ระบบ LLM มีการเปลี่ยนแปลงตลอดเวลา ทั้งการปรับ Prompt หรืออัปเกรดโมเดล เราจึงปฏิบัติต่อการประเมินออฟไลน์เหมือนการทดสอบ Integration Test แบบ End-to-end โดยต้องทำการทดสอบใหม่ทุกครั้งที่มีการเปลี่ยนแปลงสำคัญ และต้องบันทึกเวอร์ชันของทุกส่วนประกอบเพื่อให้สามารถทำซ้ำและเปรียบเทียบกับค่าฐาน (Baseline) ได้แม่นยำ
กลยุทธ์สำคัญคือการ "เปลี่ยนตัวแปรหลักทีละอย่าง" เช่น ประเมินการแก้ Prompt แยกจากการอัปเกรดโมเดล เพื่อให้ทราบแน่ชัดว่าสิ่งที่ปรับปรุงส่งผลดีหรือร้ายอย่างไร การจัดการ Prompt และการตั้งค่าต่างๆ ควรทำเหมือนการเขียนโค้ดที่มีการทำ Versioning เพื่อให้สามารถย้อนกลับ (Rollback) ได้เมื่อเกิดปัญหา
| Run ID | เวอร์ชัน Prompt | เวอร์ชันโมเดล | Precision | Recall | Latency | หมายเหตุ |
|---|---|---|---|---|---|---|
| R-001 | v1 | โมเดล A | 0.71 | 0.78 | 1.2s | ค่าฐาน |
| R-002 | v2 | โมเดล A | 0.75 | 0.77 | 1.2s | เปลี่ยนเฉพาะ Prompt |
| R-003 | v1 | โมเดล B | 0.74 | 0.80 | 1.0s | เปลี่ยนเฉพาะโมเดล |
หมายเหตุ: ค่าในตารางเป็นเพียงตัวอย่างสมมติเพื่อแสดงวิธีการติดตามผล
3. รักษาการประเมินแบบออฟไลน์ให้ใกล้เคียงกับ Production
การประเมินจะมีประโยชน์ก็ต่อเมื่อสภาพแวดล้อมทดสอบใกล้เคียงกับความจริง ในการสแกนความลับ โมเดลต้องเผชิญกับโค้ดที่มีสิ่งรบกวนหรือบริบทที่ไม่สมบูรณ์ หากเราใช้ชุดข้อมูลที่สะอาดเกินไปในการทดสอบ คะแนนที่ได้อาจดูดีแต่จะล้มเหลวทันทีเมื่อเจอข้อมูลจริงที่มีความคลุมเครือ
พิจารณาตัวอย่างโค้ดนี้:
example_token = "sample_value_for_documentation"
production_api_key = get_secret_from_environment()
candidate_value = "flagged_value"
หากระบบประเมินค่า candidate_value โดยมีสิ่งรบกวนรอบข้าง โมเดลอาจสับสนไปโฟกัสที่ example_token แทน การรักษาความคลุมเครือเหล่านี้ไว้ในชุดทดสอบออฟไลน์จะช่วยให้เราเห็นจุดบกพร่องที่อาจเกิดขึ้นใน Production ได้ล่วงหน้า
4. ปฏิบัติต่อเลเบลจาก Production เป็นสัญญาณ ไม่ใช่ความจริงสมบูรณ์
ข้อมูลจากหน้างานจริงช่วยให้การประเมินสมจริงขึ้น แต่เลเบล (Label) มักจะสะท้อนถึงผลลัพธ์ของกระบวนการทำงานมากกว่าความจริงแท้ (Ground truth) เช่น การที่นักพัฒนาปิดการแจ้งเตือนอาจไม่ได้แปลว่าเป็นผลบวกปลอมเสมอไป แต่อาจเป็นเพราะรหัสถูกเปลี่ยนแล้วหรือยอมรับความเสี่ยงได้ ทีมจึงต้องตรวจสอบข้อมูลย่อยด้วยตนเองเพื่อให้มั่นใจว่าข้อมูลประเมินมีความแม่นยำพอจะใช้ตัดสินใจ
5. ใช้ชุดข้อมูลสังเคราะห์และชุดข้อมูลเปิดเพื่อเติมเต็มช่องว่าง
ในช่วงแรกที่ข้อมูล Production ยังมีจำกัด เราสามารถใช้ข้อมูลสังเคราะห์หรือชุดข้อมูลสาธารณะมาช่วยเสริมได้ โดยเฉพาะการทดสอบกรณีที่หาได้ยาก เช่น รูปแบบโค้ดที่ไม่ปกติ หรือบริบทที่ขาดหาย อย่างไรก็ตาม ข้อมูลเหล่านี้ควรใช้เป็นส่วนเสริมเท่านั้น และต้องปรับจูนให้ตรงกับมาตรฐานของผลิตภัณฑ์ที่เราต้องการ
6. วิเคราะห์ข้อผิดพลาดเพื่อหาจุดที่ตัวชี้วัดรวมมองไม่เห็น
ค่า Precision ที่สูงขึ้นไม่ได้บอกว่าปัญหาที่เหลืออยู่เกิดจากอะไร การวิเคราะห์ข้อผิดพลาด (Error analysis) โดยการตรวจสอบตัวอย่างที่ผิดพลาดทีละกรณีจะช่วยให้เห็นสาเหตุที่แท้จริง ไม่ว่าจะเป็นปัญหาจาก Prompt, ข้อมูลนำเข้า หรือตรรกะของ Pipeline การจำแนกประเภทข้อผิดพลาดจะเปลี่ยนปัญหาคุณภาพที่คลุมเครือให้กลายเป็นงานวิศวกรรมที่แก้ไขได้จริง
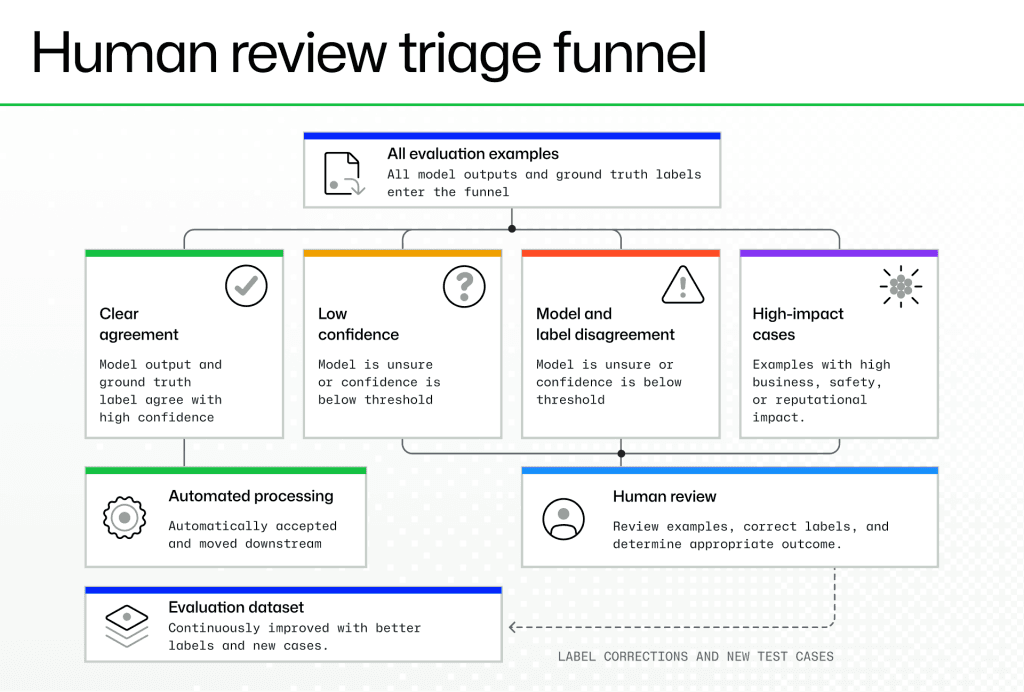
7. ใช้ LLM-as-judge เพื่อเน้นการตรวจสอบโดยมนุษย์
การตรวจสอบทุกตัวอย่างด้วยมนุษย์ในระดับสเกลใหญ่นั้นเป็นไปไม่ได้ เราสามารถใช้ LLM มาช่วยเป็นตัวตัดสิน (Judge) เพื่อคัดกรองเบื้องต้น โดยให้มนุษย์โฟกัสเฉพาะกรณีที่มีความเชื่อมั่นต่ำหรือมีความสำคัญสูง วิธีนี้จะช่วยประหยัดเวลาและเพิ่มประสิทธิภาพในการปรับปรุงคุณภาพข้อมูล
8. บทเรียนจากการสแกนความลับ
เป้าหมายของเราคือลดผลบวกปลอมโดยที่ยังคงความปลอดภัยไว้ ผลจากการประเมินและวิเคราะห์ข้อผิดพลาดซ้ำๆ ทำให้เราลดผลบวกปลอมได้ถึง 95% ในชุดทดสอบออฟไลน์ โดยที่ยังรักษาค่า Recall ให้อยู่ในเกณฑ์ที่กำหนด การประเมินอย่างเป็นระบบทำให้เรากล้าที่จะขยับไปสู่การทดลองแบบออนไลน์ด้วยความเสี่ยงที่ควบคุมได้
ความไม่แน่นอนใน Production เป็นสิ่งที่หลีกเลี่ยงไม่ได้ แต่การประเมินที่แข็งแกร่งจะช่วยให้เรามองเห็น วัดผล และจัดการความไม่แน่นอนนั้นได้อย่างมืออาชีพ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร