
Hugging Face จับมือ OpenRouter ยกระดับการรันโมเดล Open-Weight
Hugging Face และ OpenRouter ประกาศความร่วมมือครั้งสำคัญเพื่อทำให้การรันโมเดลแบบ open-weight เป็นเรื่องง่ายและมีประสิทธิภาพสูงขึ้น โดยปัจจุบันโมเดล open-weight รายใหญ่ทุกตัวถูกเผยแพร่บน Hugging Face Hub อยู่แล้ว ขณะที่ OpenRouter รับหน้าที่ให้บริการส่งต่อ (routing) คำขอไปยังผู้ให้บริการกว่า 80 รายตามผลการวัดประสิทธิภาพแบบเรียลไทม์
ความร่วมมือนี้ช่วยให้ทุกโมเดล open-weight บน Hub ที่มีผู้ให้บริการรองรับ สามารถเรียกใช้งานได้ทันทีผ่าน Hugging Face token และ API เดียวกัน โดยระบบจะเลือกผู้ให้บริการที่คุ้มค่าและเสถียรที่สุดสำหรับแต่ละคำขอให้โดยอัตโนมัติ
วันนี้มีการปรับเปลี่ยน Inference Providers จากระบบเดิมไปใช้ระบบของ OpenRouter โดยตรง คำขอที่ส่งไปยังโมเดลภาษาจะถูกคัดเลือกผู้ให้บริการจากปัจจัยด้านราคา ความเร็ว และความน่าเชื่อถือ หากรายแรกเกิดข้อผิดพลาด ระบบจะลองใหม่กับผู้ให้บริการรายอื่นทันทีโดยที่ผู้ใช้ไม่ต้องแก้ไขโค้ดแต่อย่างใด
รันโมเดลด้วยเครื่องมือที่คุณใช้อยู่แล้ว
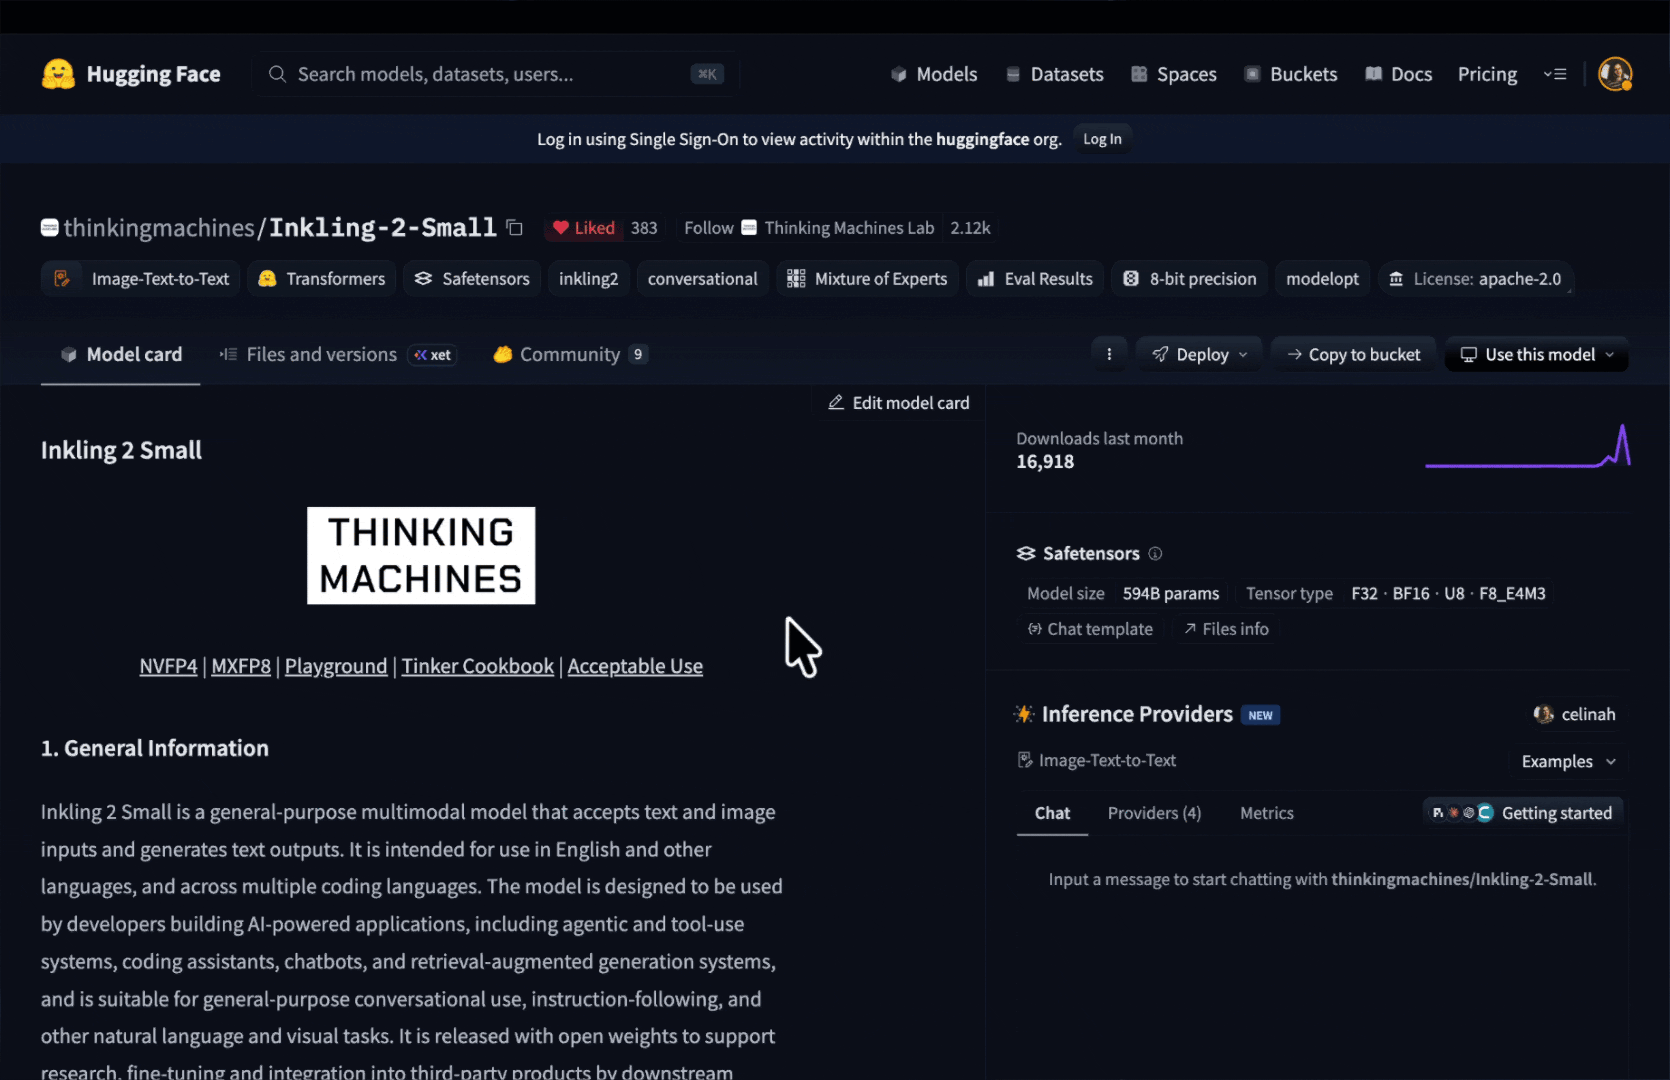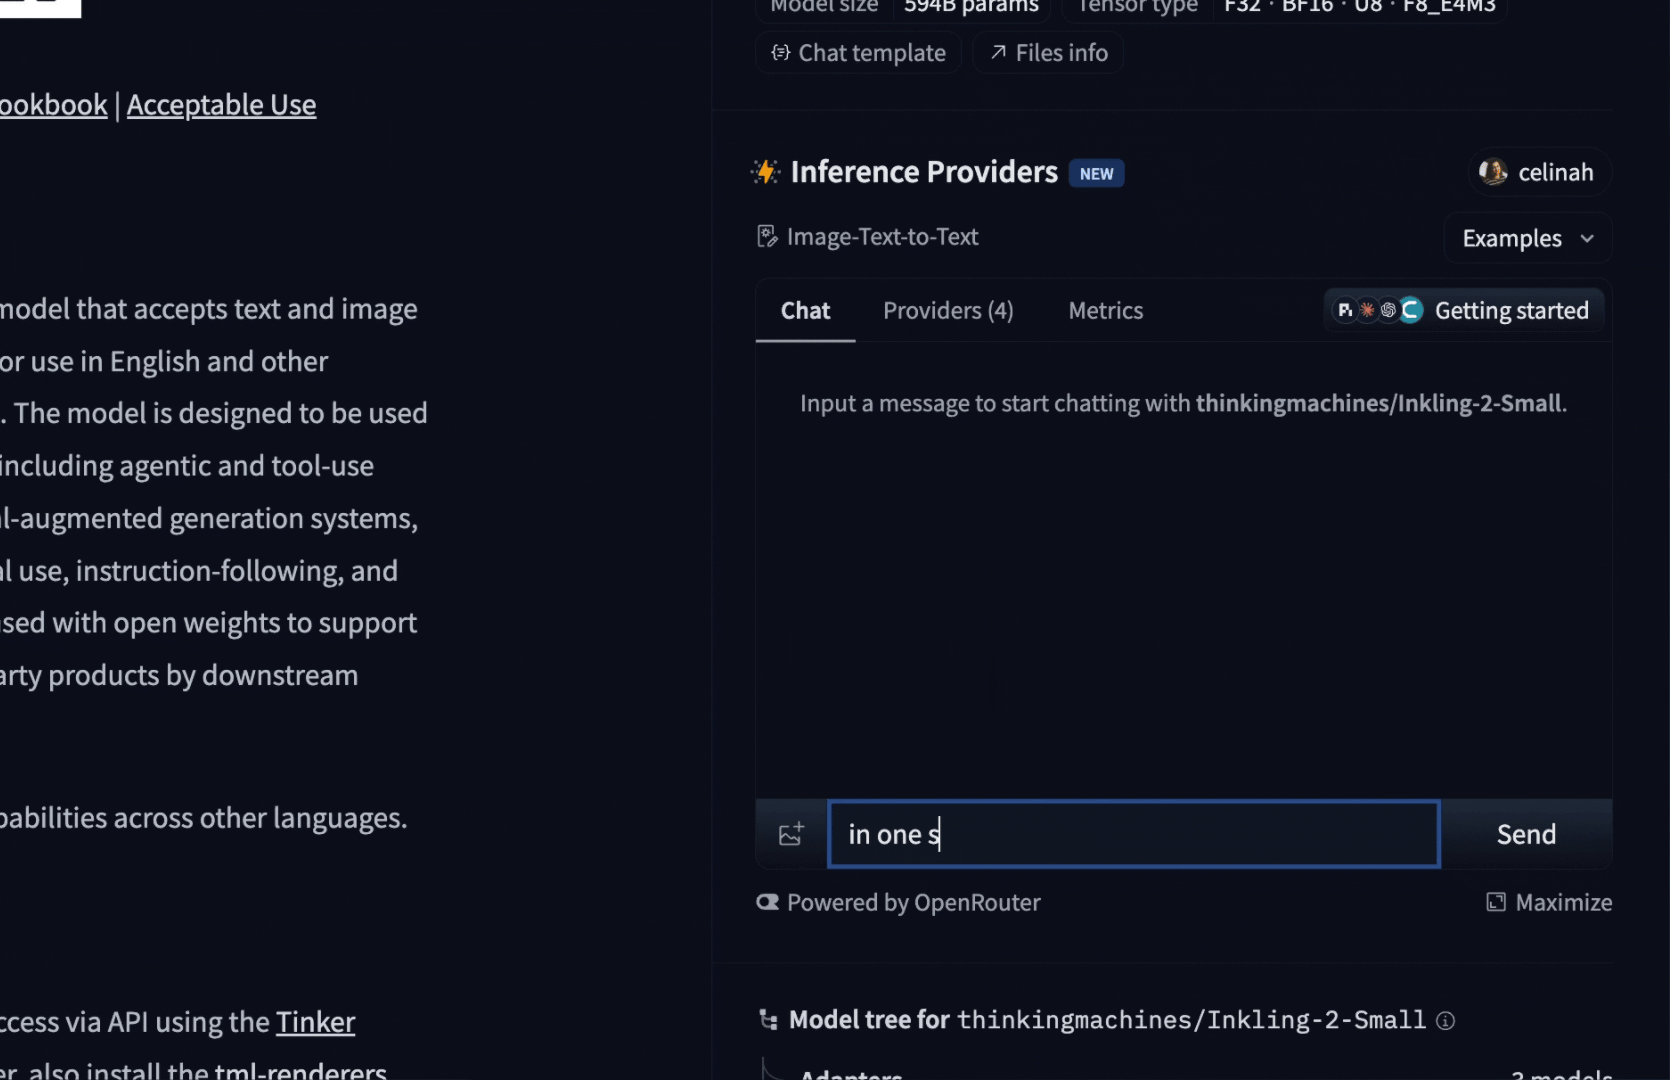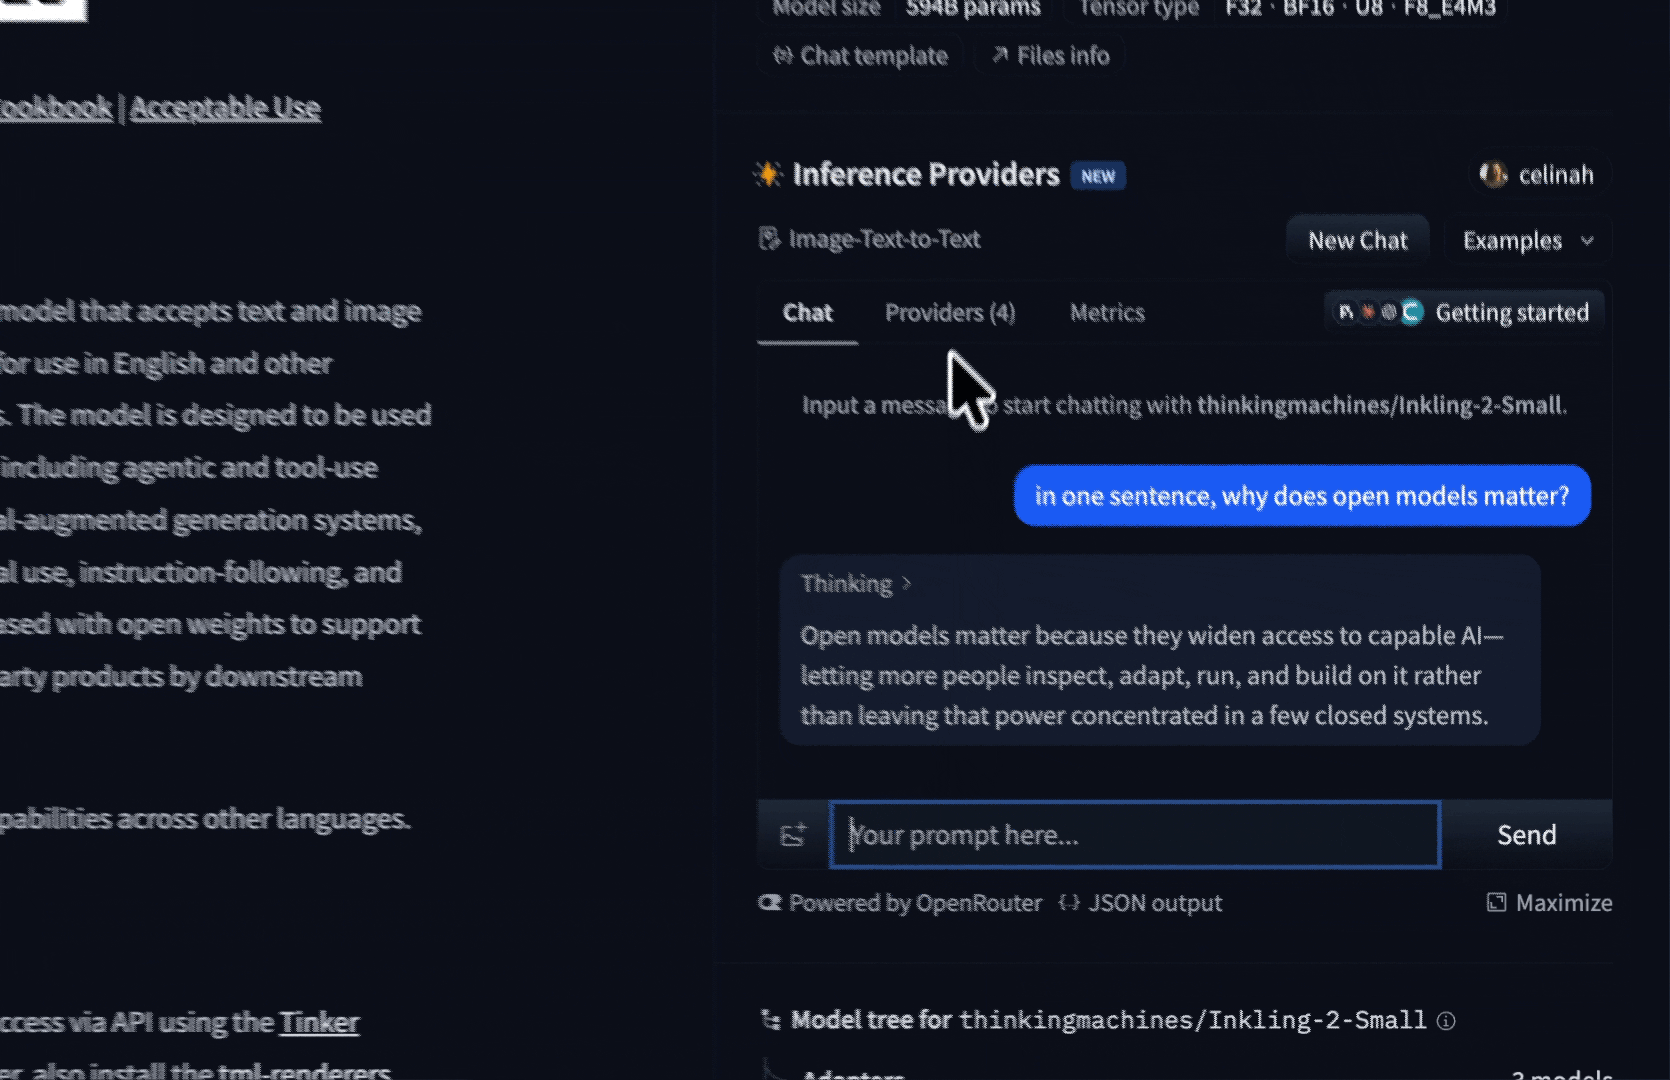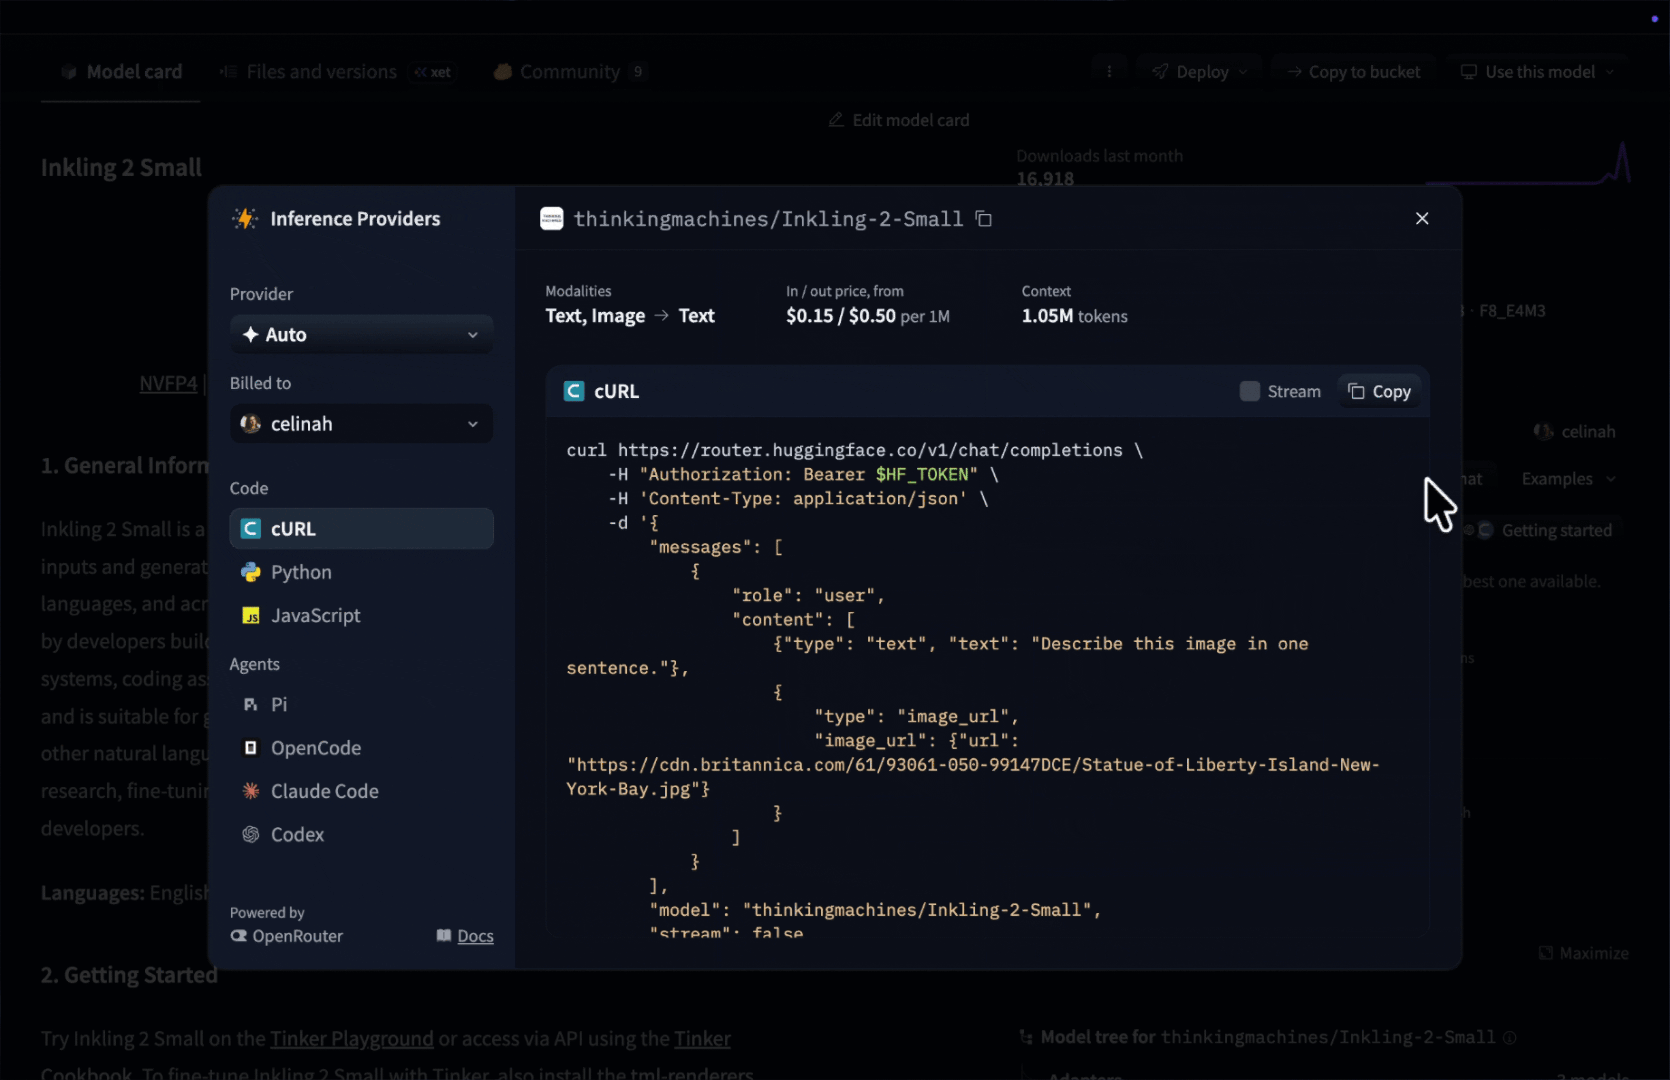
ระบบ router ใหม่นี้รองรับ API มาตรฐานทั้ง OpenAI (Chat Completions/Responses) และ Anthropic (Messages API) สำหรับทุกโมเดลแชท ผู้ใช้สามารถเลือก coding agent หรือ SDK ที่ต้องการ แล้วคัดลอกการตั้งค่าไปใช้งานได้ทันที
สำหรับผู้ที่ต้องการเริ่มต้น สามารถศึกษาคู่มือการตั้งค่าได้ที่ Claude Code, Codex, OpenCode, Pi และ Hermes Agent
นอกจากนี้ Hugging Face token ยังครอบคลุมบริการอื่นๆ เช่น Storage Buckets, Jobs และ Inference Endpoints โดยแผน PRO, Team และ Enterprise จะได้รับเครดิตรายเดือนรวมอยู่ในแพ็กเกจ
การเติบโตของโมเดล open-weight
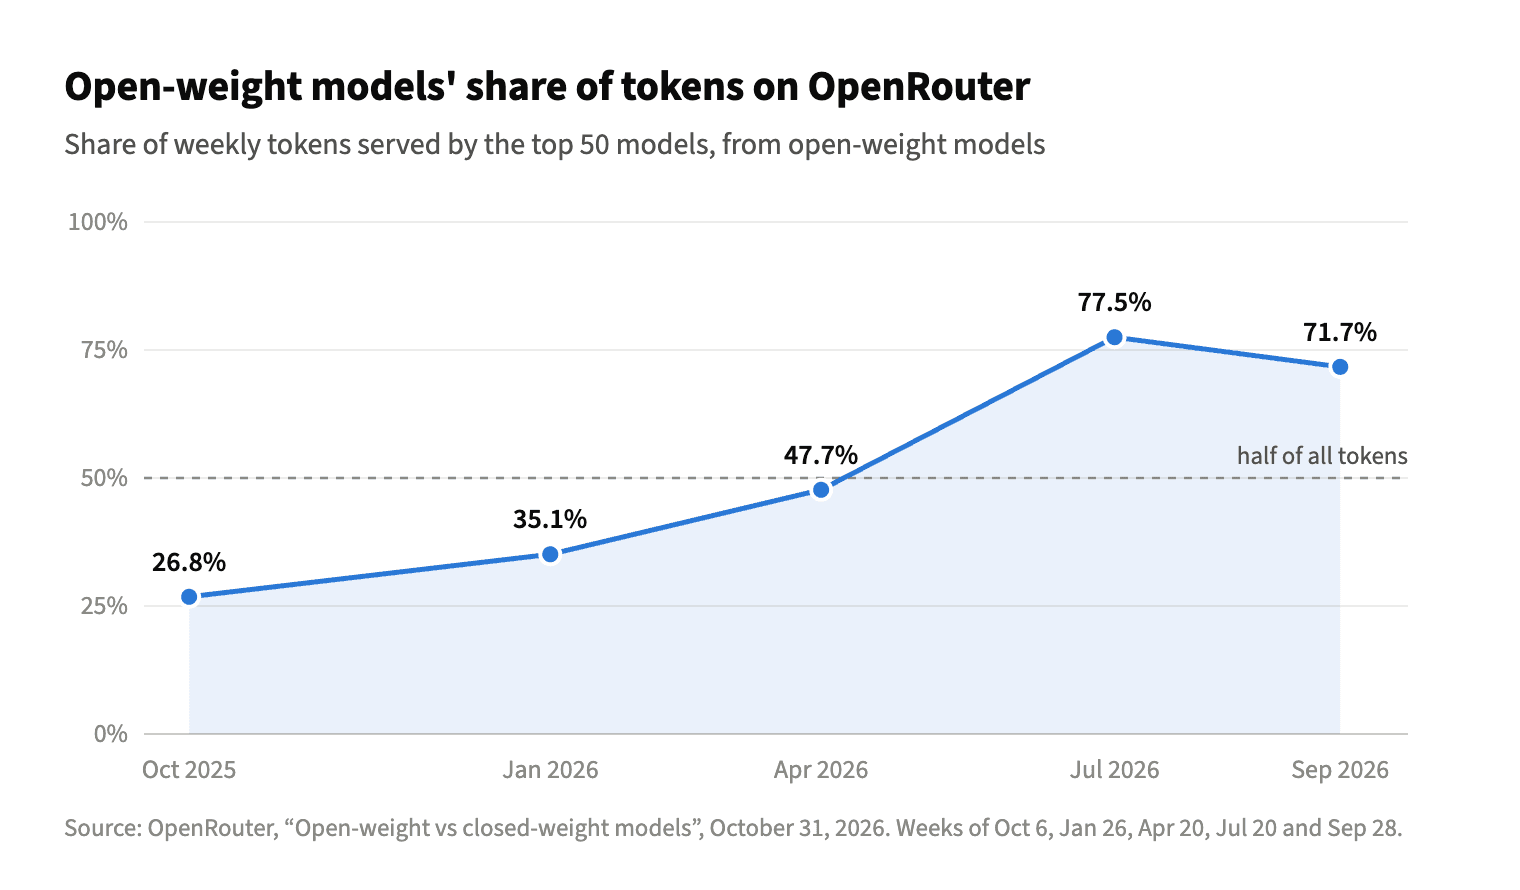
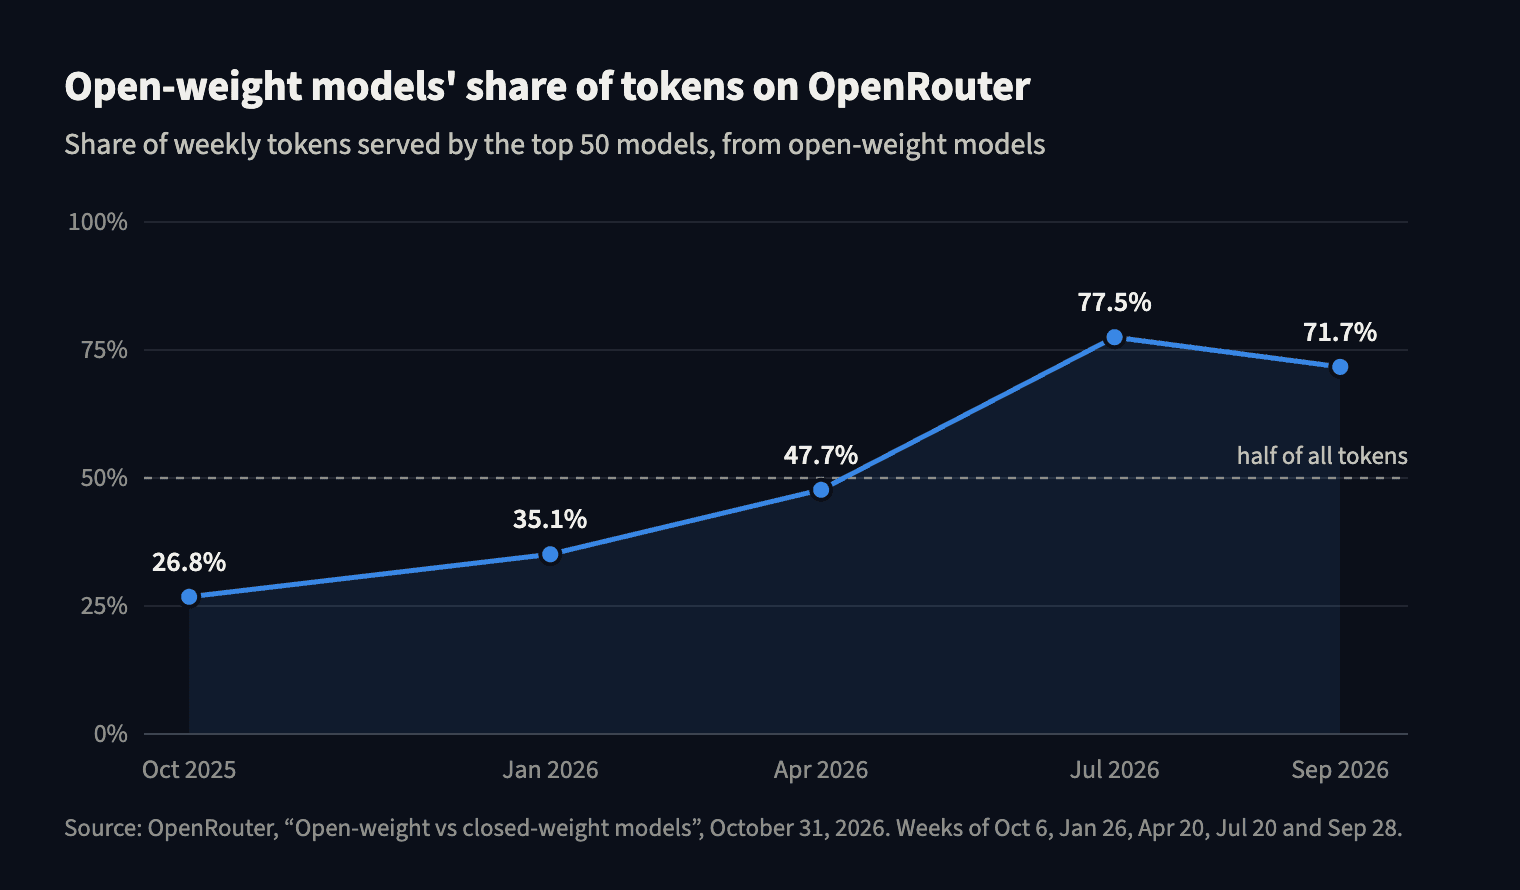
สถิติจาก OpenRouter พบว่าสัดส่วนการใช้งานโมเดล open-weight เติบโตอย่างก้าวกระโดด จาก 26.8% ในเดือนตุลาคม 2025 พุ่งขึ้นเป็น 71.7% ณ สิ้นเดือนกันยายน 2026 โดยมีจุดสูงสุดที่ 77.5% ในเดือนกรกฎาคม (OpenRouter, October 2026)
ปริมาณการใช้งาน open-weight รายสัปดาห์เติบโตขึ้นกว่า 60 เท่า เมื่อเทียบกับโมเดลแบบปิด (closed models) ที่เติบโตเกือบ 10 เท่า โดยโมเดลที่ได้รับความนิยมสูงสุดในขณะนี้คือ DeepSeek V4.1 Flash 1017 ด้วยปริมาณการใช้งานถึง 59.2 ล้านล้าน token (rankings)
ในด้านความคุ้มค่า โมเดล open-weight มีราคาถูกกว่าโมเดลแบบปิดเฉลี่ย 4 เท่า โดยมีราคาเพียง 0.28 ดอลลาร์ต่อล้าน input token และ 1.62 ดอลลาร์ต่อล้าน output token
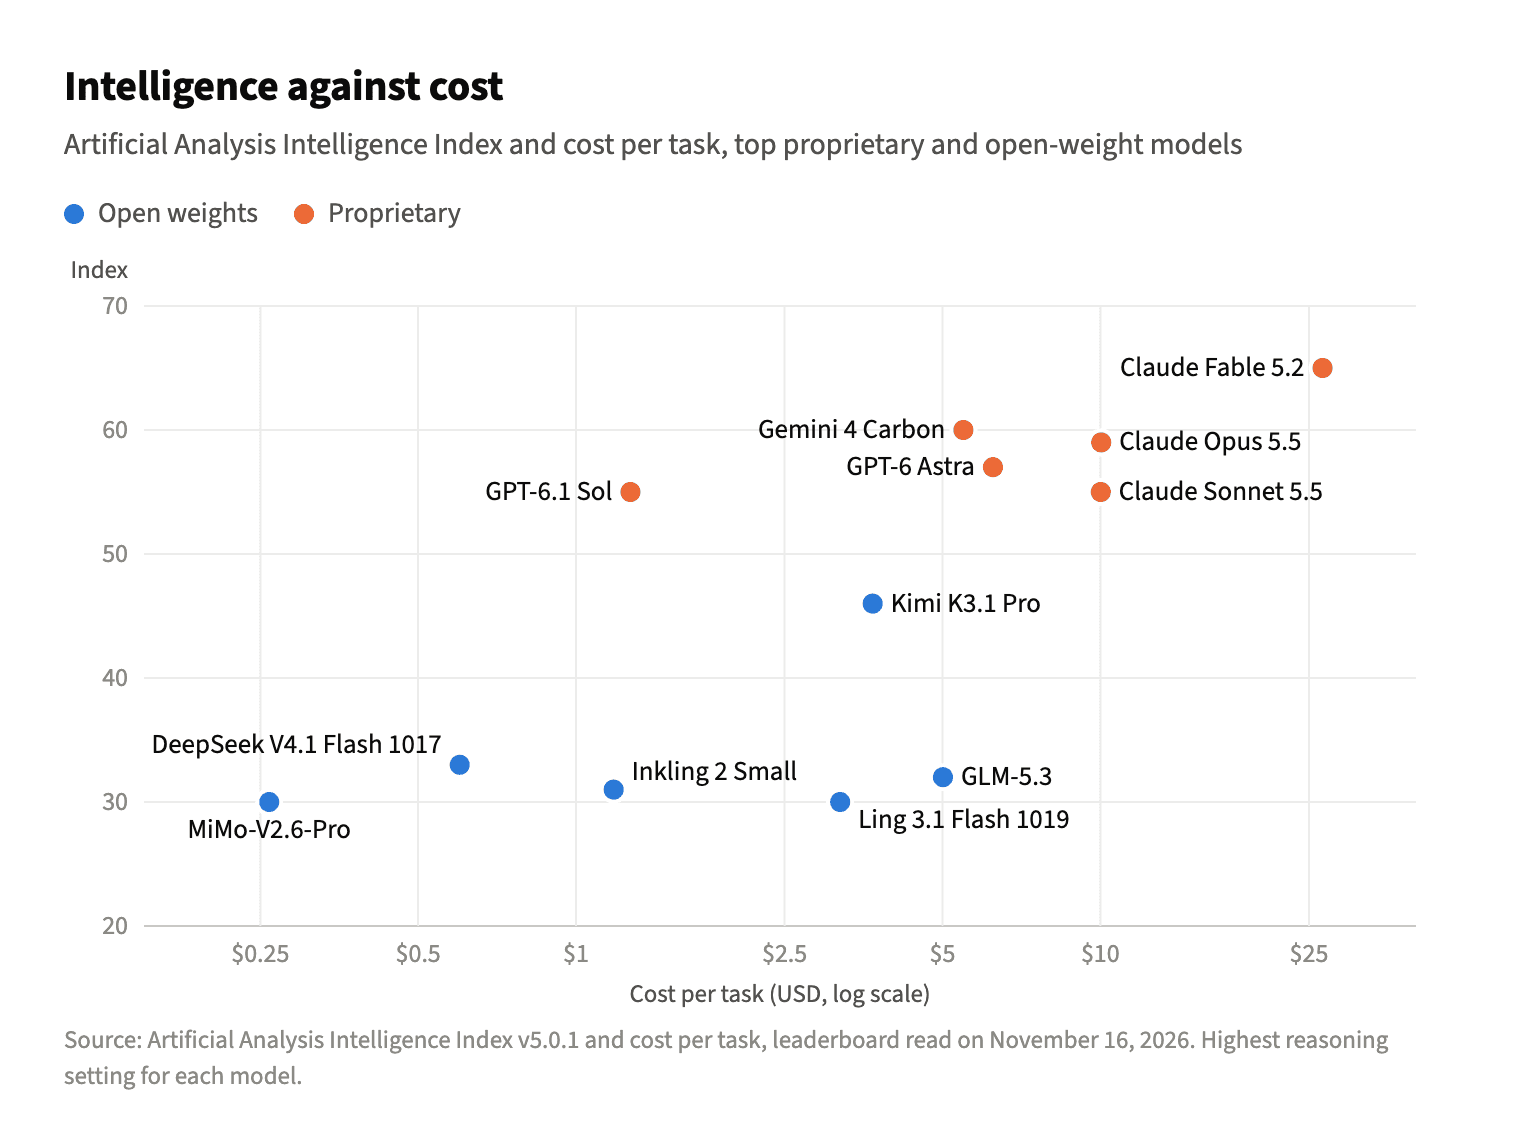
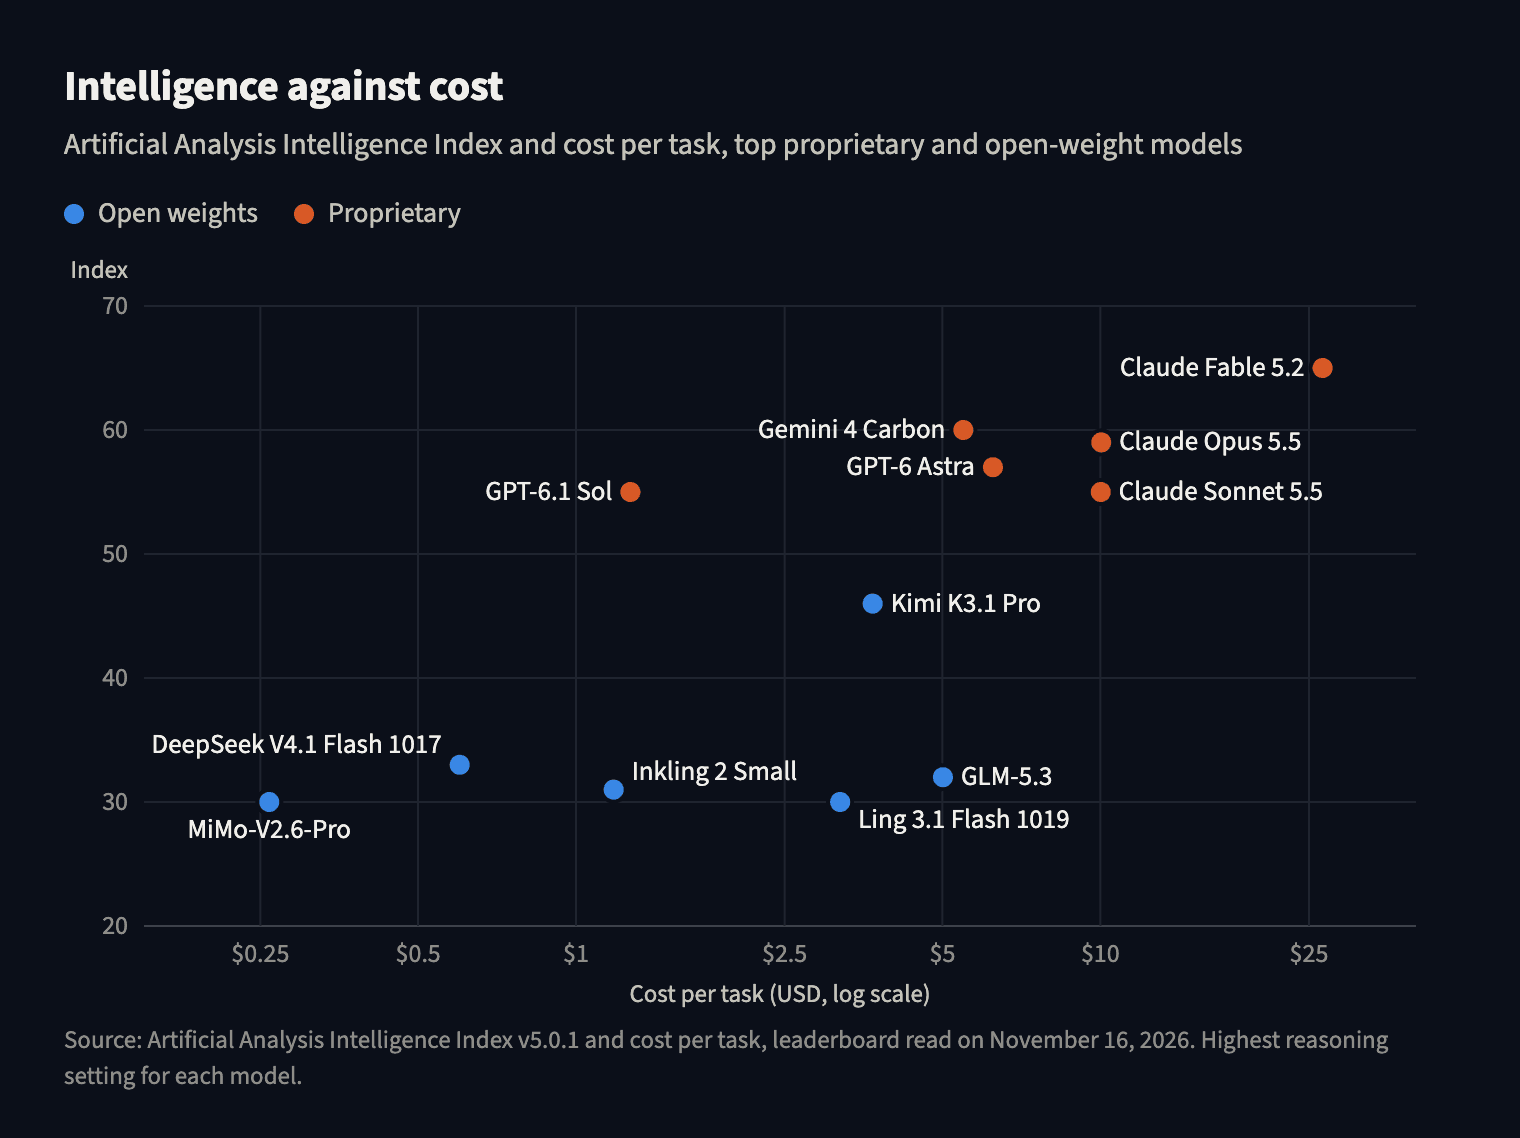
แม้โมเดลที่เป็นกรรมสิทธิ์ (proprietary) จะยังคงนำหน้าใน benchmark ที่ยากที่สุด เช่น Artificial Analysis Intelligence Index ที่ Claude Fable 5.2 ทำได้ 65 คะแนน ขณะที่โมเดล open-weight อย่าง Kimi K3.1 Pro ทำได้ 46 คะแนน แต่เมื่อเทียบกับราคาต่อภารกิจที่ถูกกว่าถึง 7 เท่า (3.68 ดอลลาร์ เทียบกับ 26.54 ดอลลาร์) ก็ถือเป็นทางเลือกที่คุ้มค่ามากสำหรับงานส่วนใหญ่
ระบบ Routing ขับเคลื่อนโดย OpenRouter
OpenRouter ให้บริการมากกว่า 800 ล้านล้าน token ต่อเดือน ครอบคลุมโมเดลกว่า 600 รุ่น ผ่านผู้ให้บริการกว่า 80 ราย โดยระบบ routing ใหม่ จะไม่ได้มองเพียงราคาถูกที่สุด แต่จะพิจารณาสมดุลระหว่างราคา ความเร็ว และความน่าเชื่อถือเป็นหลัก
หากผู้ให้บริการรายใดทำงานผิดพลาด ระบบจะย้ายปริมาณงานออกทันทีและลองใหม่กับรายถัดไปภายในการเรียกใช้ครั้งเดิม ช่วยลดข้อผิดพลาดด้านความจุ (capacity errors) ได้ 46% ปรับปรุงเวลาสร้าง token แรกได้ 16.9% และเพิ่ม throughput ได้ 16.3%
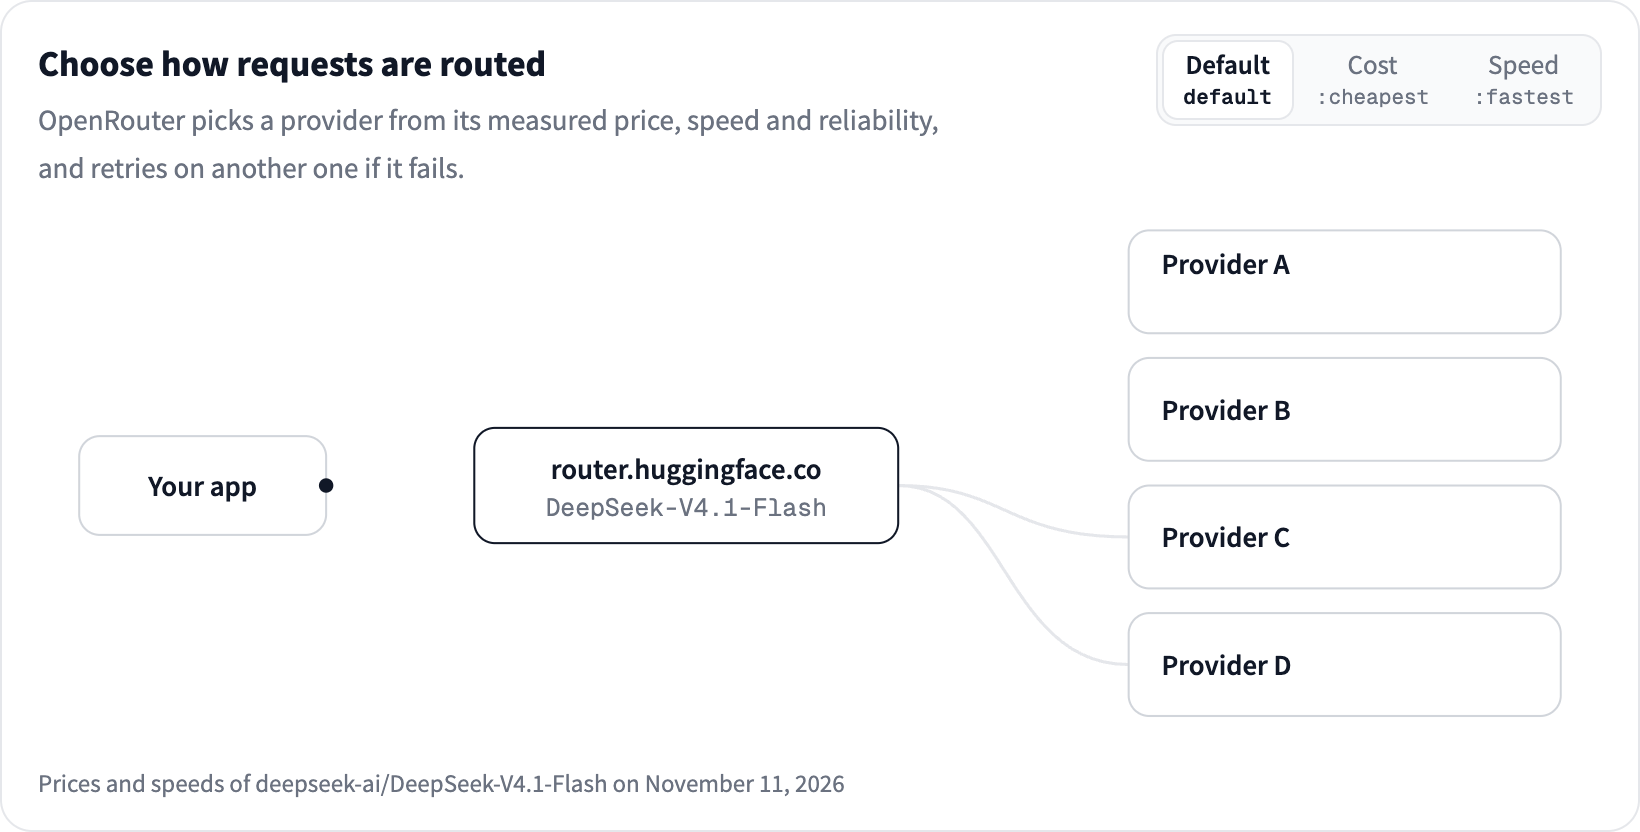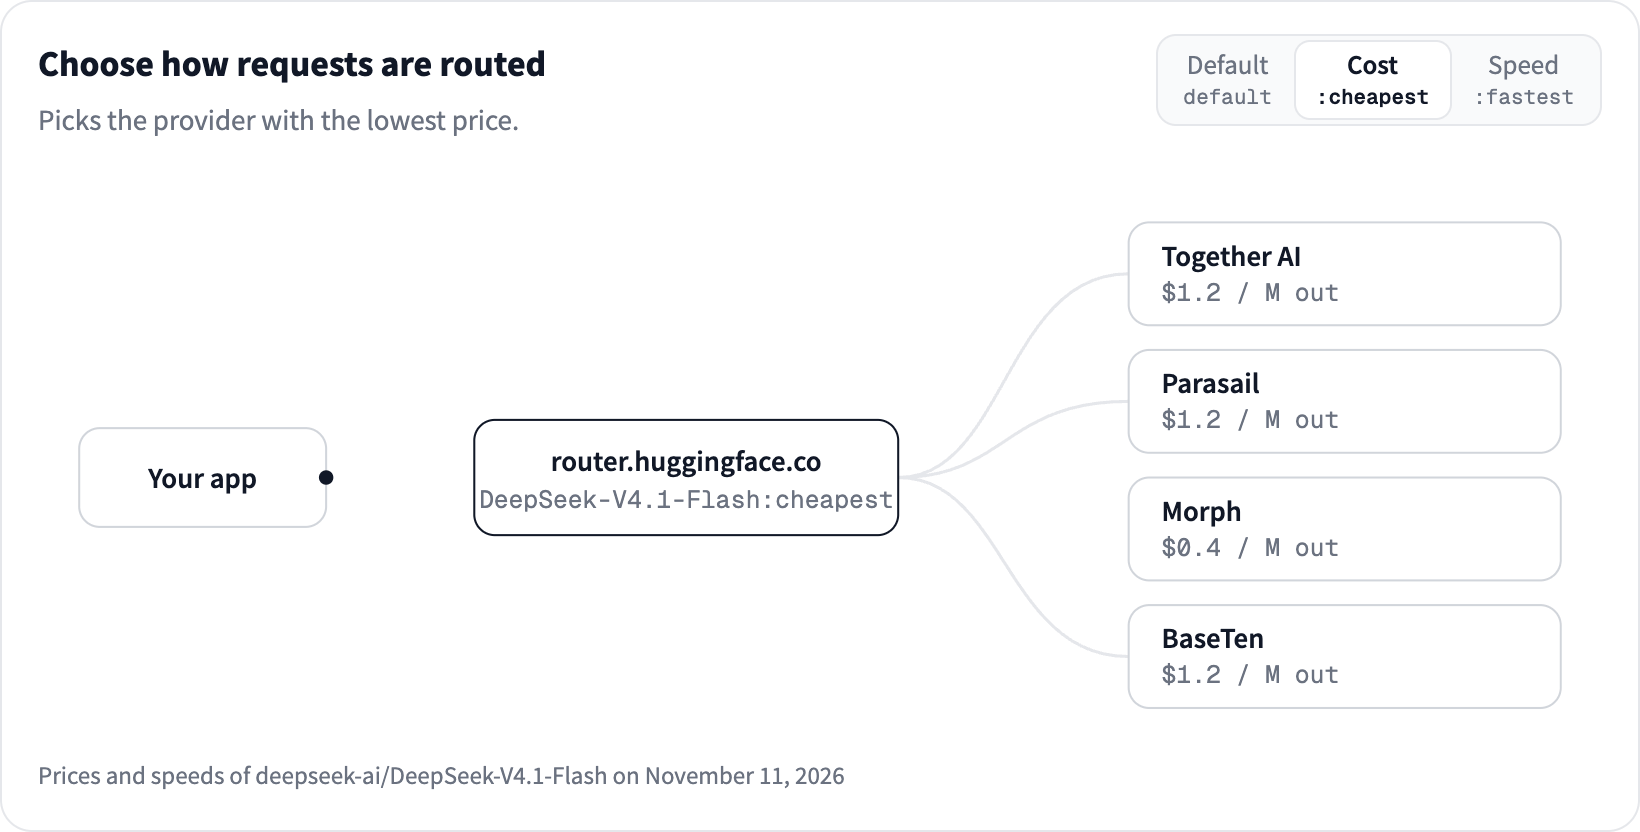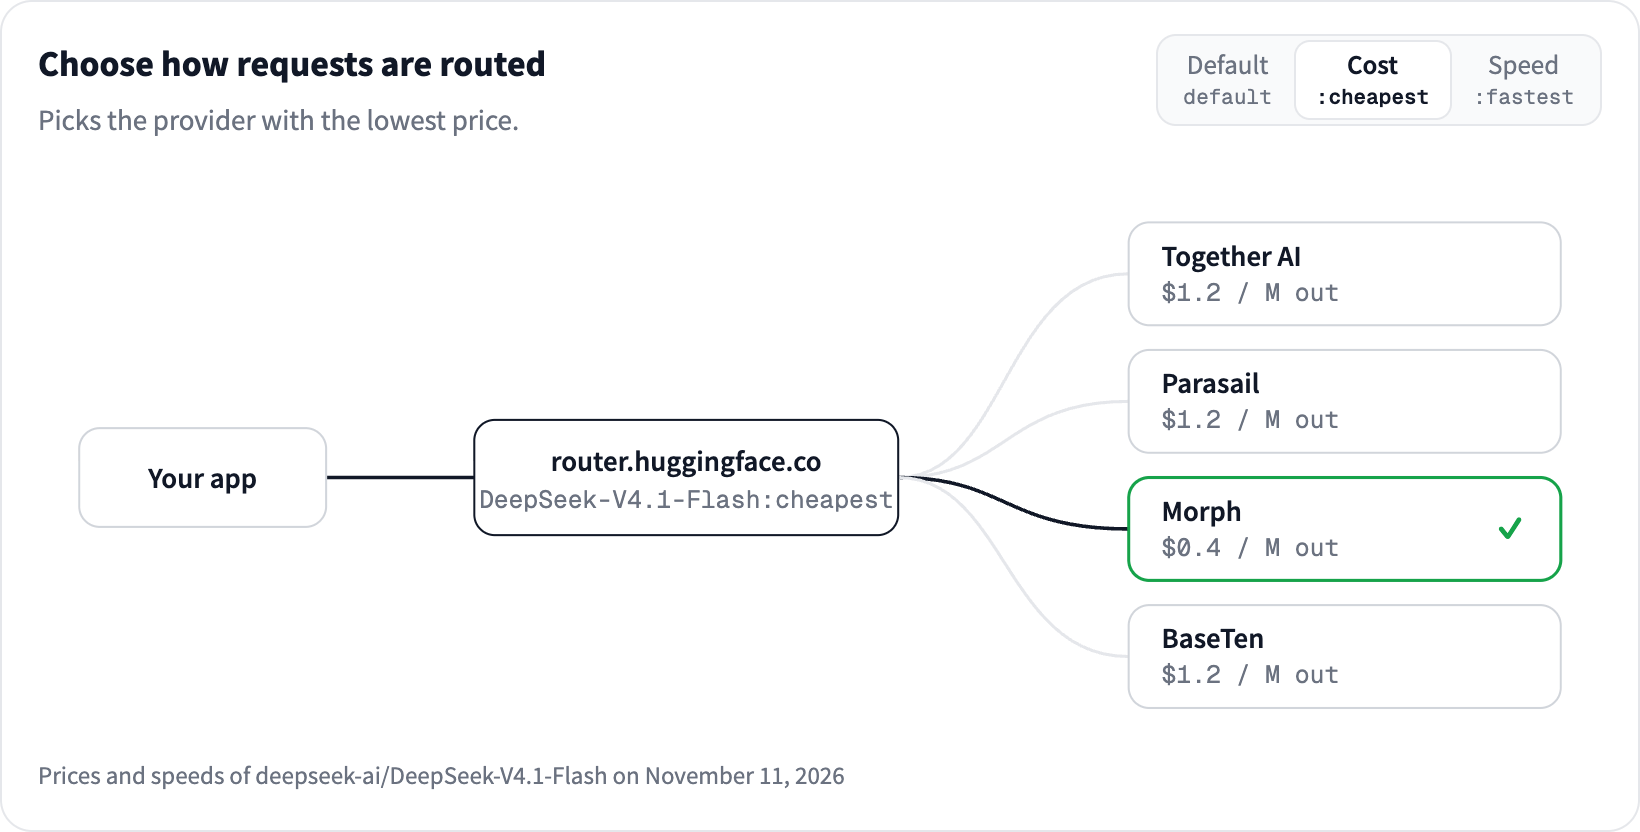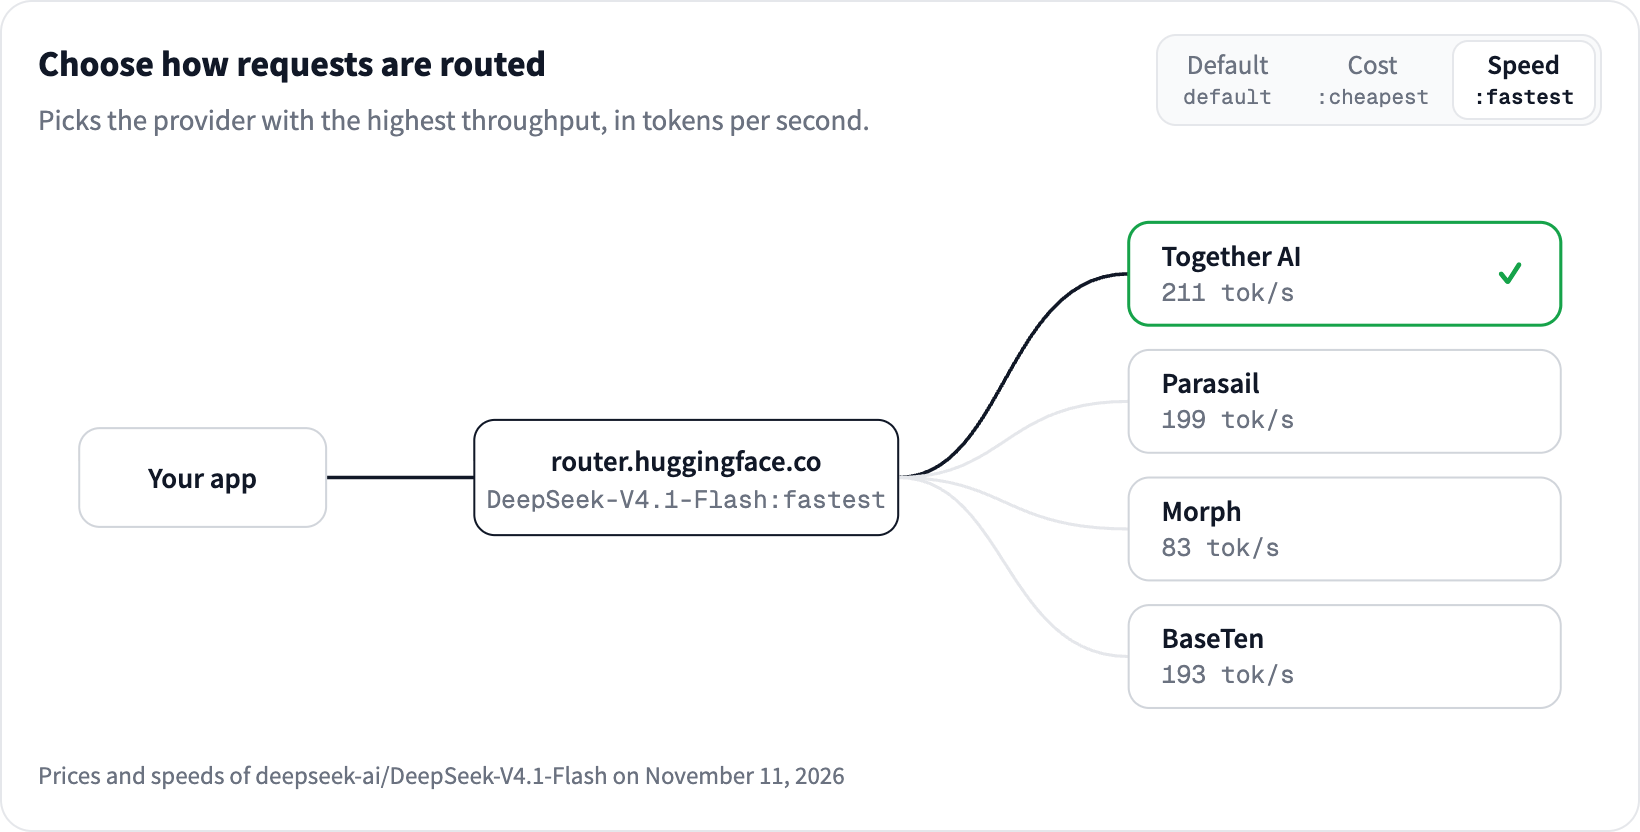
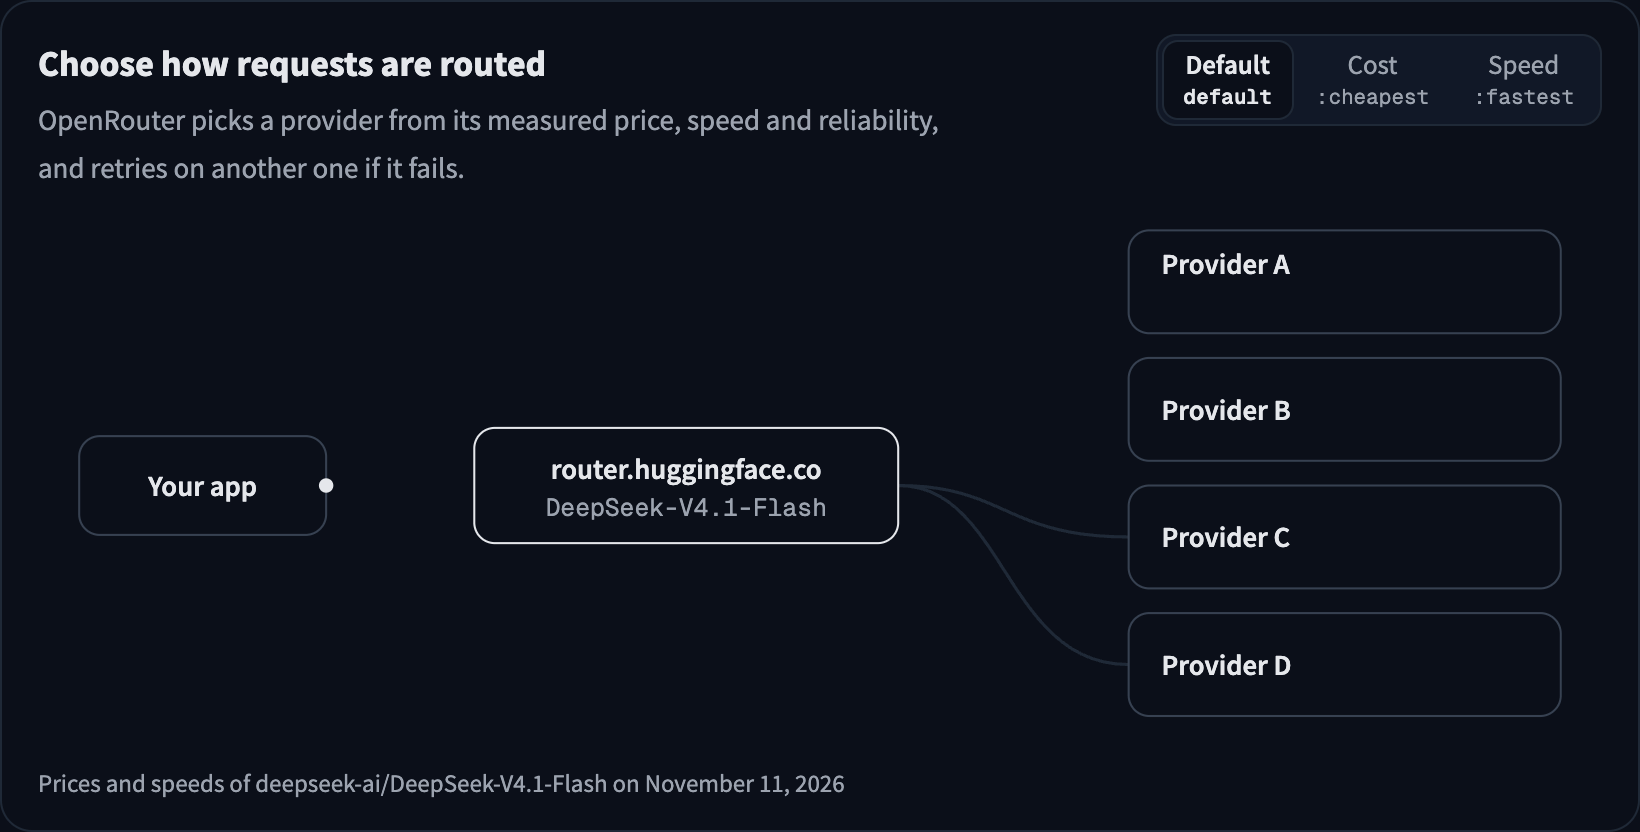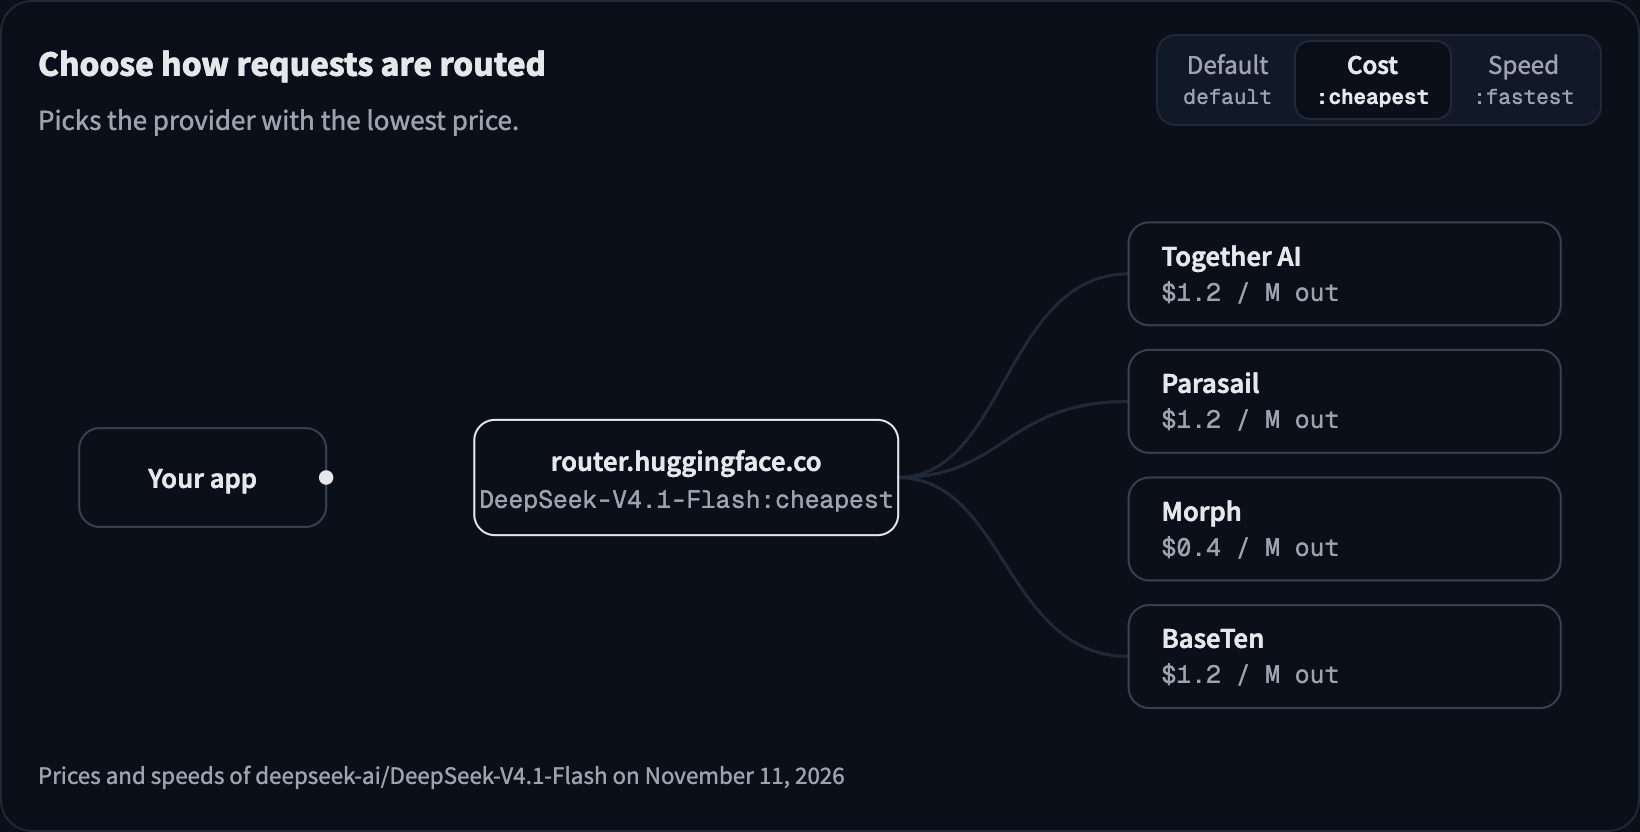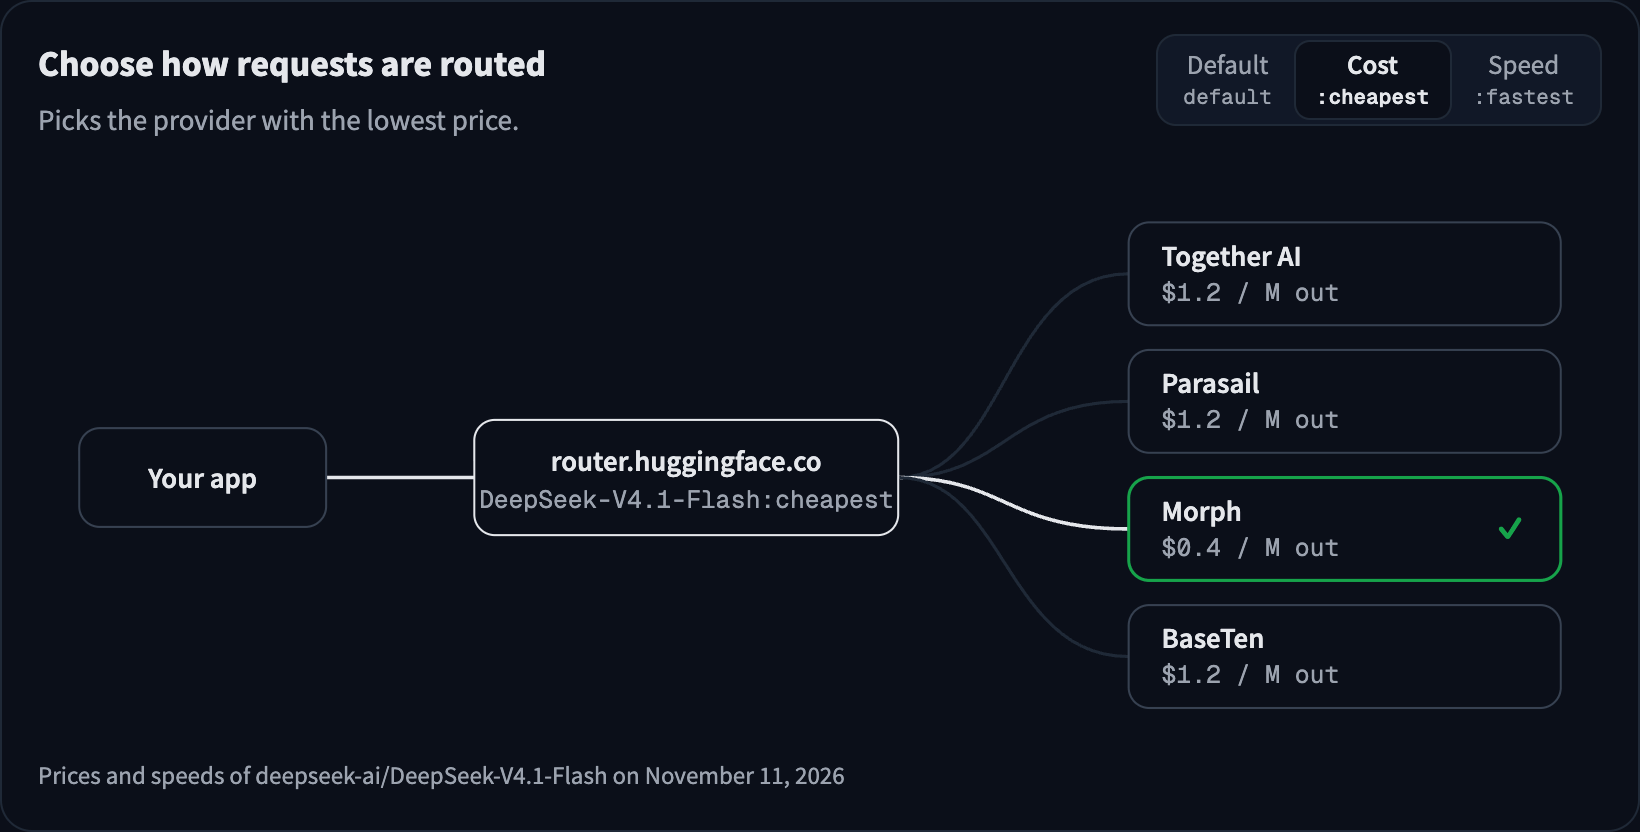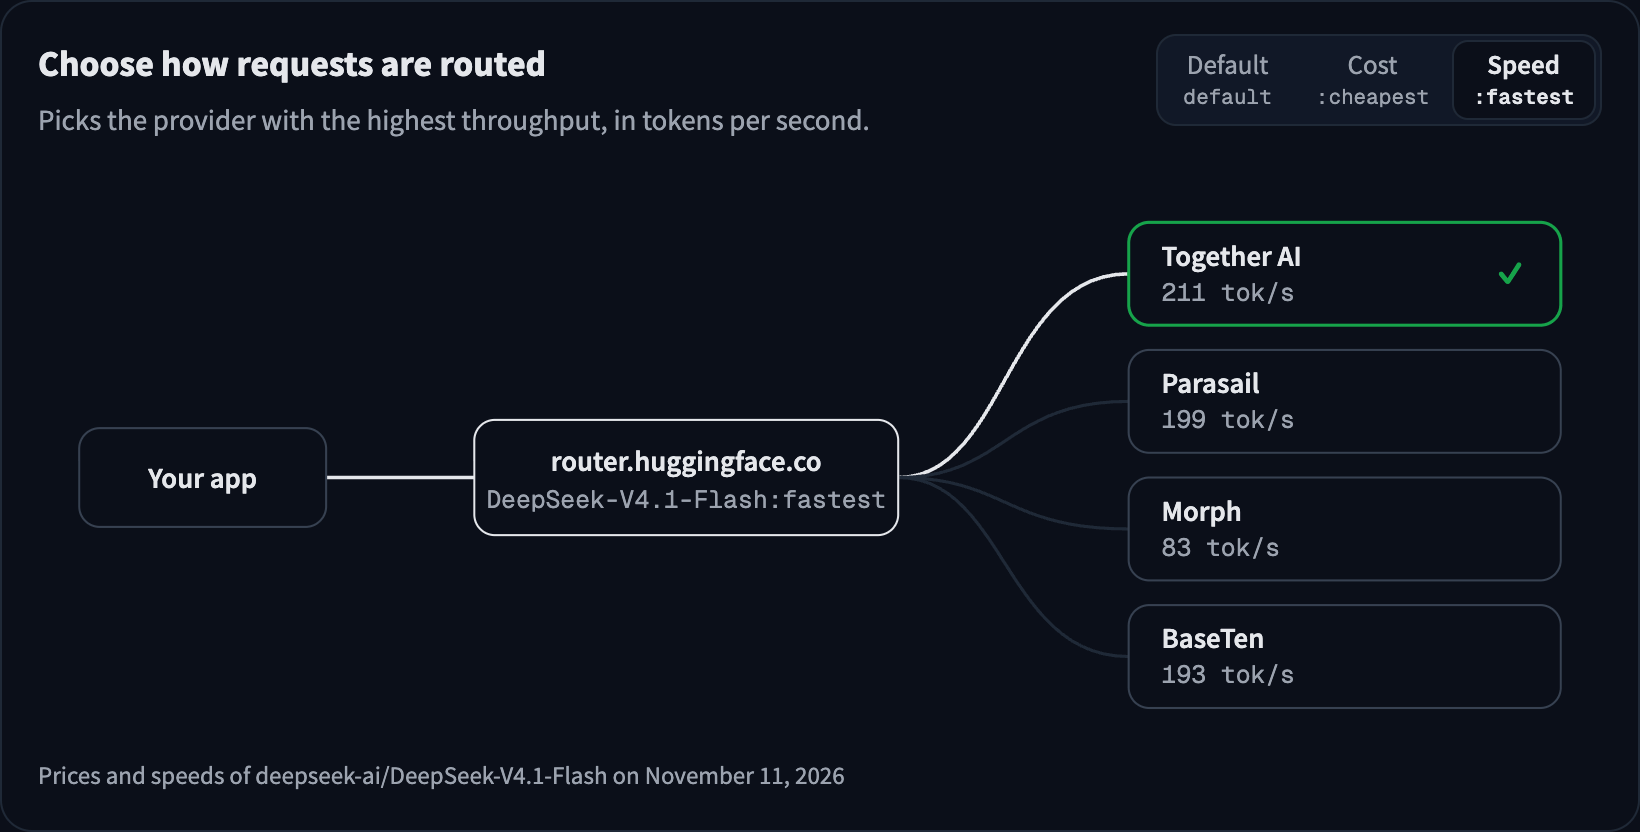
ผู้ใช้ยังสามารถเลือกนโยบายเฉพาะเจาะจงได้โดยการเติม suffix ต่อท้าย model id:
zai-org/GLM-5.3            # ค่าเริ่มต้น: สมดุลที่สุด
zai-org/GLM-5.3:fastest    # เน้นความเร็ว (throughput) สูงสุด
zai-org/GLM-5.3:cheapest   # เน้นราคาต่ำที่สุด
zai-org/GLM-5.3:novita     # ระบุผู้ให้บริการ (เช่น Novita)
ระบบยังรองรับ prompt caching เพื่อรักษาความต่อเนื่องของการสนทนากับผู้ให้บริการเดิม โดยการส่ง UUID ผ่าน header X-HF-Session-Id (ศึกษาเพิ่มเติมที่ คู่มือ prompt caching)
ราคาและการชำระเงิน
โครงสร้างราคายังคงเดิม โดยคิดตามจริงจากผู้ให้บริการและ Hugging Face ไม่มีการบวกราคาเพิ่ม สำหรับผู้ใช้ PRO จะได้รับเครดิต 2 ดอลลาร์ต่อเดือน ส่วนองค์กรระดับ Team และ Enterprise จะได้รับ 2 ดอลลาร์ต่อที่นั่ง สามารถตรวจสอบรายละเอียดได้ที่ Pricing and Billing
สำหรับการสร้างภาพ วิดีโอ และเสียง จะยังคงทำงานผ่าน Hugging Face Inference Providers โดยตรง ไม่ผ่าน OpenRouter ผู้ใช้สามารถใช้ token เดิมและเข้าถึง LoRAs จำนวนมหาศาลได้เช่นเคย
ตรวจสอบข้อมูลผู้ให้บริการ
ผู้ใช้สามารถตรวจสอบข้อมูลผู้ให้บริการได้โดยตรงใน widget หน้าโมเดล ผ่านแท็บ Providers (แสดงราคาและความเร็วรายราย) และ Metrics (แสดงค่าสถิติที่ดีที่สุดในขณะนั้น):
นอกจากนี้ยังสามารถดูรายละเอียดค่าใช้จ่ายแยกตามผู้ให้บริการได้ในหน้า ภาพรวมการใช้งาน และสามารถเลือกปิดผู้ให้บริการที่ไม่ต้องการได้ใน การตั้งค่า
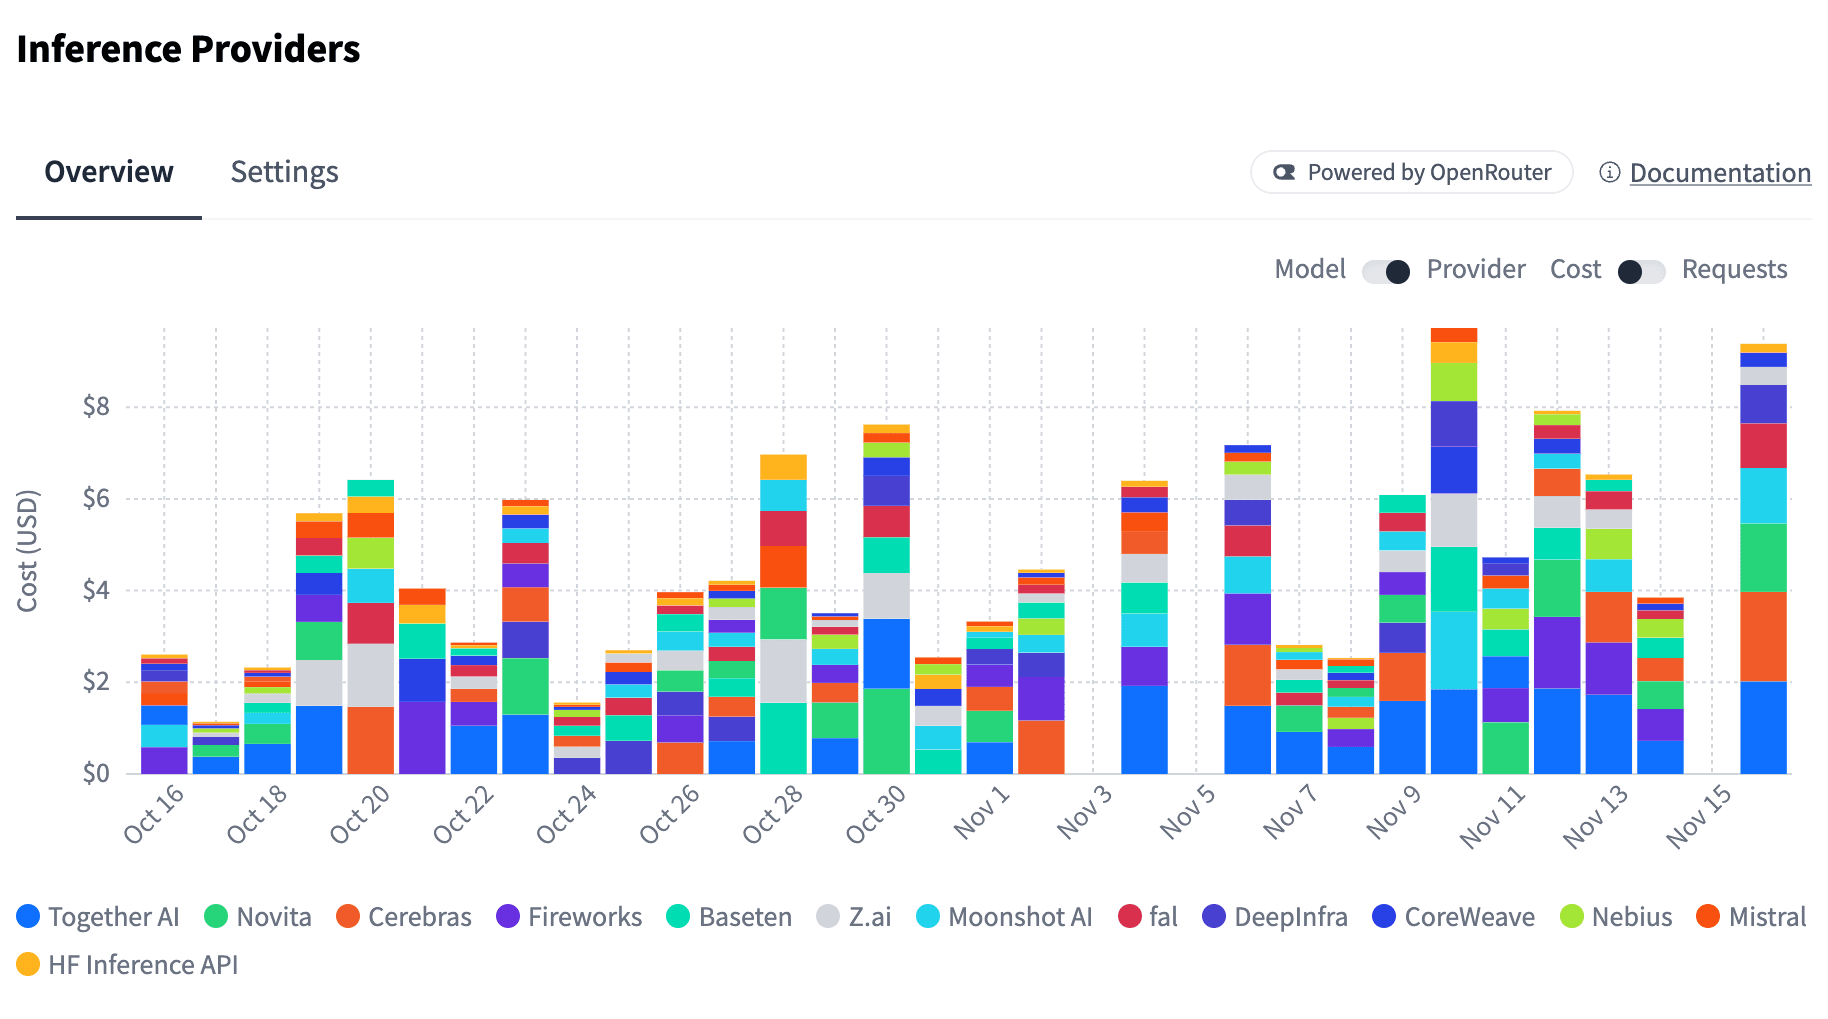
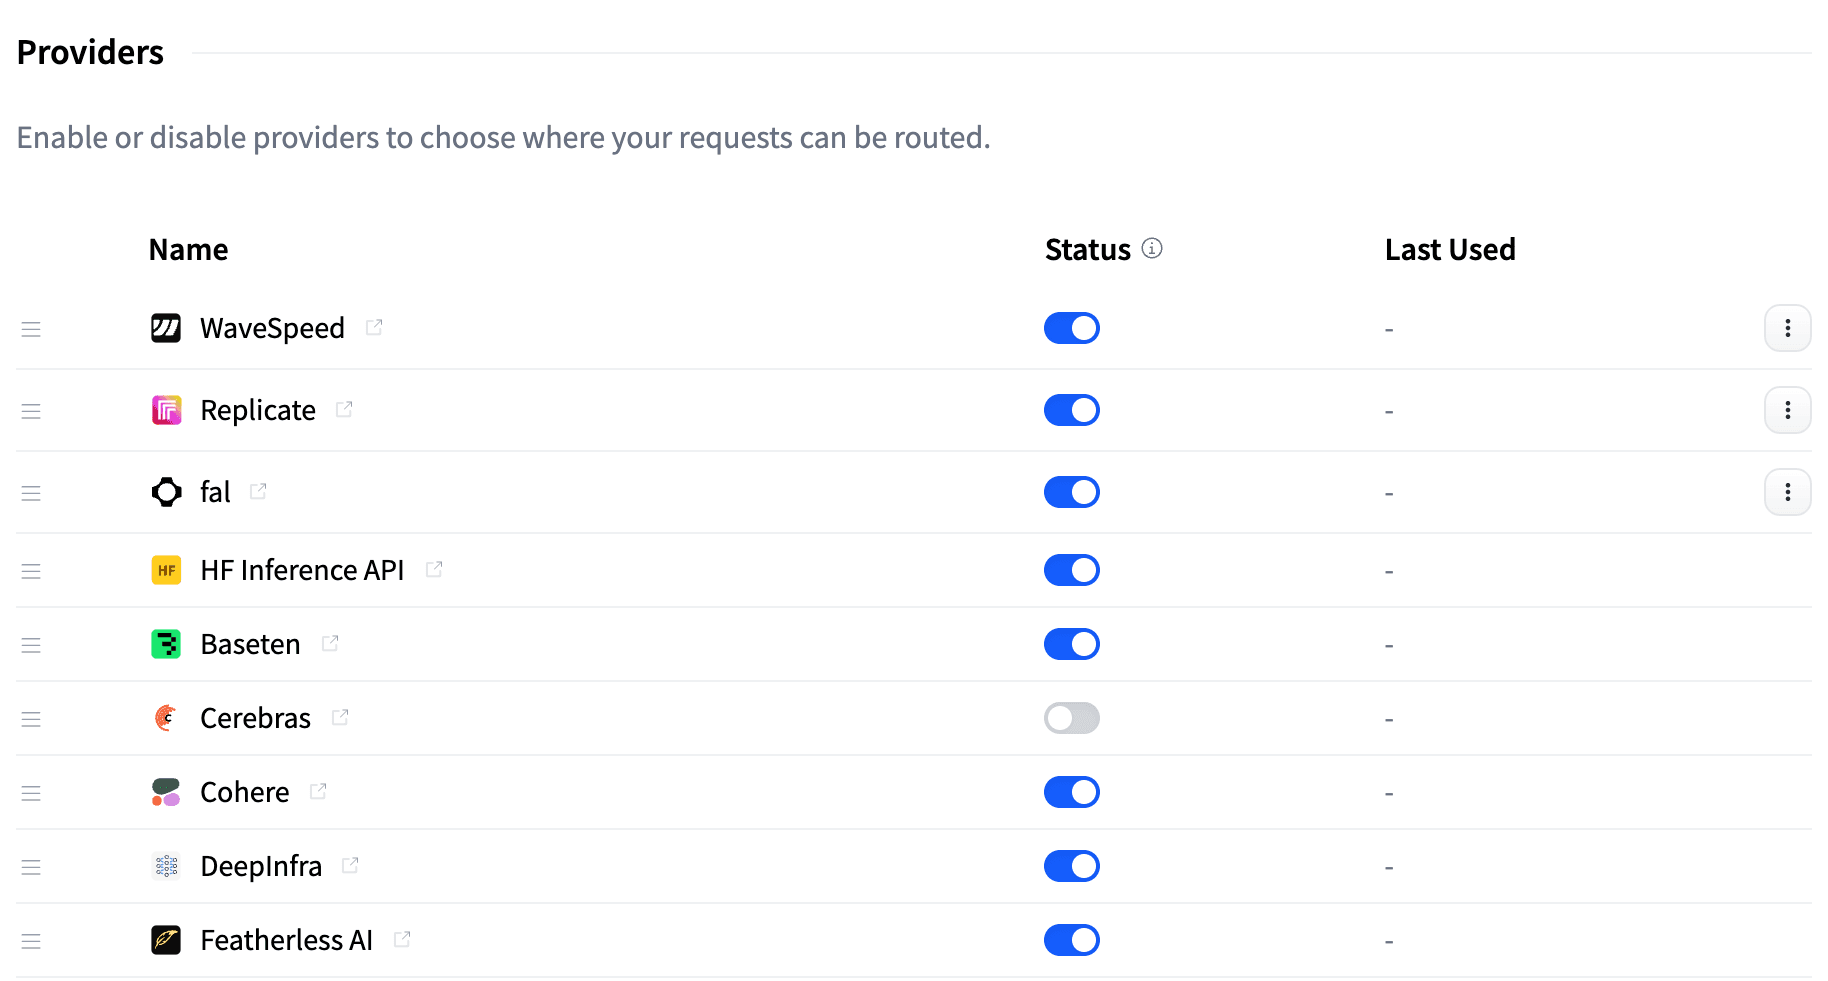
การเปลี่ยนแปลงสำคัญ เนื่องจากคำขอใช้งานโมเดลภาษาจะผ่าน OpenRouter และเรียกเก็บเงินผ่าน Hugging Face ผู้ใช้จะไม่สามารถใช้ API key ส่วนตัวของแต่ละผู้ให้บริการกับโมเดลภาษาได้อีกต่อไป แต่ยังคงระบุผู้ให้บริการที่ต้องการผ่าน suffix หรือตั้งค่าปิดผู้ให้บริการได้ตามปกติ ส่วนคีย์สำหรับผู้ให้บริการภาพและวิดีโอยังคงใช้งานได้เหมือนเดิม
ในอนาคต Hugging Face และ OpenRouter มีแผนจะเชื่อมต่อบัญชีระหว่างกันและขยายขอบเขตงานประเภทอื่นๆ ผ่านระบบ OpenRouter มากขึ้น ผู้ที่สนใจสามารถเริ่มต้นได้ที่ หน้าโมเดล หรืออ่าน เอกสาร Inference Providers
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร