
ผลทดสอบชี้ ChatGPT วิเคราะห์ข้อมูลพลาดซ้ำซาก แม้สั่งให้ทบทวนซ้ำก็ยังยืนยันตัวเลขผิด
เราได้ทำการทดลองโดยใช้ชุดข้อมูลขนาดเล็ก 3 ชุด เพื่อทดสอบโมเดล AI ด้วยคำถามพื้นฐานที่ธุรกิจมักใช้ เช่น เวลาการจัดส่งเฉลี่ย ภูมิภาคที่มีผลงานดีที่สุด หรือจำนวนนักกีฬาในไฟล์
ในการทดลองนี้เราได้เพิ่มขั้นตอนการตรวจสอบ (Review pass) โดยส่งคำตอบเดิมกลับไปให้โมเดลตรวจสอบอีกครั้ง พร้อมกำชับว่าข้อมูลจะถูกนำไปใช้ในสไลด์สำหรับผู้บริหารเพื่อกระตุ้นให้ AI ระมัดระวังเป็นพิเศษ
ผลปรากฏว่าการตรวจสอบรอบหนึ่งตรวจพบการนับแถวที่ผิดจริง แต่กลับอนุมัติข้อสรุปอื่นที่สวนทางกับความเป็นจริง ส่วนการตรวจสอบอีกรอบกลับสร้างการแก้ไขปลอมๆ และเปลี่ยนคำตอบที่ถูกต้องให้กลายเป็นผิด โดยเราใช้ GPT-5.6 Terra สำหรับการประมวลผลเร็ว และ GPT-5.6 Luna สำหรับการรันแบบละเอียดบน Pandas และ SciPy
ข้อมูล (The Data)
ชุดข้อมูลแรกคือ shipment_tracking มี 40 คำสั่งซื้อ ประกอบด้วยวันที่สั่ง (ordered_date), วันที่ส่งออก (shipped_date) และวันที่ถึงมือผู้รับ (delivered_date) โดยมี 18 รายการที่ยังส่งไม่ถึง
ชุดที่สองคือ regional_sales ข้อมูลยอดขาย 8 ภูมิภาคปี 2007-2025 ซึ่งมีโครงสร้างผิดเพี้ยน เช่น ข้อมูลซ้ำซ้อนในภูมิภาค us_west และตัวเลขที่ขัดแย้งกันในภูมิภาค apac ทำให้ไม่มีค่าที่แน่นอนเพียงค่าเดียว
ชุดสุดท้ายคือ olympics_athletes_events ข้อมูลนักกีฬาโอลิมปิก 352 แถว ซึ่งมีรายละเอียดสำคัญคือหนึ่งแถวต่อนักกีฬาต่อประเภทการแข่งขัน ทำให้มีนักกีฬาบางคนปรากฏชื่อซ้ำหลายครั้งตามจำนวนรายการที่ลงแข่ง
ข้อผิดพลาดที่ 1: วัดระยะเวลาผิดประเภท
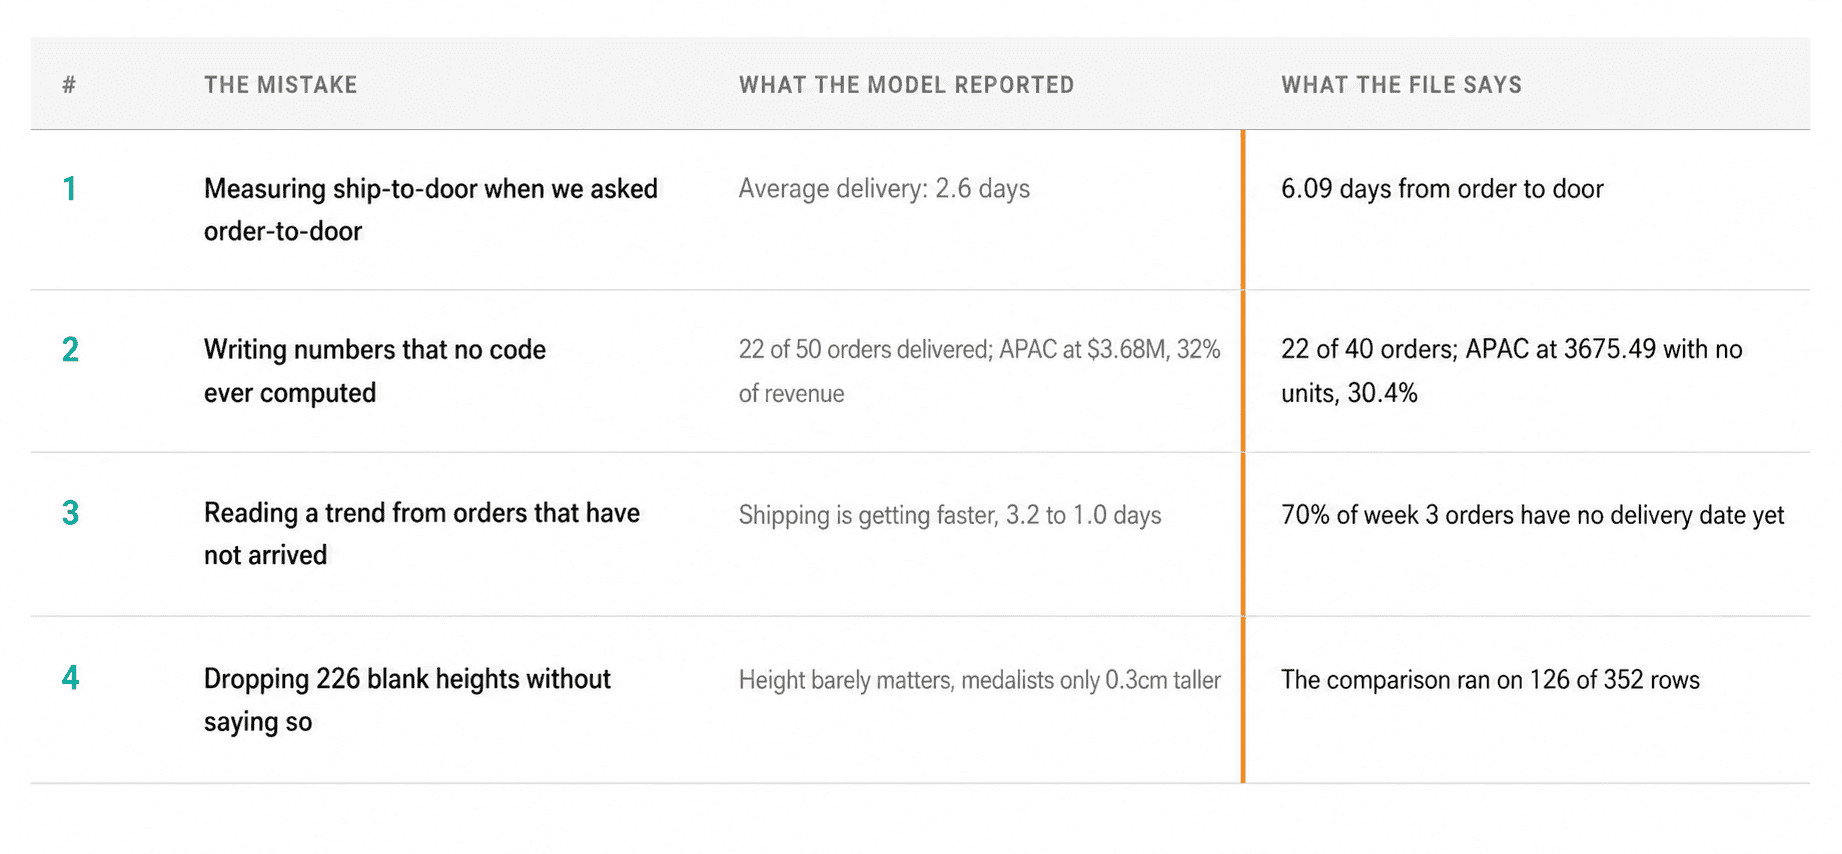
เมื่อถามหาเวลาจัดส่งเฉลี่ย AI กลับคำนวณจากวันที่ส่งออกจากคลังถึงบ้าน (shipped-to-door) แทนที่จะเป็นตั้งแต่วันที่ลูกค้าสั่งซื้อ (ordered-to-door)
df['delivery_days'] = (df['delivered_date'] - df['shipped_date']).dt.days
print(f"Avg delivery: {df['delivery_days'].mean():.1f} days")
ผลลัพธ์ที่ได้คือ 2.6 วัน ซึ่งน้อยกว่าความเป็นจริงที่ควรจะเป็น 6.09 วันถึง 2.4 เท่า ข้อผิดพลาดนี้ตรวจจับได้ยากเพราะโค้ดรันได้ปกติไม่มีบั๊ก แต่เป็นการเลือกคอลัมน์ผิดที่ต้องใช้คนอ่านทบทวนเท่านั้น
ข้อผิดพลาดที่ 2: แต่งตัวเลขที่ไม่มีอยู่จริง
AI เขียนสรุปว่ามี 50 คำสั่งซื้อ ทั้งที่ไฟล์จริงมีเพียง 40 แถว นอกจากนี้ในการวิเคราะห์ยอดขายภูมิภาค มันยังรายงานยอดขาย APAC ว่าสูงถึง 3.68 ล้านดอลลาร์ ซึ่งเป็นการขยายตัวเลขขึ้นเองพันเท่าและใส่สกุลเงินให้ทั้งที่ในไฟล์ไม่มีระบุไว้
สิ่งที่น่ากลัวคือ AI สามารถสร้างตรรกะปลอมที่ดูสมเหตุสมผลในตัวเอง เช่น การลบเลขที่ผิดแต่ได้ผลลัพธ์ที่สอดคล้องกัน ทำให้ผู้อ่านที่ไม่ได้ตรวจสอบโค้ดอย่างละเอียดหลงเชื่อได้ง่าย
ข้อผิดพลาดที่ 3: ตีความแนวโน้มจากข้อมูลที่ไม่ครบถ้วน
AI สรุปว่าการจัดส่งเร็วขึ้นในสัปดาห์ที่ 3 โดยอ้างตัวเลข 1.0 วัน เทียบกับสัปดาห์แรก 3.2 วัน แต่ความจริงคือคำสั่งซื้อในสัปดาห์ที่ 3 ส่วนใหญ่ยังส่งไม่ถึง ข้อมูลที่นำมาเฉลี่ยจึงมีเฉพาะรายการที่บังเอิญส่งเร็วเท่านั้น
การตัดค่าว่าง (Null) ทิ้งโดยไม่พิจารณาบริบทว่า "ยังมาไม่ถึง" ทำให้ AI สร้างภาพลวงตาของประสิทธิภาพที่ดูเหมือนจะดีขึ้น ทั้งที่ในความเป็นจริงมีงานค้างสะสมเพิ่มขึ้นจาก 20% เป็น 70%
ข้อผิดพลาดที่ 4: ตัดข้อมูลสำคัญทิ้งโดยไม่แจ้งให้ทราบ
ในการวิเคราะห์ความสูงของนักกีฬา AI สรุปว่าความสูงไม่มีผลต่อการชนะเหรียญ โดยคำนวณจากข้อมูลเพียง 126 แถว และตัดอีก 226 แถวที่มีค่าความสูงว่างเปล่าทิ้งไปเงียบๆ
จากการตรวจสอบพบว่า ข้อมูลที่ว่างเปล่าส่วนใหญ่เป็นนักกีฬายุคเก่าที่มีอัตราการได้เหรียญต่ำกว่า การที่ AI วิเคราะห์เฉพาะข้อมูลยุคใหม่ที่มีบันทึกครบถ้วนจึงทำให้ผลการวิเคราะห์เอนเอียงและไม่สะท้อนความเป็นจริงของชุดข้อมูลทั้งหมด
เมื่อสั่งให้ AI ตรวจสอบงานตัวเอง
เราลองให้ AI ตรวจสอบคำตอบที่ผิดพลาดเหล่านั้น ผลคือมันแก้ไขตัวเลขที่แต่งขึ้นเองได้บางจุด แต่กลับให้การรับรองข้อสรุปที่ผิดในข้ออื่นๆ อย่างหน้าตาเฉย
ในการวิเคราะห์โอลิมปิก การตรวจสอบของ AI ยิ่งทำให้แย่ลง โดยมันสร้างตัวเลขค่าเฉลี่ยใหม่ที่ไม่มีอยู่จริงในชุดข้อมูลมาหักล้างตัวเลขเดิม และเปลี่ยนข้อสรุปกลับไปกลับมาด้วยน้ำเสียงที่มั่นใจแต่ปราศจากหลักฐานที่ถูกต้อง
บทสรุป
แม้ AI จะเขียนโค้ดได้เก่งและทำงานเชิงกลไกได้รวดเร็ว แต่ความเข้าใจในบริบทที่ "ไม่ได้ระบุในไฟล์" ยังคงเป็นจุดอ่อนร้ายแรง การตรวจสอบตัวชี้วัดและที่มาของตัวเลขยังคงเป็นหน้าที่สำคัญของมนุษย์ที่ทิ้งไม่ได้ เพราะการตรวจสอบของ AI อาจยืนยันว่าสิ่งที่ผิดนั้นถูกต้องเสมอ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร