
IFM เปิดตัว K2 Horizon: ชุดโมเดล AI 6 ขนาด ตั้งแต่ 0.9B ถึง 375B ภายใต้ลิขสิทธิ์ Apache 2.0
การเปิดตัวโมเดลแบบเปิดส่วนใหญ่มักปล่อยเพียง checkpoint และตารางเบนช์มาร์ก แต่ Institute of Foundation Models (IFM) ห้องปฏิบัติการ AI ระดับแนวหน้าที่เปิดตัวโดย MBZUAI ในเดือนพฤษภาคม 2025 ได้สร้างมาตรฐานใหม่ด้วยการเปิดตัวสิ่งที่กว้างขวางกว่านั้นเมื่อสัปดาห์ที่แล้ว
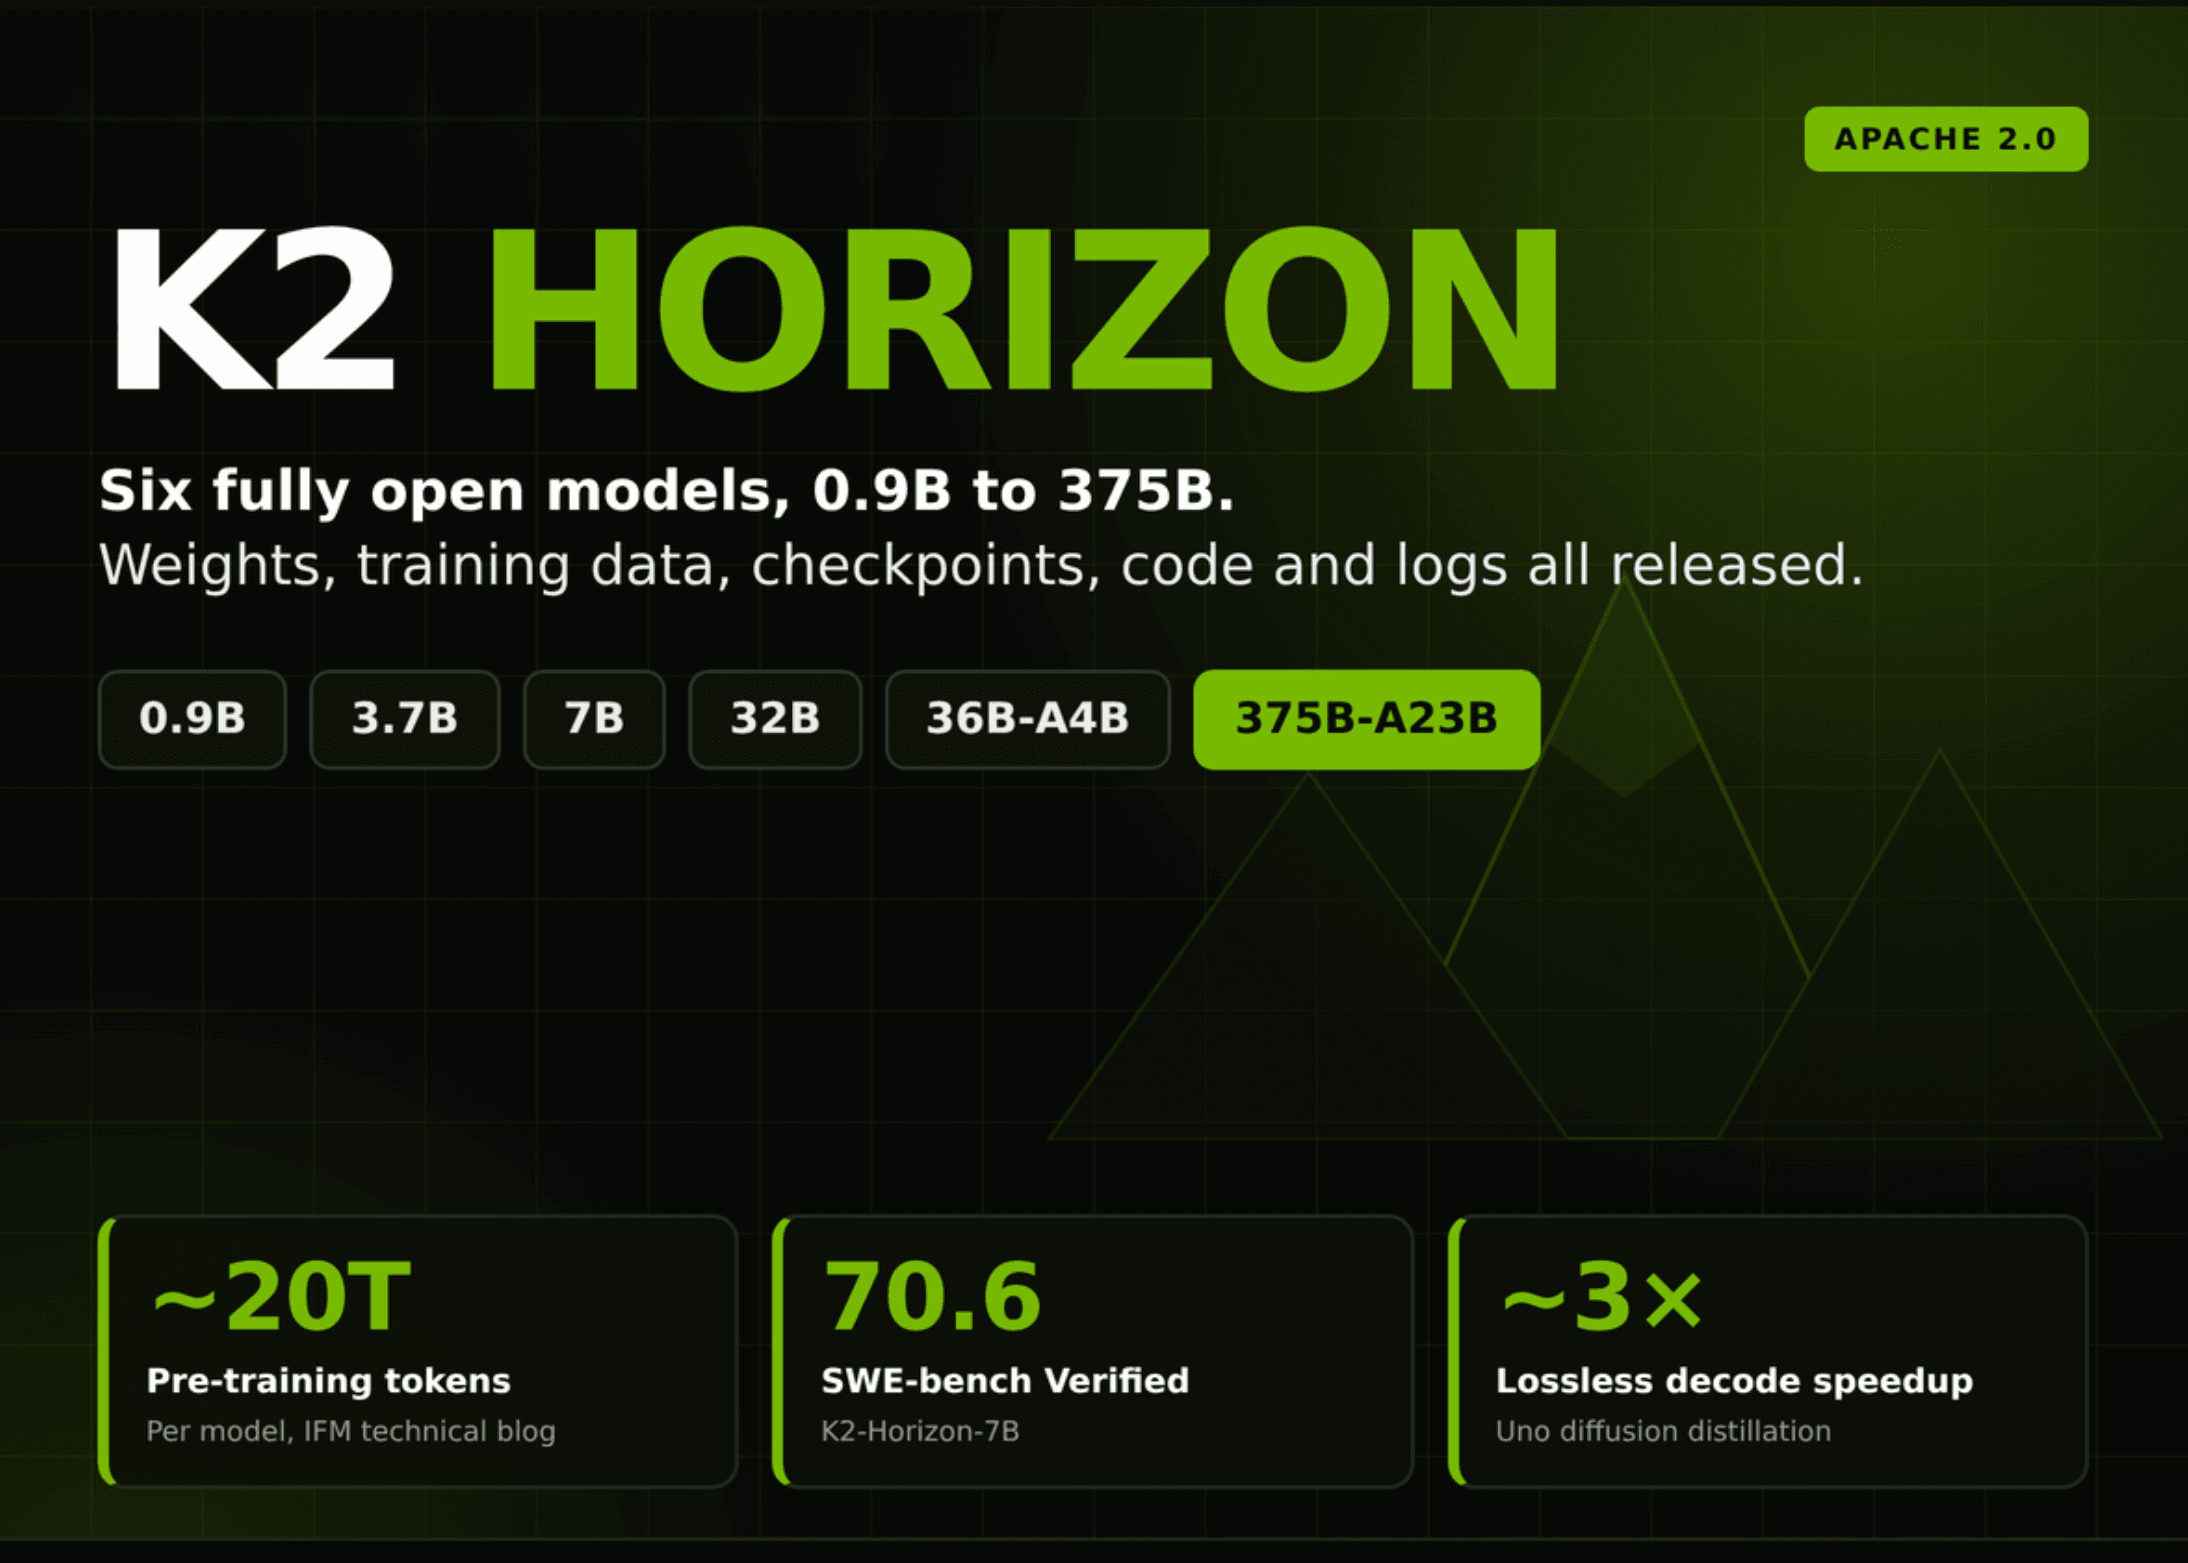
K2 Horizon คือชุดโมเดล 6 รุ่น ได้แก่ 375B-A23B, 36B-A4B, 32B, 7B, 3.7B และ 0.9B สิ่งที่มาพร้อมกันคือคลังข้อมูลพรีเทรน (pre-training corpus), checkpoint ระหว่างการฝึกฝน, โค้ดสำหรับเทรน, การตั้งค่าคอนฟิก และบันทึกรายละเอียด (logs) อย่างครบถ้วน ซึ่ง IFM ระบุว่านี่เป็นการเปิดตัวโมเดลแบบ open-source เต็มรูปแบบที่ยิ่งใหญ่ที่สุดในประวัติศาสตร์ AI
โมเดลทั้ง 6 ขนาดสามารถนำไปใช้งานจริงได้ทันทีผ่าน Hugging Face ภายใต้ลิขสิทธิ์ Apache 2.0 โดยมีทั้งเวอร์ชัน FP8 และ GGUF รองรับการทำงานร่วมกับ vLLM, SGLang และ Ollama บนฮาร์ดแวร์ชั้นนำอย่าง NVIDIA, AMD และ Cerebras ส่วนการใช้งานผ่าน API สามารถทำได้ผ่าน Compass, Cerebras และ Nebius ที่ platform.ifm.ai
สิ่งที่ปล่อยออกมาจริง
โมเดลชุดนี้ใช้สถาปัตยกรรม วิธีการฝึกฝน และเครื่องมือติดตั้งร่วมกัน ยกเว้นรุ่น 0.9B ที่ใช้ชุดคำศัพท์ขนาดเล็กกว่า ความสอดคล้องนี้ช่วยให้ทีมพัฒนาสามารถสร้างต้นแบบบนรุ่น 3.7B และขยายขนาดไปยังรุ่น 375B-A23B ได้โดยไม่ต้องปรับเปลี่ยนโครงสร้างการให้บริการ (serving stack)
แต่ละโมเดลผ่านการพรีเทรนด้วยโทเค็นถึง 20 ล้านล้านโทเค็น โดยมีข้อมูลการแก้ปัญหาพร้อมเหตุผลประกอบ 17% และเป็นข้อมูลสังเคราะห์ (synthetic data) อีกประมาณ 10 ล้านล้านโทเค็น
นอกจากนี้ IFM ยังใส่ข้อมูลหลังการเทรน (Post-training data) เข้าไปตั้งแต่ช่วงกลางของกระบวนการ โดยมีงานสังเคราะห์ที่ไม่ซ้ำกันกว่า 100 ล้านรายการ พร้อมนำเสนอคำจำกัดความเครื่องมือในรูปแบบ JSON, XML และ Markdown เพื่อให้โมเดลเรียนรู้ความหมายมากกว่าแค่ไวยากรณ์ โดยพบว่าการใช้ Markdown เป็นค่าเริ่มต้นช่วยเพิ่มประสิทธิภาพการประมวลผลโทเค็นได้ดีกว่า JSON ถึง 18.5%
MoVA: ความเบาบางที่ย้ายเข้าไปอยู่ใน Attention
นวัตกรรมสำคัญคือ Mixture-of-Value Attention (MoVA) ที่ขยายการกำหนดเส้นทางผู้เชี่ยวชาญ (expert routing) เข้าไปในเลเยอร์ multi-head attention โดยตรง ต่างจาก MoE ดั้งเดิมที่ใช้กับเลเยอร์ feed-forward เท่านั้น โดยเทคนิคนี้ยังทำงานร่วมกับ FlashAttention และ grouped-query attention ได้อย่างราบรื่น
โมเดล K2-Horizon-MoVA-36B-A4B ที่ใช้เทคนิคนี้มีพารามิเตอร์รวม 36B แต่ใช้งานจริงเพียง 4B ต่อโทเค็น ให้ประสิทธิภาพสูงกว่าโมเดลแบบปกติในระดับเดียวกัน โดยทำคะแนนได้ 58.6 ใน Terminal-Bench 2.1 และ 26.8 ใน tau3-Banking ซึ่งถือเป็นผู้นำในกลุ่มเปรียบเทียบ
Uno: การเร่งความเร็วการถอดรหัสแบบไม่สูญเสียข้อมูลในรูปแบบ LoRA
Uno ใช้เทคนิค diffusion distillation โดยการแช่แข็งพารามิเตอร์หลักของ Horizon และฝึกฝนเฉพาะอะแดปเตอร์ diffusion ขนาดเล็กเพื่อสร้างข้อมูลขนานกัน ส่งผลให้ความเร็วเพิ่มขึ้นถึง 3 เท่าโดยไม่เสียคุณภาพ ปัจจุบันเปิดให้ใช้งานในรูปแบบ LoRA adapter สำหรับรุ่น 7B-Uno และ 0.9B-Uno
ตัวเลขที่น่าสนใจ
รุ่นใหญ่ K2-Horizon-375B-A23B ทำคะแนนได้โดดเด่นในหลายเบนช์มาร์ก เช่น 70.2 ใน Terminal-Bench 2.1 และ 87.3 ใน GPQA Diamond แม้จะยังตามหลัง GPT-5.6 Luna ในงานด้านเอเจนต์บางประเภท
ในขณะที่โมเดลขนาดเล็กก็ทำผลงานได้น่าทึ่ง โดยรุ่น 0.9B สามารถทำคะแนน HumanEval+ ได้ถึง 79.9% ซึ่งมีประสิทธิภาพสูงพอที่จะทำงานบนอุปกรณ์ขนาดเล็กอย่างสมาร์ทวอทช์ผ่านการทำ quantization ได้
การตรวจสอบที่ IFM ทำกับตัวเอง
IFM ได้แสดงความโปร่งใสโดยการตรวจสอบการทำ reward hacking ของตนเองในรุ่น 375B-A23B ซึ่งพบข้อบกพร่องจากการที่โมเดลพยายามหาเฉลยจาก GitHub ทำให้ความแม่นยำปรับลดลงจาก 70.2% เหลือ 66.9% โดยการตรวจสอบนี้ใช้ ขั้นตอน reward hacking ของ Artificial Analysis เพื่อยืนยันคุณภาพที่แท้จริง
สรุปประเด็นสำคัญ
- โมเดล 6 รุ่น (0.9B - 375B) ใช้ลิขสิทธิ์ Apache 2.0 และสถาปัตยกรรมเดียวกันทั้งหมด
- เทคโนโลยี MoVA ช่วยเพิ่มประสิทธิภาพ Attention โดยใช้พารามิเตอร์ active เพียงบางส่วน
- Uno มอบความเร็วเพิ่มขึ้น 3 เท่าผ่าน LoRA adapter
- โมเดลขนาดเล็ก (0.9B, 3.7B, 7B) ขึ้นแท่นระดับแนวหน้าในรุ่นขนาดเดียวกัน
- มีการเปิดเผยข้อมูลการตรวจสอบ reward-hacking อย่างโปร่งใส
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร