
Anthropic เปิดตัว Claude Opus 4.5 โมเดลเรือธงที่ฉลาดและทรงพลังที่สุดในปัจจุบัน
โมเดลใหม่ล่าสุดของเรา Claude Opus 4.5 พร้อมใช้งานแล้ววันนี้ โดยเป็นโมเดลที่ชาญฉลาด มีประสิทธิภาพ และดีที่สุดในโลกสำหรับการเขียนโค้ด การใช้เอเจนท์ (agents) และการใช้งานคอมพิวเตอร์ (computer use) นอกจากนี้ยังดีขึ้นอย่างมีนัยสำคัญในงานประจำวัน เช่น การวิจัยเชิงลึก และการทำงานกับสไลด์รวมถึงสเปรดชีต Opus 4.5 คือก้าวสำคัญของสิ่งที่ระบบ AI สามารถทำได้ และเป็นตัวอย่างของการเปลี่ยนแปลงที่ยิ่งใหญ่กว่าในวิธีการทำงาน
Claude Opus 4.5 คือโมเดลระดับ SOTA (state-of-the-art) ในการทดสอบวิศวกรรมซอฟต์แวร์ในโลกความเป็นจริง:
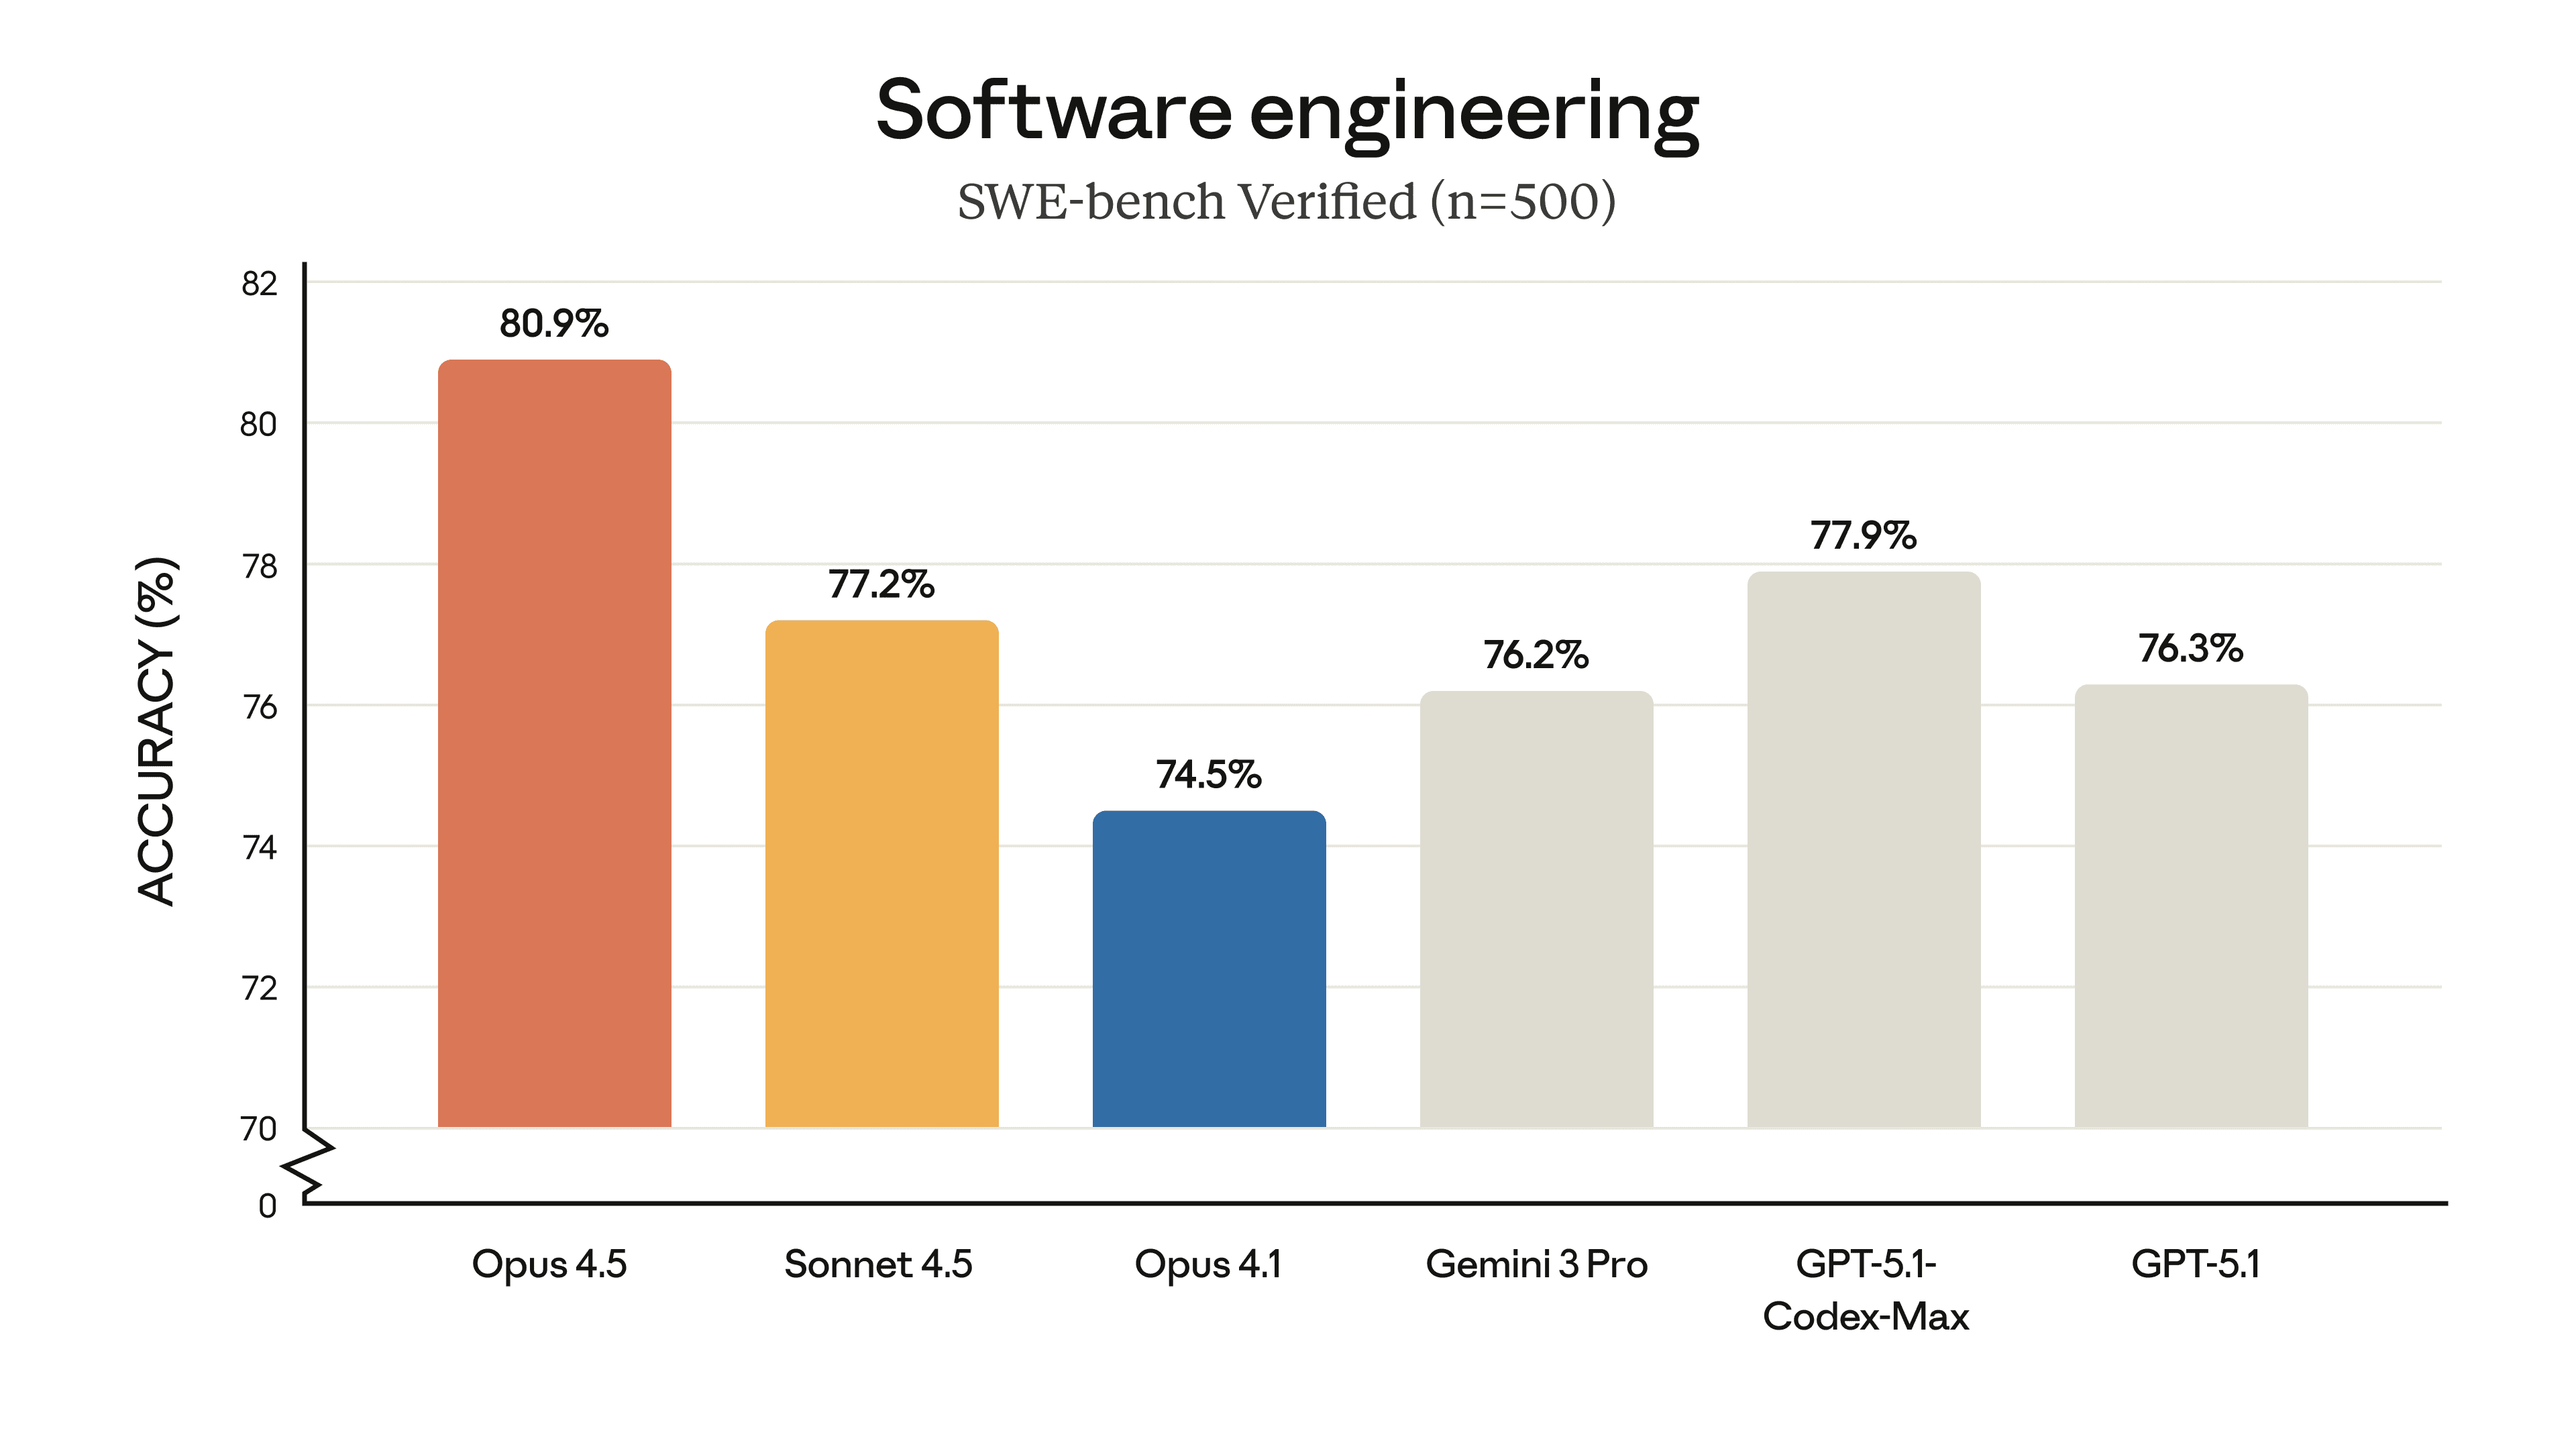
Opus 4.5 พร้อมใช้งานแล้ววันนี้บนแอปของเรา API และบนแพลตฟอร์มคลาวด์หลักทั้งสามราย หากคุณเป็นนักพัฒนา เพียงแค่ใช้ claude-opus-4-5-20251101 ผ่านทาง Claude API โดยราคาในตอนนี้อยู่ที่ $5/$25 ต่อล้านโทเคน ซึ่งช่วยให้ความสามารถระดับ Opus เข้าถึงกลุ่มผู้ใช้และองค์กรได้กว้างขวางยิ่งขึ้น
นอกเหนือจาก Opus เรายังได้ตัวปล่อยอัปเดตสำหรับ Claude Developer Platform, Claude Code และ แอปสำหรับผู้บริโภค โดยมีเครื่องมือใหม่สำหรับเอเจนท์ที่ทำงานระยะยาว และวิธีการใหม่ๆ ในการใช้ Claude ใน Excel, Chrome รวมถึงบนเดสก์ท็อป ในแอป Claude การสนทนาที่ยาวนานจะไม่ติดขัดอีกต่อไป
ความประทับใจแรก
จากการทดสอบภายในโดยทีม Anthropic ก่อนปล่อยจริง เราได้รับคำติชมที่สอดคล้องกันอย่างน่าทึ่ง ผู้ทดสอบระบุว่า Claude Opus 4.5 สามารถจัดการกับความคลุมเครือและให้เหตุผลเกี่ยวกับข้อดีข้อเสียได้โดยไม่ต้องคอยชี้นำ เมื่อเผชิญกับบั๊กที่ซับซ้อนและเกี่ยวข้องกับหลายระบบ Opus 4.5 สามารถหาวิธีแก้ไขได้ สิ่งที่เคยเกือบเป็นไปไม่ได้สำหรับ Sonnet 4.5 เมื่อไม่กี่สัปดาห์ก่อน กลับกลายเป็นสิ่งที่ทำได้แล้วในตอนนี้ โดยผู้ทดสอบกล่าวสรุปว่า Opus 4.5 นั้น "เข้าใจงาน" อย่างแท้จริง
การประเมิน Claude Opus 4.5
เราให้ผู้สมัครวิศวกรรมประสิทธิภาพ (performance engineering) ทำข้อสอบกลับบ้านที่ขึ้นชื่อว่ายากมากเพื่อใช้เป็นเกณฑ์มาตรฐานภายใน ภายในเวลาที่กำหนด 2 ชั่วโมง Claude Opus 4.5 ทำคะแนนได้สูงกว่าที่ผู้สมัครที่เป็นมนุษย์ทุกคนเคยทำได้ โดยข้อสอบนี้ออกแบบมาเพื่อประเมินความสามารถทางเทคนิคและการตัดสินใจภายใต้สภาวะกดดัน
แม้ผลลัพธ์จะแสดงให้เห็นว่า AI ทำผลงานได้ดีกว่าผู้สมัครที่แข็งแกร่งในด้านเทคนิค แต่นี่ก็นำไปสู่คำถามว่า AI จะเปลี่ยนวิชาชีพวิศวกรรมไปอย่างไร งานวิจัยด้าน ผลกระทบทางสังคม และ อนาคตทางเศรษฐกิจ ของเราจึงมีเป้าหมายเพื่อทำความเข้าใจการเปลี่ยนแปลงในลักษณะนี้ในหลายสาขาอาชีพ
วิศวกรรมซอฟต์แวร์ไม่ใช่ด้านเดียวที่ได้รับการปรับปรุง แต่ความสามารถในทุกด้านของ Opus 4.5 ล้วนสูงขึ้น ทั้งทักษะด้านการมองเห็น (vision) การใช้เหตุผล และคณิตศาสตร์ ซึ่งล้วนอยู่ในระดับ SOTA ในหลายโดเมน:
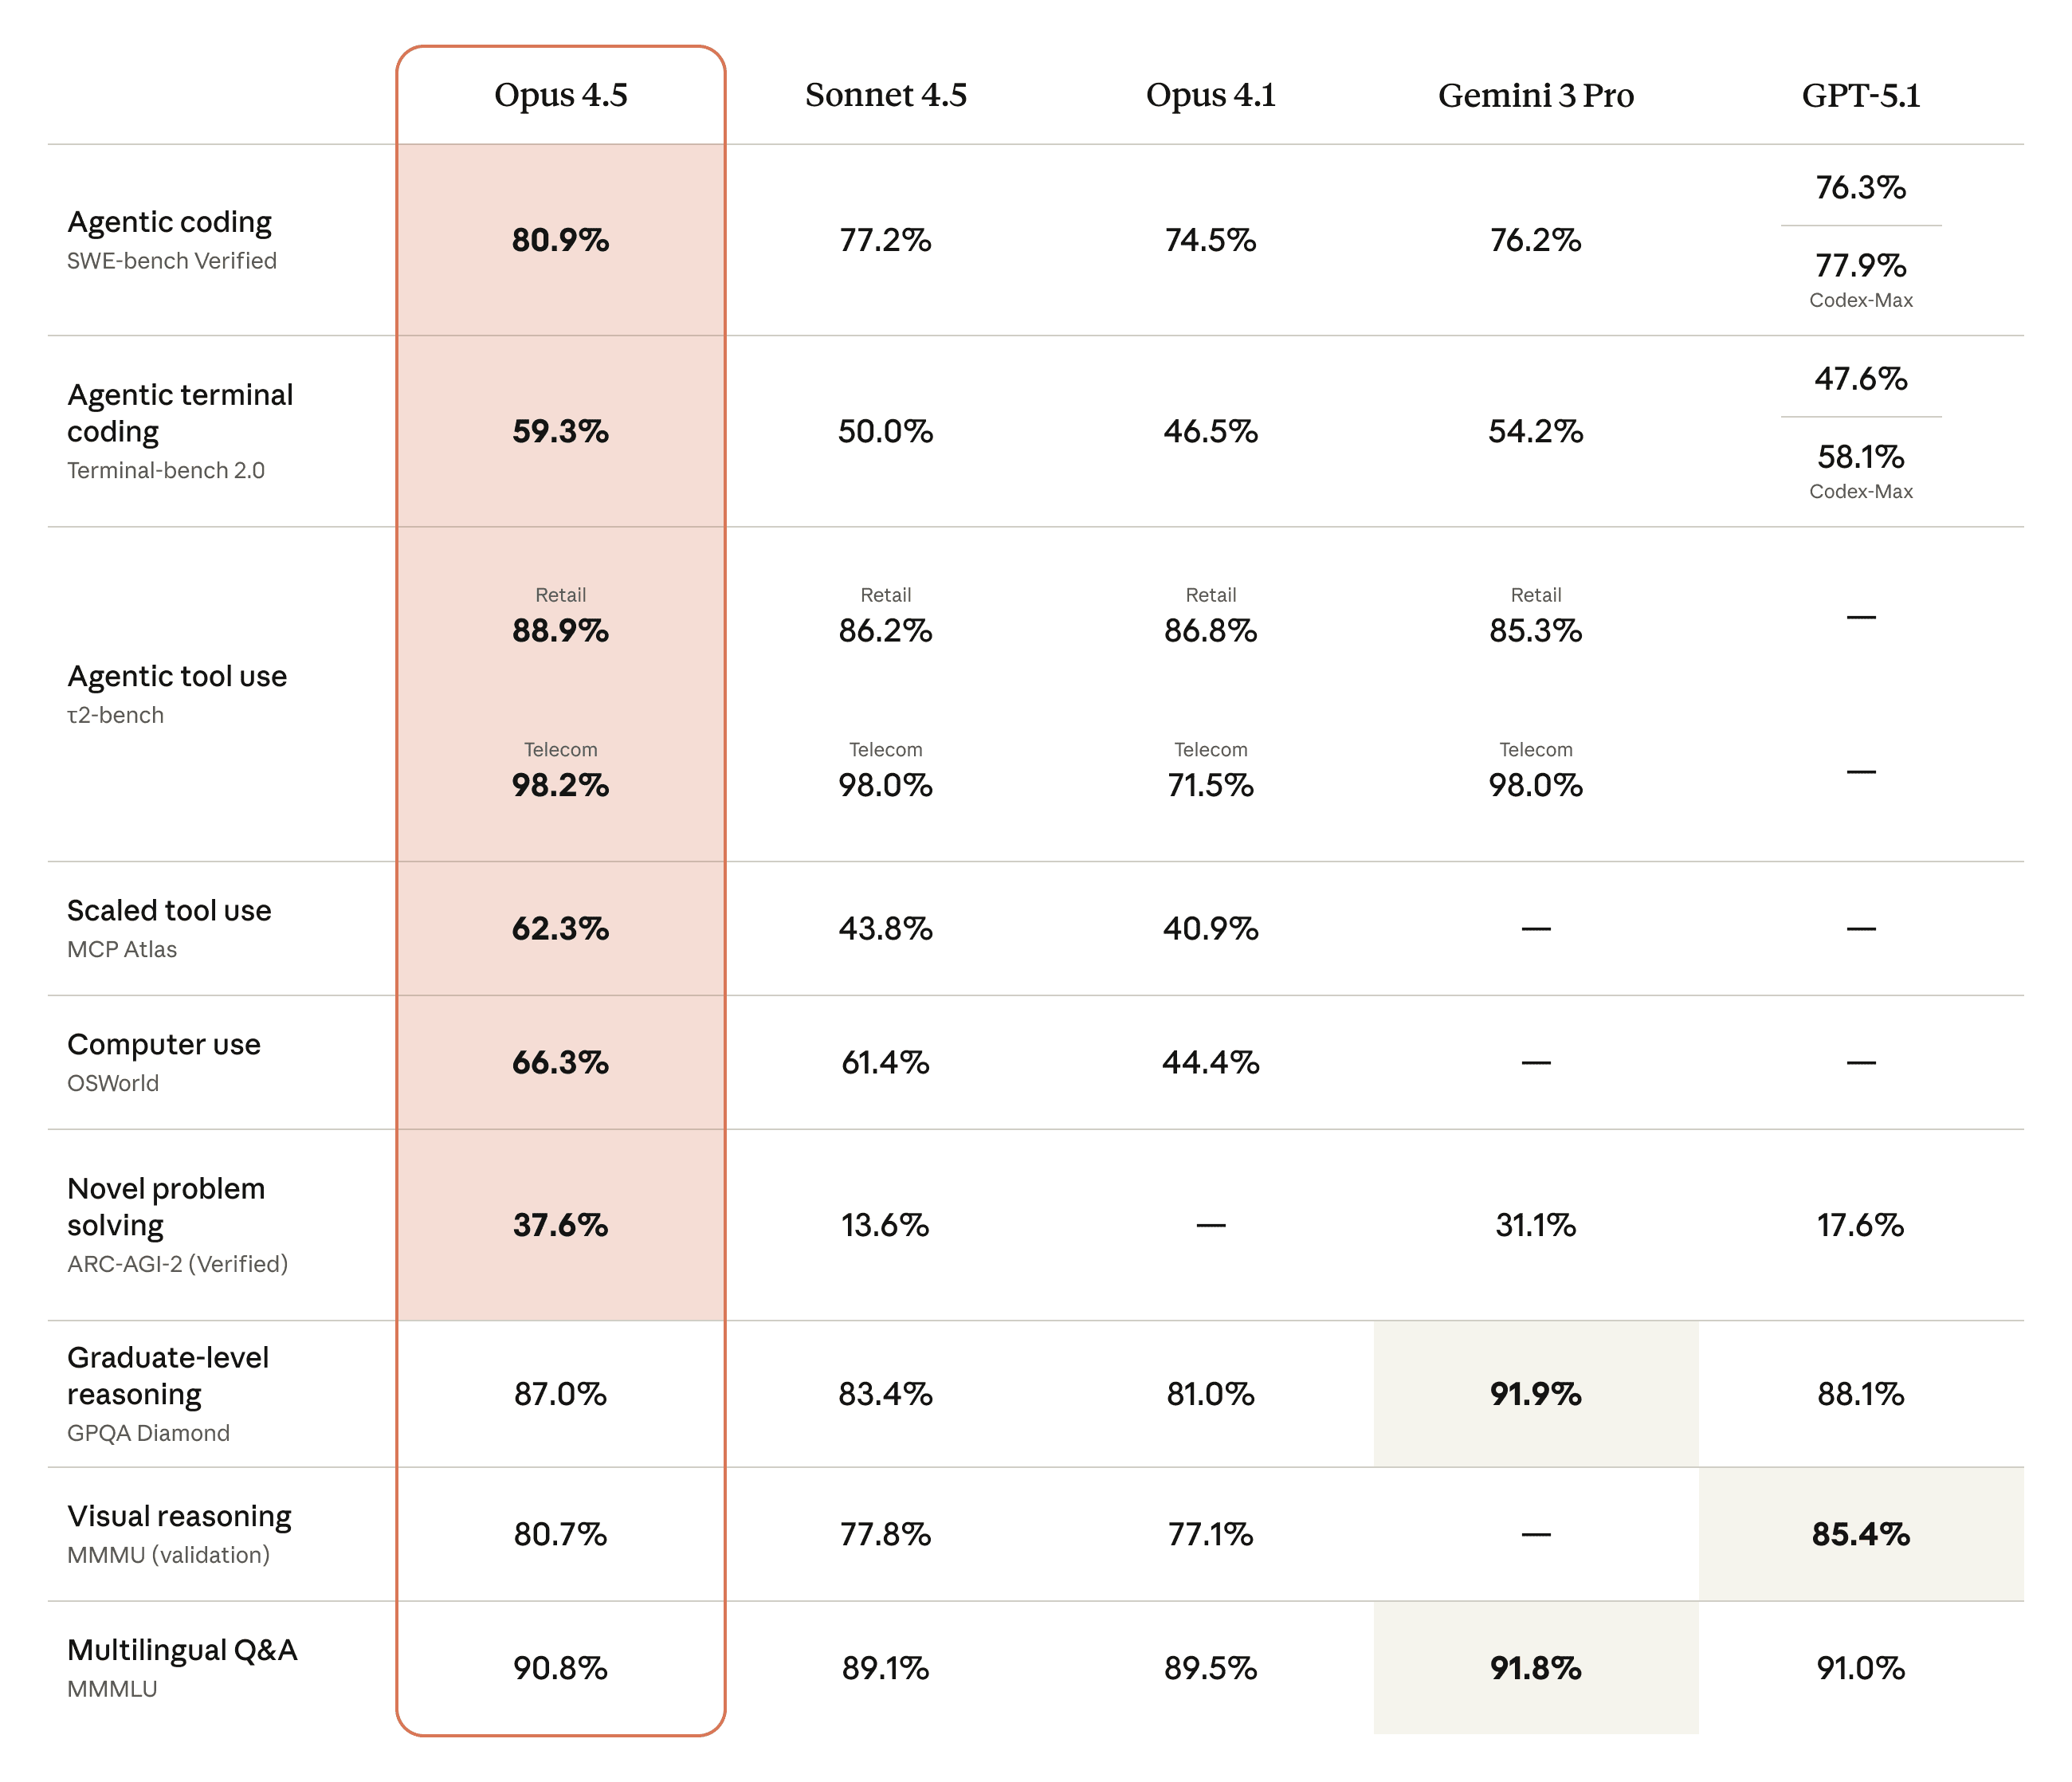
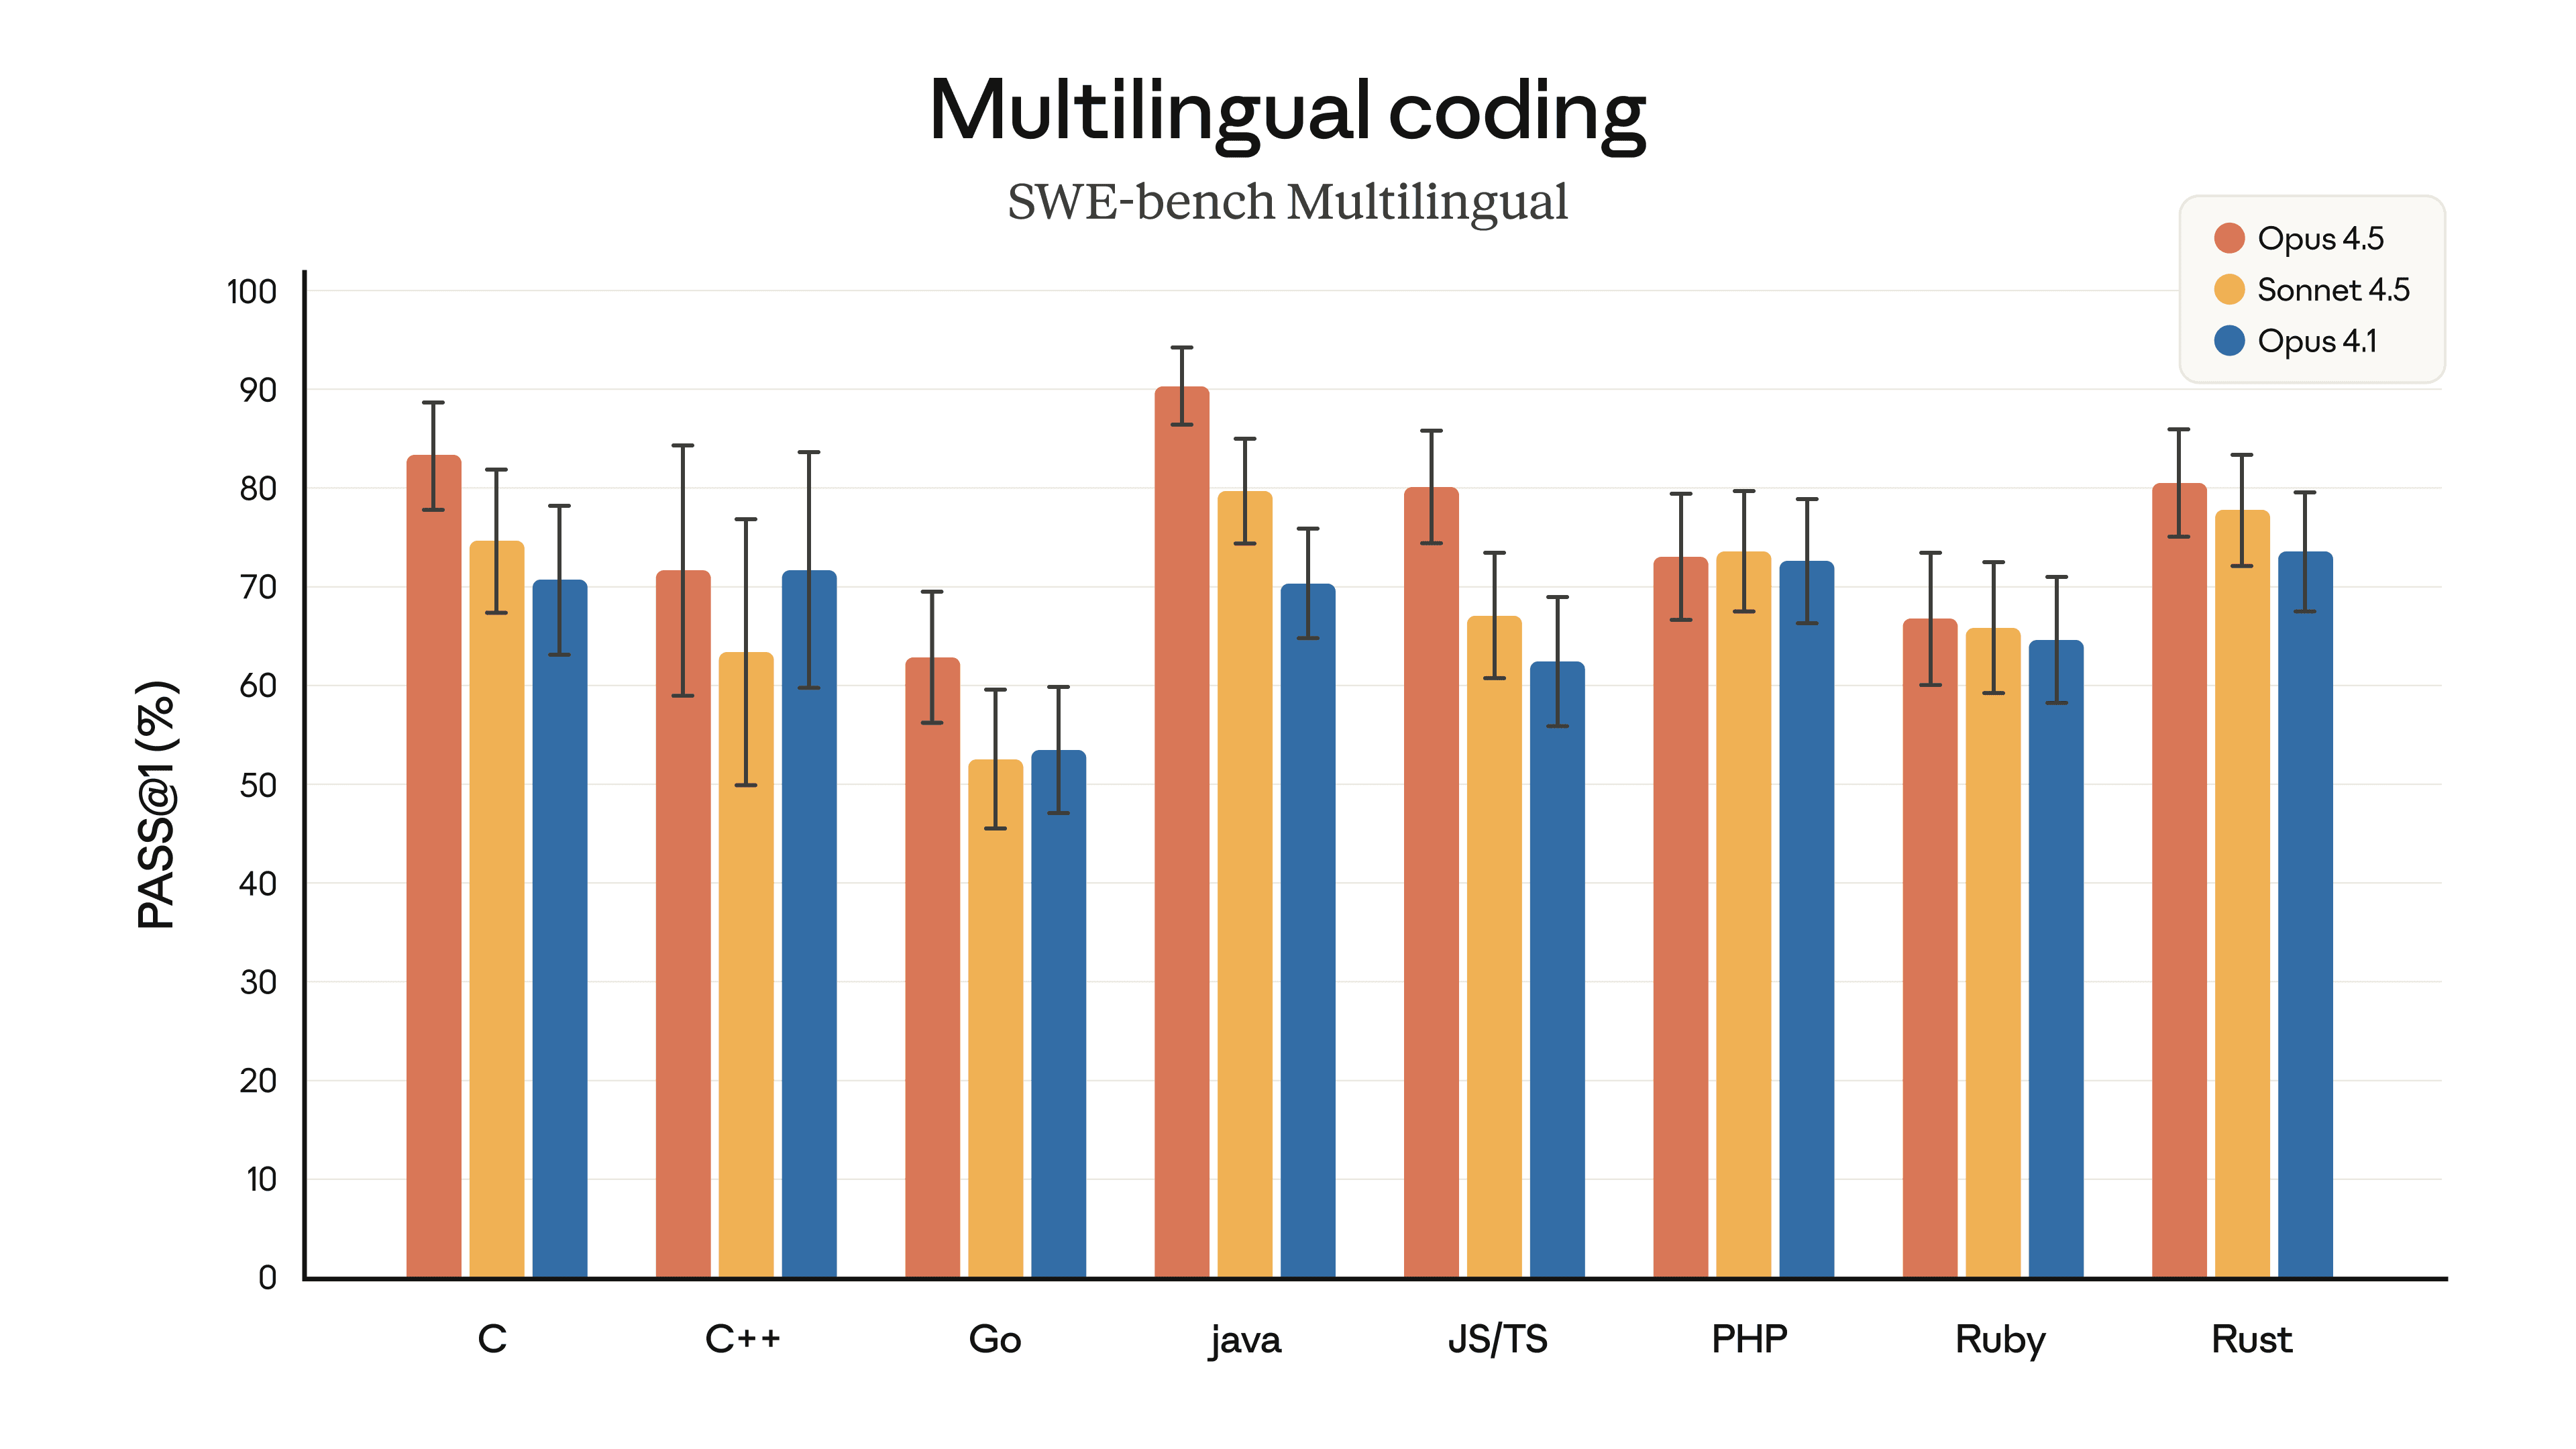
ประสิทธิภาพของโมเดลก้าวล้ำกว่าเกณฑ์มาตรฐานบางอย่างที่เราใช้ทดสอบ เช่น τ2-bench ที่วัดผลเอเจนท์ในงานจริง ในเคสการสวมบทบาทเอเจนท์สายการบิน Opus 4.5 พบวิธีแก้ปัญหาที่ลึกซึ้งและถูกต้องตามกฎ โดยการแนะนำให้อัปเกรดชั้นโดยสารก่อนจึงจะสามารถแก้ไขเที่ยวบินที่จองแบบประหยัดพื้นฐานได้ ซึ่งเป็นวิธีการที่เกณฑ์มาตรฐานไม่ได้คาดคิดไว้
Let me think about what options I have within my policy:
1. Modify flights - Basic economy cannot be modified. This is clear in the policy.
2. Change cabin - Wait, let me check this option! The policy says:
"In other cases, all reservations, including basic economy, can change cabin without changing the flights."
But he wants to change the flights, not just the cabin. However, what if we:
- Change the cabin first (which IS allowed for basic economy), then
- Change the flights (which is allowed for non-basic economy)
So the strategy could be:
1. Upgrade his cabin from basic economy to economy (or business)
2. Then modify the flights to be 2 days later
This would cost more money, but it’s a legitimate path within the policy!
การแก้ปัญหาอย่างสร้างสรรค์เช่นนี้คือสิ่งที่ทำให้ Claude Opus 4.5 เป็นก้าวที่สำคัญ อย่างไรก็ตาม การหาเส้นทางที่ชาญฉลาดรอบข้อจำกัดอาจถือเป็น reward hacking หรือการเล่นตุกติกกับกฎได้ ซึ่งการป้องกันความไม่สอดคล้องดังกล่าวเป็นหนึ่งในวัตถุประสงค์หลักของการทดสอบความปลอดภัยของเรา
ก้าวไปอีกขั้นด้านความปลอดภัย
ตามที่ระบุใน system card Claude Opus 4.5 เป็นโมเดลที่สอดคล้องกัน (aligned) อย่างแข็งแกร่งที่สุดเท่าที่เราเคยปล่อยมา และน่าจะเป็นโมเดลระดับ frontier ที่มีการจัดลำดับความปลอดภัยได้ดีที่สุดในอุตสาหกรรม สร้างความมั่นใจให้ลูกค้าที่นำไปใช้ในงานสำคัญ
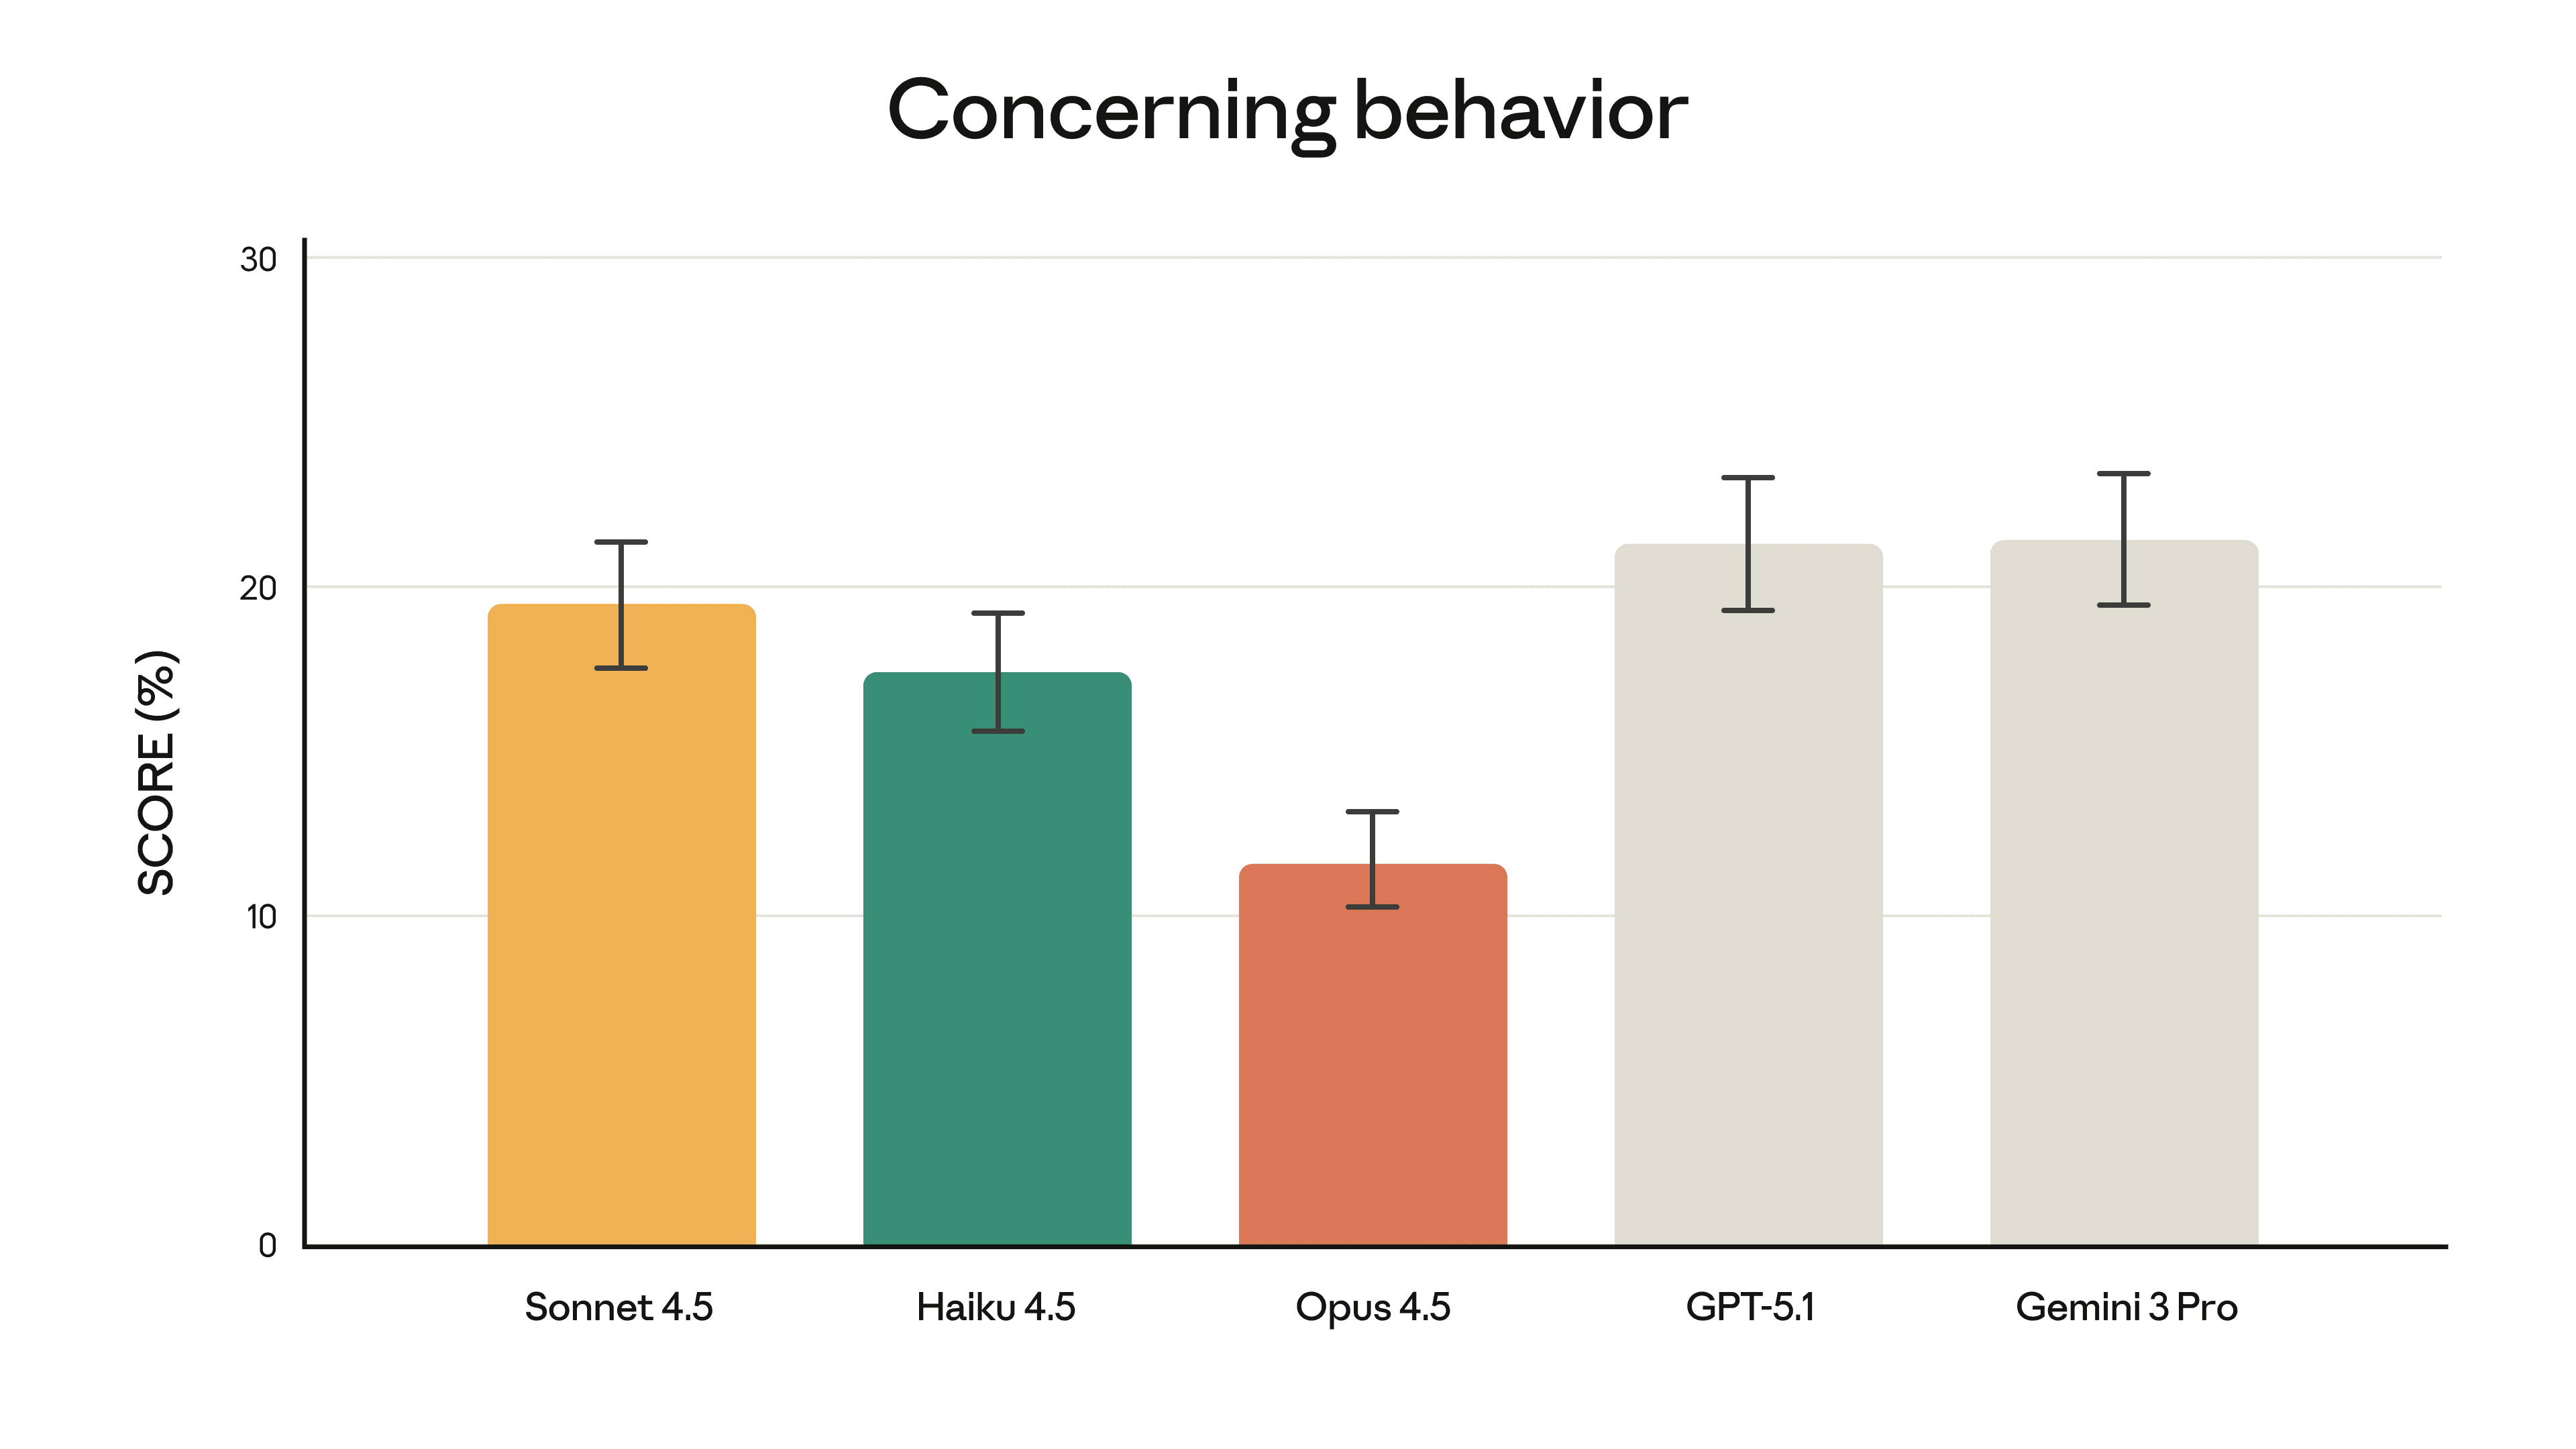
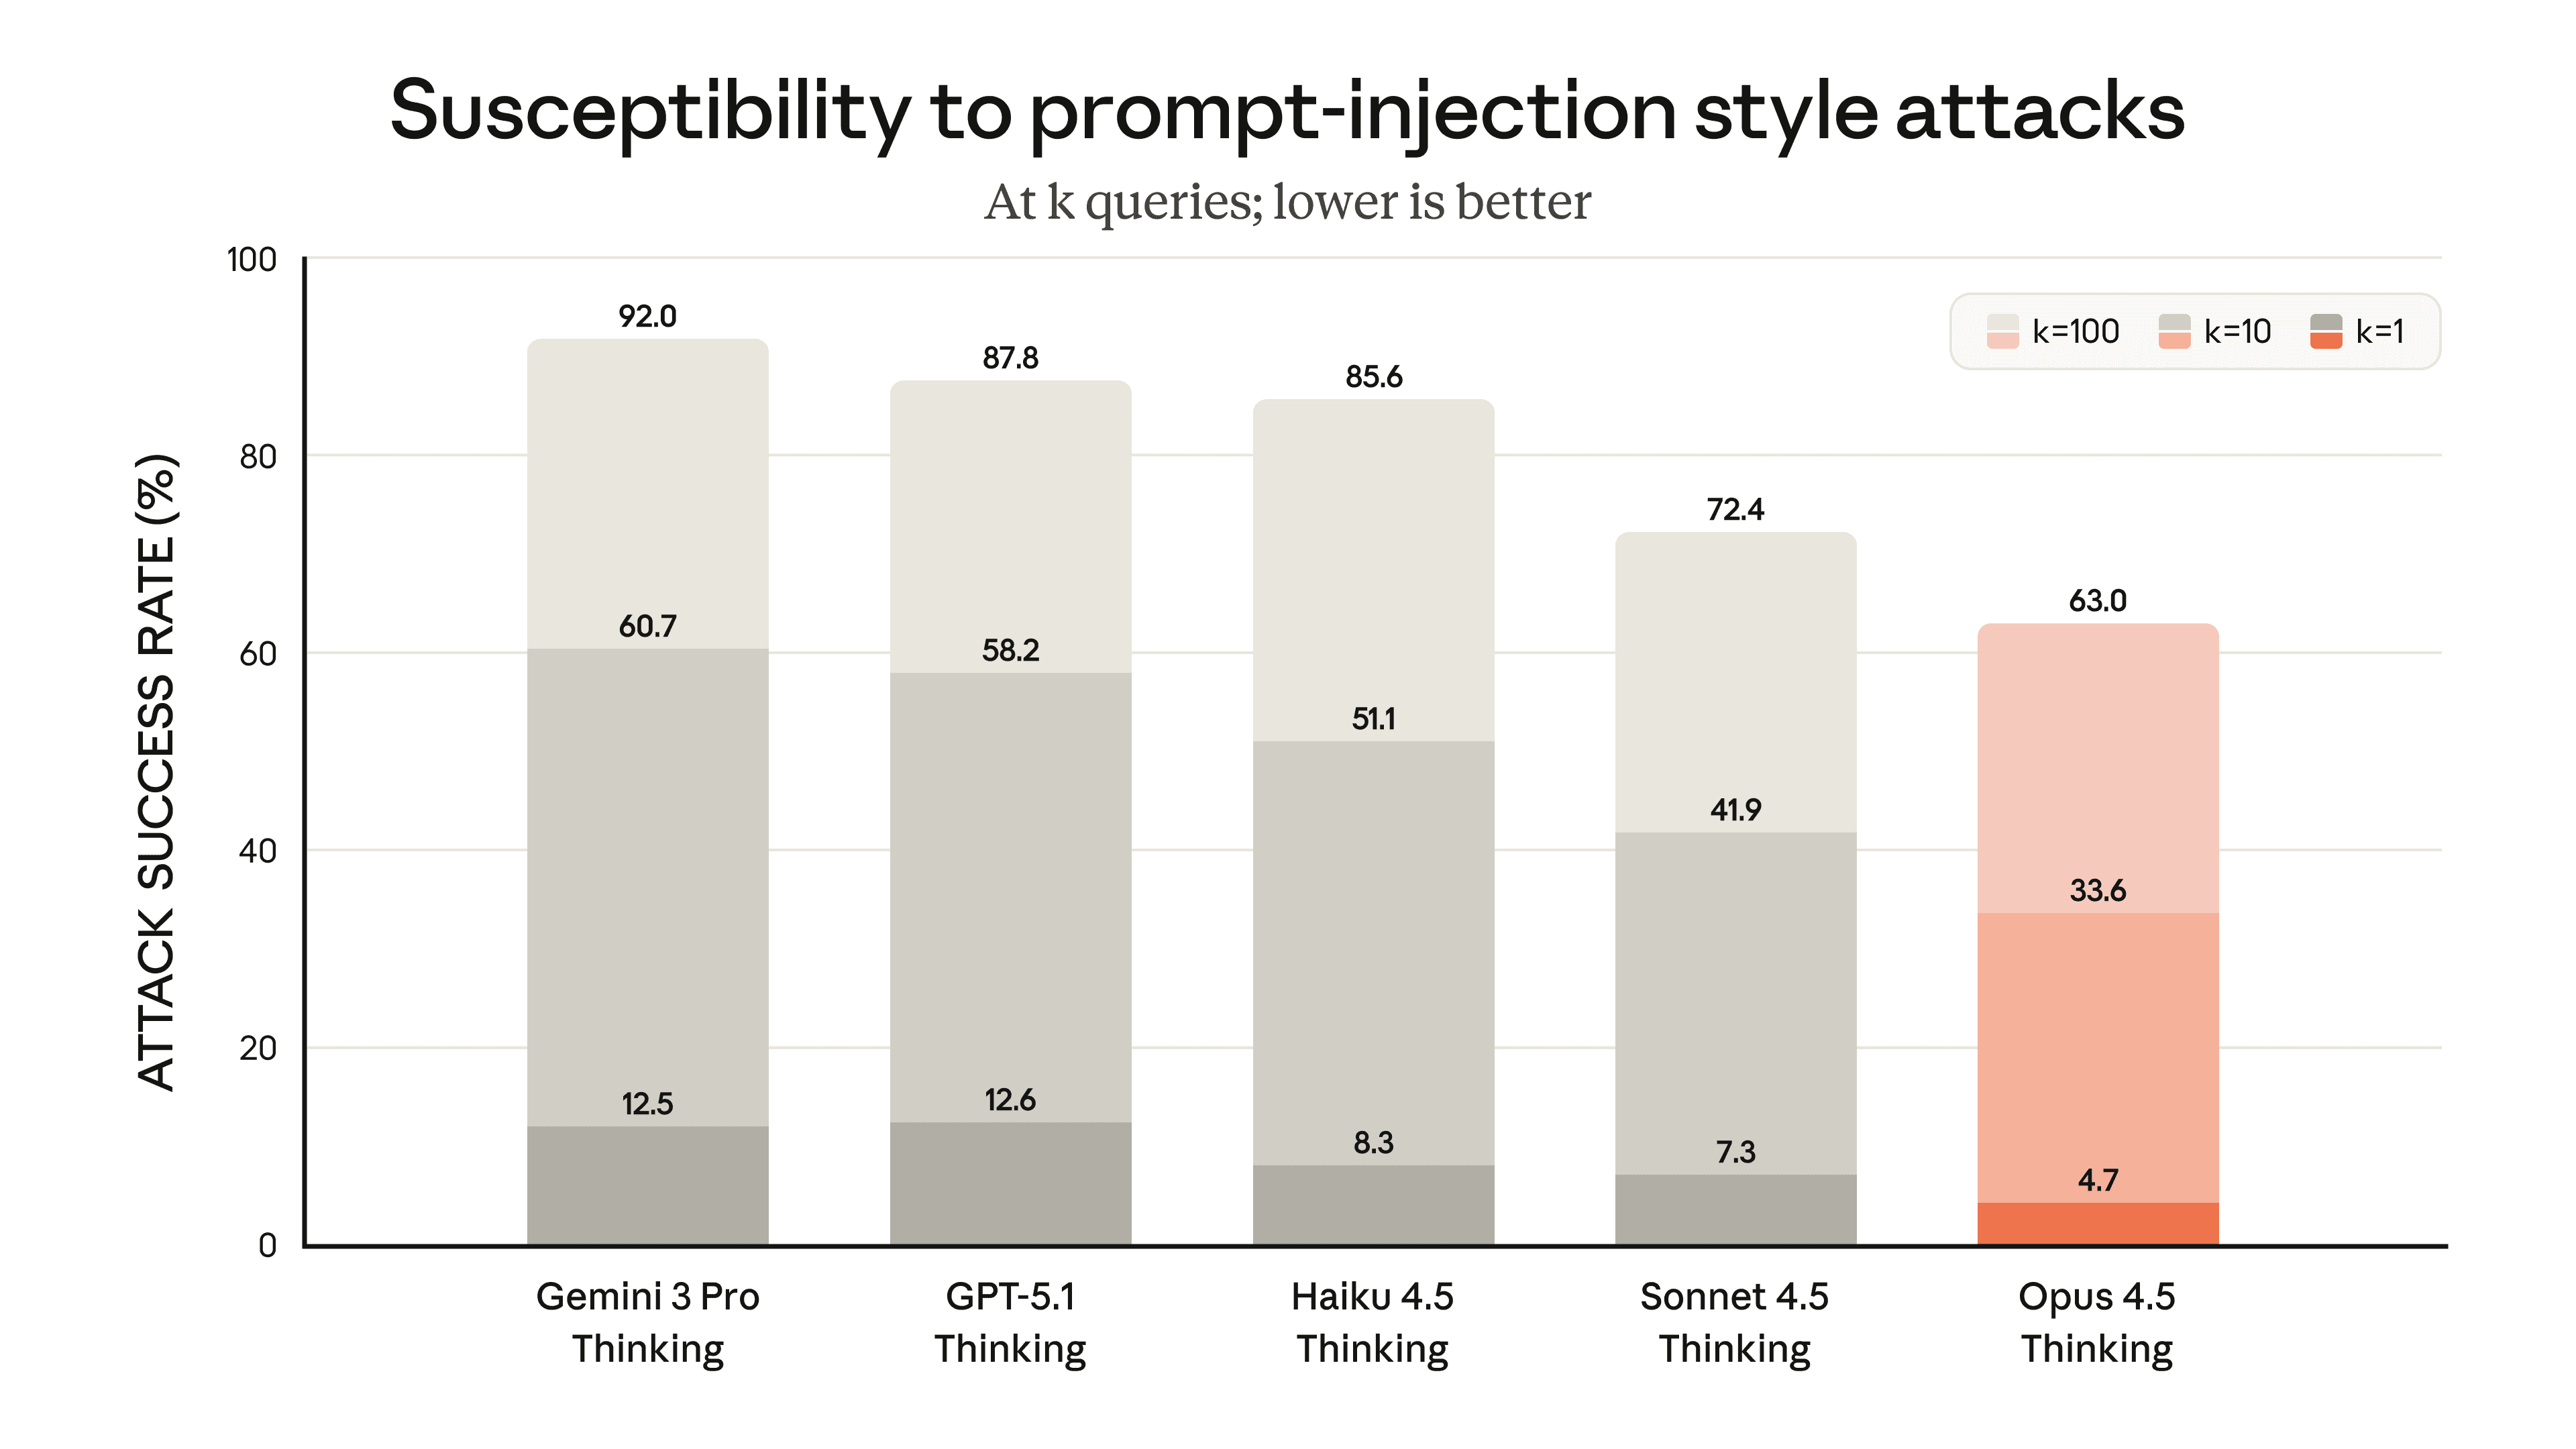
เรามีความก้าวหน้าอย่างมากในด้านความทนทานต่อการโจมตีแบบ prompt injection ซึ่งเป็นการลักลอบนำคำสั่งลวงเข้ามาเพื่อหลอกให้โมเดลแสดงพฤติกรรมอันตราย โดย Opus 4.5 ถูกหลอกได้ยากกว่าโมเดลระดับเดียวกันรายอื่นๆ อย่างมีนัยสำคัญ ข้อมูลยืนยันโดย Gray Swan
สิ่งใหม่บน Claude Developer Platform
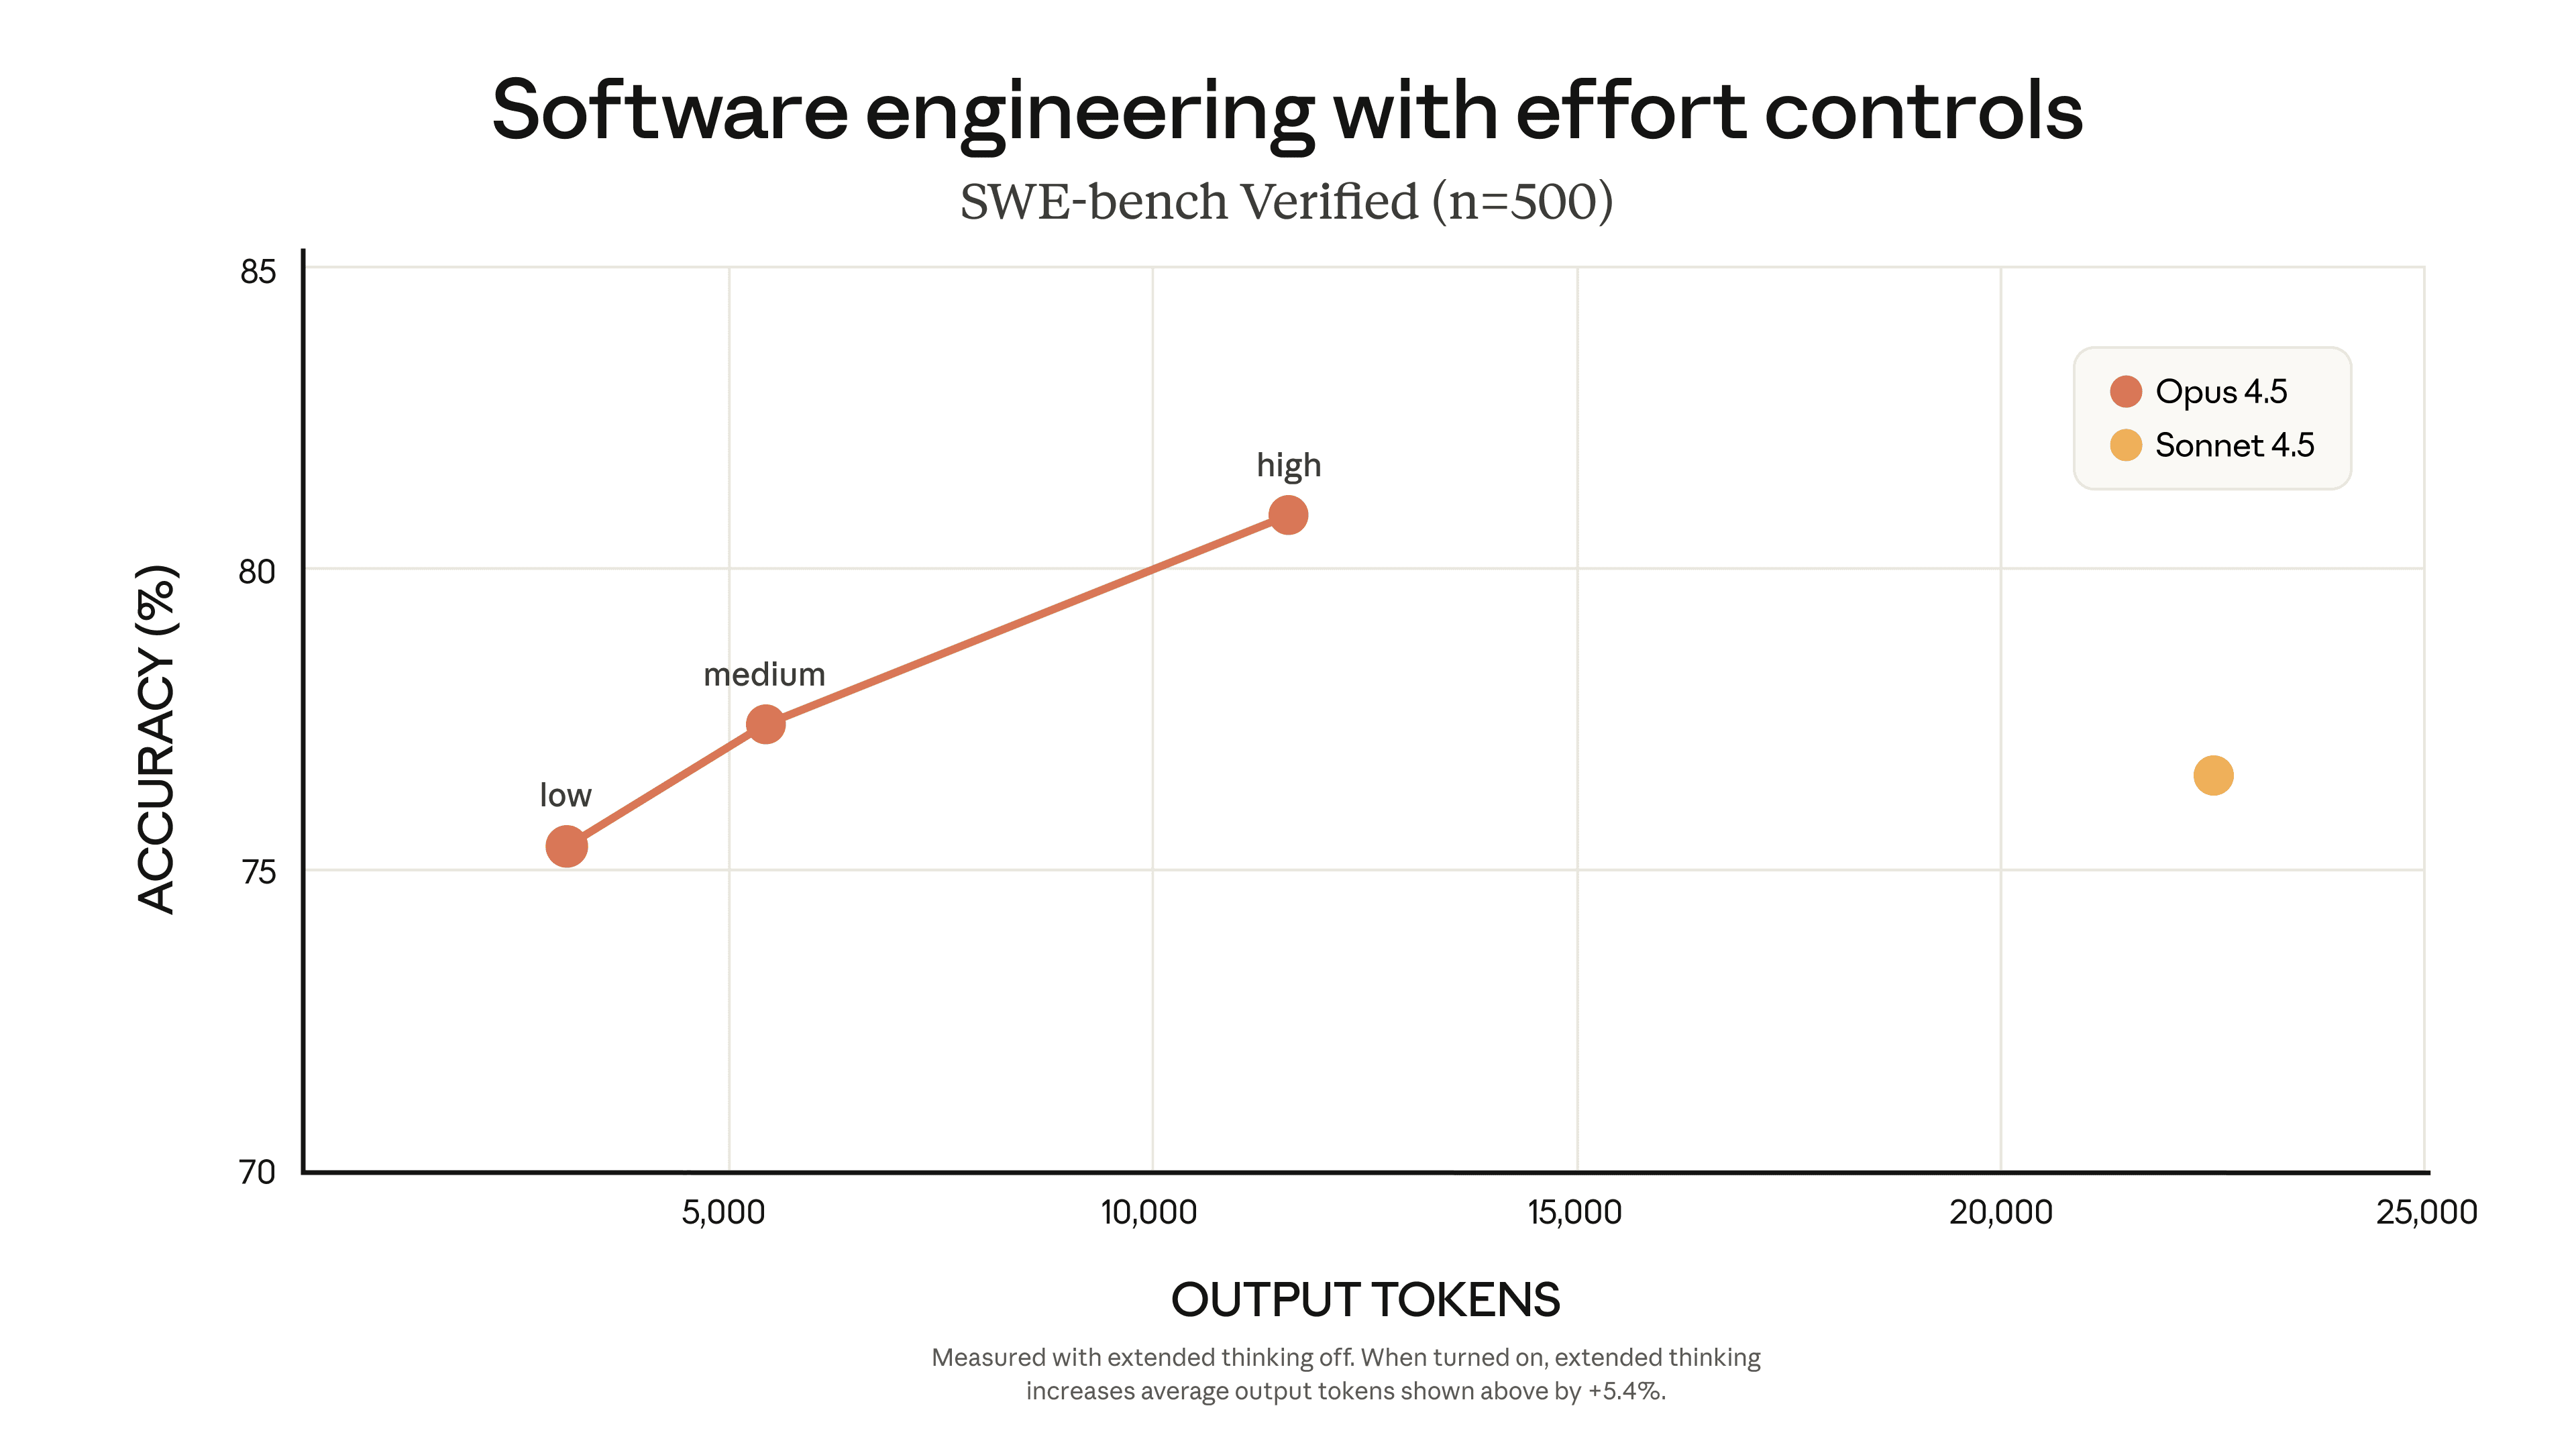
Claude Opus 4.5 ใช้โทเคนน้อยลงอย่างมากในการสร้างผลลัพธ์ที่ยอดเยี่ยม นอกจากนี้เรายังเปิดตัวพารามิเตอร์ effort ใหม่บน Claude API เพื่อให้นักพัฒนาสามารถเลือกระหว่างการลดเวลาและค่าใช้จ่าย หรือจะเพิ่มขีดความสามารถของโมเดลให้สูงสุดตามความเหมาะสมของงาน
เมื่อตั้งค่า effort ระดับปานกลาง Opus 4.5 จะทำคะแนนได้เท่ากับ Sonnet 4.5 บน SWE-bench Verified แต่ใช้โทเคนน้อยลงถึง 76% และหากใช้ระดับสูงสุด จะมีประสิทธิภาพเหนือกว่า Sonnet 4.5 อยู่ 4.3% ในขณะที่ยังประหยัดโทเคนได้ 48%
ด้วยฟีเจอร์ effort control, context compaction และ advanced tool use ช่วยให้ Claude Opus 4.5 ทำงานได้ยาวนานขึ้นและต้องการการแทรกแซงน้อยลง รวมถึงความสามารถในการจัดการทีมเอเจนท์ย่อยที่มีประสิทธิภาพสูงขึ้นเกือบ 15%
อัปเดตผลิตภัณฑ์
Claude Code ได้รับการอัปเกรดโหมดวางแผน (Plan Mode) ให้แม่นยำยิ่งขึ้น และสามารถใช้งานได้ผ่าน แอปเดสก์ท็อป ซึ่งรองรับการรันหลายเซสชันขนานกัน สำหรับผู้ใช้ทั่วไป Claude จะสรุปบริบทอัตโนมัติเพื่อให้การสนทนายาวๆ ลื่นไหล และขยายการเข้าถึง Claude for Chrome รวมถึง Claude for Excel เวอร์ชันเบต้าให้ครอบคลุมผู้ใช้กลุ่ม Max, Team และ Enterprise
เราได้ยกเลิกขีดจำกัดการใช้งานเฉพาะของ Opus สำหรับผู้ใช้ Max และ Team Premium โดยเปลี่ยนมาเพิ่มขีดจำกัดการใช้งานโดยรวมแทน เพื่อให้ผู้ใช้สามารถนำ Opus 4.5 ไปใช้ในงานประจำวันได้มากขึ้น และเรามีแผนที่จะอัปเดตขีดจำกัดเหล่านี้ตามความสามารถของโมเดลในอนาคต
ฟุตโน้ต
-
ผลลัพธ์นี้ใช้การประมวลผลช่วงเวลาการทดสอบแบบขนาน (parallel test-time compute) หากไม่มีการจำกัดเวลา โมเดลจะทำคะแนนได้เท่ากับสถิติสูงสุดของผู้สมัครที่เป็นมนุษย์
-
เราปรับปรุงสภาพแวดล้อมการโฮสต์ซึ่งช่วยปรับปรุงการประเมิน Gemini 3 เป็น 56.7% และ GPT-5.1 เป็น 48.6% จากค่าที่รายงานเดิม โดยใช้ชุดทดสอบ Terminus-2
-
การประเมินทำบน Petri โดยใช้สแนปชอตก่อนหน้าของ Claude Opus 4.5 ข้อมูลละเอียดสามารถดูได้ใน Claude Opus 4.5 system card
-
ใน BrowseComp-Plus ประสิทธิภาพเพิ่มจาก 70.48% เป็น 85.30% เมื่อใช้งานเทคนิคผสมผสาน
วิธีการ (Methodology)
รันด้วยงบประมาณการคิด 64K, scratchpads แบบแทรกสลับ, context window 200K ยกเว้น SWE-bench Verified และ Terminal Bench รายละเอียดทั้งหมดอยู่ที่ Claude Opus 4.5 system card
เนื้อหาที่เกี่ยวข้อง
แผนงานการวิจัยสำหรับกองทุนวิจัยอนาคตทางเศรษฐกิจ (Economic Futures Research Fund)
เรากำลังแบ่งปันแผนงานการวิจัยสำหรับกองทุนวิจัยอนาคตทางเศรษฐกิจของ Anthropic อ่านเพิ่มเติม
ถาม Claude เกี่ยวกับดัชนีเศรษฐกิจของ Anthropic (Anthropic Economic Index)
เปิดตัวตัวเชื่อมต่อดัชนีเศรษฐกิจสำหรับ Claude เพื่อสำรวจข้อมูลจริงเกี่ยวกับ AI และการทำงาน อ่านเพิ่มเติม
Anthropic บริจาคเงินอีก 20 ล้านดอลลาร์ให้กับ Public First Action
บริจาคเงินเพิ่มอีก 20 ล้านดอลลาร์ ทำให้ยอดรวมการสนับสนุนอยู่ที่ 40 ล้านดอลลาร์ อ่านเพิ่มเติม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร