
เปิดตัว @huggingface/kernels: ห้องสมุด 200+ WebGPU Kernels เพื่อการประมวลผล AI บนเบราว์เซอร์ที่เร็วขึ้น
เป้าหมายหลักของทีม WebAI ที่ Hugging Face คือการทำให้การประมวลผลโมเดล (Inference) บนเบราว์เซอร์รวดเร็วและใช้งานง่ายที่สุด ซึ่งการจะบรรลุเป้าหมายนี้ต้องพัฒนาในหลายส่วน ตั้งแต่โครงสร้างโมเดลที่เหมาะสม รันไทม์ที่มีประสิทธิภาพ ไปจนถึงการรีดเรี่ยวสมรรถนะของ GPU ผ่านเลเยอร์ระดับล่างสุดที่ต้องทำงานร่วมกับอุปกรณ์และเบราว์เซอร์ที่หลากหลาย
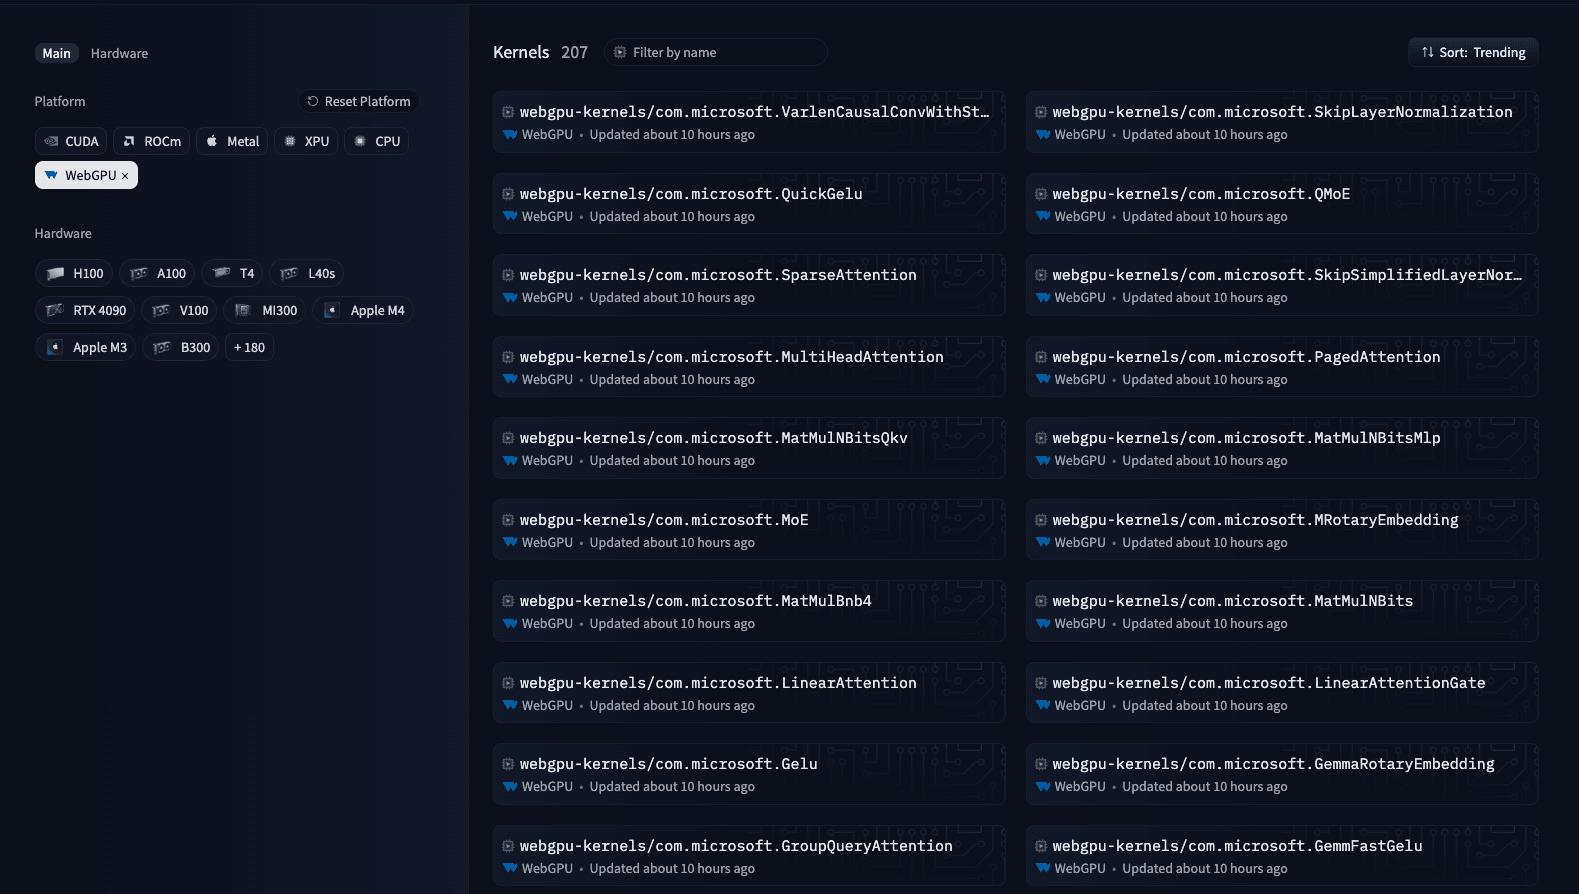
วันนี้เราก้าวสู่ขั้นแรกด้วยการเปิดตัว @huggingface/kernels ไลบรารีขนาดเล็กสำหรับโหลดและรัน WebGPU kernels ที่ปรับแต่งมาแล้วจาก Hugging Face Hub โดยเริ่มต้นที่ 207 kernels ซึ่งรวบรวมไว้ที่ huggingface.co/webgpu-kernels
ชุดสะสมนี้ครอบคลุมการทำงานพื้นฐานของ Machine Learning ในหลากหลายรูปแบบ โดยแต่ละ kernel ถูกเผยแพร่เป็นแพ็กเกจที่สมบูรณ์และมีการระบุเวอร์ชันชัดเจน ทั้งโครงสร้างคำสั่ง (Interface), Shader Templates, กรณีทดสอบความถูกต้อง, ผลทดสอบ Benchmark และคู่มือการใช้งาน ซึ่งทั้งหมดถูกจัดเก็บรวมกันไว้บน Hub
นอกจากนี้ เรายังเปิดตัว Fleet เครื่องมือสำหรับทำ Benchmark และทดสอบ GPU บนเบราว์เซอร์ ซึ่งจะช่วยประเมินประสิทธิภาพของ kernels บนฮาร์ดแวร์ของคุณ โดย Fleet ยังเปิดให้ชุมชนร่วมส่งข้อมูลประสิทธิภาพและความถูกต้องจากอุปกรณ์ที่หลากหลายในโลกแห่งความเป็นจริง ซึ่งช่วยให้เราสามารถตรวจพบข้อผิดพลาดและปรับปรุงประสิทธิภาพของ kernels ให้ดียิ่งขึ้นได้
สรุปประเด็นสำคัญ (TL;DR)
- 207 WebGPU kernels เผยแพร่ภายใต้ลิขสิทธิ์ Apache-2.0 ใน Repository แยกส่วนที่
webgpu-kernels - JavaScript loader ในชื่อ
@huggingface/kernelsสำหรับดาวน์โหลด เตรียมการ และรัน kernels จาก Hub ได้โดยตรง - มาตรฐานที่ชัดเจน ทุก kernel มาพร้อม manifest, การทดสอบความถูกต้อง, ข้อมูล benchmark และ WGSL shader templates
- Fleet เครื่องมือรวบรวมข้อมูลประสิทธิภาพแบบ Crowdsourced จาก GPU จริงทั่วโลก เพื่อตรวจสอบและพัฒนาคุณภาพของ kernels ในสถานการณ์จริง
ทำไมต้องเริ่มที่ kernels?
การรันโมเดลบนเบราว์เซอร์ประกอบด้วยการประมวลผล GPU จำนวนมาก เช่น การคูณเมทริกซ์, Convolutions หรือการทำ Quantization แม้ WebGPU และ WGSL จะช่วยให้การประมวลผลเหล่านี้ใช้งานข้ามแพลตฟอร์มได้ แต่การใช้งานได้ไม่ได้หมายความว่าจะทำงานได้เต็มประสิทธิภาพเสมอไป
ประสิทธิภาพของ Shader มักขึ้นอยู่กับปัจจัยหลายอย่าง เช่น ขนาดของ Workgroup หรือรูปแบบการเข้าถึงหน่วยความจำ ซึ่งทางเลือกที่ดีที่สุดจะเปลี่ยนไปตามอุปกรณ์และเบราว์เซอร์ที่ใช้ การทำให้ kernels สามารถเข้าถึง ทดสอบ และระบุเวอร์ชันแยกกันได้ จึงเป็นรากฐานสำคัญที่ช่วยให้เราปรับปรุงประสิทธิภาพของการรันโมเดลในระดับล่างสุดได้อย่างอิสระ
Kernel repository ที่เป็นมากกว่าแค่ shader
แต่ละ kernel ในชุดสะสมจะมี Kernel Card ของตัวเองเพื่อระบุรายละเอียดการประมวลผล อินพุต-เอาต์พุต และชนิดข้อมูลที่รองรับ พร้อมตัวอย่างการใช้งานผ่าน @huggingface/kernels ที่รันได้ทันที
ยกตัวอย่างเช่น ai.onnx.Add ซึ่งทำหน้าที่บวกข้อมูลแบบ Elementwise ใน Card จะระบุทั้งรูปแบบการทำงานและ Variant ต่างๆ ที่เหมาะสมกับอุปกรณ์แต่ละชนิด
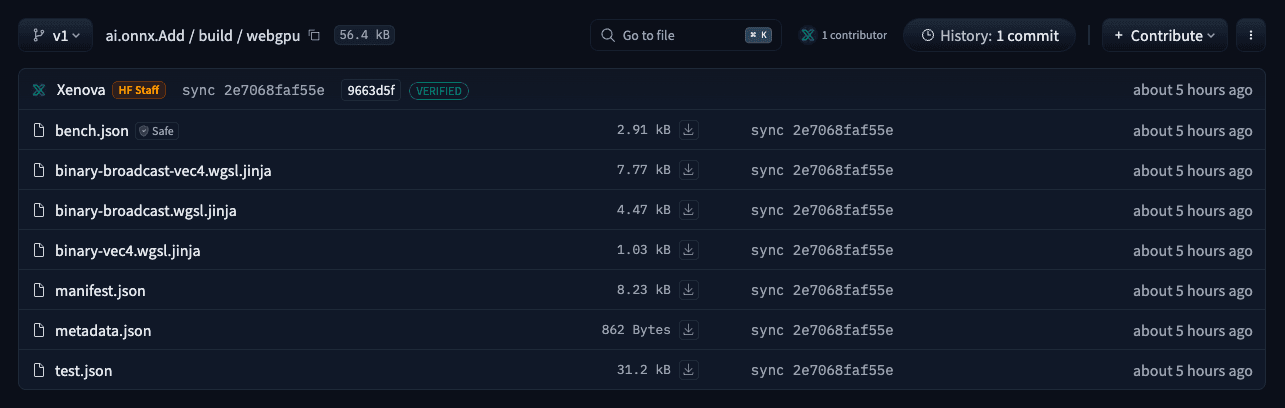
ภายในแต่ละ Repository ของ kernel จะประกอบด้วยส่วนประกอบสำคัญดังนี้:
manifest.json: กำหนดข้อตกลงในการใช้งาน เช่น อินพุต, เอาต์พุต และข้อจำกัดของข้อมูลmetadata.json: บันทึกตัวระบุและแหล่งที่มาของ kerneltest.json: ชุดทดสอบความถูกต้องของการทำงานbench.json: กรณีทดสอบเพื่อประเมินประสิทธิภาพ*.wgsl.jinja: ไฟล์ต้นฉบับ WGSL ที่สามารถปรับพารามิเตอร์ให้เหมาะสมกับแต่ละอุปกรณ์
โครงสร้างนี้เปลี่ยน Shader ให้กลายเป็นซอฟต์แวร์ที่นำกลับมาใช้ซ้ำได้ง่าย นักพัฒนาสามารถตรวจสอบอินเทอร์เฟซได้โดยไม่ต้องอ่านโค้ด WGSL และสามารถโหลดเวอร์ชันที่ต้องการมาใช้งานได้อย่างแม่นยำ
การโหลด kernel จาก Hub
คุณสามารถติดตั้งแพ็กเกจผ่าน npm ได้ด้วยคำสั่ง:
npm install @huggingface/kernels@previewหมายเหตุ: การรัน kernels เหล่านี้จำเป็นต้องใช้เบราว์เซอร์ที่รองรับ WebGPU ซึ่งความพร้อมใช้งานจะขึ้นอยู่กับระบบปฏิบัติการ GPU และไดรเวอร์ในเครื่องของคุณ โดยสามารถตรวจสอบได้ผ่าน JavaScript
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร