
เปิดตัว MKA Benchmark ใหม่วัดกึ๋น AI Agent ในงานสายอาชีพ
ด้วยความร่วมมือกับ Artificial Analysis เรากำลังเปิดตัว MKA (Multimodal Knowledge Agent) ซึ่งเป็น benchmark ใหม่ที่สร้างขึ้นเพื่อประเมินว่า agent ใช้เหตุผลผ่านไฟล์ที่มีความซับซ้อนทางภาพอย่างไร เพื่อแก้ปัญหางานความรู้ในโลกความเป็นจริง
ขอแนะนำ MKA
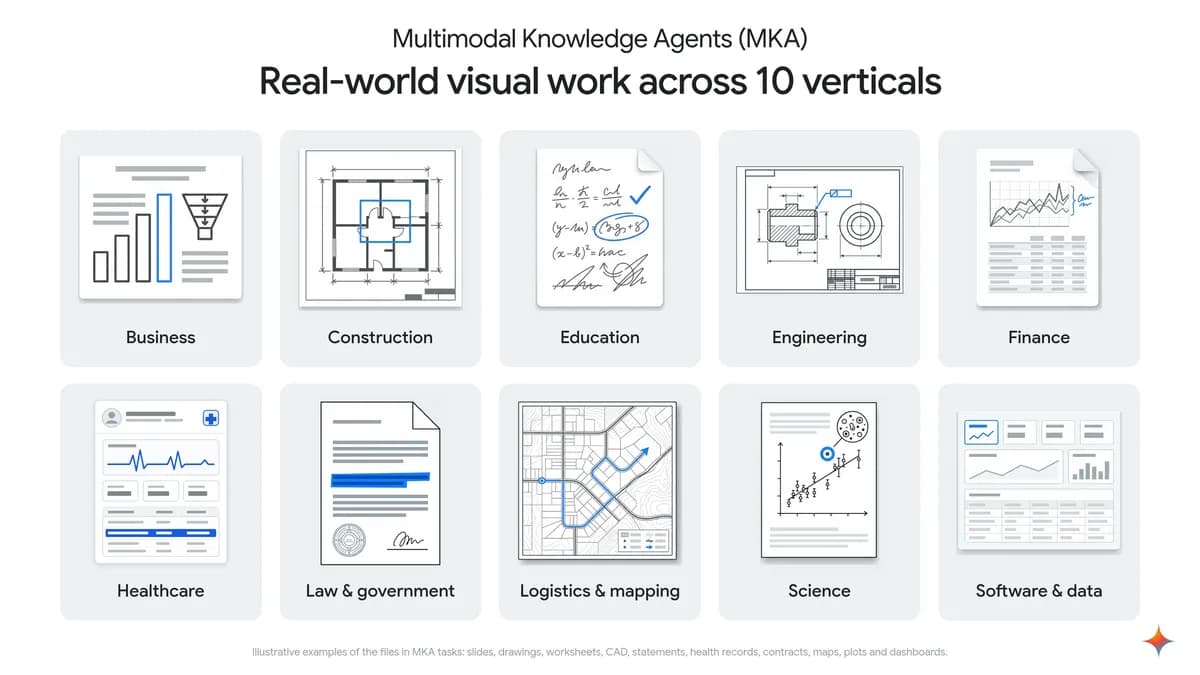
benchmark งานความรู้ส่วนใหญ่ในปัจจุบันมักแก้ได้ด้วยข้อความเพียงอย่างเดียว โดยไม่จำเป็นต้องพิจารณารูปภาพหรือเค้าโครงหน้ากระดาษ แต่ในความเป็นจริง งานระดับมืออาชีพมีความเกี่ยวข้องกับภาพอย่างลึกซึ้ง ตั้งแต่การตรวจสอบแบบแปลนสถาปัตยกรรม การไล่แผนผังวิศวกรรม ไปจนถึงการสรุปผลลัพธ์ลงในสไลด์และ spreadsheet เราจึงสร้าง MKA ขึ้นเพื่อวัดว่า agent สามารถจัดการกับงานที่มีความซับซ้อนทางภาพเหล่านี้ได้ดีเพียงใด เพื่อให้ benchmark อ้างอิงตาม workflow จริง เราได้ร่วมมือกับผู้เชี่ยวชาญจาก 10 กลุ่มอุตสาหกรรม และ 83 อาชีพที่ต้องทำงานกับภาพโดยธรรมชาติ ไม่ว่าจะเป็นสถาปนิก นักชีววิทยา นักวิทยาศาสตร์ข้อมูล หรือผู้พิจารณารับประกันภัย โดยร่วมกันสร้างชุดประเมิน 200 งานใน MKA เพื่อจำลองภารกิจจริงที่พวกเขาต้องเผชิญ
10 กลุ่มอุตสาหกรรมของ MKA
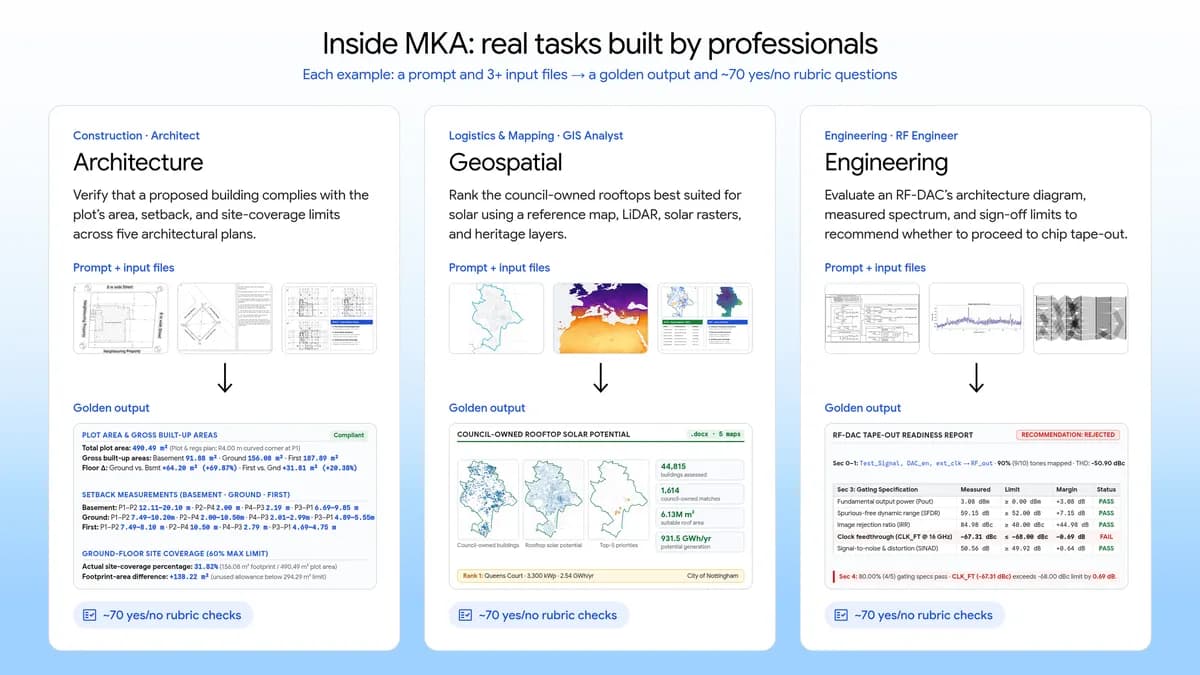
แต่ละงานสะท้อนถึงโปรเจกต์ที่มีหลายขั้นตอน ซึ่งปกติผู้เชี่ยวชาญต้องใช้เวลา 3-8 ชั่วโมงในการทำ โดยมีการจับคู่ prompt ที่สมจริงและข้อมูลแบบ multimodal เข้ากับเกณฑ์การให้คะแนน (rubric) จากผู้เชี่ยวชาญที่มีการตรวจสอบประมาณ 70 รายการ โดยถ่วงน้ำหนักความถูกต้องของข้อเท็จจริง 75% และการออกแบบทางภาพ 25%
งาน MKA สามงาน ตั้งแต่ prompt และไฟล์ข้อมูลนำเข้าไปจนถึงผลลัพธ์ต้นแบบและเกณฑ์การให้คะแนน
เริ่มตั้งแต่วันนี้ คุณสามารถสำรวจ benchmark และประเมิน model ของคุณเองได้ที่ Artificial Analysis โดยทุก model จะทำงานบน Stirrup ซึ่งเป็นชุดเครื่องมือควบคุม agent แบบ open-source เดียวกัน ภายใต้สภาพแวดล้อม sandbox และงบประมาณจำนวนรอบการทำงานที่เท่ากัน
สำหรับการตรวจผลงาน เราใช้ระบบให้คะแนนอัตโนมัติ (autorater) แบบ agentic ที่สร้างขึ้นบน model อื่นที่ไม่ใช่ของ Google ทำหน้าที่เปิดไฟล์ เรนเดอร์หน้ากระดาษ และตรวจสอบสูตรใน spreadsheet ตามเกณฑ์ของผู้เชี่ยวชาญ ซึ่งระบบนี้มีความแม่นยำสูงโดยผู้เชี่ยวชาญเห็นพ้องกับผลการตรวจถึง 96% ของเวลาทั้งหมด เพื่อให้ผลลัพธ์มีความน่าเชื่อถือ Artificial Analysis จะเก็บชุดประเมิน 200 งานไว้เป็นความลับเพื่อป้องกันไม่ให้ข้อมูลหลุดเข้าไปในชุดเทรนของ model อย่างไรก็ตาม เราได้ปล่อยชุดงานสาธารณะแยกต่างหาก 10 งานบน Hugging Face เพื่อให้ทุกคนนำไปทดสอบรูปแบบและประสิทธิภาพของ agent ตนเองได้
รายงานทางเทคนิค ของเราแสดงให้เห็นว่า frontier models มีประสิทธิภาพต่างกันมากในงานเดียวกัน โดยใช้จำนวนรอบการทำงานเฉลี่ยระหว่าง 30 ถึง 130 รอบ ข้อมูลระบุชัดเจนว่าความสามารถในการรับรู้ทางภาพที่แข็งแกร่งเป็นสิ่งจำเป็น และ model จะล้มเหลวอย่างเห็นได้ชัดเมื่อส่วนของการมองเห็นถูกตัดออกไป
ขยายขอบเขตทางภาพด้วย Gemini 4 Carbon
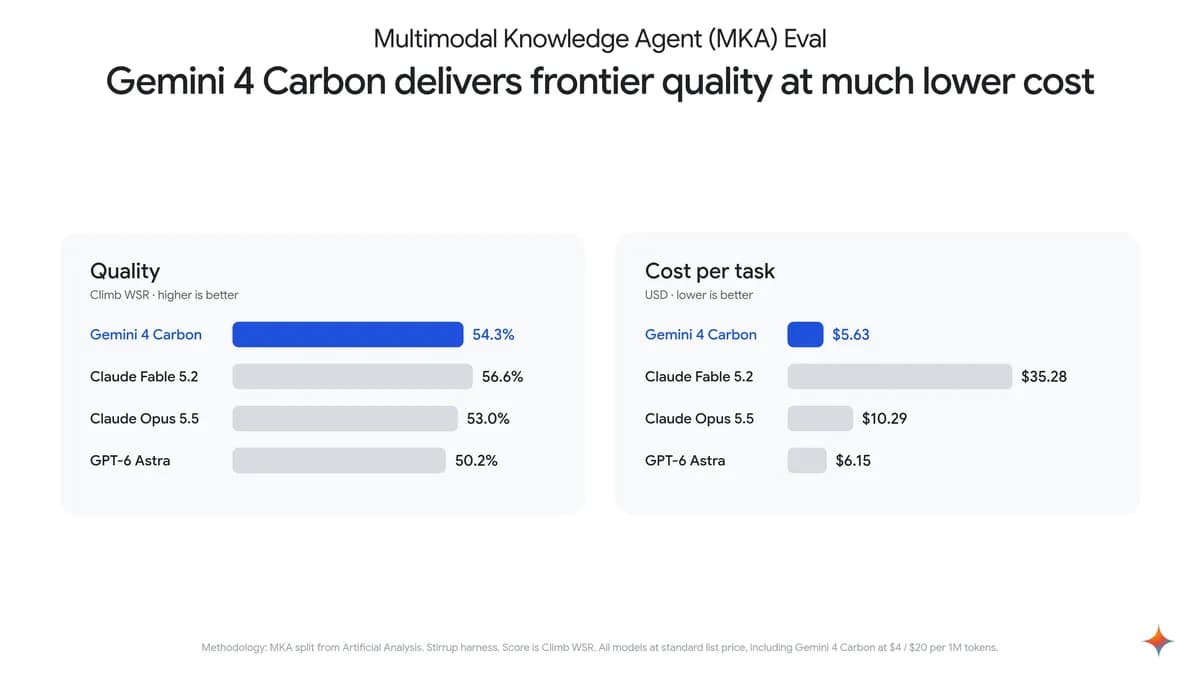
Gemini 4 Carbon ทำคะแนนด้านคุณภาพได้อันดับ #2 จาก model ทั้งหมดที่เราทดสอบ และที่สำคัญคือทำงานเสร็จสิ้นด้วยต้นทุนเฉลี่ยต่ำกว่า model ที่ได้อันดับหนึ่งถึง 6 เท่า
Gemini 4 Carbon อยู่บน pareto frontier ของคุณภาพและราคาสำหรับการประเมิน MKA
การเริ่มต้นใช้งาน
Gemini 4 Carbon พร้อมใช้งานแล้ววันนี้ผ่าน Gemini API ใน Google AI Studio โดยคุณสามารถศึกษารายละเอียดเพิ่มเติมได้ที่ คู่มือสำหรับนักพัฒนา และ เอกสารประกอบ ของ Gemini 4 ที่อัปเดตใหม่ล่าสุด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร