
Linkup เปิดตัว SPARSEUP โมเดล Sparse Embedding ขนาด 149M พารามิเตอร์
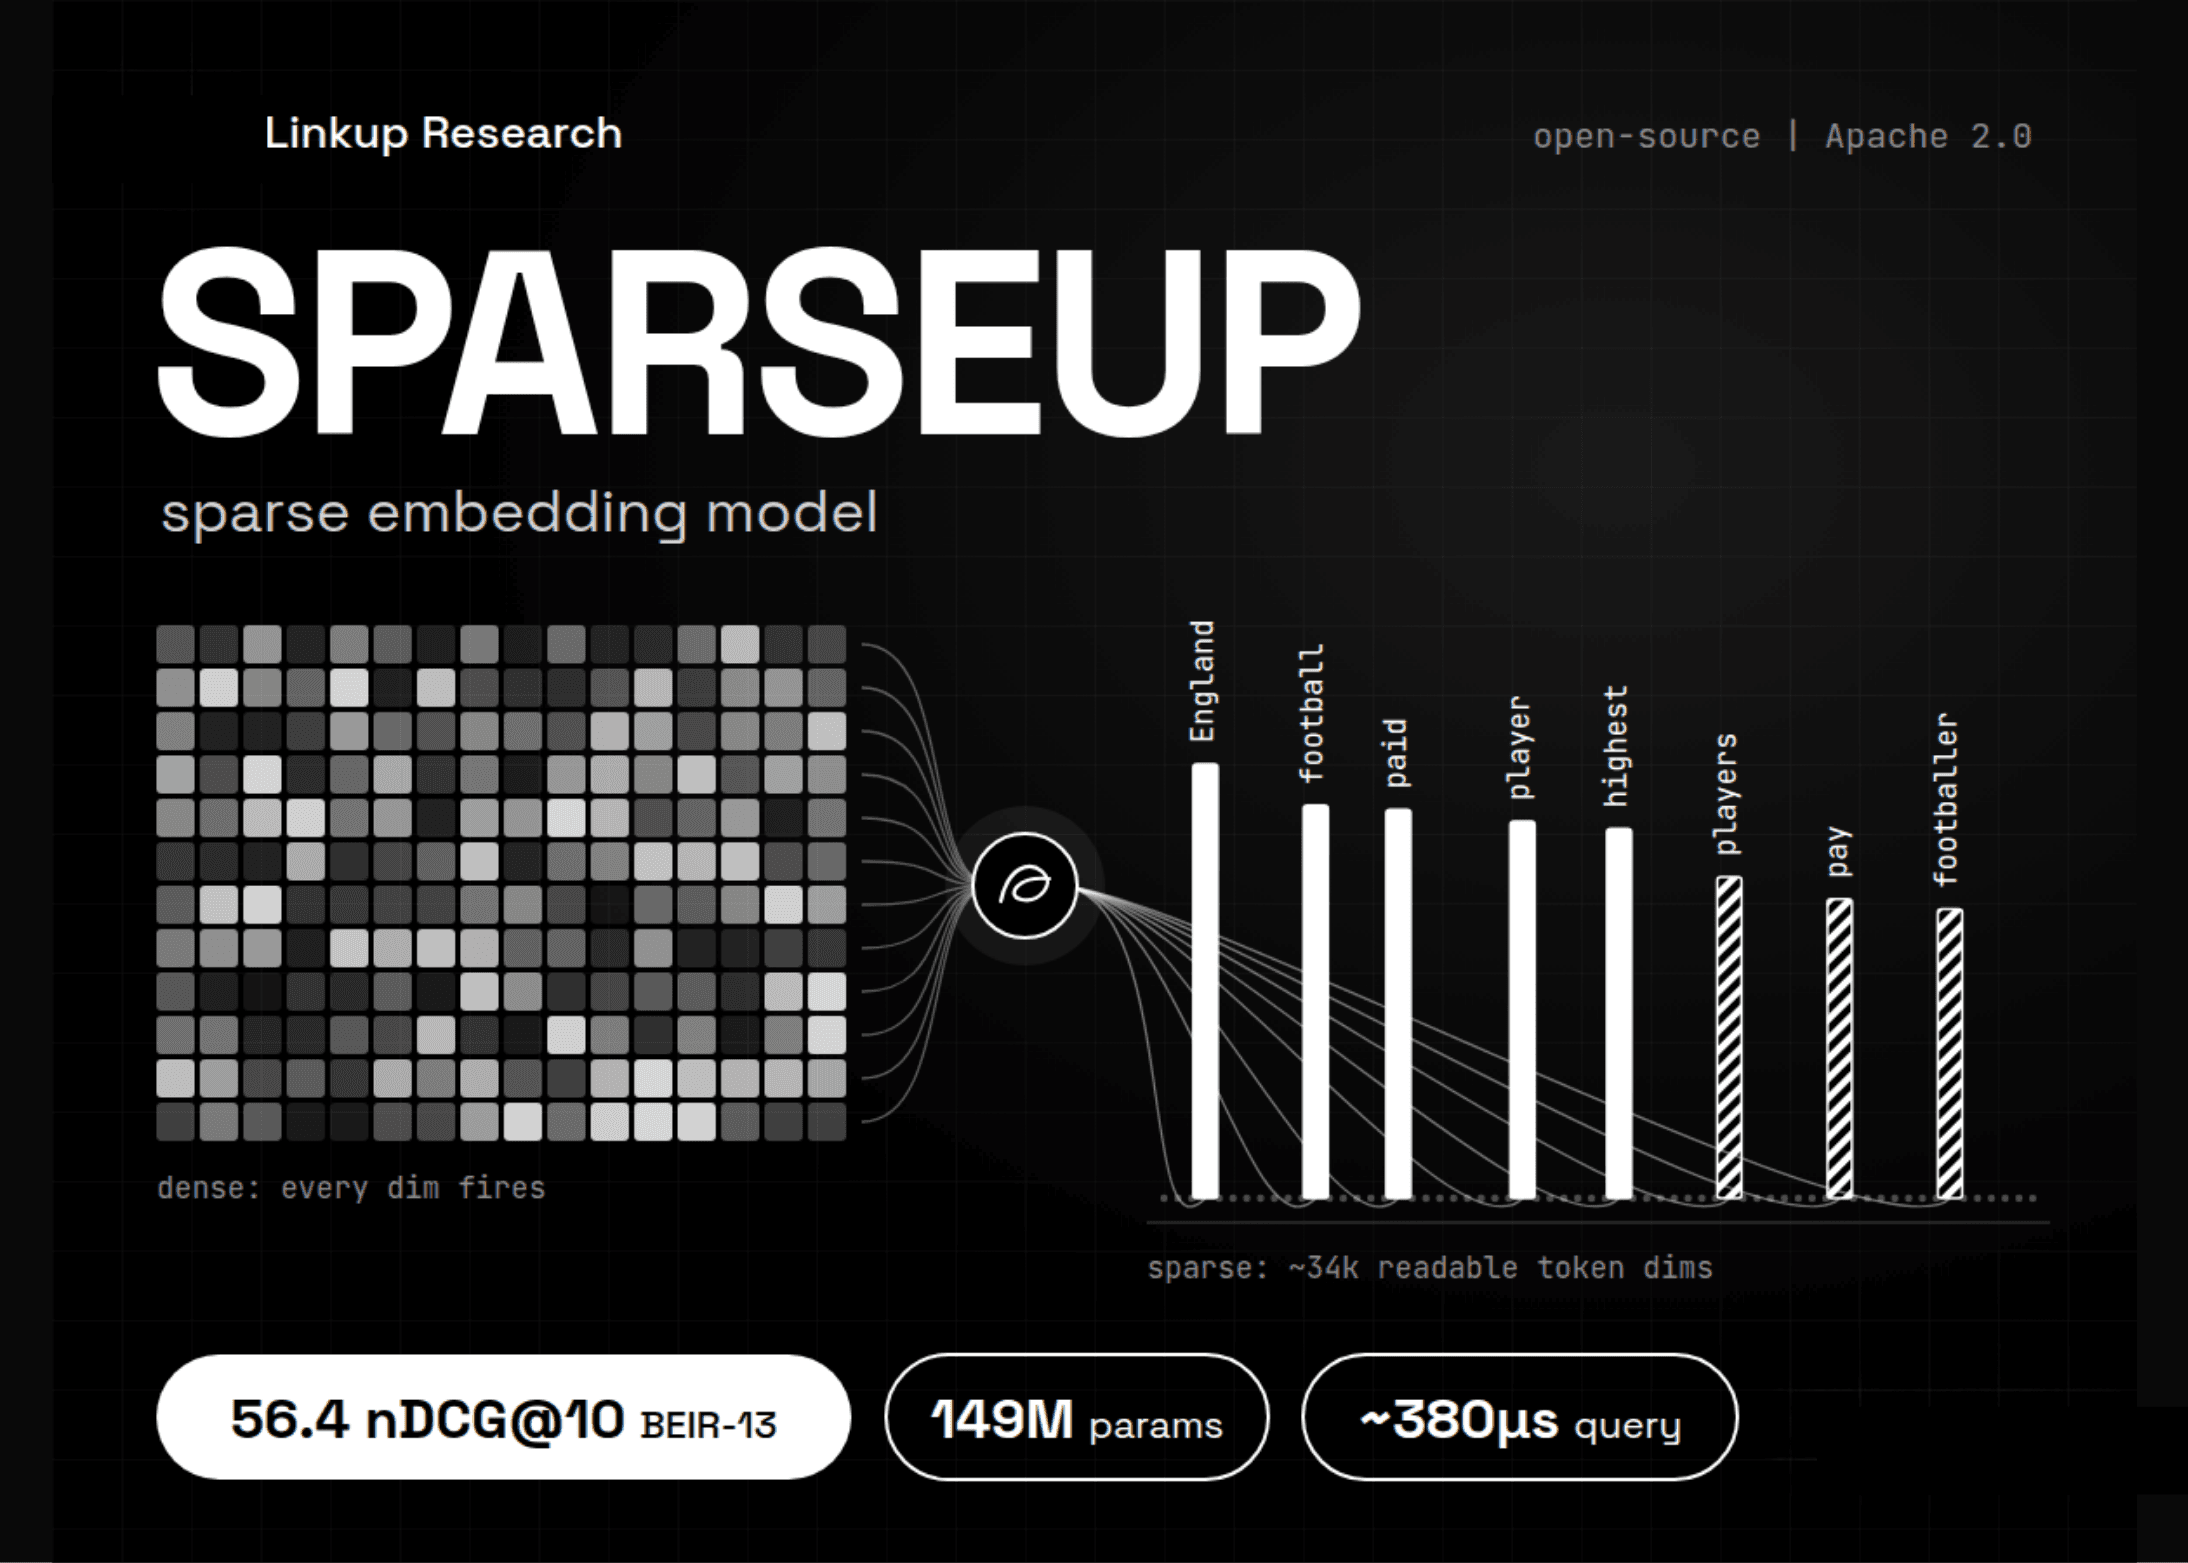
ทีมวิจัย Linkup เปิดตัว SPARSEUP โมเดล learned sparse embedding แบบโอเพนซอร์สที่พัฒนาบนโครงสร้าง ModernBERT ขนาด 149 ล้านพารามิเตอร์ ภายใต้สัญญาอนุญาตแบบ Apache 2.0 โดย Linkup รายงานว่าโมเดลนี้ทำค่าเฉลี่ย nDCG@10 บน BEIR-13 ได้ที่ 56.4 ซึ่งถือเป็นสถิติที่ดีที่สุดสำหรับ public vocabulary-based sparse encoder ในกลุ่มพารามิเตอร์ต่ำกว่า 150 ล้าน
สำหรับผู้ที่สนใจนำไปใช้งานจริง สามารถดาวน์โหลด weights อยู่บน Hugging Face ได้ทันที โดยตัวโมเดลรองรับการโหลดผ่านไลบรารี Transformers หรือ Sentence Transformers เพียงตั้งค่า trust_remote_code=True ในการเรียกใช้งาน
ทำไมต้องเป็นโมเดลแบบ Sparse และทำไมต้องตอนนี้
ในขณะที่โมเดลการค้นคืน (retrieval) ส่วนใหญ่มักเป็นแบบ dense ที่ใช้ 1 เวกเตอร์ต่อ 1 ข้อความ แต่โมเดลแบบ sparse จะให้ค่าน้ำหนักบนชุดคำศัพท์แทน ทำให้แต่ละมิติเชื่อมโยงกับโทเคนจริง ส่งผลให้เวกเตอร์เข้ากับ inverted indexes ได้ดี มนุษย์สามารถอ่านทำความเข้าใจได้ง่าย และมีความโดดเด่นในการจับคู่คำที่พบยาก (rare words)
โปรเจกต์นี้ต่อยอดมาจาก DenseOn และ LateOn ของ LightOn ซึ่งเคยเผยแพร่ข้อมูลและสูตรการฝึกโมเดลแบบ dense และ late-interaction ไว้ก่อนหน้า SPARSEUP จึงเข้ามาเติมเต็มในส่วนของ sparse โดยใช้โครงสร้างหลักและข้อมูลชุดเดียวกัน ช่วยให้นักพัฒนาสามารถเปรียบเทียบสไตล์การค้นคืนทั้ง 3 รูปแบบได้อย่างชัดเจน
SPARSEUP ถูกสร้างขึ้นอย่างไร
การฝึกฝนเริ่มต้นจาก LateOn-unsupervised โดยทีมงานได้นำ MLM head ดั้งเดิมของ ModernBERT กลับมาใส่ใหม่ และทำ fine-tuning ผ่าน ชุดข้อมูล fine-tuning ของ LightOn ด้วยเทคนิค contrastive learning โดยใช้ GPU H100 เพียงตัวเดียวในการฝึก และไม่มีการทำ cross-encoder distillation เนื่องจากการใช้ SPLADE แบบปกติกับโครงสร้างนี้มักประสบปัญหา stopword ล้น Linkup จึงแก้ไขด้วยเทคนิค 3 ประการ:
- Logit shifting: ปรับการคำนวณเป็น
log(1 + ReLU(x - 15))เพื่อไม่ให้ค่า log อิ่มตัวเร็วเกินไปจนเวกเตอร์หนาแน่นตั้งแต่เริ่มต้น - Per-position top-k: จำกัดให้แต่ละโทเคนคงไว้เฉพาะ 12 มิติคำศัพท์ที่แข็งแกร่งที่สุดก่อนทำ max pooling
- Case folding: รวมไอดีคำที่มีความหมายเดียวกันแต่ต่างกันที่ตัวพิมพ์ใหญ่-เล็ก (เช่น
heatและHeat) เข้าด้วยกัน ช่วยลดมิติเอาต์พุตจาก 50,000 เหลือประมาณ 34,000
การใช้งานจะใช้พรีฟิกซ์ [Q] สำหรับคิวรี และ [D] สำหรับเอกสาร โดยคำนวณคะแนนแบบ dot product รองรับความยาวสูงสุด 128 โทเคนสำหรับคิวรี และ 512 โทเคนสำหรับเอกสาร
ผลการทดสอบ Benchmark
จากการเปรียบเทียบกับ sparse encoders อื่นๆ บน BEIR-13 (nDCG@10) ตามที่ระบุใน model card มีผลลัพธ์ดังนี้:
| Model | BEIR-13 avg |
|---|---|
| SPARSEUP | 56.4 |
| opensearch-neural-sparse-encoding-doc-v3-gte | 54.6 |
| splade-v3 | 51.7 |
| granite-embedding-30m-sparse | 50.6 |
| LACONIC-1B (1B parameters) | 58.7 |
แม้ผลคะแนนโดยรวมจะดูดี แต่เมื่อเทียบในสภาพแวดล้อมเดียวกัน SPARSEUP ยังตามหลังโมเดลแบบอื่นของ LightOn เล็กน้อย (LateOn 58.9 และ DenseOn 57.9) โดย SPARSEUP ทำคะแนนได้ดีมากในชุดข้อมูล ArguAna และ Touché แต่ยังมีความอ่อนไหวในชุดข้อมูลเชิงความหมายอย่าง FiQA และ DBPedia
ความเร็วและความเบาบาง (Speed and Sparsity)
บนฐานข้อมูล MS MARCO โมเดล SPARSEUP มีค่าเฉลี่ย non-zero terms อยู่ที่ 47 ต่อคิวรี และ 190 ต่อเอกสาร เมื่อทำงานร่วมกับดัชนี Seismic จะสามารถทำค่า recall ได้สูงกว่า 97% โดยใช้เวลาประมวลผลเพียง 380 ไมโครวินาทีต่อคิวรี (single-threaded) ซึ่งทีมวิจัยเน้นย้ำว่าพวกเขาเลือกคงความเบาบาง (sparse) ไว้เพื่อความเร็ว แม้การขยายขนาดเวกเตอร์อาจช่วยเพิ่มคะแนนทดสอบได้มากกว่านี้ก็ตาม
ประเด็นสำคัญ
- SPARSEUP เป็นโมเดลแรกจาก Linkup Research ขนาด 149 ล้านพารามิเตอร์ ภายใต้ Apache 2.0
- ทำคะแนน nDCG@10 ได้ 56.4 บน BEIR-13 สูงที่สุดในกลุ่มโมเดล sparse ขนาดเล็ก
- ใช้เทคนิคเฉพาะตัวทั้ง logit shift, top-12 expansion และ case folding เพื่อรักษาประสิทธิภาพ
- ให้ความเร็วในการค้นคืนที่ยอดเยี่ยม โดยบรรลุ recall >97% ในเวลาไม่ถึง 1 มิลลิวินาทีเมื่อใช้ร่วมกับ Seismic
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร