
Liquid AI เปิดตัว LiquidCodec บีบอัดเสียงเร็วขึ้น 361 เท่า
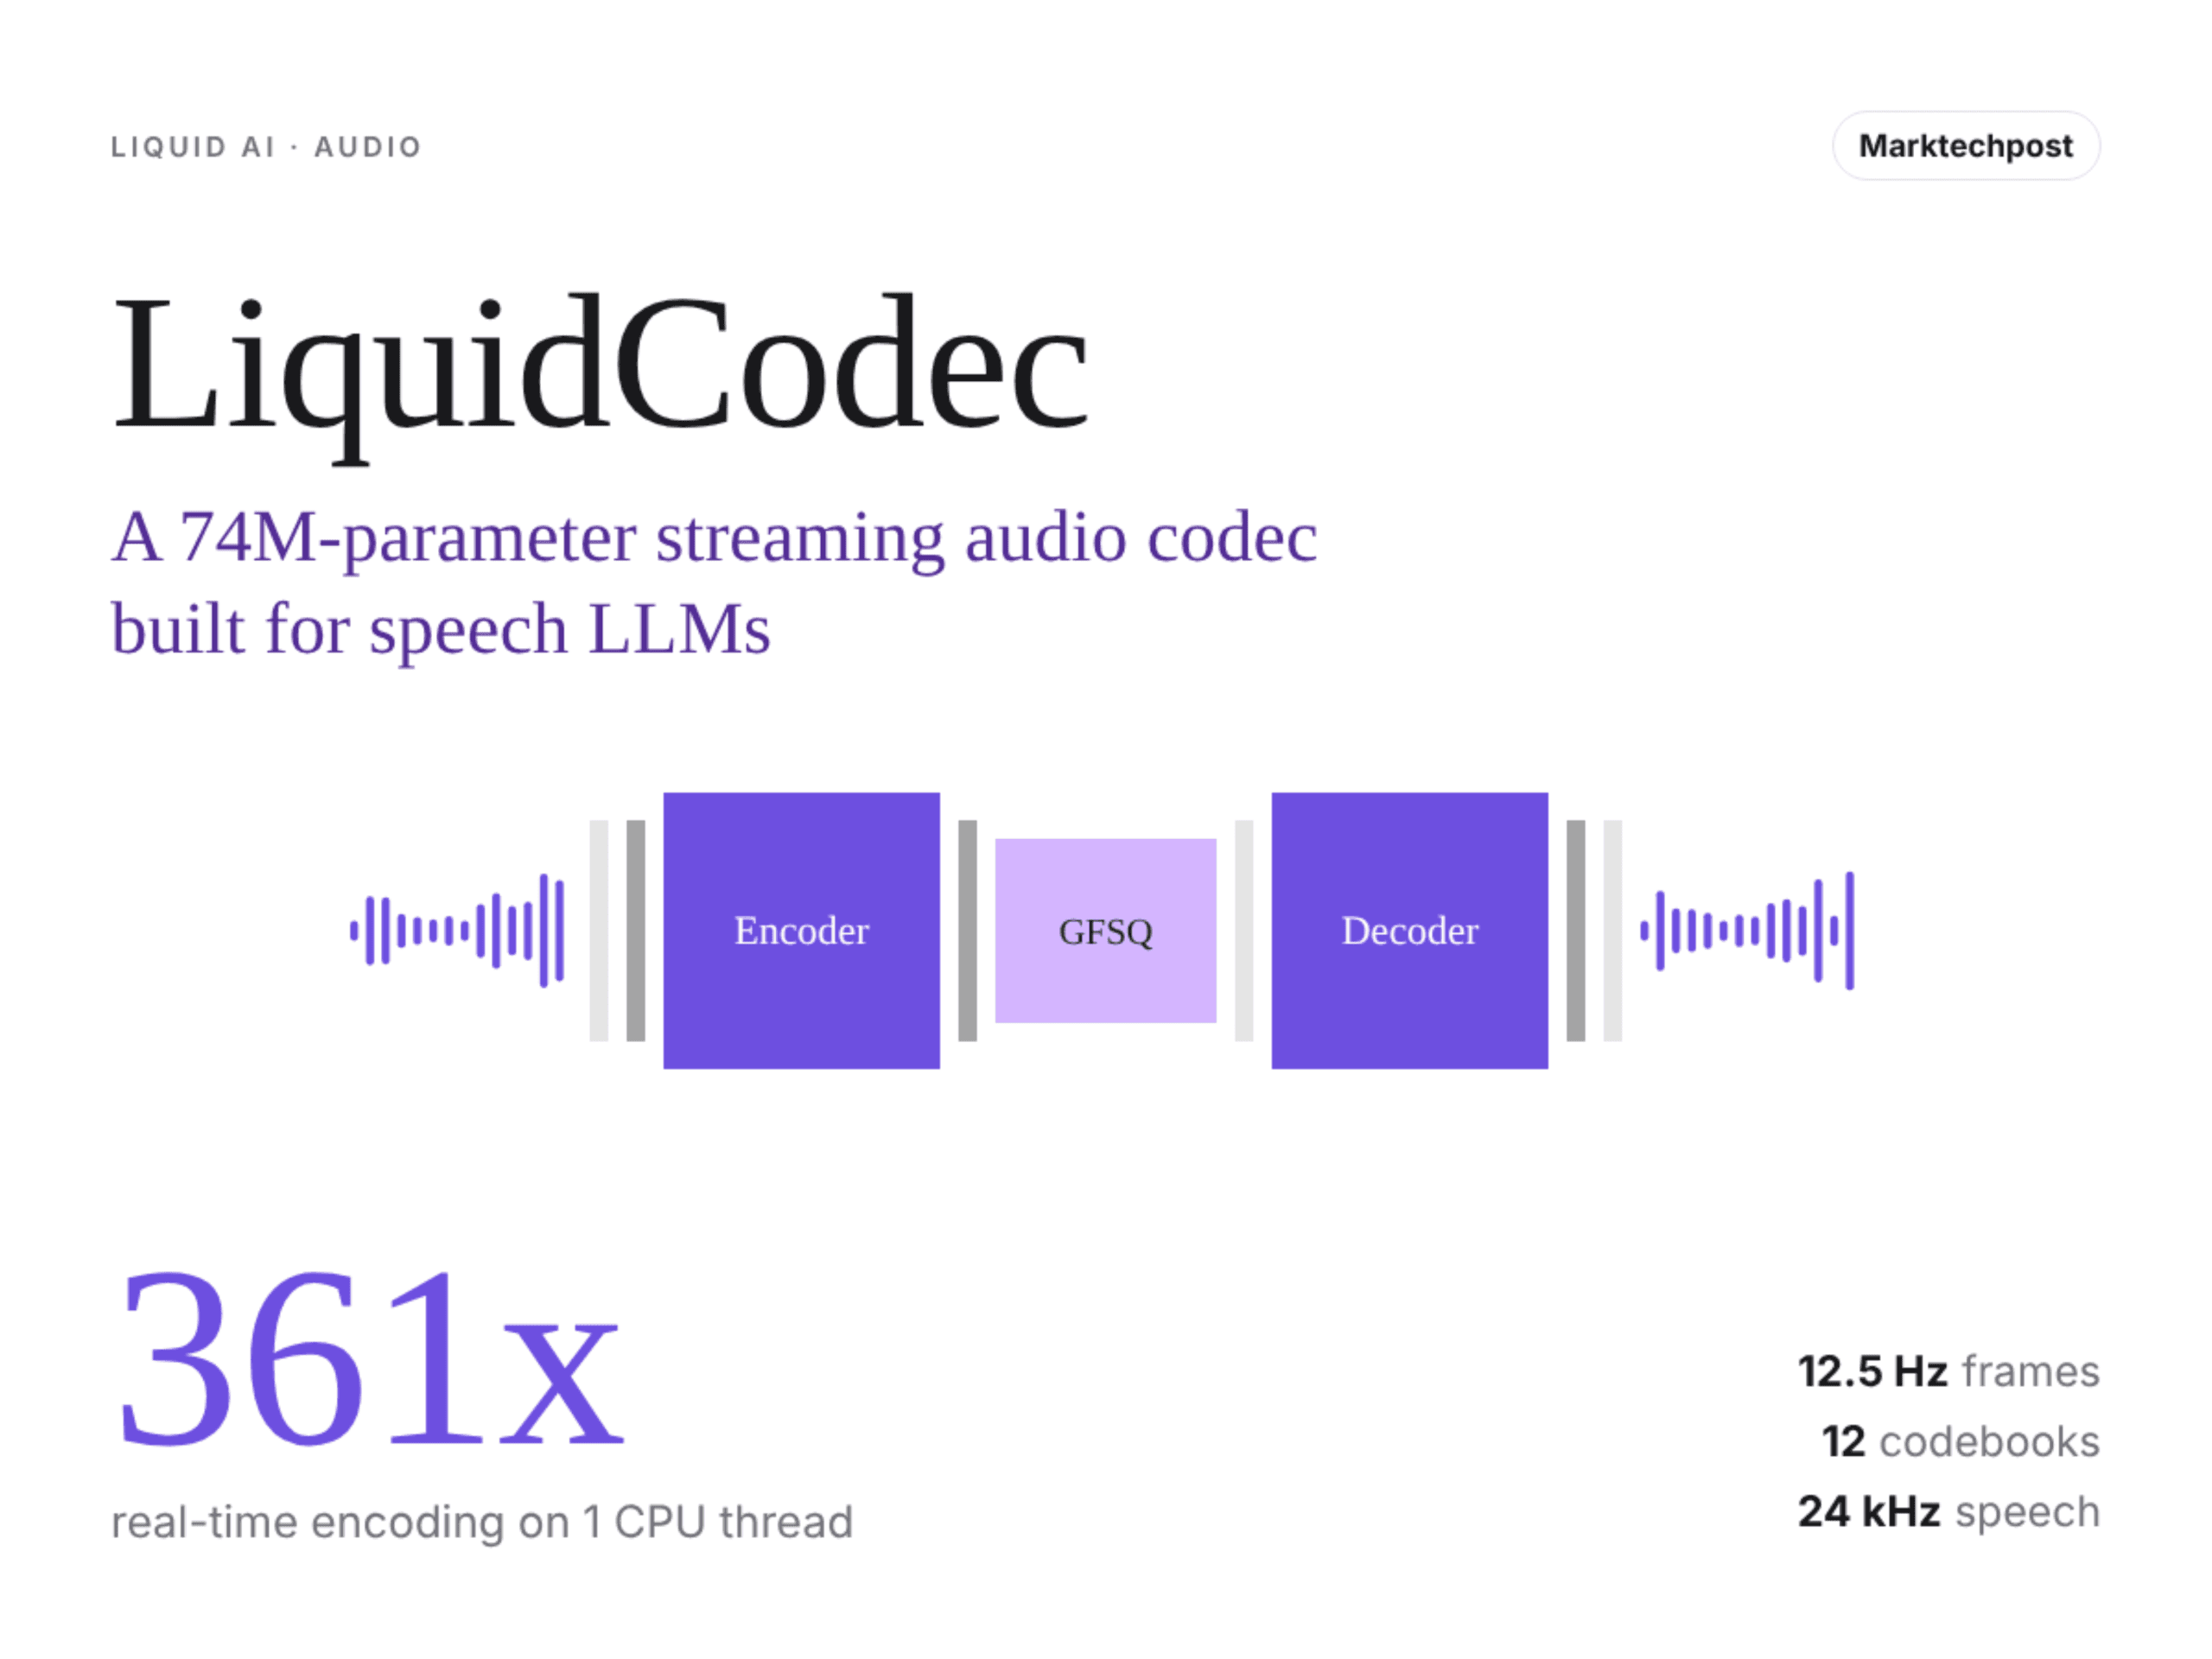
Liquid AI ประกาศ released LiquidCodec เทคโนโลยี audio codec เบื้องหลังโมเดลภาษาขนาดใหญ่อย่าง LFM3-Audio-2B และ LFM3-Omni-2B โดย LiquidCodec ทำหน้าที่เป็น streaming speech tokenizer ขนาด 74 ล้านพารามิเตอร์ ซึ่งจะเปลี่ยนเสียงพูดให้เป็น token เพื่อให้โมเดลภาษาประมวลผลและแปลงกลับเป็นเสียงได้อย่างรวดเร็ว ผู้สนใจสามารถดาวน์โหลด weights are on Hugging Face
TL;DR
- ขนาด: ประมาณ 74M parameters (73.6M บน model card); รองรับเสียง 24 kHz, เฟรม 12.5 Hz พร้อม 12 codebooks
- การรองรับ: รันบน CPU thread เดียว (ทดสอบบน Apple M4 Max) หรือ CUDA GPUs ผ่าน Transformers และมีบิลด์ GGUF สำหรับ llama.cpp
- ประสิทธิภาพ: ให้ค่า ViSQOL ดีที่สุดและ mel distance ต่ำที่สุดเมื่อเทียบกับ X-Codec 2, NanoCodec และ Mimi
- ความเร็ว: การเข้ารหัส (Encoding) เร็วกว่าเวลาจริงประมาณ 361 เท่าบน CPU เพียงเธรดเดียว
LiquidCodec คืออะไร?
LiquidCodec คือ speech codec ที่ Liquid AI พัฒนาขึ้นเพื่อบีบอัดเสียง 24 kHz ลงใน 12 token streams โดยแต่ละเฟรมขนาด 80 ms จะถูกแปลงเป็น 12 discrete tokens ตามข้อมูลใน LFM3-Audio-2B model card เทคโนโลยีนี้เข้ามาแทนที่ Kyutai’s Mimi ซึ่งเคยใช้ในโมเดลรุ่นก่อน โดย LiquidCodec มีขนาดเล็กกว่า Mimi ที่มีพารามิเตอร์ 96.2M
LiquidCodec ทำงานอย่างไร?
กระบวนการทำงานประกอบด้วยการ encode, quantize และ decode โดยใช้สถาปัตยกรรม LFM3 ที่ Liquid AI พัฒนาขึ้นเองทั้งในส่วน encoder และ decoder ซึ่งออกแบบมาให้มีความสมมาตรและรองรับการสตรีมมิ่งแบบ fully causal
จุดเด่นอยู่ที่การใช้ Grouped Finite Scalar Quantization (GFSQ) แทนที่ระบบเดิมอย่าง RVQ ทำให้ codebook ทั้ง 12 ชุดสามารถทำนายผลขนานกันได้ผ่าน transformer นอกจากนี้ในส่วนของ decoder ยังทำนาย spectral coefficients โดยตรง ซึ่งช่วยลดภาระการประมวลผลที่มักเกิดขึ้นใน waveform decoders ทั่วไป
ขั้นตอนการฝึกฝน
การฝึกฝนแบ่งเป็น 2 ช่วงหลัก คือช่วงแรกใช้เสียงพูด 264,000 ชั่วโมง ครอบคลุม 107 ภาษา เพื่อวางรากฐาน และช่วงที่สองเป็นการ fine-tuned ด้วยเสียงคุณภาพสูง 55,000 ชั่วโมงร่วมกับ adversarial critics เพื่อกำจัดเสียงเพี้ยนแบบโลหะ (metallic artifacts) ปิดท้ายด้วยการทำ quantization-aware training (QAT) เพื่อให้ใช้งานบนอุปกรณ์พกพาหรือ edge devices ได้อย่างมีประสิทธิภาพ
LiquidCodec เร็วแค่ไหน?
จากการทดสอบบน Apple M4 Max (1 CPU thread) พบว่า LiquidCodec ทำความเร็วในการ encode ได้สูงถึง 361 เท่าของเวลาจริง และ decode ได้ประมาณ 87 เท่าของเวลาจริง
เมื่อวัดจากค่า Real-time factor (RTF) ซึ่งค่ายิ่งน้อยยิ่งดี พบว่า encode RTF ของ LiquidCodec อยู่ที่ 0.0028 ซึ่งเร็วกว่า Mimi (0.0361) ประมาณ 13 เท่า และเร็วกว่า X-Codec 2 (0.7359) อย่างมหาศาล ส่วนด้านการ decode ก็เร็วกว่า Mimi ประมาณ 2.9 เท่า
ประสิทธิภาพเมื่อเทียบกับมาตรฐานอุตสาหกรรม
Liquid AI ทดสอบกับชุดข้อมูลมาตรฐาน 8 ชุด พบว่าในด้านการสร้างเสียงใหม่ (Reconstruction) LiquidCodec ให้ค่า ViSQOL สูงที่สุดที่ 4.319 และมีค่าความผิดเพี้ยนต่ำที่สุดเหนือกว่าคู่แข่งทุกราย
ในด้านการเปลี่ยนข้อความเป็นเสียง (Text-to-speech) LiquidCodec ยังทำคะแนน UTMOSv2 ได้สูงสุดในทุกชุดทดสอบ และทำค่าอัตราความผิดพลาดของคำ (WER) ได้ดีเยี่ยม โดยบน LibriSpeech ทำได้เพียง 3.15% เทียบกับ Mimi ที่ 6.27% อย่างไรก็ตาม NanoCodec ของ NVIDIA ยังคงนำอยู่ในด้านคะแนน PESQ และความคล้ายคลึงของเสียงผู้พูดในบางการทดสอบ
ตารางเปรียบเทียบ LiquidCodec vs Mimi vs NanoCodec vs X-Codec 2
| คุณสมบัติ | LiquidCodec | Mimi | NanoCodec 1.78 kbps | X-Codec 2 |
|---|---|---|---|---|
| ผู้พัฒนา | Liquid AI | Kyutai | NVIDIA | HKUST Audio |
| พารามิเตอร์ | 73.6M | 96.2M | 62M | 0.8B |
| Sample rate | 24 kHz | 24 kHz | 22.05 kHz | 16 kHz |
| Quantizer | GFSQ | RVQ | FSQ | Single-layer FSQ |
| Encode RTF (M4 Max)* | 0.0028 | 0.0361 | 0.2145 | 0.7359 |
| LibriSpeech ViSQOL* | 4.319 | 4.031 | 4.219 | 4.119 |
วัดโดย Liquid AI ในบล็อก LiquidCodec
การใช้งานสำหรับนักพัฒนา
นักพัฒนาสามารถโหลดโคเด็กนี้ผ่าน Hugging Face Transformers โดยใช้คำสั่ง trust_remote_code=True ซึ่งรองรับการ decode แบบทีละส่วน (chunk-by-chunk) ผ่าน LiquidCodecStreamingCache
สำหรับการรันบนอุปกรณ์ปลายทาง Liquid AI ได้จัดทำบิลด์ GGUF ทั้งรุ่น Q4_0, Q4_K_M และ Q8_0 ไว้ให้แล้ว โดยเฉพาะรุ่น Q4_0 ที่ผ่านการทำ QAT สามารถลดขนาด decoder ลงได้ถึง 3.5 เท่าโดยที่คุณภาพเสียงลดลงเพียงเล็กน้อยเท่านั้น
สรุปประเด็นสำคัญ
- เป็น streaming codec ขนาด 74M พารามิเตอร์ที่รองรับเสียง 24 kHz
- ความเร็วในการประมวลผลสูงมากเมื่อเทียบกับคู่แข่งบน CPU เธรดเดียว
- ให้คุณภาพการสร้างเสียงใหม่และ TTS ดีที่สุดในหลายดัชนีชี้วัด
- รองรับการใช้งานแบบ Quantized เพื่อลดขนาดโมเดลสำหรับอุปกรณ์พกพา
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร