
Redis เปิดตัว LangCache: บริการ Semantic Cache ช่วยลดค่าใช้จ่าย LLM สูงสุด 90% และประมวลผลเร็วขึ้น 15 เท่า
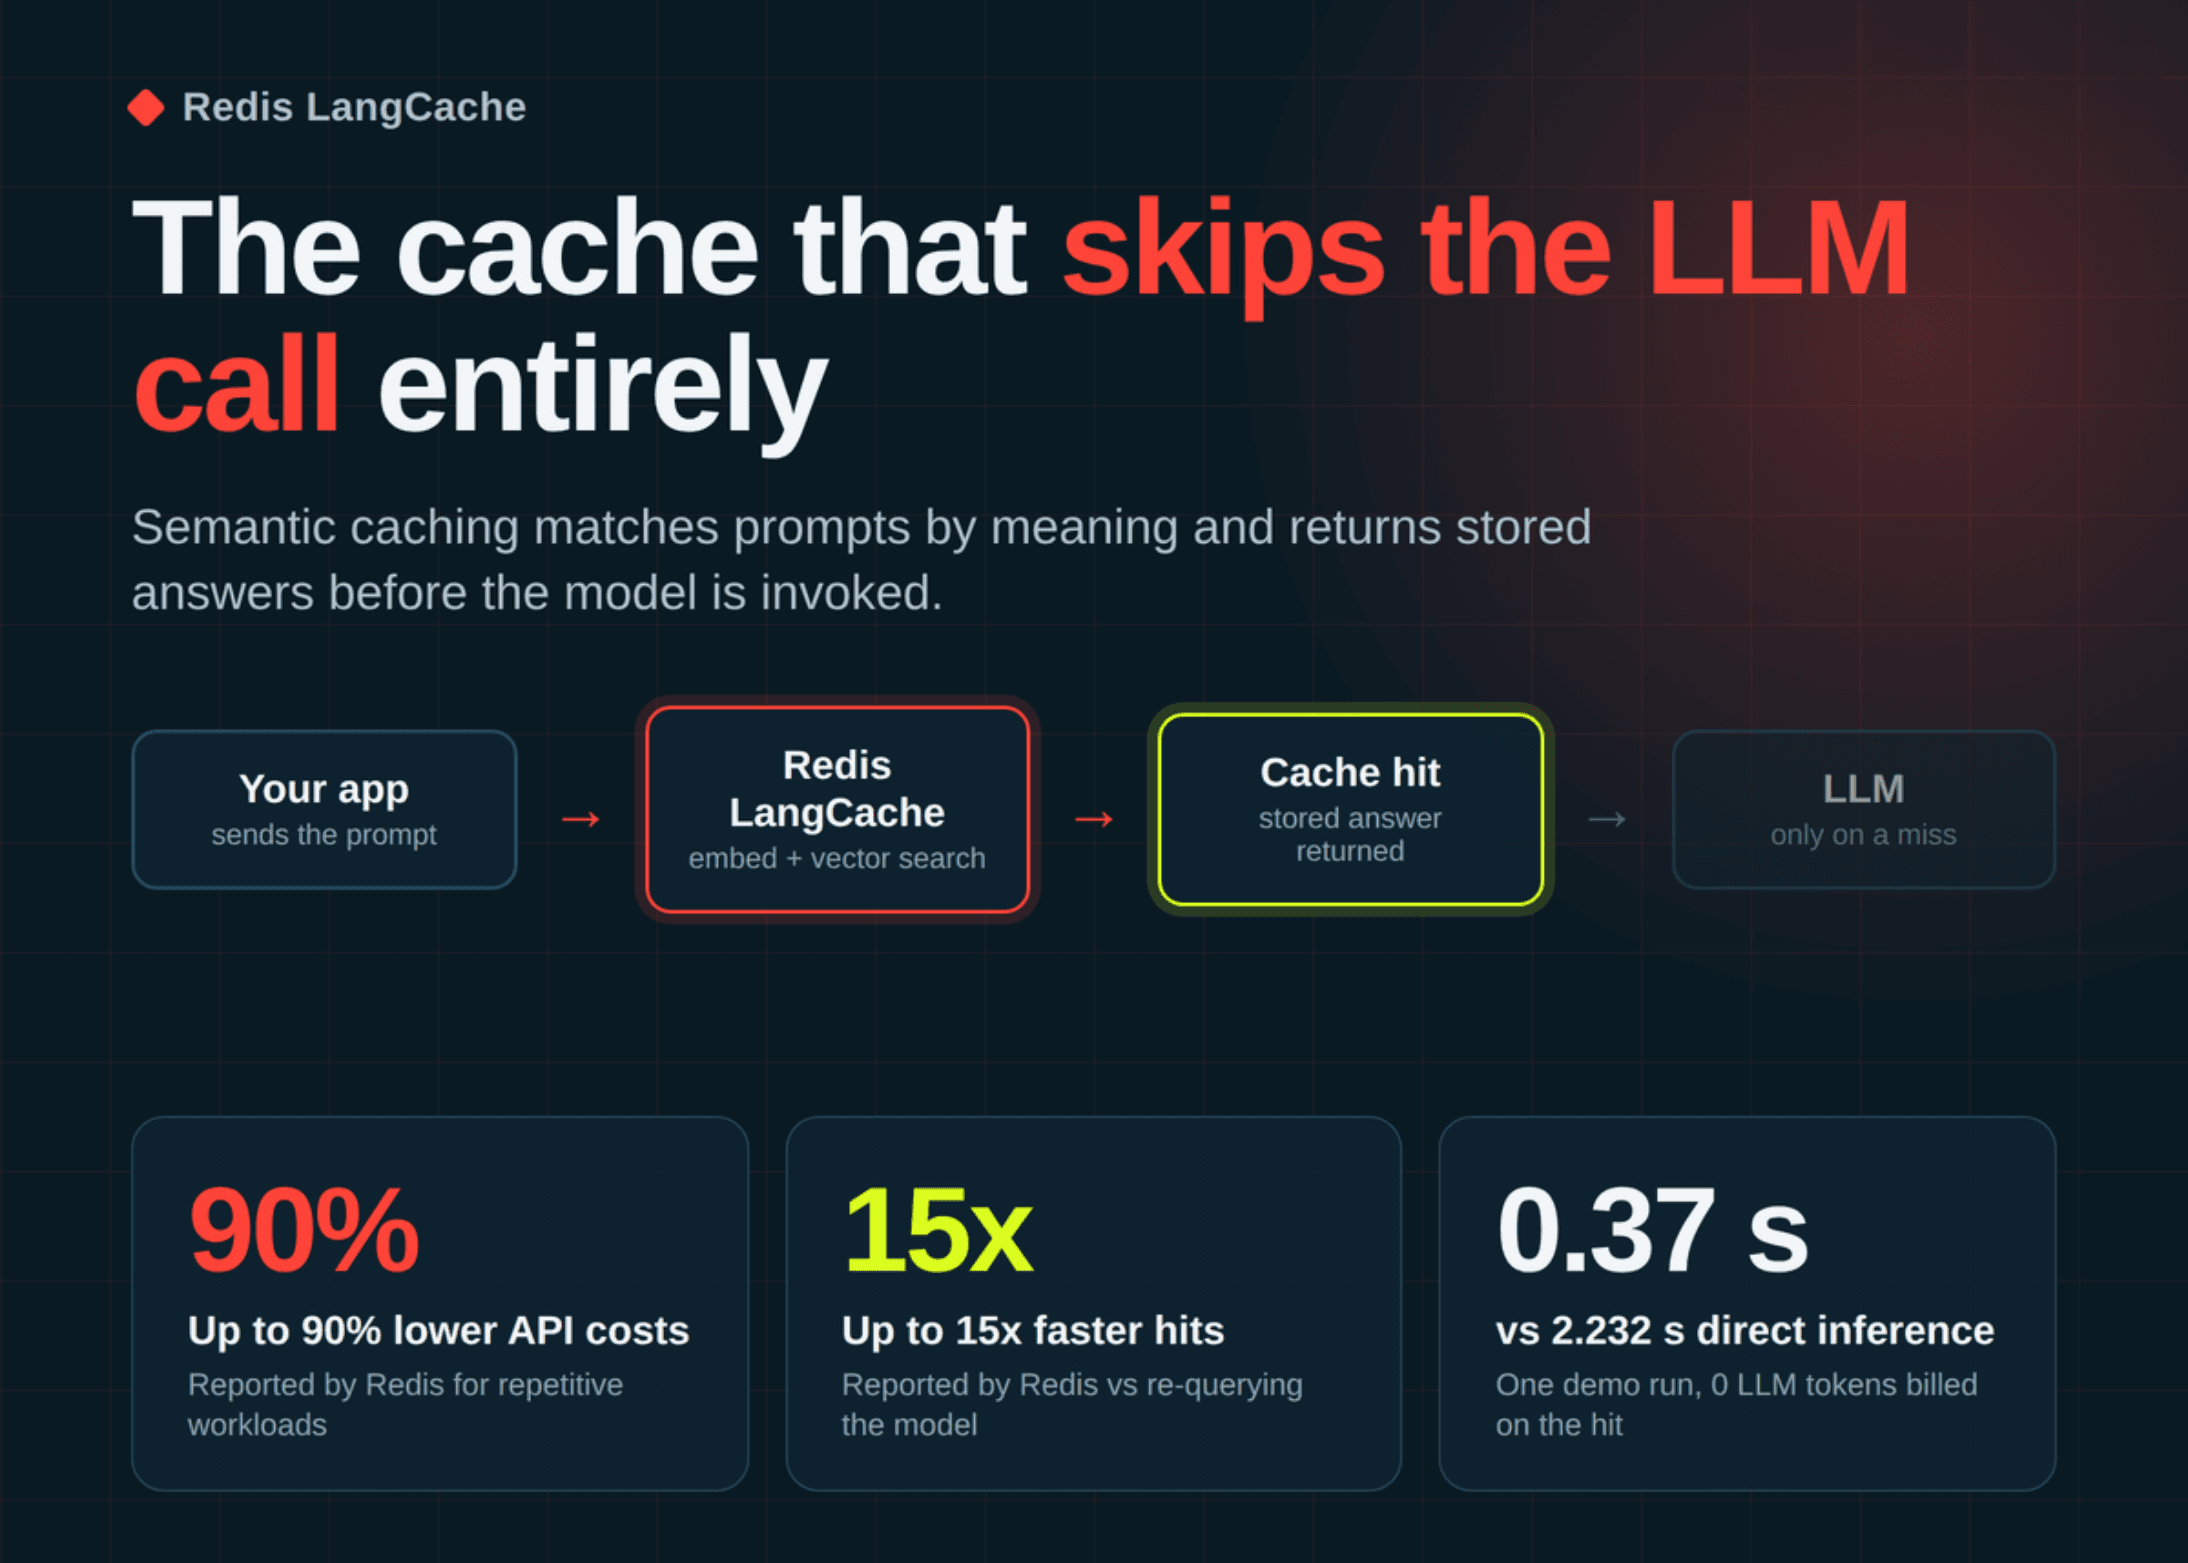
แอปพลิเคชัน LLM ในระดับโปรดักชันส่วนใหญ่มักพบกับคำถามรูปแบบเดิมซ้ำๆ โดยเฉพาะในระบบ Support หรือ RAG pipeline ที่ต้องรับมือกับเจตนาเดิมของผู้อื่นนับพันครั้งต่อวัน แม้จะใช้ถ้อยคำต่างกันแต่ระบบทั่วไปมักมองว่าเป็นคำขอใหม่และต้องเสียค่าใช้จ่ายเต็มจำนวน Redis LangCache จึงถูกพัฒนาขึ้นเป็นบริการ semantic caching แบบ managed ที่วางตัวอยู่ระหว่างแอปพลิเคชันและโมเดล
หลักการทำงานของ LangCache คือการจับคู่พรอมต์ที่เข้ามากับคำตอบเดิมที่เคยบันทึกไว้โดยอิงจาก "ความหมาย" แทนการตรวจข้อความแบบตัวอักษรต่อตัวอักษร หากพบการจับคู่ที่มีความใกล้เคียงเพียงพอ ระบบจะส่งคืนคำตอบจากแคชทันที ซึ่ง Redis ระบุว่าช่วยประหยัดค่า API ได้สูงสุดถึง 90% และให้การตอบสนองที่เร็วขึ้นกว่าการเรียกโมเดลใหม่ถึง 15 เท่า
ปัจจุบัน LangCache พร้อมใช้งานแล้วในรูปแบบ Public Preview บน Redis Cloud โดยสามารถเข้าถึงผ่าน REST API พร้อมรองรับ SDK สำหรับ Python และ JavaScript ทั้งนี้ทาง Redis ระบุว่าคุณสมบัติและพฤติกรรมของระบบอาจมีการปรับปรุงเพิ่มเติมในช่วงทดสอบนี้
ปัญหา: การเปลี่ยนถ้อยคำ (Paraphrases) ที่ยังทำให้ LLM ทำงานหนัก
ลองพิจารณาคำถามสามรูปแบบ เช่น "ขอเงินคืนแผนรายเดือนได้ไหม?", "การสมัครสมาชิกรายเดือนคืนเงินได้หรือไม่?" หรือ "ยกเลิกแผนแล้วรับเงินคืนได้ไหม?" แม้จะใช้คำต่างกันแต่ใจความสำคัญคือเรื่องเดียวกัน หากไม่มีระบบ semantic cache ทุกคำถามจะถูกส่งไปประมวลผลใหม่ทั้งหมด ทำให้ผู้ใช้ต้องรอและเสียค่า token โดยไม่จำเป็น
แม้เทคนิค Prefix caching จะช่วยลดค่าใช้จ่ายได้บ้างจากการนำสถานะ KV ของ system prompt มาใช้ใหม่ แต่คำขอก็ยังคงถูกส่งไปถึง LLM และต้องผ่านกระบวนการถอดรหัส (decode) คำตอบฉบับเต็มอยู่ดี ดังนั้น Prefix-cache hit จึงเป็นเพียงการทำให้การเรียกใช้งานราคาถูกลง แต่ไม่ใช่การเลี่ยงการเรียกใช้งานโมเดลโดยสิ้นเชิง
กลไกการทำงานของ LangCache
LangCache ย้ายการเก็บแคชออกมาอยู่นอกโมเดลและเก็บคำตอบที่เคยสร้างไว้โดยตรง ซึ่ง สถาปัตยกรรม จะเป็นวงจรการเรียกแบบสองจังหวะ เริ่มจากแอปส่งพรอมต์ไปที่ POST /v1/caches/{cacheId}/entries/search เพื่อให้ระบบสร้าง embedding และค้นหาด้วยวิธี vector search หากความคล้ายคลึงผ่านเกณฑ์ (similarity threshold) ที่ตั้งไว้ ระบบจะคืนคำตอบทันทีโดยไม่เรียก LLM แต่ถ้าไม่พบ (miss) แอปจึงจะเรียก LLM ตามปกติแล้วค่อยบันทึกข้อมูลผ่าน POST /v1/caches/{cacheId}/entries เพื่อใช้ในอนาคต
บริการนี้จะจัดการเรื่องการสร้าง Embedding ให้โดยอัตโนมัติ ซึ่งผู้ใช้สามารถเลือกใช้โมเดลมาตรฐานหรือนำโมเดลมาเองก็ได้ การควบคุมพฤติกรรมของแคชทำได้ผ่านการตั้งค่า similarity thresholds, TTLs และนโยบายการไล่ข้อมูลออก (eviction policies) เนื่องจากทำงานบนฐานข้อมูลเวกเตอร์ของ Redis และเชื่อมต่อผ่าน REST API จึงสามารถใช้งานร่วมกับผู้ให้บริการ LLM และภาษาโปรแกรมใดก็ได้
วิเคราะห์ความคุ้มค่าและความเร็ว
การเกิด Cache hit ช่วยตัดทั้ง input tokens, output tokens และความหน่วงในการประมวลผลออกไป จากการทดสอบเปรียบเทียบพบว่า การเรียกโมเดลโดยตรงใช้เวลา 2.232 วินาที พร้อมค่า token จำนวนมาก ขณะที่ LangCache ส่งคืนคำตอบได้ในเวลาเพียง 0.37 วินาที โดยไม่เสียค่า token เลย ซึ่งเร็วขึ้นประมาณ 6 เท่าในการทดสอบเบื้องต้น
สำหรับการคำนวณความคุ้มค่า Redis แนะนำสูตรประมาณการคือ Est. monthly savings = (Monthly output token costs) x (Cache hit rate) ตัวอย่างเช่น หากจ่ายค่า LLM เดือนละ $200 โดยเป็นค่า output tokens 60% และมีอัตรา hit rate 50% จะช่วยประหยัดเงินได้ราว $60 ต่อเดือน โดยมี เครื่องคำนวณการประหยัด ให้ใช้งานผ่านหน้าเว็บ
ข้อมูลจาก ประกาศ public preview และกรณีศึกษาจาก Mangoes.ai ยืนยันว่าการใช้งานจริงสามารถลดการใช้ token ได้มหาศาล โดย Mangoes.ai รายงานอัตรา hit rate สูงถึง 70% ในแอปพลิเคชันเสียง ช่วยลดค่าใช้จ่ายลง 70% และตอบสนองเร็วขึ้น 4 เท่า
ข้อควรระวังในการใช้ Semantic Caching
ความท้าทายสำคัญคือการตั้งค่า Threshold ที่เหมาะสม หากตั้งค่าต่ำเกินไป ระบบอาจให้คำตอบที่ผิดประเด็น แต่ถ้าตั้งสูงเกินไป แคชก็จะไม่ทำงาน การนำไปใช้จริงจึงต้องอาศัยการปรับจูนความแม่นยำ, การตั้งค่าวันหมดอายุของข้อมูล (TTL), การแยกข้อมูลระหว่างลูกค้า (tenants) และการตรวจสอบความถูกต้องสม่ำเสมอ
LangCache รองรับการจัดการเหล่านี้ผ่าน access scopes, การกรองข้อมูลแบบกำหนดเอง และการตรวจสอบผ่าน Redis Cloud โดยข้อมูลทั้งหมดจะถูกเก็บไว้ในเซิร์ฟเวอร์ Redis ของลูกค้า ซึ่งทาง Redis ยืนยันว่าไม่มีการเข้าถึงข้อมูลดังกล่าวเพื่อนำไปฝึกโมเดลต่อแต่อย่างใด
สรุปประเด็นสำคัญ
- Semantic caching ต่างจาก Prefix caching ตรงที่สามารถเลี่ยงการเรียก LLM ได้ทั้งหมดเมื่อพบข้อมูลในแคช
- ระบบทำงานผ่าน REST API สองขั้นตอน: ค้นหาก่อนเรียกโมเดล และจัดเก็บหลังได้รับคำตอบ
- ช่วยประหยัดค่าใช้จ่ายหลักจากส่วนของ output tokens
- ผลการทดสอบแสดงความเร็วที่เพิ่มขึ้นอย่างชัดเจน และประหยัดค่าใช้จ่ายได้สูงสุดถึง 90% ตามการตั้งค่า
- ความปลอดภัยและความแม่นยำขึ้นอยู่กับการปรับจูน Thresholds และการจัดการข้อมูลที่รัดกุม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร