
Nokia เปิดซอร์ส AnyJev เปลี่ยน Open LLM เป็นโมเดลตัดสินใจแม่นยำสูง
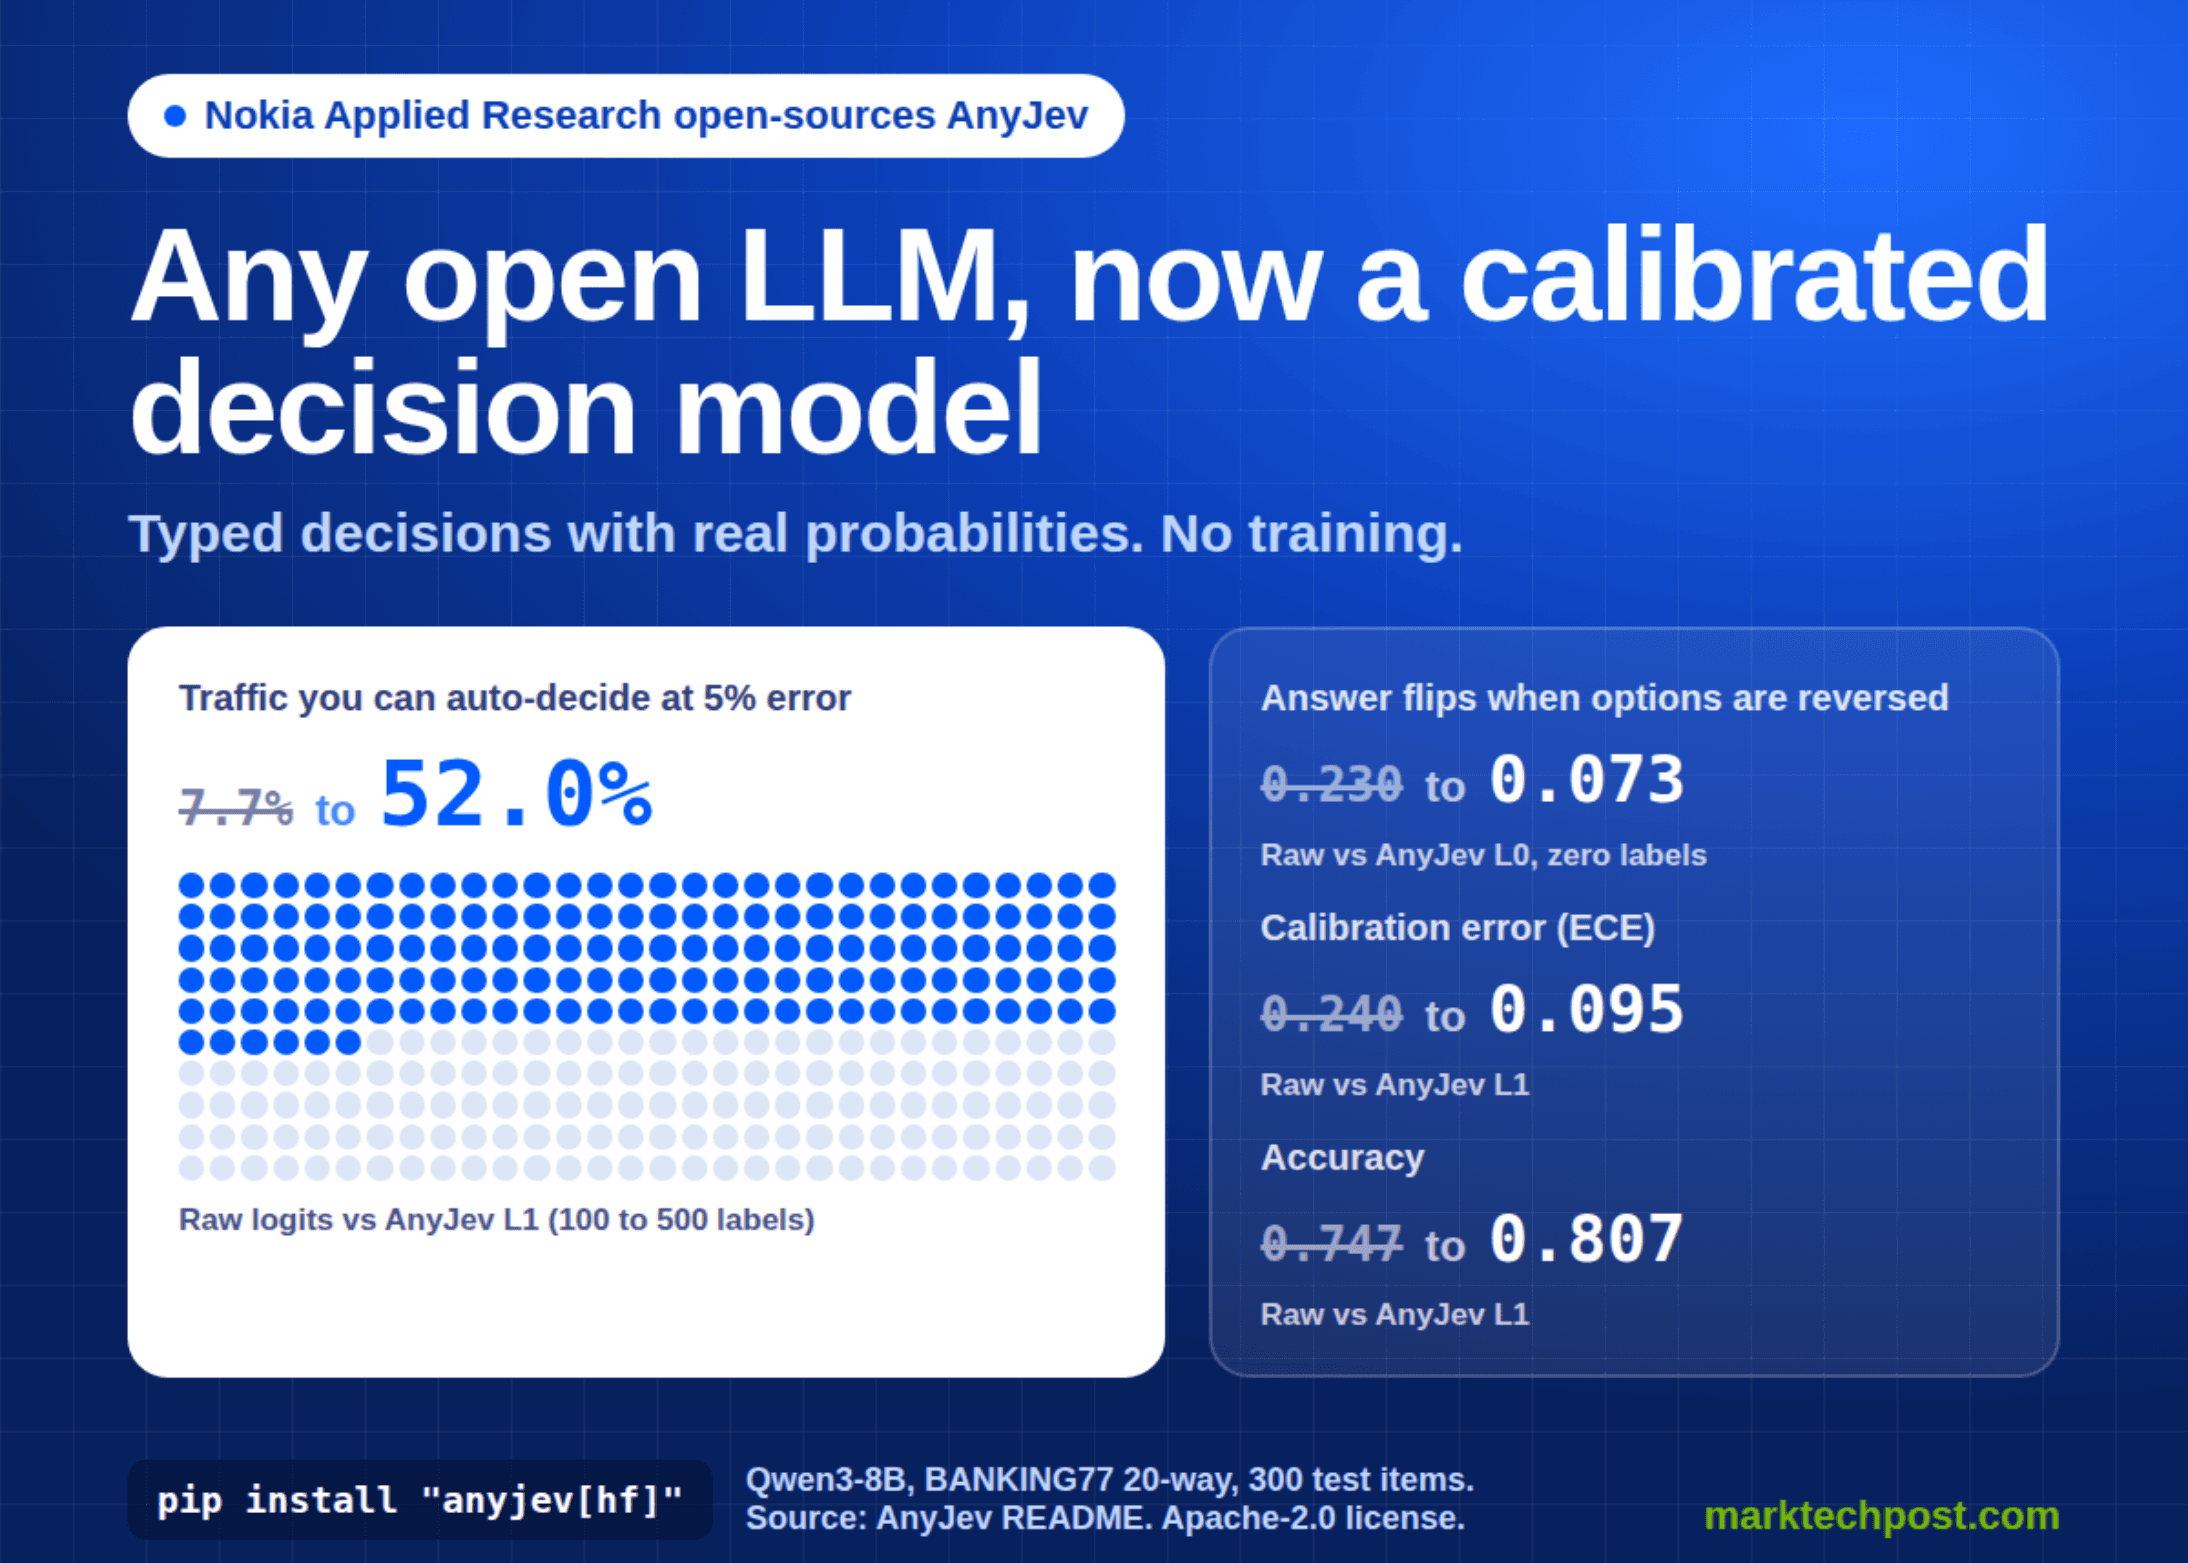
ทีมวิจัยประยุกต์ของ Nokia ได้เปิดตัว AnyJev ซึ่งเป็นไลบรารี Python โอเพนซอร์สที่เปลี่ยน open LLM ให้กลายเป็นโมเดลการตัดสินใจ (decision model) โดยไม่จำเป็นต้องผ่านกระบวนการเทรน (training) มุ่งเน้นไปที่การใช้งานในระดับโปรดักชัน เพื่อเลือกคำตอบที่ถูกต้องจากชุดคำตอบที่กำหนดไว้แทนการเขียนประโยคยาวๆ
ปัจจุบัน AnyJev พร้อมใช้งานแล้วผ่าน PyPI ภายใต้สัญญาอนุญาตแบบ Apache-2.0 โดยรองรับทั้ง backend ของ Transformers และ vLLM พร้อมความสามารถในการทำ shared-prefix scoring เพื่อประสิทธิภาพสูงสุด
AnyJev คืออะไร?
AnyJev พัฒนาโดยอ้างอิงอินเทอร์เฟซจาก Jev ซึ่งเป็นโมเดลการตัดสินใจแบบ System One ที่ TypeSafe AI เปิดตัว เมื่อเดือนกันยายน 2026 ผู้ใช้สามารถส่งคำถามที่มีการกำหนดประเภท (typed question) และรับผลการตัดสินใจกลับมาพร้อมค่าความน่าจะเป็นที่กำหนดเกณฑ์ (threshold) ได้
หัวใจสำคัญคือการอ่านค่าจากความน่าจะเป็นของการกระจาย next-token ของโมเดลโดยตรง ทำให้ไม่ต้องเสียเวลาสร้างข้อความ (generation) หรือวิเคราะห์ไวยากรณ์ (parsing) โดยตัวไลบรารีรองรับคำถาม 3 รูปแบบหลัก ได้แก่ choice สำหรับเลือกหนึ่งจากหลายตัวเลือก, noul สำหรับการตอบใช่หรือไม่ใช่ และ score สำหรับการจัดอันดับคำตอบลงในกลุ่ม
ปัญหาของการอ่าน Logits โดยตรง
แม้โปรเจกต์โอเพนซอร์สจำนวนมากจะใช้วิธีอ่านคะแนนจากป้ายกำกับโดยตรง แต่ทีมวิจัย Nokia พบข้อบกพร่องสำคัญ 2 ประการ คือ คำตอบมักเปลี่ยนแปลงเมื่อมีการเรียงลำดับตัวเลือกใหม่ และค่าความน่าจะเป็นที่ได้มักไม่ผ่านการ Calibrate ทำให้ขาดความแม่นยำ
จากเอกสาร levels doc ระบุว่าสาเหตุมาจากอคติ 2 ด้าน คือ Prior bias ที่โมเดลเอนเอียงเข้าหาป้ายกำกับบางอย่าง เช่น "Yes" มากกว่า "No" โดยธรรมชาติ และ Position bias ที่โมเดลมักชอบตัวเลือกที่อยู่ในตำแหน่งเฉพาะในรายการ
AnyJev ทำงานอย่างไร: L0 และ L1
ทุกการตัดสินใจใน AnyJev จะมีการกำกับระดับ (level) เพื่อจัดการอคติดังกล่าว โดยในระดับ L0 (ระดับเริ่มต้น) จะใช้วิธี Cyclic shifts ด้วยการหมุนลำดับตัวเลือกให้ทุกตัวเลือกปรากฏในทุกตำแหน่งหนึ่งครั้ง แล้วนำผลลัพธ์มารวมกันแบบค่าเฉลี่ยเรขาคณิต (geometric mean) ร่วมกับการทำ Prior correction เพื่อหักลบอคติสะสมออกไป
ระดับ L0 มีค่าใช้จ่ายเล็กน้อยในส่วนของ prefill แต่สามารถทำแบบ batch บน shared prefix ได้ ซึ่งจากการทดสอบบน H100 หนึ่งตัว พบว่าใช้เวลาเพียง 0.25 วินาทีต่อการตัดสินใจเมื่อประมวลผลพร้อมกัน 32 รายการ
สำหรับระดับ L1 (ใช้ 100 ถึง 500 labels) จะเพิ่มการทำ Temperature scaling ต่อจาก L0 เพื่อปรับจูนความเชื่อมั่น (confidence) ให้แม่นยำยิ่งขึ้นโดยไม่เปลี่ยนลำดับของคำตอบ เหมาะสำหรับงานที่ต้องการความละเอียดสูง
ผลการทดสอบ (Benchmark)
จากการทดสอบบนโมเดล Qwen3-8B ด้วยชุดข้อมูล BANKING77 ที่มี 20 ตัวเลือก พบว่า AnyJev ให้ผลลัพธ์ที่เหนือกว่าการอ่านค่า Logits แบบปกติอย่างชัดเจน:
| Metric | Raw logits | AnyJev L0 | AnyJev L1 |
|---|---|---|---|
| Labels required | 0 | 0 | 100 to 500 |
| Flip rate when options reversed | 0.230 | 0.073 | 0.077 |
| Accuracy | 0.747 | 0.803 | 0.807 |
| Calibration error (ECE) | 0.240 | 0.184 | 0.095 |
| Auto-decidable at 5% error | 7.7% | 46.3% | 52.0% |
นอกจากนี้ ตารางการวิเคราะห์ส่วนประกอบ ยังครอบคลุมโมเดลยอดนิยมทั้ง Qwen, OLMo, Granite, Phi และ Mistral โดย Nokia ได้เริ่มนำ AnyJev ไปประยุกต์ใช้กับระบบการกำหนดเส้นทาง (routing) ภายในองค์กรและพบผลลัพธ์ที่น่าพึงพอใจ
วิธีใช้ AnyJev
# pip install "anyjev[hf]"
from anyjev import Decider, Question
from anyjev.backends.hf import HFBackend

d = Decider(HFBackend("Qwen/Qwen3-8B"))
route = Question.choice("Which team should handle this?",
["billing", "technical", "sales", "other"], name="route")

r = d.decide({"conversation": [...]}, [route])
r["route"].distribution # probabilities per option
สำหรับการใช้งานในระดับสเกล ผู้ใช้สามารถรันผ่าน vLLM พร้อมเปิดใช้งาน prefix caching เพื่อเพิ่มความเร็วในการประมวลผลได้ทันที
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร