
Google เปิดตัวโมเดลเสียง AI Edge แบบ On-Device สั่งงานไวไม่ต้องพึ่งเน็ต
10 พ.ย. 2026
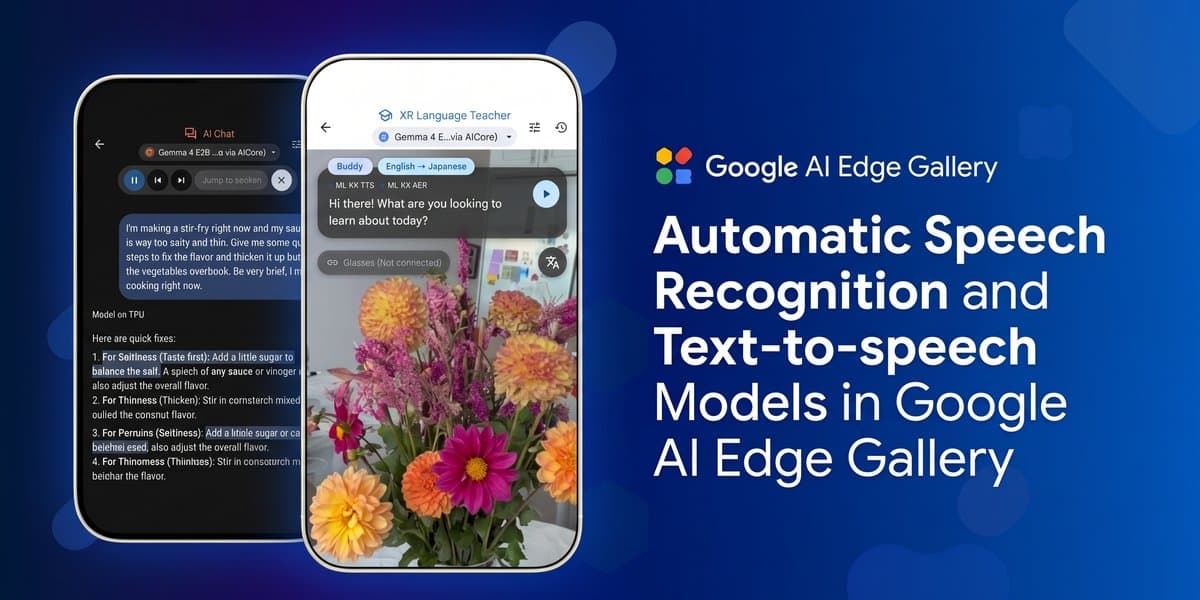
วันนี้ Google นำเสนอความสามารถใหม่ด้าน on-device Automatic Speech Recognition (ASR) และ Text-to-Speech (TTS) ใน Google AI Edge Gallery เพื่อยกระดับการโต้ตอบกับ AI บนสมาร์ทโฟนและอุปกรณ์สวมใส่ให้เป็นธรรมชาติยิ่งขึ้น ด้วยความก้าวหน้าของสถาปัตยกรรมเสียงขนาดเล็ก ทำให้นักพัฒนาสามารถรันโมเดล multilingual ASR และ expressive TTS บนอุปกรณ์ได้โดยตรง ช่วยลดความหน่วง ประหยัดหน่วยความจำ และทำงานแบบออฟไลน์ได้สมบูรณ์
การจับคู่โมเดลเสียงน้ำหนักเบาเหล่านี้กับ on-device small language models (SLMs) อย่าง Gemini Nano และ Gemma 4 ช่วยให้แอปพลิเคชันสามารถแสดงคำถอดความแบบสตรีมมิ่งสดและสังเคราะห์เสียงตอบกลับที่แม่นยำได้ทันทีในเครื่องเดียว การเปิดตัวครั้งนี้เป็นการรวมนวัตกรรมจากทั้งระบบโมเดลของ Google และระบบนิเวศแบบ open-weight เข้าด้วยกัน
สำหรับผู้ใช้งาน Android ความสามารถนี้จะขับเคลื่อนด้วย ML Kit ซึ่งมอบการถอดความหลายภาษาได้แม่นยำกว่า 100 ภาษาด้วยความเร็วที่เหนือกว่าเวลาจริง (real-time) ถึง 10 เท่า โดยใช้โมเดลเสียงพื้นฐานที่รวมเข้ากับระบบปฏิบัติการ ทำให้ไม่มีผลกระทบต่อขนาดไฟล์ APK (0 MB) ส่วนบนแพลตฟอร์ม Web และ Desktop จะใช้งานผ่าน MediaPipe Tasks และ LiteRT ซึ่งรองรับโมเดลตระกูล .litertlm เช่น Parakeet-TDT และ Kokoro-82M เพื่อการทำงานข้ามแพลตฟอร์มที่ลื่นไหลโดยไม่แย่งทรัพยากรประมวลผล
หนึ่งในตัวอย่างการใช้งานที่น่าสนใจคือ XR Language Teacher เครื่องมือช่วยเรียนภาษาในโลกแห่งความเป็นจริงที่ทำงานบนโทรศัพท์ได้เครื่องเดียว 100% แม้อยู่ในจุดที่ไม่มีสัญญาณ Wi-Fi เพียงแค่ส่องกล้องไปยังวัตถุหรือเมนูอาหารแล้วถามคำถาม ระบบจะใช้ ASR ส่งข้อมูลไปยัง Gemini Nano เพื่อประมวลผล และใช้ TTS สลับสำเนียงระหว่างภาษาแม่และภาษาเป้าหมายได้อย่างแนบเนียน
Link to Youtube Video (มองเห็นได้เฉพาะเมื่อปิดใช้งาน JS)
นอกจากนี้ Google ยังได้อัปเกรดฟีเจอร์ AI Chat ใน AI Edge Gallery ให้รองรับอินเทอร์เฟซเสียงแบบออฟไลน์ โดยผู้ใช้สามารถตั้งค่าเสียงและดาวน์โหลดแพ็กภาษาไว้ใช้งานล่วงหน้าได้ พร้อมระบบไฮไลต์ประโยคขณะอ่านออกเสียง (Auto-play TTS) ที่ช่วยให้การโต้ตอบกับแชทบอทมีชีวิตชีวามากขึ้น
Link to Youtube Video (มองเห็นได้เฉพาะเมื่อปิดใช้งาน JS)
สำหรับนักพัฒนาที่สนใจ โอเพนซอร์สโค้ดบน GitHub ได้เผยแพร่โซลูชันที่ปรับแต่งมาเพื่อ Android โดยเฉพาะผ่าน ML Kit ซึ่งช่วยให้เข้าถึงการเร่งความเร็วด้วยฮาร์ดแวร์ NPU และ TPU ได้ทันที ขณะที่ MediaPipe Tasks จะช่วยจัดการขั้นตอนที่ซับซ้อน เช่น การตรวจจับกิจกรรมเสียง (VAD) ให้กลายเป็น API ที่เรียกใช้งานง่ายบน iOS, Windows, Linux และ Web
เบื้องหลังความสำเร็จนี้คือ LiteRT โครงสร้างพื้นฐานการอนุมาน AI ประสิทธิภาพสูงของ Google โดยไฟล์โมเดล .litertlm ได้รวบรวมส่วนประกอบจำเป็นทั้งหมดไว้ในไฟล์เดียวเพื่อให้ง่ายต่อการนำไปปรับใช้ นักพัฒนาสามารถเลือกใช้โมเดลยอดนิยมจาก Hugging Face LiteRT Community เพื่อสร้างประสบการณ์การโต้ตอบด้วยเสียงที่เป็นเอกลักษณ์ในแอปพลิเคชันของตนเองได้แล้ววันนี้
ขอขอบคุณทีมงานผู้มีส่วนร่วมสำคัญในโครงการนี้:
Alice Zheng, Ajay Dudani, Alex Kanaukou, Amy Zeppenfeld, Byungchul Kim, Cheng Yang, Chintan Parikh, Chris Parsons, Cormac Brick, David Chou, Dong Chen, Geonsun Lee, Glenn Cameron, Hriday Chhabria, Ian Ballantyne, Ireneu Pla, James O’Donnell, Jamieson Pryor, Jason Poon, Jenn Lee, Jianing Wei, Jing Jin, Jingxiao Zheng, Jingyu Shi, Karthik Thirumalai, Kristen Wright, Lu Wang, Marius Kintel, Matthias Grundmann, Miao Wang, Mogan Shieh, Na Li, Paul Hsia, Qiumin Xu, Ravi Shankar, Rishika Sinha, Ronald Wotzlaw, Sachin Kotwani, Sandeep Patil, Sebastian Schmidt, Shao-Fu Shih, Shuangfeng Li, Suril Shah, Tiger Souvannakoumane, Tzu-Ping Chen, Weiyi Wang, Wentao Tu, Yang Yang, Yi-Chun Kuo, Yishuang Pang, Yu-che Liu, Yu-hui Chen, Yuling Liang, Zhihao Yang, Zichuan Wei.
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร