
OpenAI เปิดตัว Pando: Git Backend ใหม่ ลด latency ในการ Push ได้ 80%
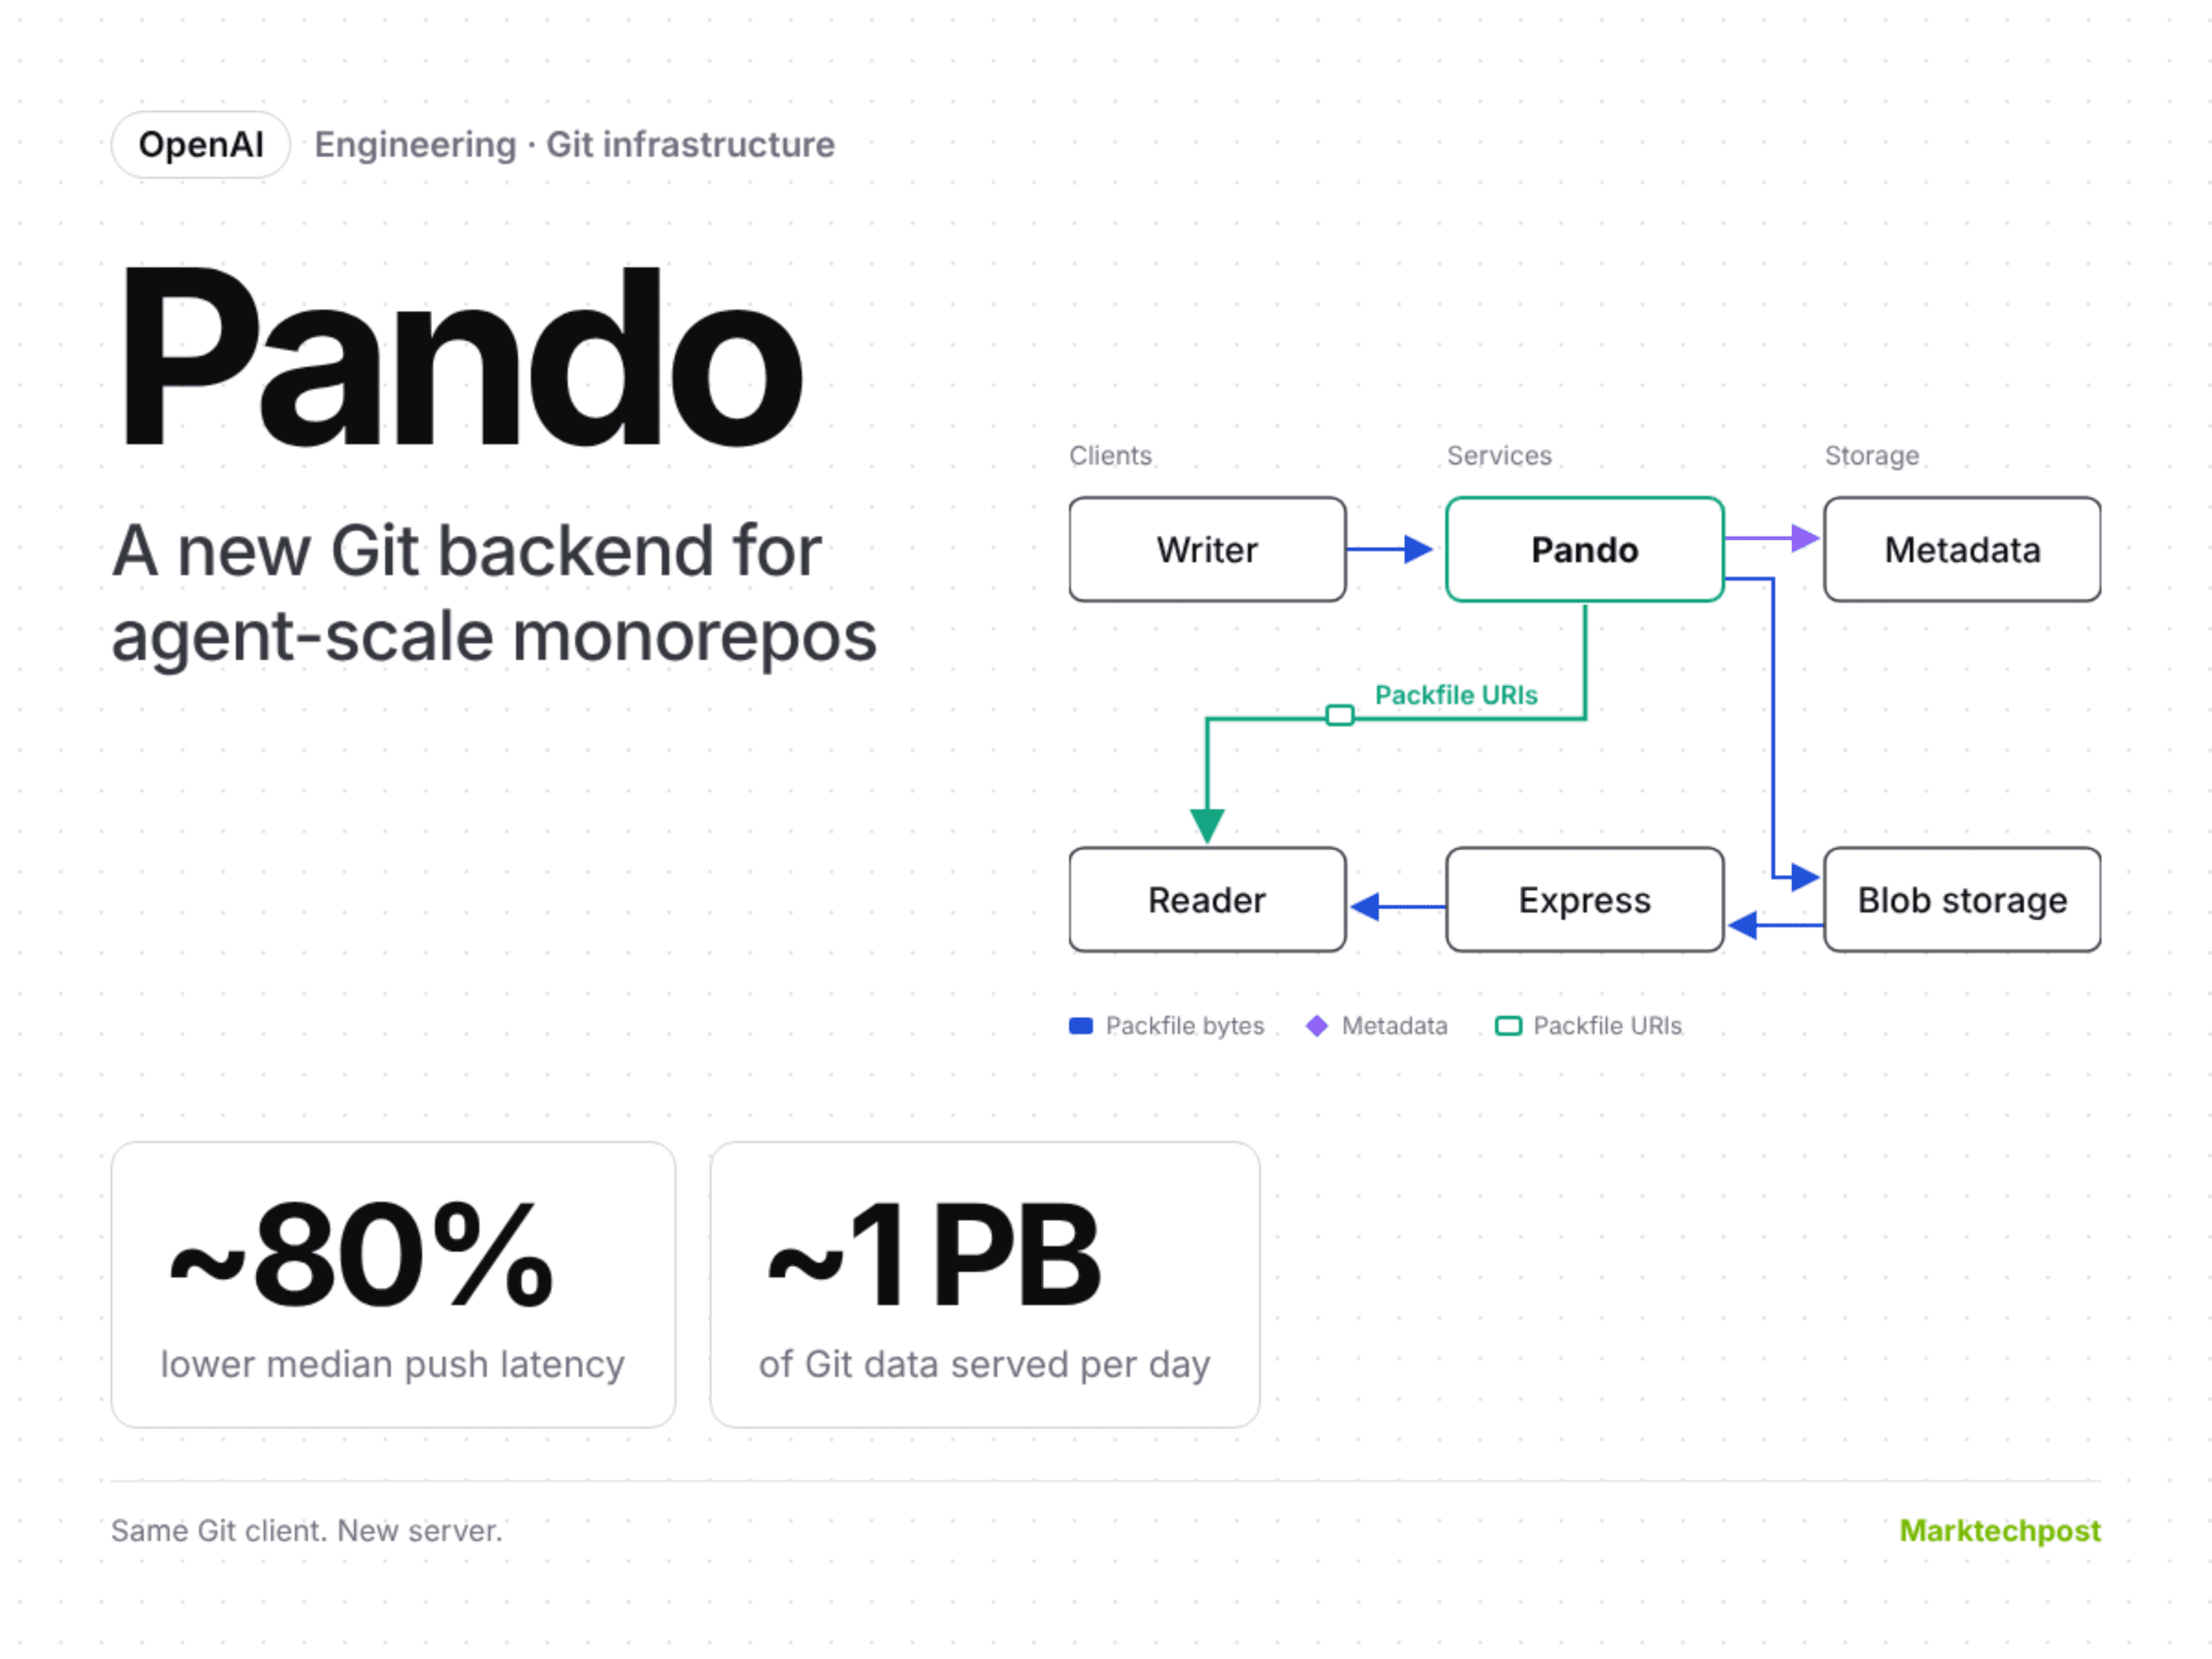
OpenAI เปิดตัว Pando ระบบ Git backend ใหม่ที่รองรับการพัฒนาซอฟต์แวร์ทั้งหมดใน monorepo ของบริษัท โดย Pando ยังคงทำงานร่วมกับ Git client และโปรโตคอลมาตรฐานได้ตามปกติ ทำให้นักพัฒนาและ Codex agent สามารถรันคำสั่ง git push และ git fetch ได้โดยไม่ต้องเปลี่ยนพฤติกรรมเดิม
ทีมวิศวกรของ OpenAI รายงานว่า Pando ช่วยลดค่าเฉลี่ย (median) ของ push latency ลงได้เกือบ 80% และปัจจุบันให้บริการข้อมูล Git ในระบบสูงถึงเกือบหนึ่ง petabyte ต่อวัน
ข้อมูลสรุป (TL;DR)
- Scale: รองรับข้อมูล Git เกือบ 1 PB ต่อวัน โดยช่วงพีคสูงสุดเกิน 57 TB ต่อชั่วโมง
- Runs on: ทำงานบนฮาร์ดแวร์ทั่วไปและ cloud VM มาตรฐาน โดยทำความเร็วแบนด์วิดท์ได้เต็มขีดจำกัด 10 Gbps ในการ clone และ fetch
- Performance: ผลทดสอบภายในระบุว่ารองรับการ push พร้อมกันหลายพันรายการโดยที่ประสิทธิภาพไม่ลดลง
- Best: Median push latency ลดลงเกือบ 80% หรือเร็วขึ้นประมาณ 5 เท่า
- Worst: ยังไม่เปิดเป็น open source และการ push branch ซ้ำจะมีการส่งประวัติส่วนที่ไม่อยู่ใน trunk ใหม่เสมอ (แต่ขนาด p99 pack ยังต่ำกว่า 3 MiB)
OpenAI Pando คืออะไร?
Pando เป็น server backend ที่เน้นการขยายขีดความสามารถในการ push และ fetch พร้อมกันจำนวนมากสำหรับ monorepo ระบบถูกเขียนขึ้นด้วยภาษา Rust และเริ่มใช้งานจริง (production) ภายในเวลาเพียง 10 สัปดาห์ จากการออกแบบโดยวิศวกรหนึ่งคนร่วมกับทีม Codex agent โดย Pando เริ่มให้บริการในระบบจริงมาตั้งแต่เดือนเมษายน 2026
ทำไม OpenAI ถึงต้องการ Git backend ใหม่?
การใช้งาน Codex ทำให้งานที่ทำขนานกันเพิ่มขึ้นมหาศาล โดยจำนวน commit ในสาขา master เพิ่มขึ้นถึง 1,378% ในช่วงไตรมาส 3 ของปี 2026 เมื่อเทียบกับต้นปี 2024 และคาดว่าจะพุ่งสูงถึง +2,442% ในไตรมาสสุดท้ายของปี 2026
การ push ที่เพิ่มขึ้นส่งผลให้เกิด CI fetch จำนวนมากตามมา จนในช่วงปลายปี 2025 ระบบเริ่มประสบความล่าช้า การ merge ล้มเหลว และความเสถียรลดลงต่ำกว่า 90% ทำให้ OpenAI สรุปว่าคอขวดอยู่ที่วิธีการให้บริการของเซิร์ฟเวอร์ ไม่ใช่ตัวโปรโตคอล Git เอง
Pando ทำงานอย่างไร?
Pando ปฏิวัติแนวคิดเดิมของเซิร์ฟเวอร์ Git ใน 2 ประเด็นหลัก:
-
Causal consistency แทน Repository-wide consistency: เซิร์ฟเวอร์ทั่วไปจะจัดลำดับการอัปเดตทุก ref ทั้ง repo ทำให้การ push ที่ไม่เกี่ยวข้องกันต้องรอคิวกัน แต่ Pando จะแยกการจัดลำดับ (serialize) เฉพาะแต่ละ branch ทำให้เกิดความขัดแย้งเฉพาะเมื่อมีการ push ไปยัง ref เดียวกันเท่านั้น แม้อาจทำให้ผู้ที่อ่านพร้อมกันหลาย branch เห็นข้อมูลต่างช่วงเวลากันบ้าง
-
Immutable packfiles แทน Unique packfile per client: แทนที่จะสร้าง pack ใหม่ทุกครั้งที่มีการ fetch ระบบ Pando จะเก็บ pack ที่ถูก push มาเป็น immutable blob และใช้ metadata store ที่ขยายขนาดได้ในการจัดการ ทำให้การ push มีความซับซ้อนในระดับ O(1) และการ fetch อยู่ที่ O(log Δ)
การเพิ่มประสิทธิภาพการ Push และ Fetch เพื่อลดภาระจากการมี branch จำนวนมหาศาลซึ่งอาจทำให้ ref advertisement ใหญ่เกิน 100 MiB Pando จะโฆษณาเฉพาะ trunk branch เท่านั้น เพื่อใช้เป็นฐานสำหรับการ push branch ใหม่ ส่งผลให้ค่าเฉลี่ยของ pack ใน monorepo ของ OpenAI มีขนาดต่ำกว่า 20 KiB
สำหรับการให้บริการ fetch ความเร็วสูง Pando จะส่งคืนลิงก์ดาวน์โหลดผ่านฟีเจอร์ packfile-uri ของ Git โดยมีบริการที่เรียกว่า Express ทำหน้าที่แคช pack ในระดับภูมิภาคด้วย consistent hashing ซึ่งให้อัตรา hit rate สูงกว่า 99%
ระบบจัดการขยะ (Garbage Collection) รูปแบบใหม่
Pando ใช้หลักการคล้าย LSM-tree compaction โดยการ push แต่ละครั้งจะสร้าง pack ระดับ "L0" จากนั้นจะมี background worker คอยรวมกลุ่ม pack ให้มีขนาดใหญ่ขึ้นตามลำดับ (L1-L4) ซึ่งทำหน้าที่เป็นเหมือน skip list ช่วยให้การเลือก pack ทำงานได้ในเวลาแบบ logarithmic
สถิติในระบบ Production และการเปรียบเทียบ
จากรายงานของ OpenAI ระบบ Pando สามารถทำสถิติดังนี้:
- Median push latency ลดลงเกือบ 80%
- ให้บริการข้อมูล Git เกือบ 1 PB ต่อวัน โดยใช้ CPU core เพียงไม่กี่ตัว
- รองรับการให้บริการ pack มากกว่า 57 TB ในชั่วโมงเดียว โดย 99% มาจาก local disk cache
| คุณสมบัติ | OpenAI Pando | GitHub Spokes | Anthropic Scion |
|---|---|---|---|
| Git client compatible | ใช่ | ใช่ | ไม่ (ใช้ scn client) |
| Write coordination | ราย branch, causal consistency | Three-phase commit + quorum | Server-side commits |
| Read path | ใช้ pack ซ้ำผ่าน packfile-uri | ชุดสำเนาที่ซิงค์ใกล้ที่สุด | Tiered tree/blob caches |
| ผลลัพธ์หลัก | Median push latency ลดลง ~80% | รองรับ repo ~1 พันล้านชุด | ใช้ทรัพยากรน้อยลง 200 เท่า |
| ระยะเวลาสร้าง | 10 สัปดาห์ (Rust) | ไม่เปิดเผย | 7 คน, 5 เดือน |
การพัฒนาและข้อจำกัด
OpenAI พัฒนา Pando โดยใช้ชุดทดสอบความสอดคล้อง (conformance suite) และการจำลองแบบกำหนดสภาวะล่วงหน้า (deterministic simulation testing) รวมถึงให้ agent GPT-6 Astra ช่วยเขียนสเปกแบบ Lean และ TLA+ เพื่อตรวจหาบั๊ก
อย่างไรก็ตาม Pando ยังมีข้อจำกัด เช่น การไม่เปิดเป็น open source ในขณะนี้, การอ่านข้าม branch จะไม่มี snapshot ณ จุดเวลาเดียวกัน และการ push branch ซ้ำจะมีการส่งข้อมูลส่วนที่ไม่อยู่ใน trunk ใหม่ทั้งหมด ซึ่งปัจจุบัน OpenAI กำลังอยู่ระหว่างการส่ง patch บางส่วนกลับไปยังต้นทาง (upstream) ของ Git เพื่อปรับปรุงการทำงานของโปรโตคอลในภาพรวม
ประเด็นที่น่าสนใจคือ Pando ถูกสร้างขึ้นเพื่อรองรับทราฟฟิกมหาศาลจาก agent ที่ทำงานขนานกัน โดยมี Michal Sutter ผู้เชี่ยวชาญด้านวิทยาศาสตร์ข้อมูลจาก University of Padova เป็นหนึ่งในกำลังสำคัญที่ช่วยเปลี่ยนชุดข้อมูลซับซ้อนให้เป็นกลไกที่ใช้งานได้จริงในระบบนี้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร