
Zyphra เปิดตัว ZHA ระบบ Sparse Attention แบบต้นไม้ ประสิทธิภาพเทียบชั้น Dense
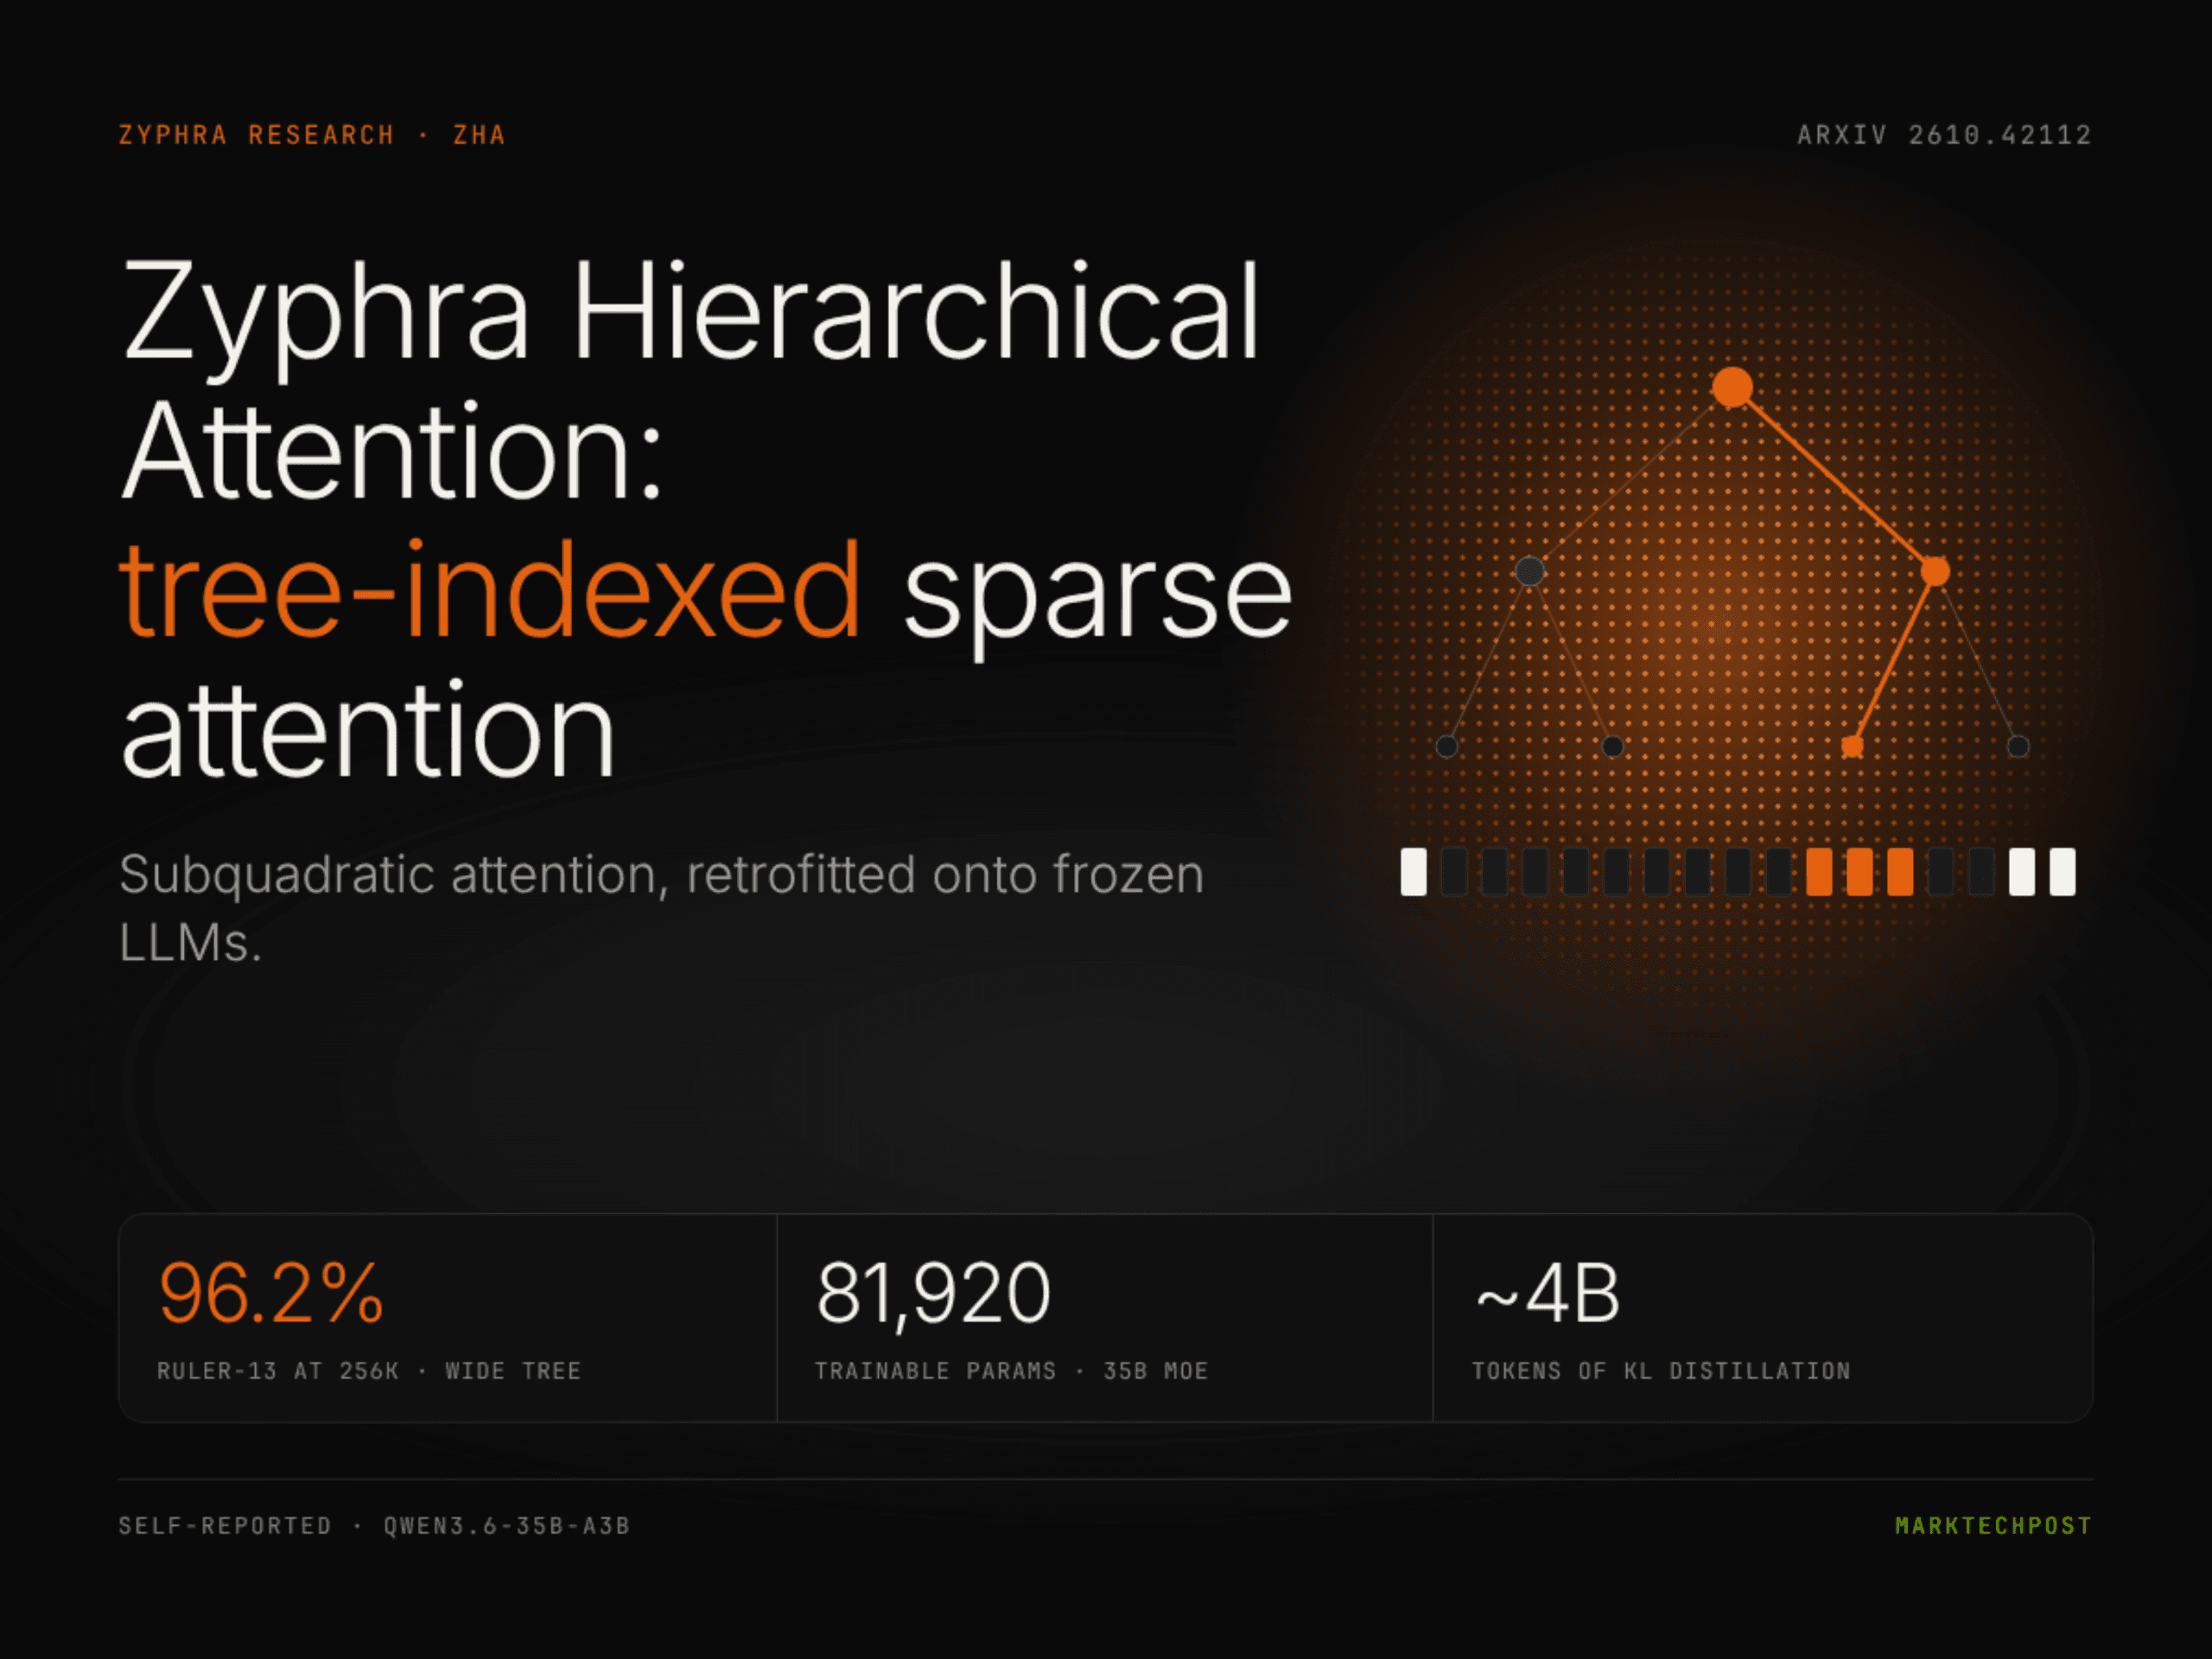
Zyphra เปิดตัว Zyphra Hierarchical Attention (ZHA) วิธีการประมวลผลแบบ Sparse Attention ที่พัฒนาขึ้นบนระบบดัชนีโครงสร้างต้นไม้ (tree-structured indexer) เพื่อแก้ปัญหาคอขวดเดิมของ Sparse Attention ที่ตัวเลือก Token ยังคงต้องสแกนบริบททั้งหมด รายงานทางเทคนิคระบุว่า ZHA สามารถนำไปติดตั้งย้อนหลัง (Retrofit) ให้กับโมเดลที่ผ่านการ Pretrain และถูกแช่แข็ง (Frozen) ไว้ได้ โดยใช้การทำ Distillation เพียง 4B Token เท่านั้น
จากการทดสอบกับรุ่น Qwen3.6-35B-A3B พบว่า ZHA ให้ผลลัพธ์ใกล้เคียงกับ Dense Attention ทั้งในด้านการใช้เหตุผล การเขียนโค้ดแบบ Agentic และเกณฑ์มาตรฐานการดึงข้อมูลที่ระยะบริบท 256K โดยมีการเพิ่มพารามิเตอร์ที่ฝึกฝนได้เพียง 81,920 ตัว หรือคิดเป็นประมาณ 0.00024% ของโมเดลเดิม
กลไกการทำงานของ Zyphra Hierarchical Attention (ZHA)
ZHA ค้นหา Key ที่เกี่ยวข้องผ่านโครงสร้างต้นไม้แทนการสแกนแบบแบน โดยยังคงรักษา KV Cache ทั้งหมดไว้ แต่ให้ระบบต้นไม้ทำหน้าที่ตัดสินใจว่า Query แต่ละตัวควรดึง Key ใดจาก Cache มาใช้งาน วิธีนี้แตกต่างจาก SSMs หรือ Sliding Windows ที่มักจะอิ่มตัวเมื่อเจอความยาวบริบทมหาศาล และมีประสิทธิภาพดีกว่า DeepSeek Sparse Attention ที่ตัวดัชนียังคงเติบโตตามขนาดบริบททั้งหมด
ในบริบทระดับ 1 ล้าน (1M) Token งานวิจัยชี้ให้เห็นว่าการทำดัชนีอาจกินเวลาถึง 60-90% ในแต่ละ Layer ซึ่ง ZHA เข้ามาเปลี่ยนการค้นหานี้ให้เป็นแบบ Sparse ในตัวเอง โดยแบ่ง Key ออกเป็น Chunk ต่อเนื่องและบีบอัดเป็น Summary Key ในหลายระดับ ตัวอย่างเช่น การแบ่ง Chunk ขนาด 4 จำนวน 6 ระดับ จะสามารถครอบคลุมได้ถึง 4,096 Token ต่อ Node สูงสุด
ประสิทธิภาพและการเลือก Token ด้วย Top-p Routing
ในขณะ Decode ตัว Query จะให้คะแนน Node ระดับบนสุดและเลือกชุดที่เล็กที่สุดที่มีสัดส่วน p ตามที่กำหนด จากนั้นจะขยายเฉพาะกิ่งลูกที่เกี่ยวข้องจนถึงรายการ KV ดั้งเดิม ระบบ Top-p ช่วยให้งบประมาณการคำนวณปรับเปลี่ยนตามสถานการณ์ หากเป็นการหาข้อเท็จจริงเดียวจะใช้เพียงไม่กี่กิ่ง แต่ถ้าต้องการข้อมูลที่กระจัดกระจายก็จะขยายกิ่งมากขึ้น โดยยังคงเก็บ Token แรกไว้เป็น Attention Sink เสมอ
ผลการทดสอบ Benchmark ของ Qwen3.6-35B-A3B ด้วย ZHA รูปแบบต่างๆ เทียบกับ Dense Attention และ MSA พบข้อมูลที่น่าสนใจ ดังนี้:
| Benchmark | Dense | ZHA deep | ZHA wide | MSA |
|---|---|---|---|---|
| AIME 2026 | 93.1 | 91.2 | 90.8 | 91.7 |
| SWE-bench Verified | 67.4 | 67.4 | 68.4 | 63.6 |
| MMLU-Pro | 84.9 | 85.3 | 85.2 | 85.3 |
| RULER-13 (256K) | 96.0 | 93.3 | 96.2 | 77.1 |
| LongBench v2 | 58.0 | 63.4 | 62.4 | 49.3 |
ที่มา: arXiv 2610.42112, รูปที่ 5 (ตัวเลขรายงานโดย Zyphra)
ความเร็วและการปรับใช้ในอนาคต
แม้ Zyphra จะยังไม่ได้ปล่อย Kernel ออกมา แต่จากการจำลองความหน่วงการ Decode บน H100 BF16 คาดการณ์ว่า ZHA จะเริ่มมีประสิทธิภาพเหนือกว่า Dense Attention ที่บริบท 48K Token และเหนือกว่า MSA ที่ 0.48M Token หากขยายไปถึงระดับ 1 พันล้าน Token ความเร็วอาจสูงกว่า Dense ถึง 373-417 เท่า
สำหรับการนำไปฝึกกับโมเดลเดิม จะมีการแช่แข็งโมเดลหลักไว้และฝึกเฉพาะ Reference Query โดยใช้ KL Loss เพื่อให้สอดคล้องกับ Dense Attention Mass ในแต่ละ Chunk ซึ่งจากการทดสอบพบว่าโมเดลขนาดต่ำกว่า 1B ประสบปัญหาในการแปลง แต่ผลลัพธ์จะดีขึ้นอย่างรวดเร็วในโมเดลระดับ 4B ขึ้นไป
บทความโดย Asif Razzaq CEO ของ Marktechpost AI Media Inc. ผู้เชี่ยวชาญด้านวิศวกรรมและสื่อด้าน AI ที่มีผู้เข้าชมแพลตฟอร์มกว่า 2 ล้านครั้งต่อเดือน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร