
Perplexity เผยเบื้องหลัง GPU Embedding Stack: เจาะลึก Ivy, Tulip และ ROSE ขับเคลื่อน pplx-embed
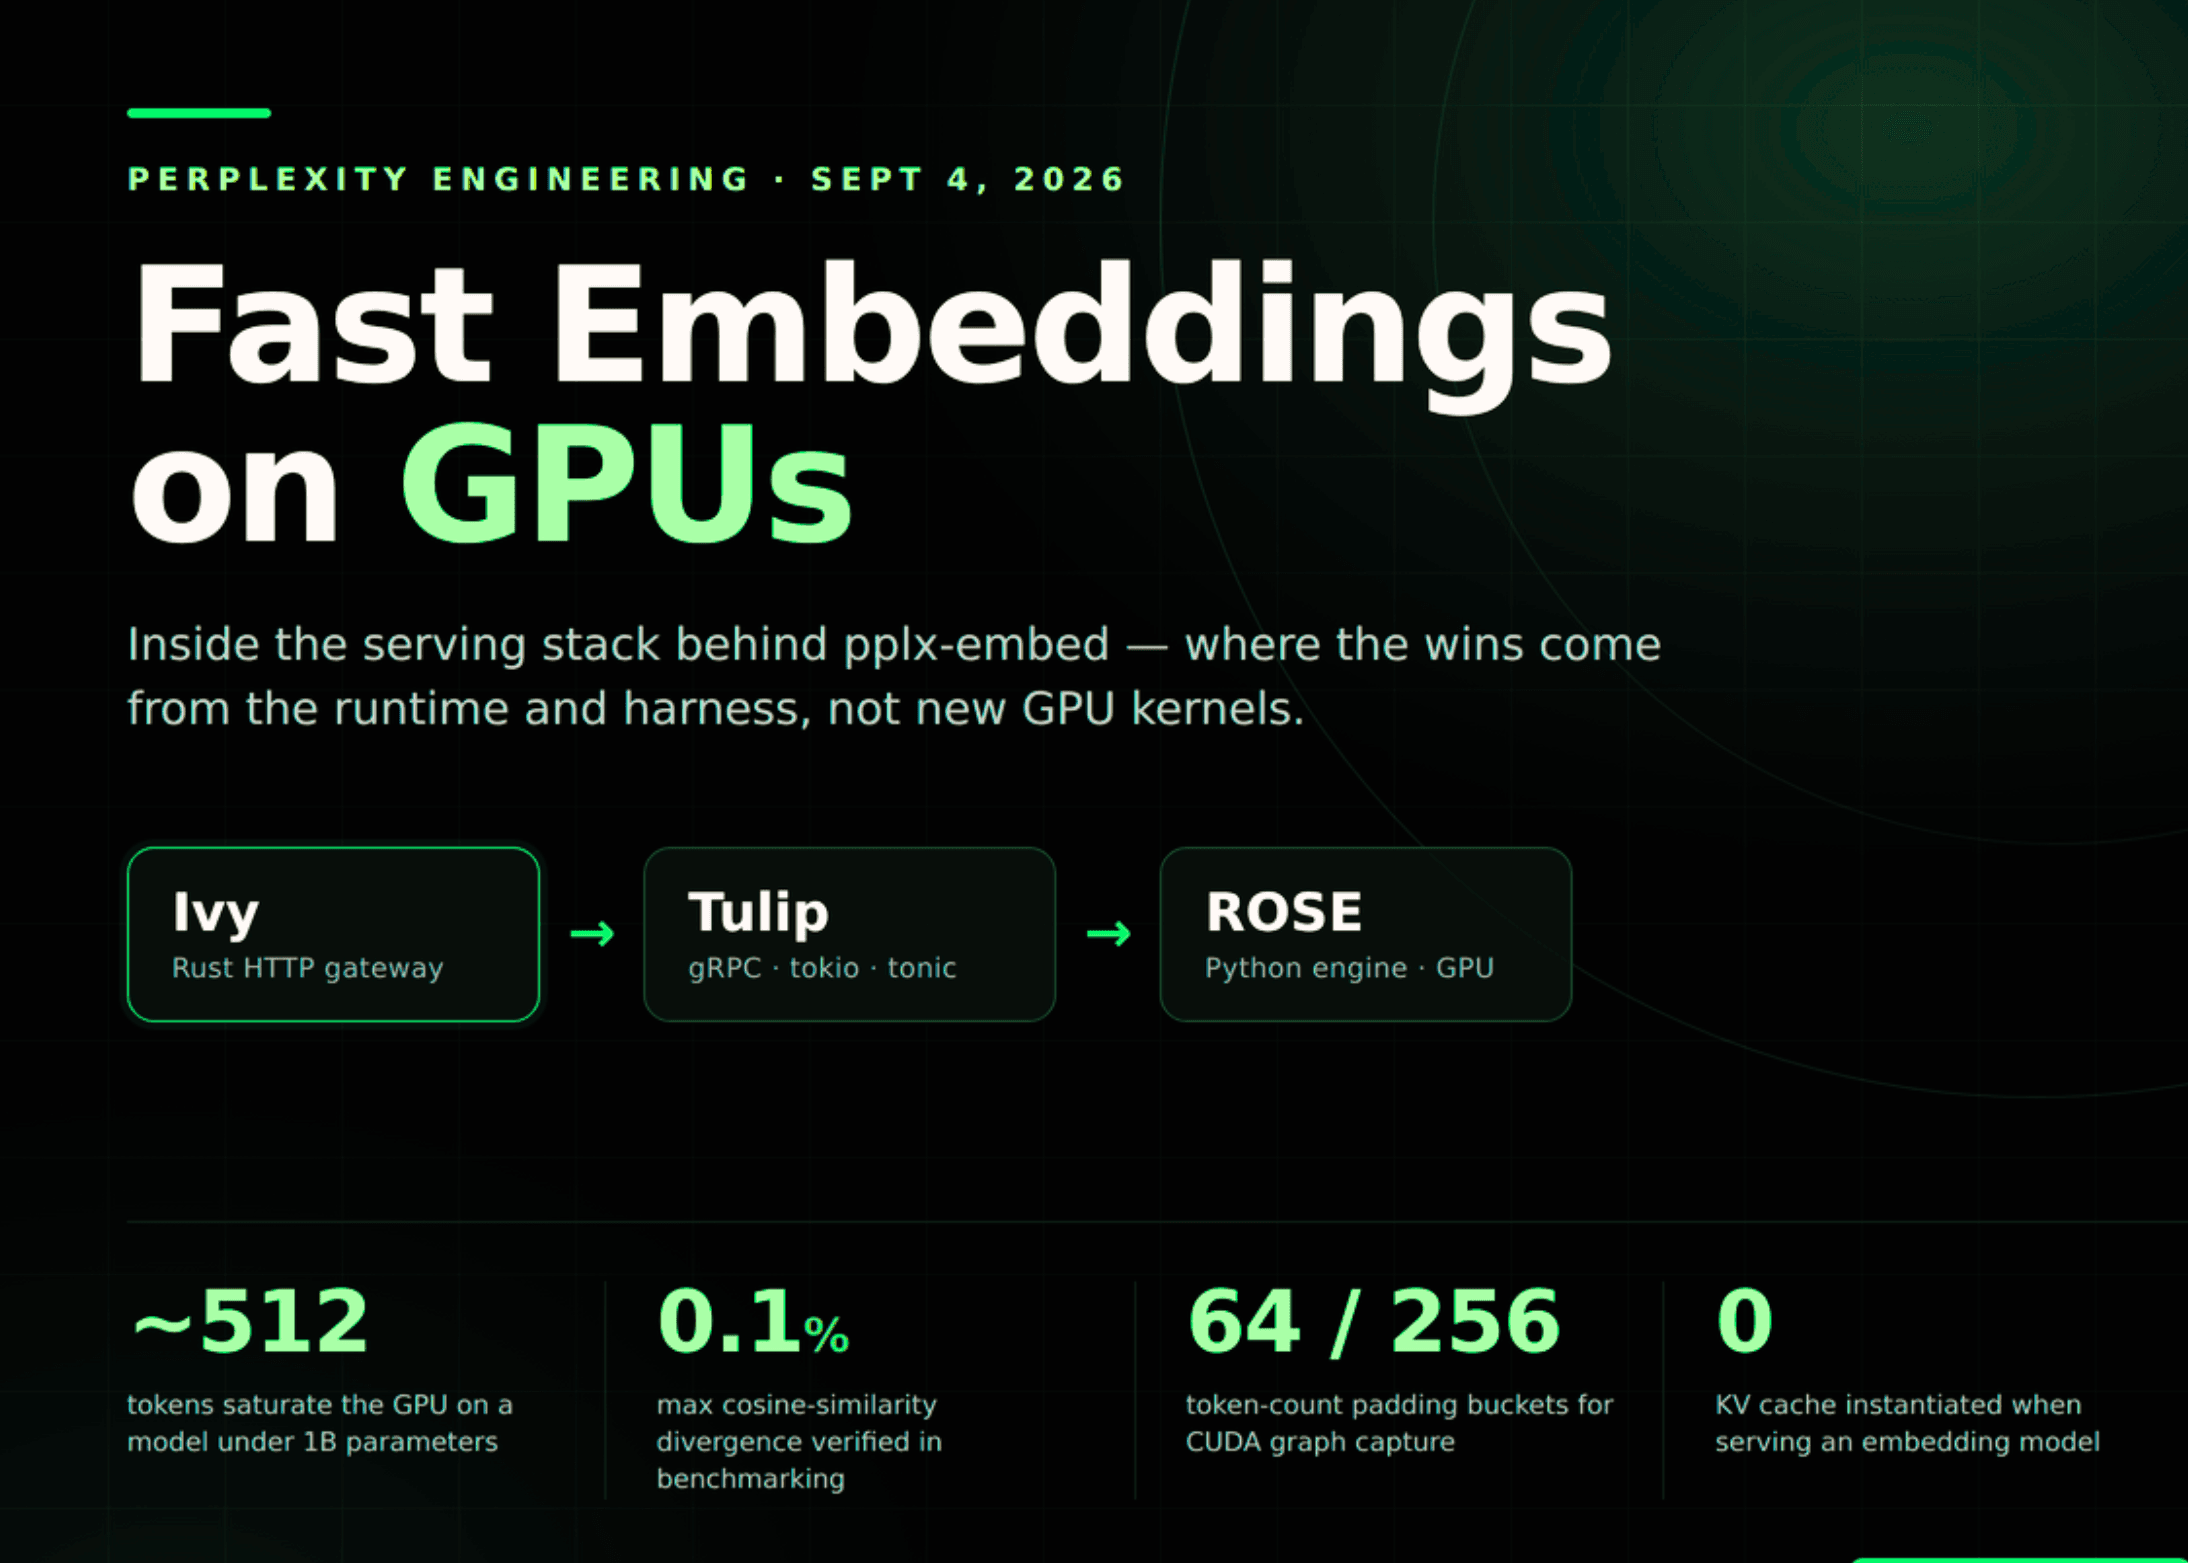
คุณภาพการสืบค้นข้อมูลของผลิตภัณฑ์ AI search ในปัจจุบันถูกจำกัดด้วยสองปัจจัยหลัก คือความสามารถของโมเดลการฝังตัว (embedding model) และความประหยัดในการรันโมเดลบนดัชนีข้อมูล (index) ล่าสุดทีมวิศวกรรมของ Perplexity ได้เผยแพร่บทความ Fast Embeddings on GPUs ซึ่งเจาะลึกถึงโครงสร้างพื้นฐานการให้บริการ (serving infrastructure) ผู้อยู่เบื้องหลัง pplx-embed และระบบจัดอันดับใน Perplexity Search, Computer รวมถึง API Platform
ทีมงานระบุว่าในขณะที่การทำ inference บน GPU เริ่มเข้าสู่จุดอิ่มตัวสำหรับฮาร์ดแวร์ยุค Hopper และ Blackwell สิ่งที่จะสร้างความแตกต่างได้จริงคือระบบที่หุ้มตัวโมเดลไว้ (runtime) เช่น การจัดการ CUDA graph, ระบบติดตามผลลัพธ์แบบ async และการใช้ภาษา Rust ในเส้นทางรับส่งข้อมูล (request path) เพื่อประสิทธิภาพสูงสุด
สองรูปแบบทราฟฟิก หนึ่งเอนจิน
Perplexity แบ่งเวิร์กโหลดการให้บริการออกเป็นสองรูปแบบคือ Batch embedding สำหรับการสร้างดัชนีฐานข้อมูลเวกเตอร์ใหม่ที่เน้น throughput เพื่อลดต้นทุน และ Online embedding สำหรับการประมวลผลคำค้นหา (query) ที่เน้นความเร็ว นอกจากนี้ยังมีงานด้าน Scoring ที่อยู่กึ่งกลางระหว่างสองแบบเพื่อจัดอันดับเอกสารหลังจากค้นหาเสร็จสิ้น
จุดที่น่าสนใจคือ Perplexity ไม่ได้สร้างเอนจินแยกสำหรับ embedding โดยเฉพาะ แต่เลือกนำ prefill และ decode kernels จาก LLM stack เดิมมาใช้ซ้ำ เนื่องจาก embedding model คือ Transformer ขนาดเล็ก ซึ่งการประมวลผลแบบ batch จะมีลักษณะคล้ายช่วง prefill ที่ติดคอขวดด้านคำนวณ ส่วน online embedding จะคล้ายช่วง decode ที่ติดคอขวดด้านหน่วยความจำ
Ivy, Tulip และ ROSE: สามประสานขุมพลัง
ระบบนี้ประกอบด้วยสามส่วนหลักที่ทำงานร่วมกัน ได้แก่ Ivy ซึ่งเป็น HTTP gateway ภาษา Rust ทำหน้าที่จัดการงานฝั่ง CPU เช่น tokenization และการทำ load-balance กระจายโหลดไปยังเครื่องอื่นๆ เพื่อป้องกันปัญหา payload ขนาดใหญ่ค้างในระบบ
ส่วนถัดมาคือ Tulip ซึ่งทำหน้าที่เป็นอินเทอร์เฟซของ inference server ผ่าน gRPC ที่พัฒนาด้วย Rust, tokio และ tonic และสุดท้ายคือ ROSE เอนจิน inference ภาษา C++ ที่ส่งต่อฟังก์ชัน step() ให้ Tulip นำไปใช้งานต่อ
การออกแบบ Scheduler ให้เรียบง่ายและมีประสิทธิภาพ
Tulip เลือกใช้ระบบจัดการลำดับแบบมาก่อนได้ก่อน (first-come, first-served) เนื่องจากผลการวัดพบว่าสำหรับโมเดลขนาดเล็ก ต้นทุนส่วนใหญ่มาจาก dense layers ไม่ใช่ attention ดังนั้นความหน่วง (latency) จึงแปรผันตามจำนวน token มากกว่าจำนวนลำดับ (sequence) เมื่อ batch หนึ่งทำให้ GPU เต็มประสิทธิภาพที่ประมาณ 512 tokens บนโมเดลที่มีพารามิเตอร์ต่ำกว่าหนึ่งพันล้าน การเพิ่มลำดับเข้าไปจึงไม่ช่วยให้เร็วขึ้น
CUDA graphs และ LazyTensors เพื่อลดภาระการเรียกใช้เอนจินจากฝั่ง CPU Perplexity ได้สร้าง whole-model CUDA graphs เพื่อรวมการทำงานของโมเดลไว้ในการเรียกใช้งานเพียงครั้งเดียว นอกจากนี้ยังได้ ส่งการแก้ไขไปยัง FlashInfer (upstreamed) เพื่อให้สามารถจับภาพ (capture) กราฟการทำงานของ attention บางประเภทที่ซับซ้อนได้
ระบบยังใช้เทคนิค lazy capture เพื่อลดระยะเวลาการเตรียมการก่อนเริ่มงาน โดยจะเริ่มจับภาพกราฟในการเรียกใช้งานครั้งที่สองแทน เพื่อไม่ให้ผู้ใช้งานต้องรอนานหลายนาทีในช่วงเริ่มต้น และมีการใช้ LazyTensor เพื่อให้งานฝั่ง CPU และ GPU สามารถทำงานซ้อนทับกันได้ (asynchronous) ช่วยให้การเตรียม batch ถัดไปทำได้ทันทีโดยไม่ต้องรอให้งานเก่าเสร็จสิ้น
ความสำคัญของ Kernel และผลการทดสอบ
ROSE รองรับการจัดการ input ที่มีความยาวไม่เท่ากันผ่าน FlashInfer และ FlashAttention โดยเลือกใช้ตามความเหมาะสมของโมเดล เช่น การใช้ FlashInfer 3 กับโมเดล ตระกูล Qwen ที่มีความยาวลำดับสูงมาก เพื่อประสิทธิภาพสูงสุดและหลีกเลี่ยงการทำ padding ที่เปลืองทรัพยากร
จากการทดสอบเปรียบเทียบกับ vLLM พบว่าระบบของ Perplexity ให้ประสิทธิภาพที่เหนือกว่าทั้งในแง่ความหน่วงต่ำและการจัดการข้อมูลจำนวนมากพร้อมกัน โดยยังคงรักษาความถูกต้องของข้อมูล (cosine similarity) ไว้ได้ในระดับแม่นยำสูงถึง 99.9% ซึ่งผู้สนใจสามารถใช้ความสามารถเหล่านี้ได้ผ่าน Perplexity’s Embeddings API
ตรวจสอบรายละเอียดเพิ่มเติมได้ที่ Technical details และติดตามเราได้ที่
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร