
TabPFN-3.5 เปิดตัว! โมเดลตารางเทพ เอาชนะแชมป์ Kaggle ด้วยค่าเริ่มต้น
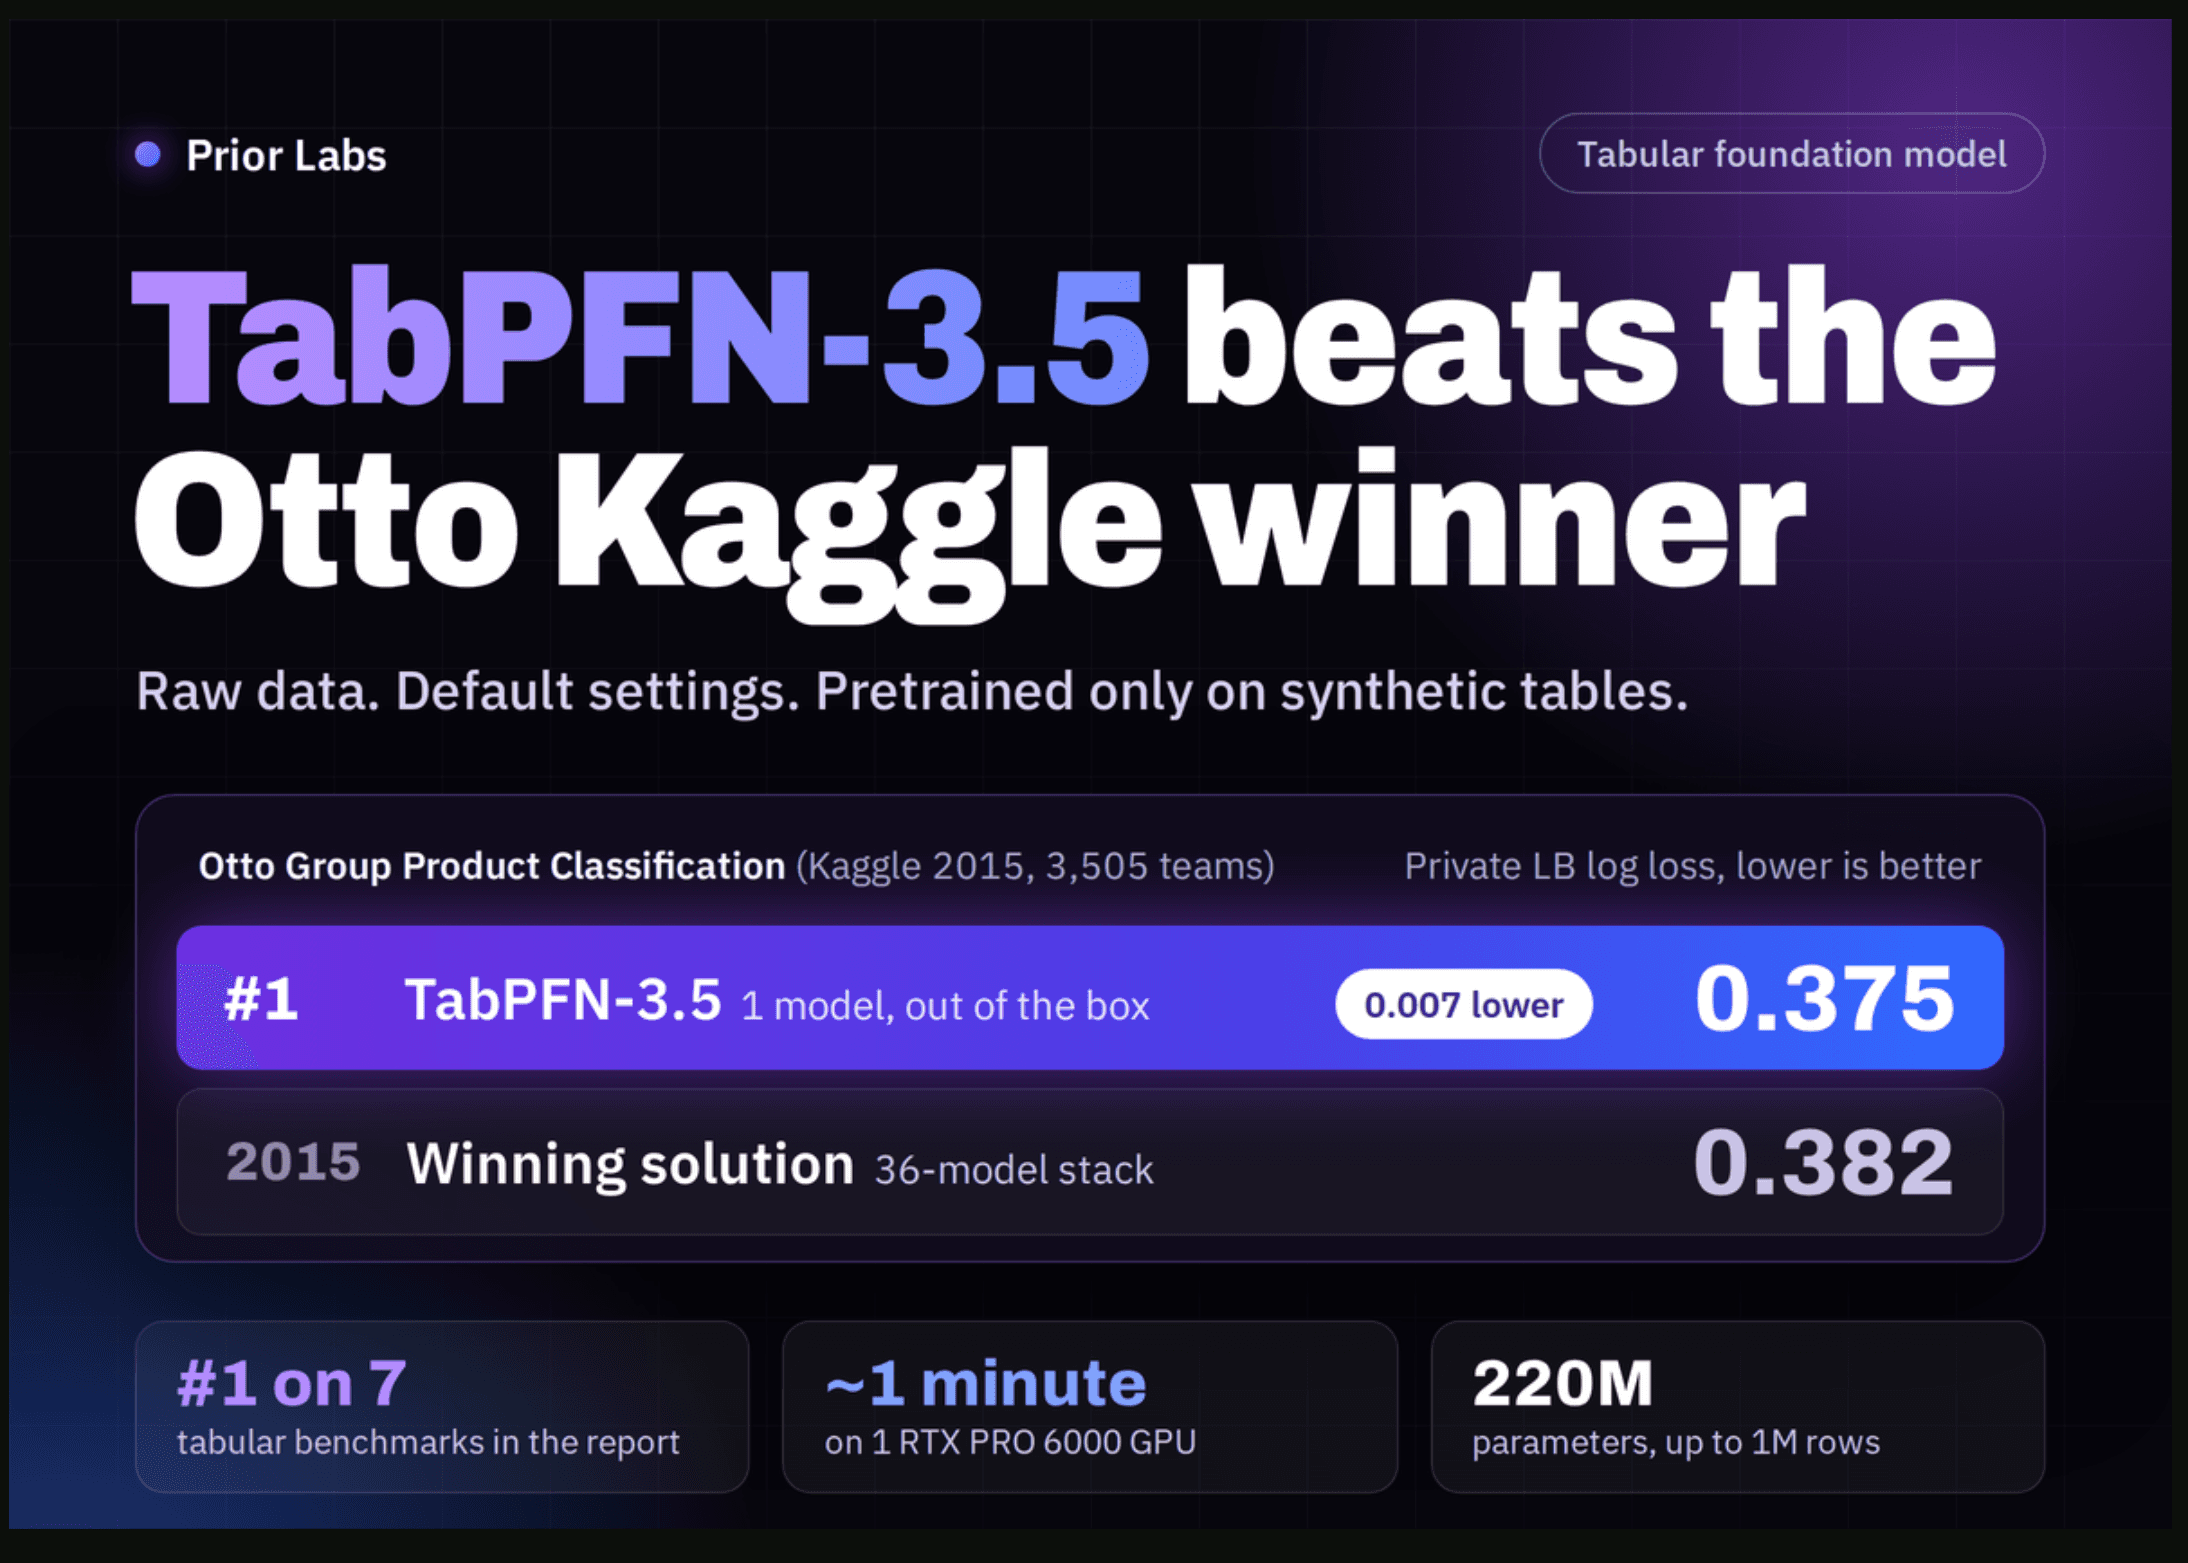
Prior Labs เปิดตัว TabPFN-3.5 เวอร์ชันล่าสุดของ Tabular Foundation Model ที่สร้างความฮือฮาด้วยการทำนายผลบนข้อมูลตารางผ่านกระบวนการ Forward Pass โดยไม่ต้องฝึกฝนหรือปรับจูนตามชุดข้อมูลใหม่ (Per-dataset training or tuning) รายงานระบุว่าโมเดลนี้ครองอันดับหนึ่งใน 7 Tabular Benchmarks และสามารถเอาชนะโซลูชันที่เคยชนะเลิศในการแข่งขัน Kaggle ชื่อดังเมื่อปี 2015 ได้สำเร็จ
สำหรับการใช้งานจริงนั้น ตัวโมเดลเปิดรูปแบบ Open weights ซึ่งสามารถรันในเครื่องเพื่อการวิจัย การประเมินผล หรือใช้ในการแข่งขัน Kaggle ได้ทันที แต่หากต้องการใช้งานในระดับ Production จำเป็นต้องใช้ผ่าน API ของ Prior Labs หรือถือใบอนุญาตเชิงพาณิชย์เท่านั้น
ผลลัพธ์เหนือชั้นในการแข่งขัน Otto
การแข่งขัน Otto Group Product Classification Challenge บน Kaggle ปี 2015 ถือเป็นตำนานที่มีทีมเข้าร่วมกว่า 3,500 ทีม โดย โซลูชันที่ชนะเลิศ ในขณะนั้นใช้วิธีซ้อนโมเดลถึง 36 ชั้นบนฟีเจอร์ที่ออกแบบด้วยมืออย่างละเอียด
Nick Erickson ผู้ร่วมสร้าง AutoGluon และนักวิจัยจาก Prior Labs เผยว่า TabPFN-3.5 สามารถทำคะแนนได้ 0.375 บน Private Leaderboard ซึ่งดีกว่าคะแนนแชมป์เดิมที่ 0.382 โดยใช้เพียงข้อมูลดิบและการตั้งค่าเริ่มต้น (Default settings) รันบน GPU รุ่น RTX PRO 6000 เพียง 1 นาทีเท่านั้น ทั้งที่โมเดลนี้ถูก Pretrain จากข้อมูลสังเคราะห์และไม่เคยเห็นชุดข้อมูล Otto มาก่อนเลย ผู้ที่สนใจสามารถดูวิธีการทำซ้ำได้ที่ Kaggle notebook
ทุบสถิติ Benchmark ระดับโลก
ตามข้อมูลใน รายงานทางเทคนิค TabPFN-3.5 ขึ้นแท่นอันดับหนึ่งในหลายสมรภูมิ เช่น TabArena, BeyondArena, STRABLE, MulTaBench, RelArena-α, TALENT และ ScoringBench โดยเฉพาะใน TabArena รุ่น Thinking ทำคะแนน Elo ได้สูงถึง 1910 นำหน้าคู่แข่งอย่าง TabFM+ และ AutoGluon 1.6 extreme อย่างขาดลอยโดยใช้เวลาประมวลผลเพียง 1 ใน 5 ของเวลาเดิม
แม้ใน BeyondArena ที่รวมชุดข้อมูลที่ซับซ้อนกว่า 142 ชุด TabPFN-3.5 จะมีคะแนนนำโด่งกว่า 150 Elo points แต่ในส่วนของข้อมูลที่มีการจัดกลุ่ม (Grouped), ข้อมูลตามช่วงเวลา (Temporal) และข้อมูลขนาดใหญ่มาก โมเดลกลุ่ม MLPs ที่ผ่านการปรับจูนเฉพาะทางยังคงรักษาความได้เปรียบไว้ได้
นวัตกรรมเบื้องหลังความสำเร็จ
การอัปเกรดครั้งนี้มีการขยาย In-context Transformer จาก 512 เป็น 1024 มิติ ส่งผลให้พารามิเตอร์เพิ่มขึ้นเป็น 220M และเปลี่ยนมาใช้ Multitask Checkpoint เดียวที่จัดการได้ทั้งงาน Classification และ Regression นอกจากนี้ยังใช้การเข้ารหัสเซลล์แบบใหม่ผ่าน Fourier features และลำดับ ECDF ซึ่งช่วยให้โมเดลทนทานต่อการแปลงข้อมูลแบบ Monotonic เช่น Log scaling
ในแง่การเตรียมข้อมูล ระบบได้ตัดขั้นตอนยุ่งยากอย่าง Quantile transforms หรือ SVD features ออก ทำให้รองรับข้อมูลได้ถึง 1 ล้านแถว และฟีเจอร์สูงสุด 20,000 รายการ แม้จะมีพารามิเตอร์เพิ่มขึ้น 4 เท่า แต่การทำนายผลแบบแถวเดียวโดยใช้ Cache ยังคงรวดเร็วเท่าเดิม ส่วนในชุดข้อมูลขนาดใหญ่ โมเดลพื้นฐานอาจทำงานช้าลงกว่ารุ่นก่อนหน้าสูงสุด 2 เท่า
สมาชิกในตระกูล TabPFN-3.5
- TabPFN-3.5: รุ่นมาตรฐาน Open weights ขนาด 220M parameters
- TabPFN-3.5-Fast (alpha): รุ่นเน้นความเร็ว ขนาด 84M parameters เร็วกว่ารุ่นปกติสูงสุด 6 เท่า
- TabPFN-3.5-Plus: สำหรับลูกค้า API และองค์กร รองรับการจัดการข้อความแบบ Native และ FP8 Attention
- TabPFN-3.5-Thinking: รุ่นที่ใช้ Inference เพิ่มขึ้นเพื่อความแม่นยำสูงสุดโดยไม่ใช้ LLMs เร็วกว่ารุ่น Thinking เดิม 12 เท่า
สรุปแล้ว TabPFN-3.5 คือก้าวสำคัญของวงการ Machine Learning สำหรับข้อมูลตารางที่พิสูจน์ว่าโมเดลพื้นฐานสามารถให้ผลลัพธ์ระดับโลกได้ทันทีโดยไม่ต้องผ่านกระบวนการ Fine-tuning ที่ซับซ้อน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร