
ผลวิจัย Stanford ชี้ งานวิจัย LLM เกือบครึ่งหมดอายุภายใน 16 เดือน
Owen Queen และ James Zou นักวิจัยจาก Stanford ได้ทำการทดสอบคำกล่าวอ้างที่ถูกอ้างอิงอย่างกว้างขวาง 50 รายการเกี่ยวกับ large language models กับโมเดลต่างๆ จำนวน 20 โมเดล ผลการศึกษาพบว่าร้อยละ 44 ของงานวิจัยเหล่านั้นได้ "หมดอายุ" ไปแล้ว โดยจากการประเมินพบว่าผลการวิจัยเหล่านี้มีอายุขัยเฉลี่ยเพียง 15.7 เดือนเท่านั้น
ทีมวิจัยตรวจสอบข้อมูลโดยใช้โมเดลที่เปิดตัวระหว่างเดือนกรกฎาคม 2024 ถึงกันยายน 2026 จากผู้พัฒนา 8 ราย พบว่าผลกระทบดั้งเดิมของงานวิจัยที่หมดอายุได้จางหายไปเกือบหมด ในขณะที่อีกร้อยละ 34 อ่อนกำลังลงอย่างมาก มีเพียงร้อยละ 16 ที่ยังคงเป็นจริง และมีเพียงร้อยละ 6 เท่านั้นที่ข้อค้นพบแข็งแกร่งขึ้นเมื่อเวลาผ่านไป
สิ่งที่โมเดล "ทำไม่ได้" หมดอายุเร็วที่สุด
คำกล่าวอ้างเกี่ยวกับข้อจำกัดหรือสิ่งที่โมเดลไม่สามารถทำได้ถือเป็นกลุ่มที่หมดอายุเร็วที่สุด ตามรายงานการศึกษา โดยผลวิจัยด้านการใช้เหตุผล 5 จาก 9 รายการถูกตัดสินว่าหมดอายุแล้ว ซึ่งรวมถึงจุดอ่อนที่เคยเป็นประเด็นดังอย่างการนับตัวอักษรในคำว่า "strawberry", การคำนวณในระบบตัวเลขที่ไม่คุ้นเคย และ การสูญเสียข้อมูลในระหว่างบริบทที่ยาว
นักวิจัยตั้งข้อสังเกตว่า เนื่องจากข้อผิดพลาดเหล่านี้มีคำตอบที่ถูกต้องชัดเจน จึงทำให้ผู้พัฒนามีเป้าหมายที่แน่นอนในการฝึกฝนเพื่อแก้ไขปัญหาได้ตรงจุด
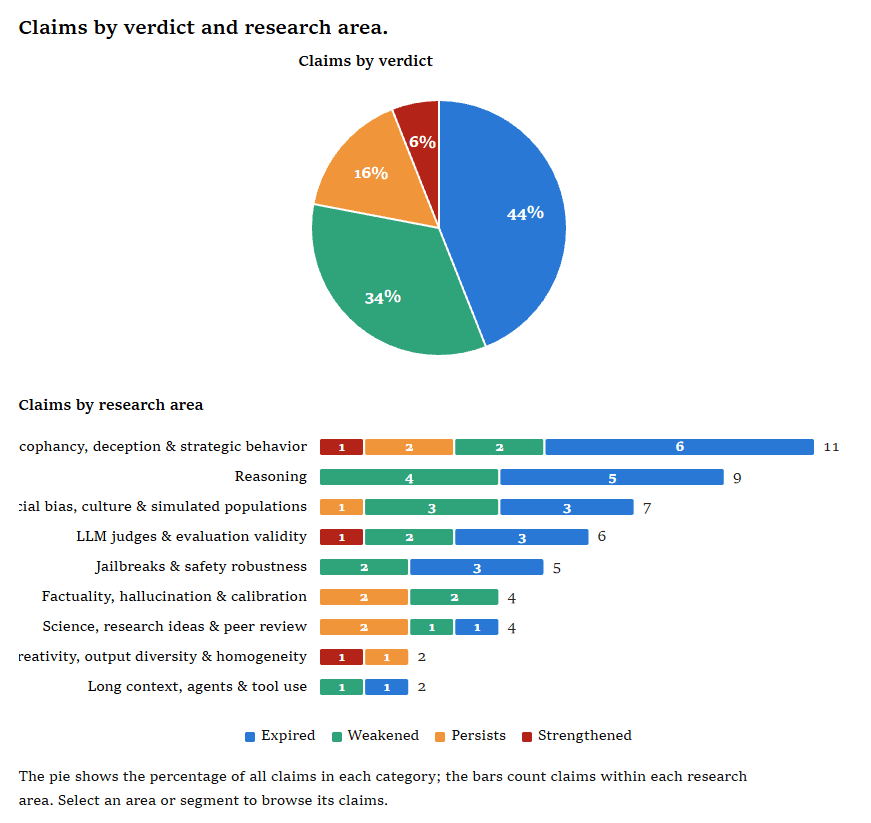
ในทางกลับกัน คำกล่าวอ้างเกี่ยวกับแนวโน้มพฤติกรรมกลับมีอายุยืนยาวกว่า โดยพบว่า LLM ยังคงมีพฤติกรรม ชอบคำตอบของตัวเอง และ มักประจบประแจงหรือเออออตามผู้ใช้ นอกจากนี้ยังพบ อคติทางการเมืองที่เอนเอียงไปทางซ้าย และความไม่สม่ำเสมอในการสร้างตัวเลขสุ่มที่ยังคงปรากฏให้เห็นในโมเดลรุ่นใหม่ๆ
การอ้างอิงที่หลอนขึ้นมาเองลดลงจากร้อยละ 55 เหลือศูนย์
จากการศึกษากรณี การสร้างข้อมูลอ้างอิงทางวิทยาศาสตร์ปลอม ซึ่งใน การศึกษาต้นฉบับปี 2023 พบว่า GPT-3.5 สร้างข้อมูลเท็จสูงถึงร้อยละ 55 แต่ปัจจุบัน GPT-6.1 Sol สามารถลดอัตราการหลอนของข้อมูลจนเหลือร้อยละ 0 ในขณะที่ Claude Sonnet 5.5 อยู่ที่ร้อยละ 1 อย่างไรก็ตาม Qwen3.7-Flash ซึ่งเป็นโมเดลรุ่นปี 2026 กลับยังคงสร้างข้อมูลเท็จสูงถึงร้อยละ 69
แม้สถิติจะดูดีขึ้นแต่การศึกษายังเตือนว่าอย่าเพิ่งวางใจ ในโจทย์แบบ two-hop ที่ต้องเชื่อมโยงข้อเท็จจริง Claude Sonnet 5.5 ยังคงพลาดในบางกรณี ส่วนประเด็นเรื่อง "คำสาปการย้อนกลับ" (Reversal Curse) แม้จะอ่อนกำลังลงแต่ก็ยังตรวจพบได้ในปัจจุบัน
ช่องว่างระหว่างโมเดลยังคงกว้างแม้จะอยู่ในรุ่นเดียวกัน
ความแตกต่างของโมเดลแต่ละตัวยังคงมีสูงมาก แม้จะเปิดตัวในช่วงเวลาเดียวกันอย่างในไตรมาส 3 ของปี 2026 พบว่า DeepSeek V4 Pro มีผลการวิจัยที่หมดอายุเพียง 11 รายการ แต่ GPT-6.1 Sol กลับมีถึง 30 รายการ ซึ่งขนาดของโมเดลหรือชื่อผู้พัฒนาไม่สามารถใช้พยากรณ์ความแม่นยำได้เสมอไป
Queen และ Zou สรุปว่างานวิจัยเชิงประจักษ์เกี่ยวกับ LLM ควรถูกมองว่าเป็นเพียงข้อสังเกตเฉพาะช่วงเวลา ไม่ใช่ความจริงนิรันดร์ พร้อมแนะนำให้ระบุเวอร์ชันและวันที่ทดสอบอย่างชัดเจนเพื่อให้สามารถนำไปตรวจสอบซ้ำได้ในอนาคต
สอดคล้องกับ โพสต์ของ Andrej Karpathy อดีตทีมผู้ก่อตั้ง OpenAI ที่ปัจจุบัน ร่วมงานกับ Anthropic ซึ่งระบุว่าสิ่งที่โลกเห็นในตอนนี้เป็นเพียง ตัวอย่างเรียกน้ำย่อยของขีดความสามารถ ที่แท้จริงของ AI ที่จะตามมาเท่านั้น
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร