
StateBench: ชุดทดสอบใหม่ วัดความสามารถ AI ในการติดตามสถานะ
📄 Tech Report | 🤗 Data | 💻 Code
เรากำลังนำเสนอ StateBench ซึ่งเป็นเบนช์มาร์คสำหรับ state tracking ใน long-context เพื่อทดสอบว่าโมเดลภาษาติดตามข้อมูลเกี่ยวกับเอนทิตีในเอกสารที่มีความยาวได้ดีเพียงใดเมื่อมีการเปลี่ยนแปลงไปตามเวลา
การติดตามสถานะ (State tracking) เป็นพื้นฐานของงานที่หลากหลาย ตั้งแต่การอ่านโค้ดที่มีการกำหนดค่าตัวแปรใหม่ ไปจนถึงการติดตามเนื้อเรื่องในนิยายที่ตัวละครเคลื่อนที่หรือสิ่งของเปลี่ยนมือ ตัวอย่างเช่น ในนิยายสืบสวน หากระบุว่า “John ให้มีดแก่ Mary” ก่อนเกิดเหตุฆาตกรรม สิ่งสำคัญคือต้องรู้ว่าสถานะของตัวละครเปลี่ยนไปอย่างไร
อย่างไรก็ตาม ปัญหาการติดตามสถานะนั้นมีความยากไม่เท่ากัน บางงานต้องการเพียงการหาการอัปเดตล่าสุด แต่บางงานที่ยากกว่าต้องติดตามห่วงโซ่การเปลี่ยนแปลง (chain of updates) ซึ่งหากพลาดเพียงขั้นตอนเดียวจะส่งผลให้คำตอบสุดท้ายผิดพลาดทันที
Transformers มีขีดจำกัดทางทฤษฎีในด้านการติดตามสถานะที่มีห่วงโซ่การพึ่งพายาวๆ ซึ่งกระตุ้นให้เกิดการพัฒนาสถาปัตยกรรมแบบ recurrent และไฮบริด เช่น Gated DeltaNet ที่สามารถส่งหน่วยความจำออกไปข้างหน้าได้ดีกว่า นักวิจัยจำเป็นต้องรู้ว่าสถาปัตยกรรมแต่ละแบบรับมือกับการติดตามสถานะประเภทใดได้บ้าง เพื่อทำความเข้าใจความแตกต่างของสถาปัตยกรรมในทุกระดับความยาก ไม่ใช่แค่ระดับที่ยากที่สุดเท่านั้น
ด้วยเหตุนี้ เราจึงพัฒนา StateBench เพื่อรวบรวมปัญหาการติดตามสถานะที่มีความซับซ้อนแตกต่างกัน ผลการประเมินพบว่าโมเดลแบบ recurrent และไฮบริดสามารถทำ generalization ได้ไกลกว่า Transformers มากเมื่อผ่านการฝึกฝนโดยตรง ในขณะที่โมเดลระดับแนวหน้า (frontier models) อย่าง Gemini 3.8 Flash, Claude Opus 5.5 รวมถึง GPT-6 Sol และ Luna ยังคงล้มเหลวในรูปแบบที่ยากขึ้นเมื่ออินพุตมีความยาวเพิ่มขึ้น
การติดตามสถานะสี่ระดับ
StateBench แบ่งความยากออกเป็น 4 ระดับ ตามความซับซ้อนของการอัปเดตสถานะ ดังนี้:
- ปัญหาแบบ R-trivial: ใช้การกำหนดค่าแบบเปลี่ยนแปลงไม่ได้ (immutable assignment) เช่น ค่าตัวแปรที่ตั้งครั้งเดียวแล้วจบ เหมือนวันเกิดที่คงที่เสมอ
- ปัญหาแบบ Aperiodic: อนุญาตให้กำหนดค่าใหม่ตามค่า (reassignment by value) โมเดลต้องหาค่าล่าสุดและเพิกเฉยต่อค่าก่อนหน้าได้ เหมือนการตั้งค่าอุณหภูมิที่ค่าล่าสุดคือตัวกำหนดผลลัพธ์
- ปัญหาแบบ Soluble: เพิ่มการอัปเดตแบบอ้างอิงตนเอง (self-referential updates) ที่การเปลี่ยนแปลงใหม่ต่อยอดจากค่าเดิม เช่น การบวกคะแนนในเกมสะสมไปเรื่อยๆ
- ปัญหาแบบ General finite: เพิ่มการกำหนดค่าโดยการอ้างอิง (assignment by reference) ที่ตัวแปรหนึ่งรับค่าจากอีกตัวแปรหนึ่ง ทำให้เกิดการพึ่งพากัน เช่น การสลับลูกบอลในถ้วยที่ต้องตามตำแหน่งให้ทันตลอดเวลา นี่คือระดับที่ยากที่สุดซึ่งมีการอภิปรายไว้ใน งานวิจัยก่อนหน้านี้เกี่ยวกับขีดจำกัดของการติดตามสถานะ
ระดับเหล่านี้มีรากฐานมาจากทฤษฎี Krohn - Rhodes ซึ่งใช้พีชคณิตอธิบายว่าปัญหาการติดตามสถานะสามารถแยกส่วนออกเป็นอะตอมมิกพริมิทิฟ (atomic primitives) ได้อย่างไร โดย StateBench ได้สร้างปัญหาที่เปรียบเทียบกันได้ในทุกระดับผ่านจำนวนตัวแปรและตำแหน่งการอัปเดตที่เท่ากัน
สิ่งที่เราพบ
โมเดลที่ผ่านการ Pretrain (Pretrained models)
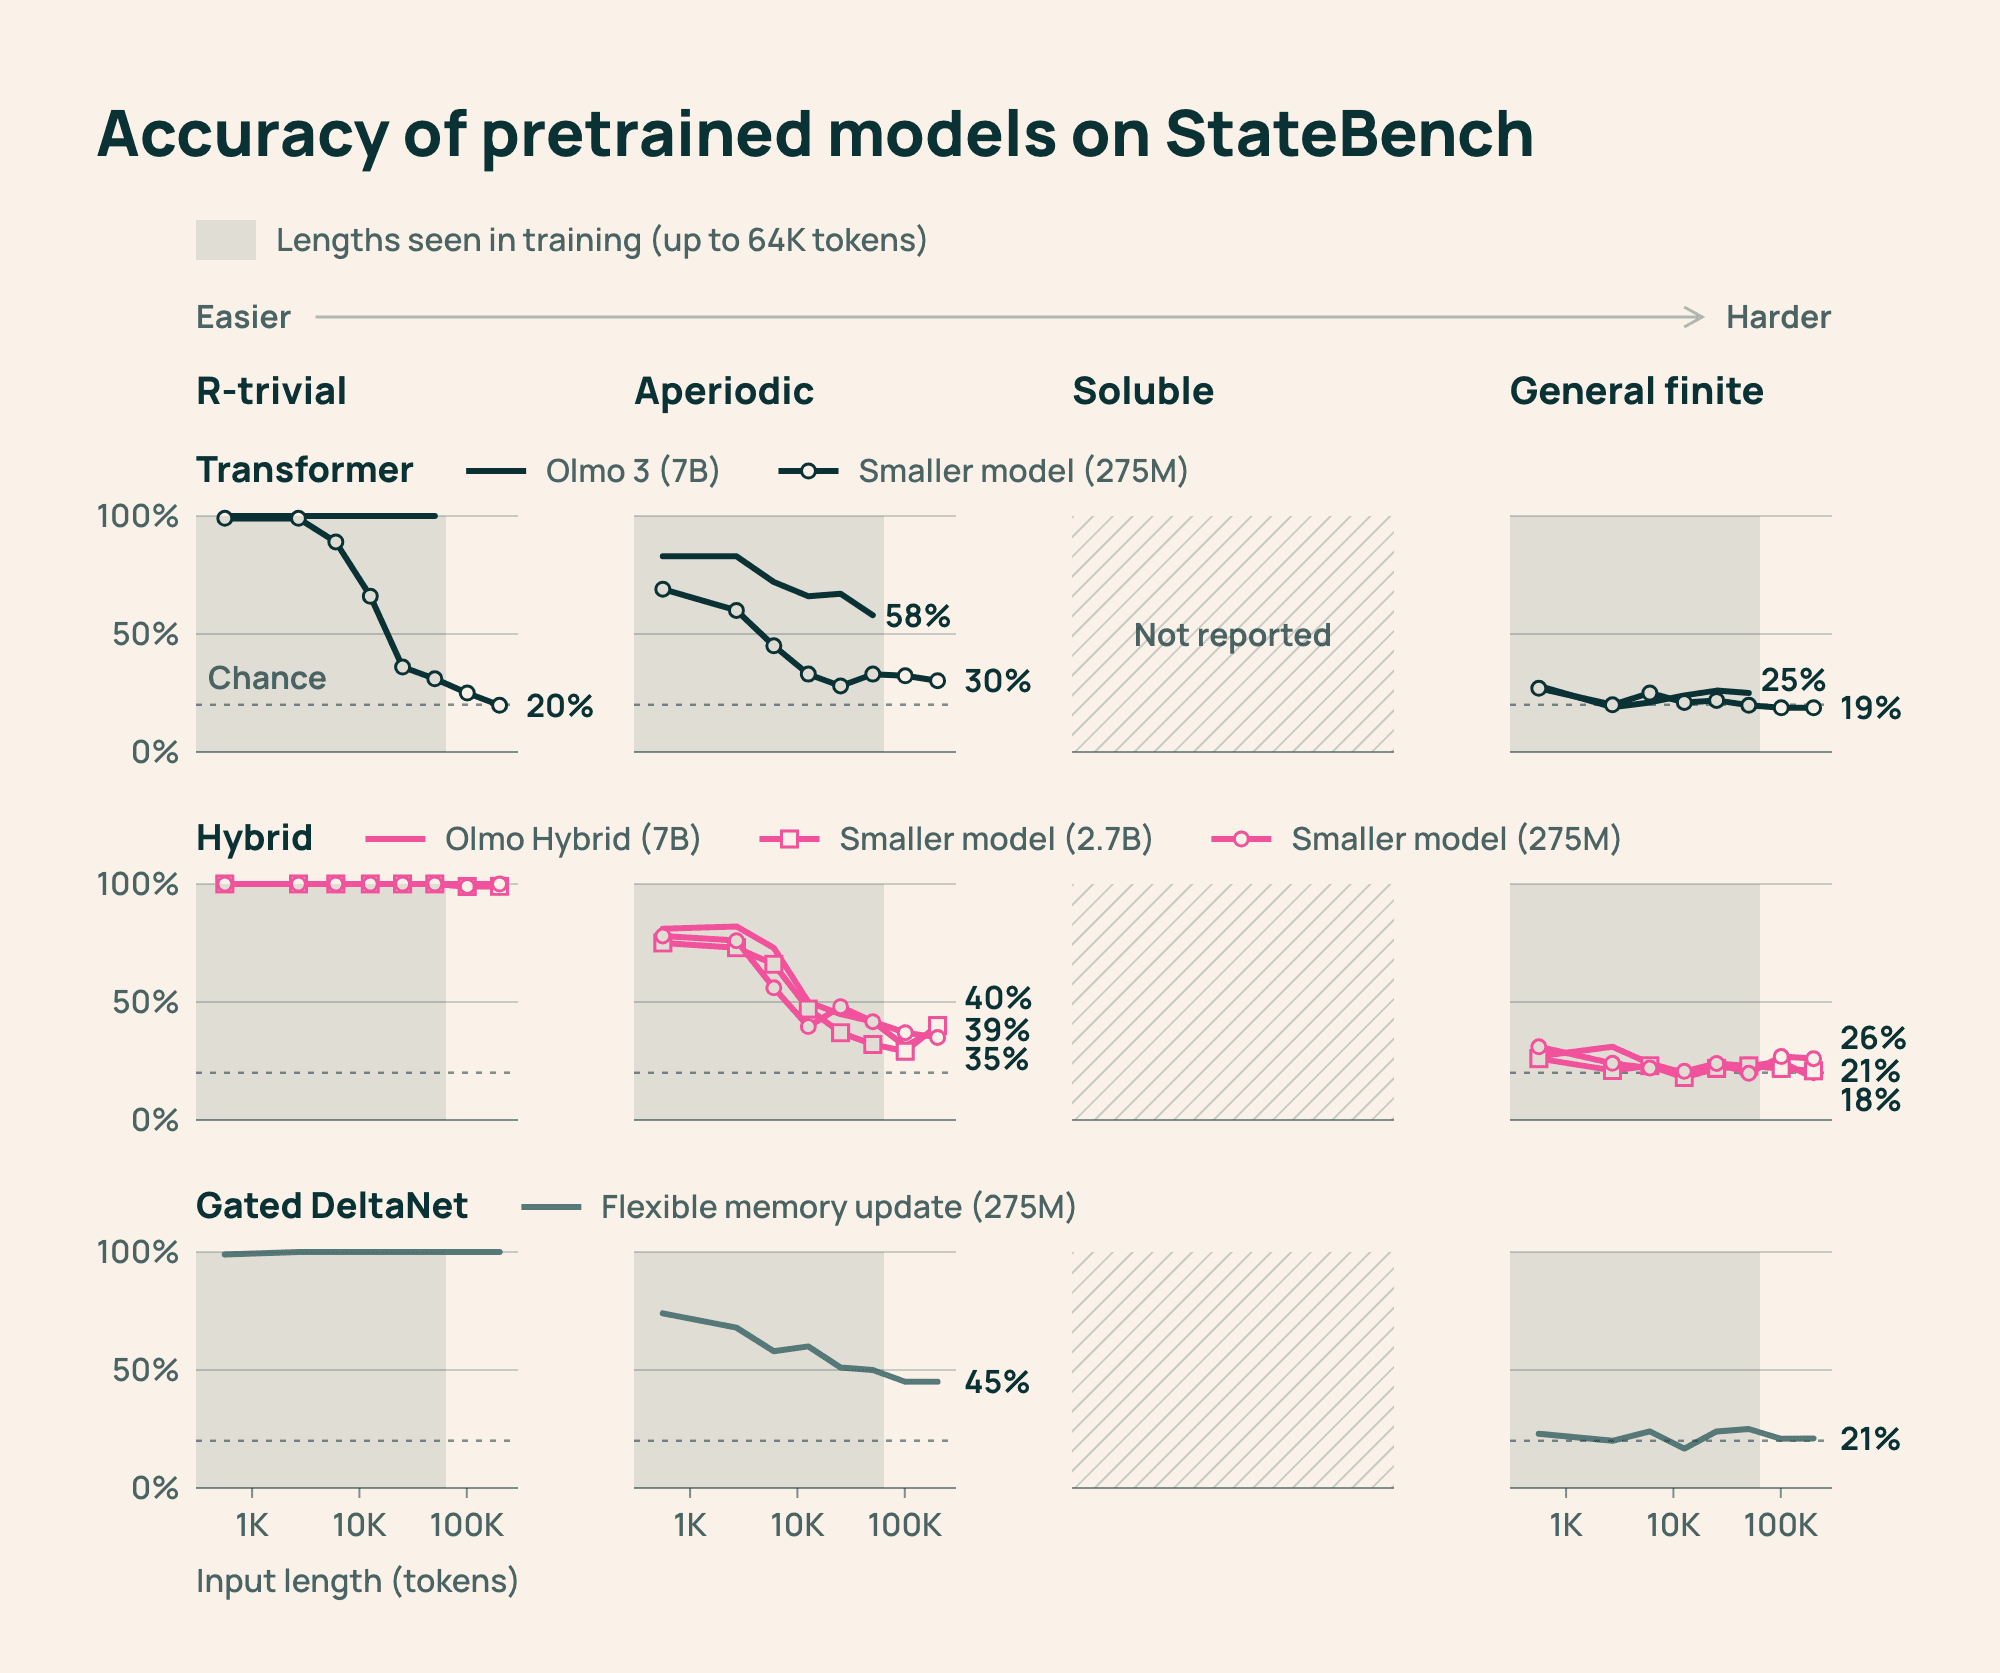
เราทดสอบโมเดลโอเพนซอร์ส เช่น Olmo 3 (Transformer) และ Olmo Hybrid (Gated DeltaNet) พบว่า Transformers จัดการ r-trivial ได้ดี แต่ล้มเหลวในปัญหาทั่วไปตามคาด ขณะที่ Gated DeltaNet สามารถจัดการได้ทุกระดับในทางทฤษฎี
เมื่อทดสอบกับอินพุตที่ยาวกว่าที่เคยฝึก (64,000 token) เกือบทุกโมเดลทำได้ดีใน r-trivial แต่แม่นยำลดลงใน aperiodic และทำได้เพียงระดับการเดาสุ่มใน general finite นอกจากนี้รูปแบบของปัญหายังมีผล โดยโมเดลไฮบริดทำคะแนนได้ดีในรูปแบบ RULER แต่กลับแย่ลงในรูปแบบการแก้ไขสเปรดชีต
โมเดลระดับแนวหน้า (Frontier models)
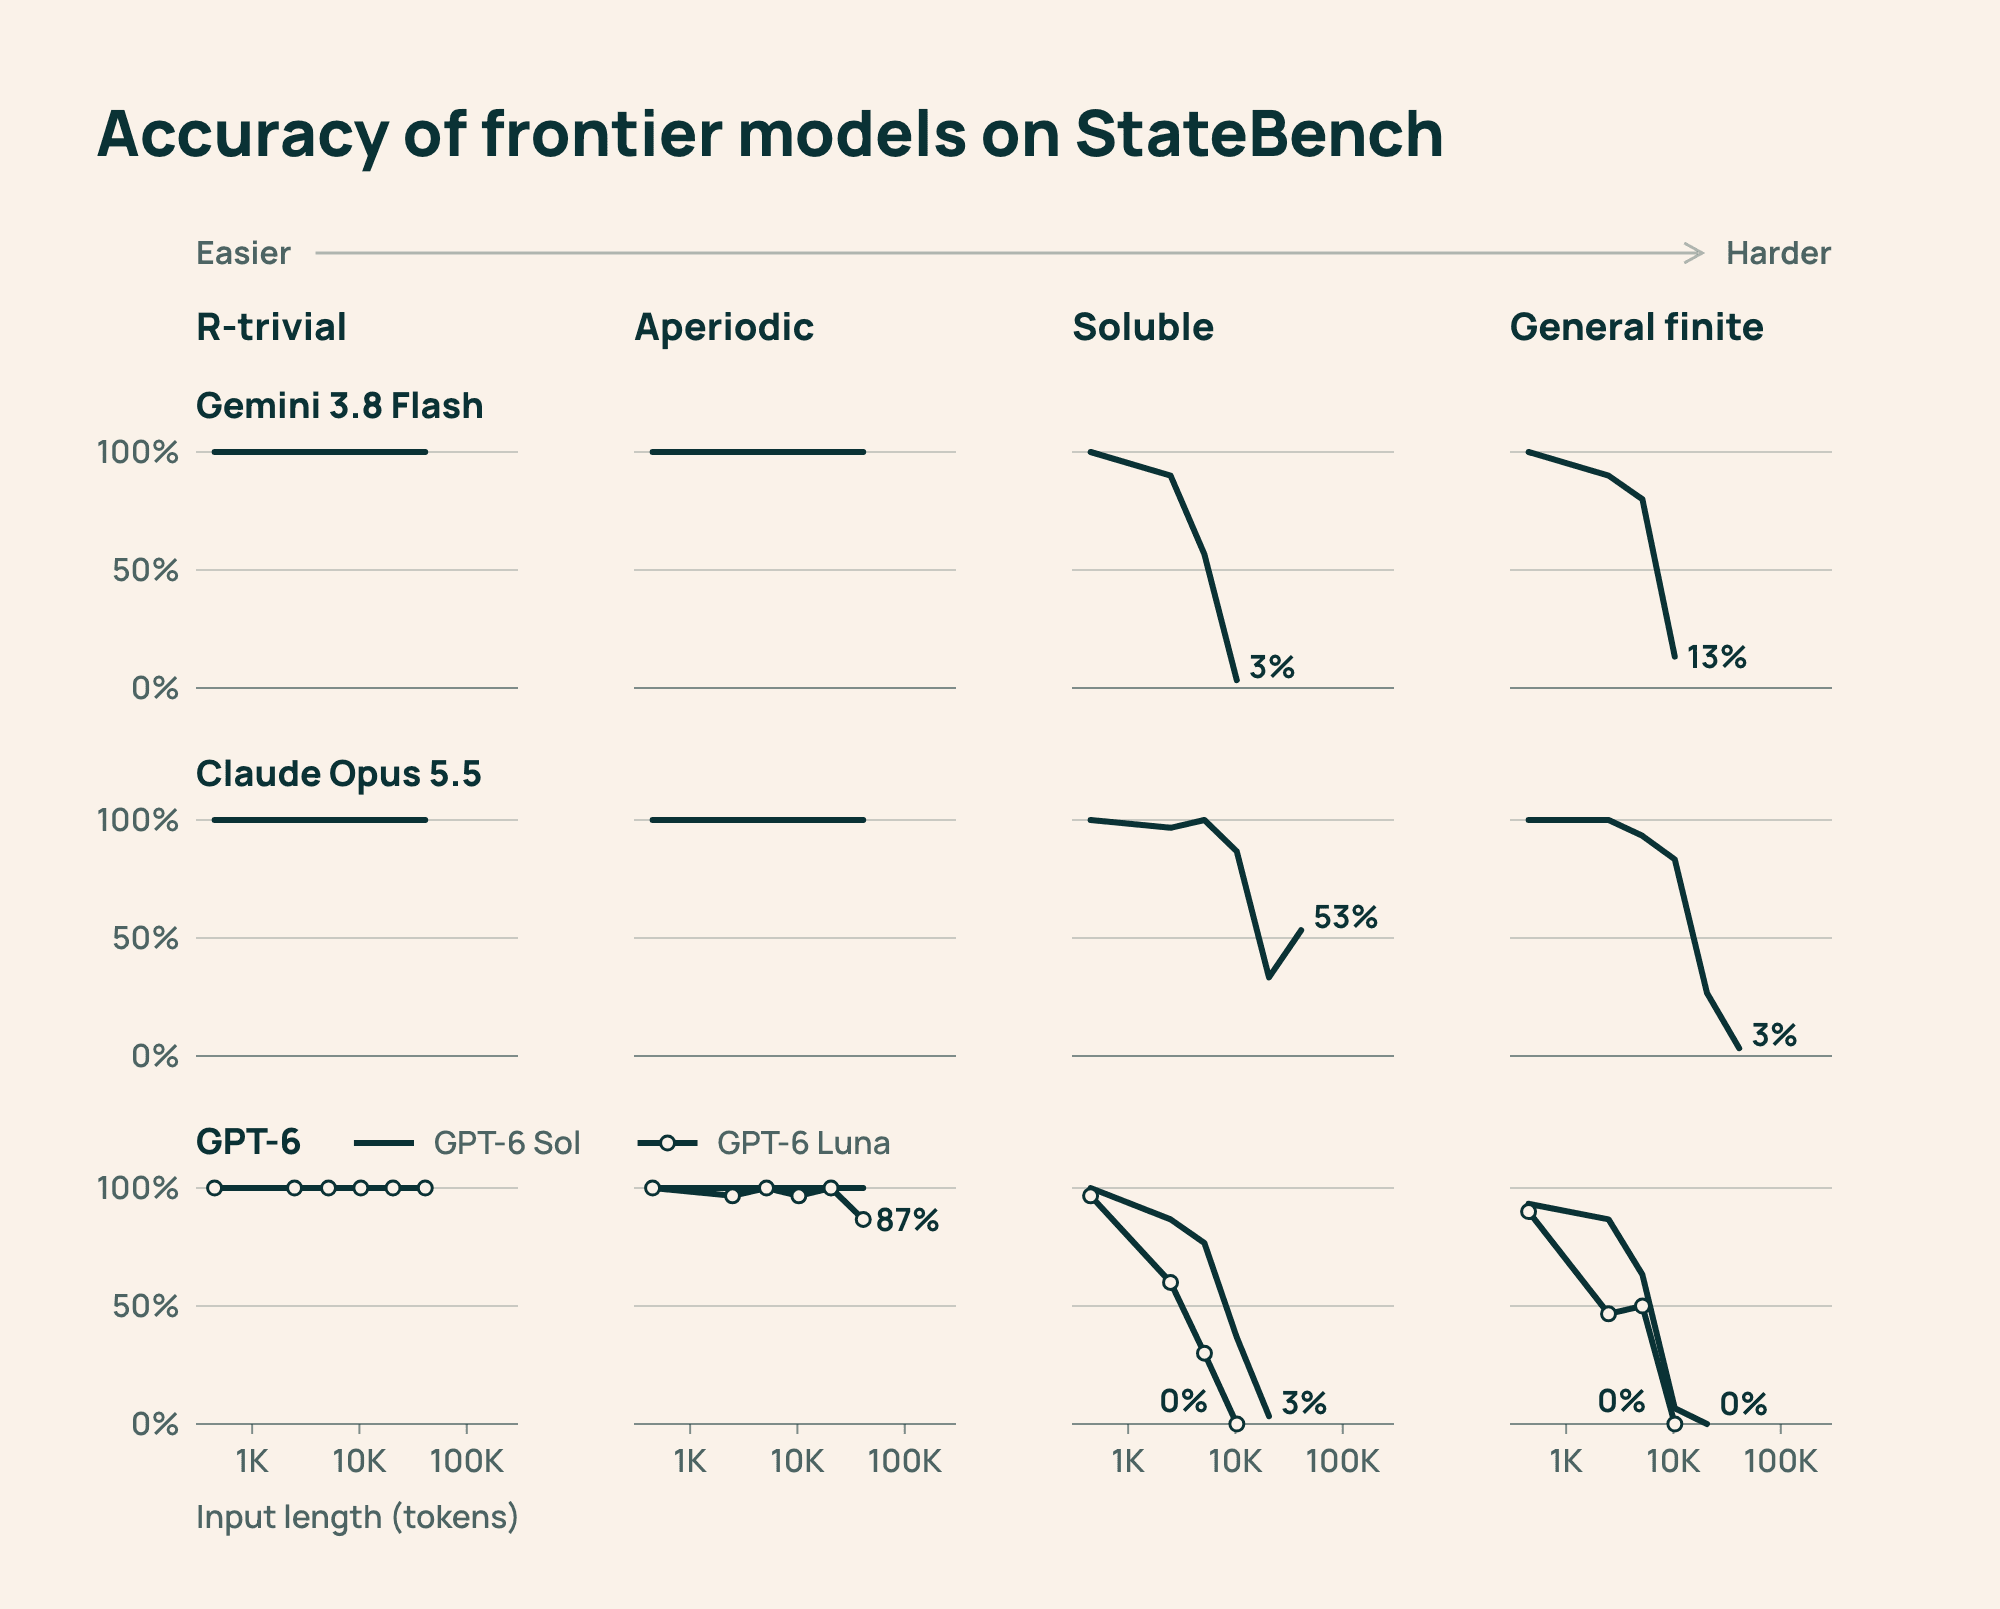
ผลการทดสอบ Gemini 3.8 Flash, Claude Opus 5.5, GPT-6 Sol และ Luna พบว่าทุกรุ่นทำได้ดีในระดับ r-trivial และ aperiodic แต่ในระดับ soluble และ general finite ความแม่นยำลดลงเหลือเพียง 13% หรือต่ำกว่าเมื่ออินพุตยาวขึ้น เนื่องจากความไว (sensitivity) ของปัญหาที่หากพลาดเพียงจุดเดียวก็ส่งผลเสียต่อคำตอบทั้งหมด
โมเดลที่ได้รับการฝึกโดยตรงในงานนี้
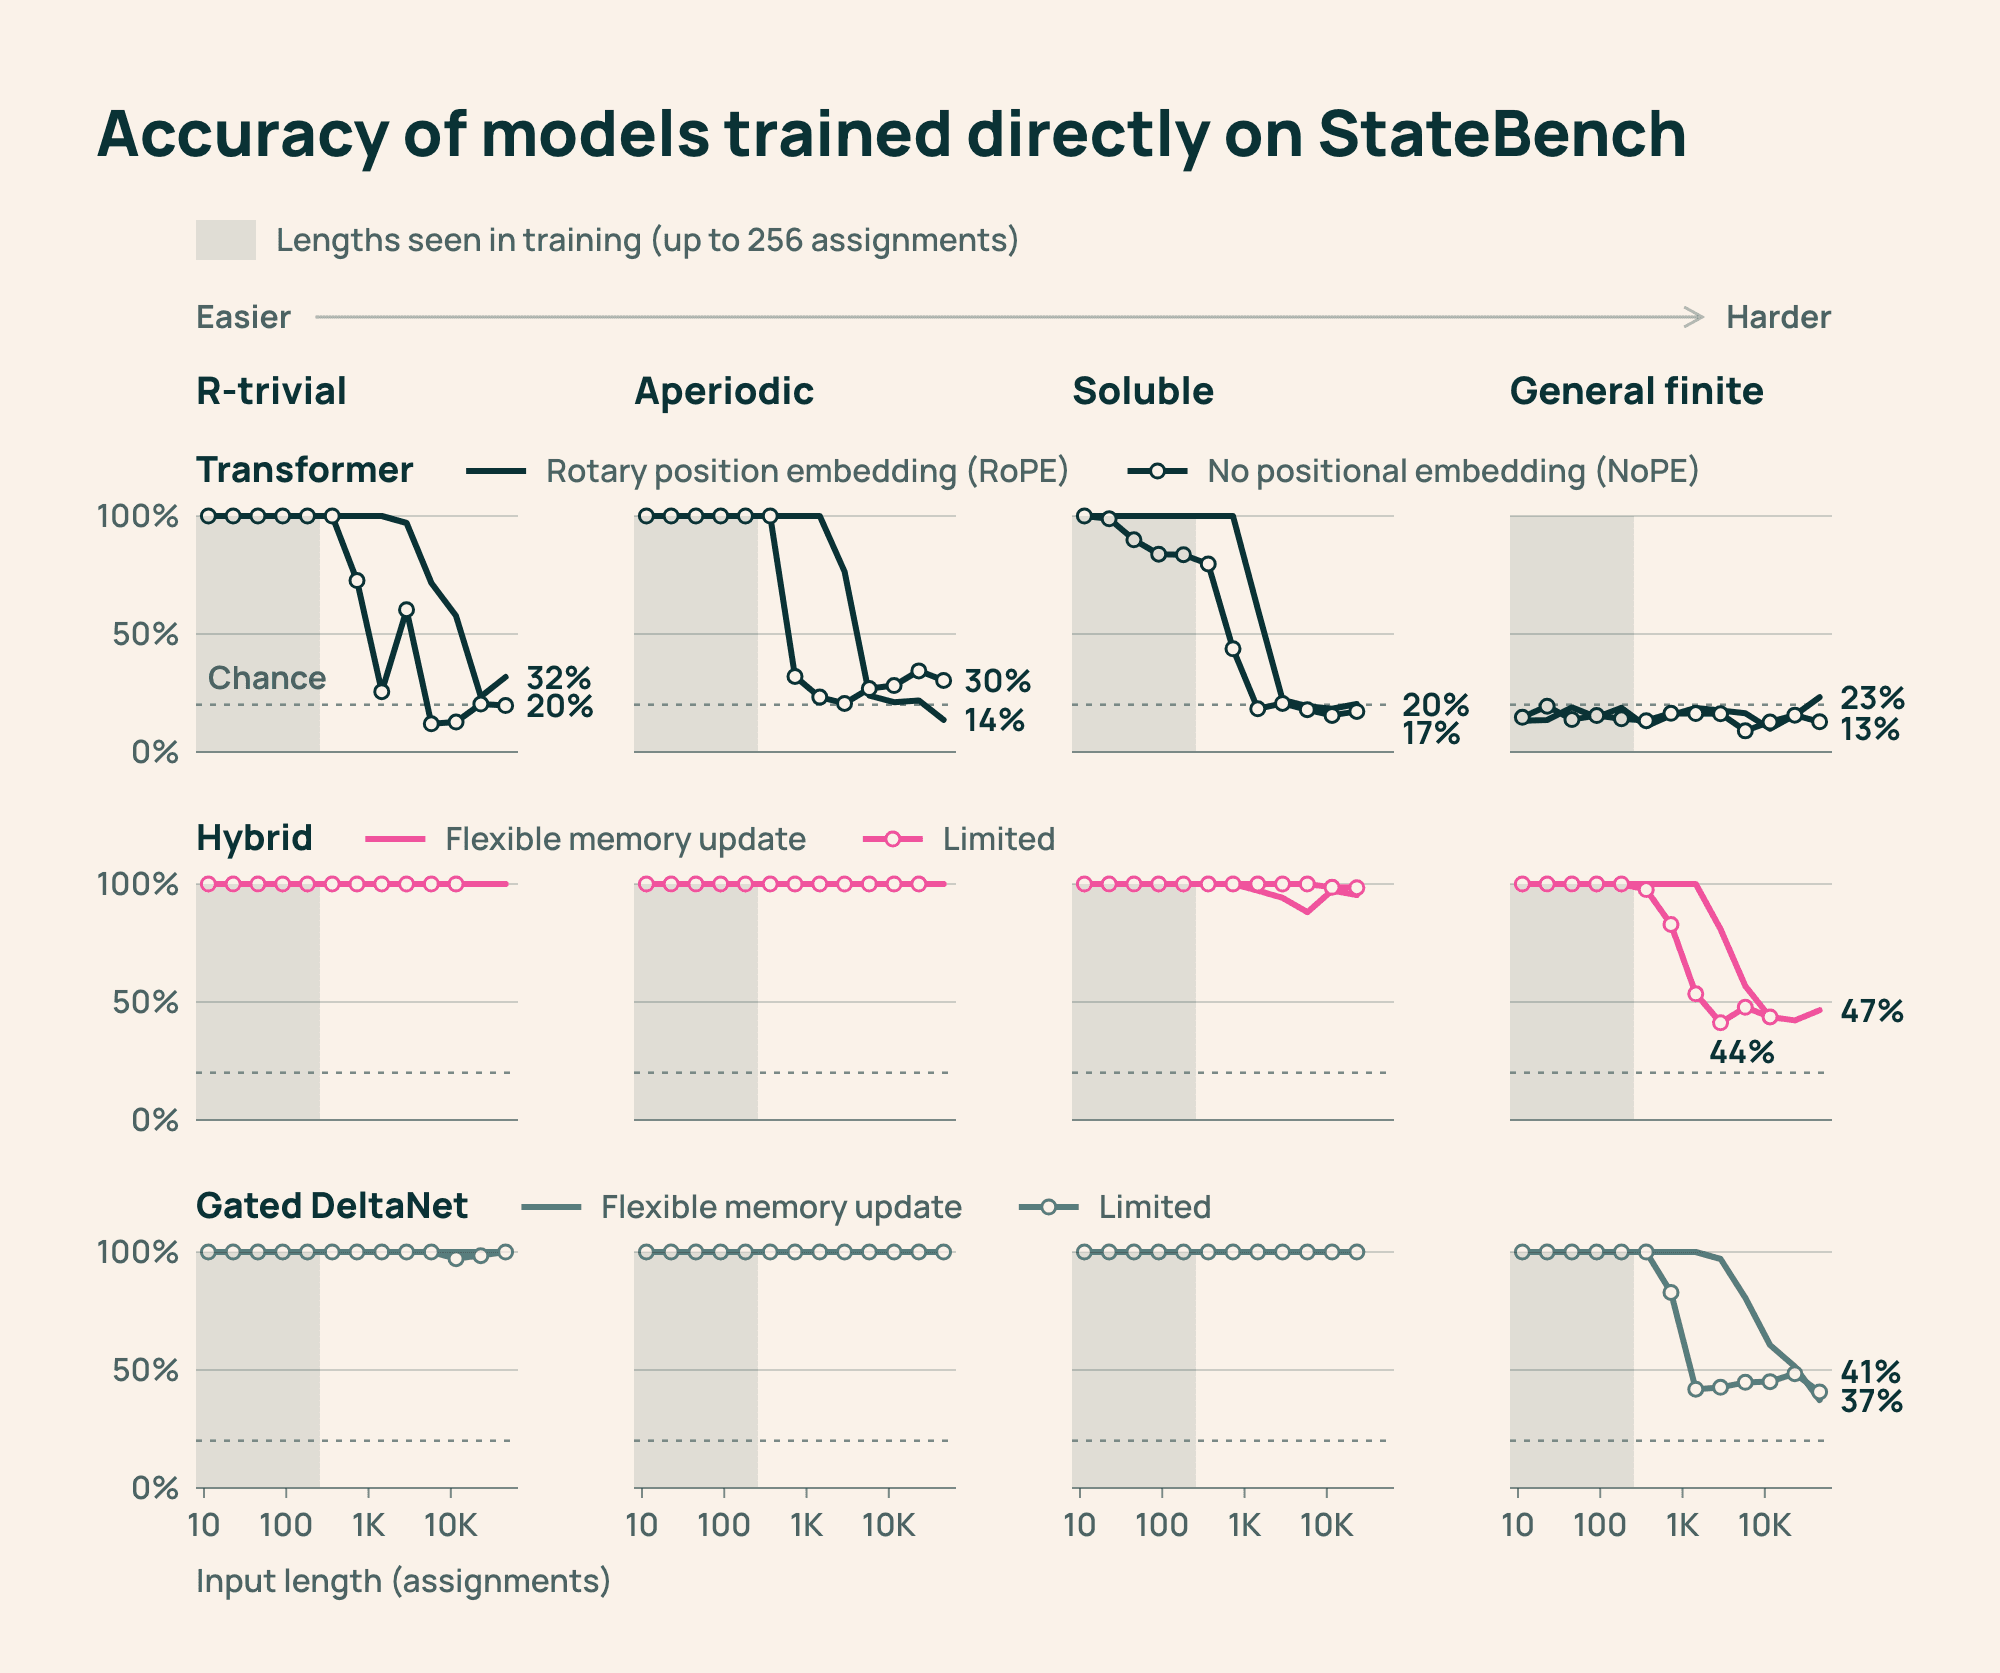
เราตรวจสอบต่อว่าความล้มเหลวเกิดจากสถาปัตยกรรมหรือข้อมูลที่ใช้ฝึก โดยลองฝึกโมเดลขนาด 275 ล้านพารามิเตอร์จากต้นจนจบในงาน StateBench โดยตรง ฝึกด้วยลำดับการกำหนดค่า 256 ครั้ง แต่ทดสอบยาวถึง 64,000 ครั้ง
ผลลัพธ์แสดงให้เห็นชัดเจนว่าโมเดล Gated DeltaNet และไฮบริดทำ generalization ได้เกือบสมบูรณ์แบบใน 3 ระดับแรก และทำได้ดีกว่า Transformers มากในระดับที่ยากที่สุด ขณะที่ Transformers ไม่เคยเรียนรู้ปัญหาแบบ general finite ได้เลย แม้จะผ่านการฝึกโดยตรงก็ตาม
คำถามที่ยังค้างคาและการเปิดตัว
แม้ผลลัพธ์จะชัดเจน แต่ยังมีประเด็นที่น่าสนใจ เช่น ขีดจำกัดที่แน่นอนของ Gated DeltaNet ภายใต้ความแม่นยำทางคณิตศาสตร์ที่ต่างกัน และการรับมือกับเอนทิตีใหม่ๆ ที่ปรากฏขึ้นระหว่างทาง (Dynamic entities) ซึ่ง StateBench ปัจจุบันยังเน้นที่ตัวแปรคงที่
เราหวังว่า StateBench จะเป็นเครื่องชี้นำ (North Star) ให้นักวิจัยเข้าใจจุดอ่อนของโมเดลแต่ละประเภท และช่วยในการพัฒนาสถาปัตยกรรมใหม่ๆ ที่มีความสามารถในการติดตามสถานะได้แข็งแกร่งกว่าระบบในปัจจุบัน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร