
เทคนิค Token Pooling-Aware เพิ่มประสิทธิภาพ Multi-Vector Embedding
โมเดล Multi-vector embedding ช่วยให้แต่ละ token ของคำค้นหามีโอกาสค้นหาคู่ที่ตรงกันในเอกสารได้ด้วยตัวเอง สิ่งนี้ทำให้โมเดลมีความสามารถในการถ่ายทอดความหมายสำหรับการค้นหาได้อย่างยอดเยี่ยม แต่เวกเตอร์ของเอกสารเหล่านั้นก็เพิ่มจำนวนขึ้นอย่างรวดเร็ว คลังข้อมูลที่มีเอกสารหลายล้านฉบับอาจประกอบด้วยเวกเตอร์หลายร้อยล้านตัว!
Token pooling ช่วยทำให้การแสดงแทน (representation) เหล่านี้มีขนาดเล็กลงโดยการรวมเวกเตอร์ token ที่คล้ายกันเข้าด้วยกัน อย่างไรก็ตาม ยิ่งบีบอัดข้อมูลให้เล็กลงเท่าไหร่ โอกาสที่จะสูญเสียข้อมูลที่มีประโยชน์ก็ยิ่งง่ายขึ้นเท่านั้น การฝึกฝนแบบ Pooling-aware training จะสอนให้ตัว encoder รักษาข้อมูลที่สำคัญเอาไว้เมื่อเวกเตอร์ถูกรวมเข้าด้วยกัน ช่วยให้คุณสามารถดึงข้อมูล (retrieve) ได้ดีขึ้นภายใต้ขีดจำกัดพื้นที่จัดเก็บที่เท่าเดิม
ในโพสต์นี้ ฉันจะอธิบายว่า pooling ทำงานอย่างไร ฝึกโมเดลสำหรับการดึงข้อมูลแบบบีบอัดด้วย Sentence Transformers และสำรวจผลลัพธ์ของคุณภาพเทียบกับการแลกเปลี่ยนด้วยพื้นที่จัดเก็บ ด้วยการตั้งค่า pool_factor=4 โมเดลที่ฝึกแบบปกติของฉันยังคงรักษาค่า NanoBEIR nDCG@10 ได้ 94.6% ของรุ่นที่ไม่ได้ทำ pooling โดยลดจำนวนเวกเตอร์เอกสารลงถึง 4 เท่า ส่วนการฝึกแบบ Token pooling-aware ช่วยเพิ่มการรักษาระดับประสิทธิภาพนั้นขึ้นเป็น 97.8% ภายใต้พื้นที่จัดเก็บที่เท่ากัน! มาดูกันว่าทำได้อย่างไร
โพสต์นี้สร้างขึ้นจากเนื้อหาการฝึกแบบ pooling-aware ที่ศึกษาใน Learn to Pool ของ Stefan Josef และ การศึกษา pooling regularization ของ LightOn ซึ่งสำรวจเรื่องการฝึกแบบเฉพาะเจาะจงและงบประมาณพื้นที่แบบยืดหยุ่นด้วย ในที่นี้ ฉันจะมุ่งเน้นไปที่การทำความเข้าใจวิธีการและนำไปใช้งานจริงด้วยตัวอย่าง Sentence Transformers ที่สั้นและทำซ้ำได้
สารบัญ
- ทำไม Multi-Vector Retrieval ถึงต้องใช้เวกเตอร์จำนวนมาก
- Token Pooling
- Token Pooling-Aware Training
- การใช้งานโมเดลที่ผ่านการฝึกแล้ว
- ผลการประเมิน
- การผสมผสานเทคนิคการบีบอัดข้อมูล
- อ้างอิง
- โค้ดและโมเดล
ทำไม Multi-Vector Retrieval ถึงต้องใช้เวกเตอร์จำนวนมาก
โมเดล embedding แบบเวกเตอร์เดี่ยว (single-vector) จะบีบอัดเอกสารทั้งฉบับลงในเวกเตอร์เดียว แต่ โมเดล Multi-vector เช่น ColBERT จะเก็บชุดของเวกเตอร์ token ตามบริบทแทน ซึ่งช่วยให้ส่วนต่างๆ ของคำค้นหาจับคู่กับส่วนต่างๆ ของเอกสารที่แตกต่างกันได้
ตัวอย่างเช่น คำค้นหาเกี่ยวกับแล็ปท็อปที่มีอายุการใช้งานแบตเตอรี่ยาวนาน สามารถพบหลักฐานเกี่ยวกับแล็ปท็อปในส่วนหนึ่งของเอกสารและความทนทานของแบตเตอรี่ในอีกส่วนหนึ่งได้ ด้วยการให้คะแนนแบบ MaxSim เวกเตอร์คำค้นหาแต่ละตัวจะเลือกเวกเตอร์เอกสารที่ตรงกันที่สุด และนำคะแนนเหล่านั้นมารวมกัน:
MaxSim(Q,D)=∑q∈Qmaxd∈Dq⊤d \operatorname{MaxSim}(Q, D) = \sum_{q \in Q} \max_{d \in D} q^\top d MaxSim(Q,D)=q∈Q∑d∈Dmaxq⊤d
แม้จะมีการใช้ residual quantization แบบ 2-bit หรือ 4-bit ที่รองรับโดย Fast-PLAID แต่การเก็บเวกเตอร์หลายร้อยตัวต่อหนึ่งเอกสารก็ยังเพิ่มขึ้นเรื่อยๆ ที่ 4 บิตต่อค่าพิกัด residual, เวกเตอร์ 200 ตัวที่มี 128 มิติ ต้องการพื้นที่ 12.8 KB ของ quantized residuals ต่อเอกสาร หรือ 12.8 GB สำหรับเอกสารหนึ่งล้านฉบับ การทำ pooling แต่ละเอกสารให้เหลือ 50 เวกเตอร์จะลดพื้นที่ลงเหลือ 3.2 GB ที่มิติและความแม่นยำเท่าเดิม
ข้อสังเกตที่เป็นประโยชน์คือ เวกเตอร์เอกสารจำนวนมากอาจมีความคล้ายคลึงกัน token หลายตัวอาจบรรยายแนวคิดที่เกี่ยวข้องกันอย่างใกล้ชิด ซึ่งสร้างโอกาสในการแสดงแทนพวกมันรวมกัน
Token Pooling
HierarchicalTokenPooling จัดกลุ่ม embedding ของ token ที่คล้ายกันโดยใช้ Ward hierarchical clustering เริ่มต้นจากหนึ่งกลุ่มต่อหนึ่งเวกเตอร์ token จากนั้นจะทำการรวมสองกลุ่มที่ทำให้เกิดการเพิ่มขึ้นของการกระจายตัวของเวกเตอร์ภายในกลุ่มน้อยที่สุดซ้ำๆ
การกระจายตัวนี้วัดโดยผลรวมของระยะทางกำลังสองจากแต่ละเวกเตอร์ไปยังค่าเฉลี่ยของกลุ่ม ดังนั้นวิธีของ Ward จึงชอบกลุ่มที่เกาะกลุ่มกันแน่นของเวกเตอร์ที่คล้ายคลึงกัน การรวมกลุ่มเหล่านี้จะสร้างลำดับชั้นของกลุ่มที่ใหญ่ขึ้นเรื่อยๆ ช่วยให้เราเลือกระดับการบีบอัดที่เหมาะสมกับงบประมาณของเรา จากนั้นเราจะแสดงแทนแต่ละกลุ่มด้วยค่าเฉลี่ยและทำการ normalize เวกเตอร์ที่ได้อีกครั้ง พร้อมสำหรับการให้คะแนนแบบ MaxSim
คุณสามารถทำให้การบีบอัดเป็นสัดส่วนกับความยาวของเอกสารได้:
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

pooling = HierarchicalTokenPooling(pool_factor=4)
ด้วย pool_factor=4 เอกสารจะรักษาเวกเตอร์ไว้ประมาณหนึ่งในสี่ของจำนวนเดิม ดังนั้นเอกสารที่ยาวกว่าจึงสามารถเก็บความจุไว้ได้มากกว่าตามสัดส่วน โดยค่าเริ่มต้น token แรกจะถูกป้องกันไม่ให้ถูกรวม และการทำ pooling จะใช้กับเอกสาร embedding เท่านั้น โดยปล่อยให้คำค้นหา embedding ไม่เปลี่ยนแปลง
การเลือกงบประมาณการทำ Pooling
HierarchicalTokenPooling มีตัวเลือกการควบคุมสามแบบ:
| การตั้งค่า | สิ่งที่แสดงออก |
|---|---|
max_tokens=16 | จำนวนเวกเตอร์สูงสุด 16 ตัวต่อเอกสาร รวมถึง token ที่ถูกป้องกันไว้ |
pool_factor=4 | ประมาณหนึ่งในสี่ของเวกเตอร์เดิมของแต่ละเอกสาร |
distance_threshold=... | เกณฑ์ระยะทางรวมของ Ward ที่ใช้ร่วมกัน ทำให้จำนวนเวกเตอร์ผันแปรตามรูปทรงของ embedding |
ความแตกต่างนี้มีความสำคัญเมื่อความยาวของเอกสารแตกต่างกัน ด้วย pool_factor=4 เอกสารที่ยาวกว่าสามารถรักษาเวกเตอร์ไว้ได้ประมาณหนึ่งในสี่ ช่วยให้การแสดงแทนเติบโตไปพร้อมกับเนื้อหา สำหรับ distance_threshold จำนวนเวกเตอร์สามารถเพิ่มขึ้นได้เมื่อมี embedding ที่แตกต่างกันมากขึ้นซึ่งจำเป็นต้องถูกรักษาไว้
การปรับเทียบ Adaptive Pooling
Adaptive pooling ใช้เกณฑ์ระยะทางร่วมกันเพื่อรวม embedding ที่คล้ายกันอย่างรุนแรงขึ้น ในขณะที่ยังรักษาเวกเตอร์ไว้มากขึ้นสำหรับเอกสารที่มีเนื้อหาแตกต่างกัน สามารถใช้กับโมเดล multi-vector ใดก็ได้ รวมถึงโมเดลที่ฝึกโดยไม่มีวัตถุประสงค์แบบ pooling-aware
แทนที่จะเลือกเกณฑ์ด้วยตนเอง คุณสามารถปรับเทียบ (calibrate) สำหรับจำนวนเวกเตอร์เฉลี่ยที่ตั้งเป้าไว้ได้ เมื่อมีตัวอย่างที่เป็นตัวแทนจากคลังข้อมูลของคุณใน calibration_documents:
from sentence_transformers import MultiVectorEncoder
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

model = MultiVectorEncoder("lightonai/LateOn")
calibration_embeddings = model.encode_document(calibration_documents)
threshold = HierarchicalTokenPooling.calibrate_distance_threshold(calibration_embeddings, target_tokens=16)
pooling = HierarchicalTokenPooling(distance_threshold=threshold)

# ปรับใช้ pooling โดยตั้งเป้าหมายค่าเฉลี่ยที่ 16 เวกเตอร์ต่อเอกสาร
document_embeddings = model.encode_document(documents_to_index, token_pooling=pooling)
การปรับเทียบต้องการเพียงเอกสาร embedding และจะคืนค่าเกณฑ์ที่คุณสามารถนำไปใช้ซ้ำได้เมื่อทำการทำ index เป้าหมายคือค่าเฉลี่ย ดังนั้นแต่ละเอกสารอาจได้รับเวกเตอร์มากกว่าหรือน้อยกว่า 16 ตัว ค่าเฉลี่ยที่ได้จริงอาจเปลี่ยนไปตามคลังข้อมูลอื่น
Token Pooling-Aware Training
การทำ Pooling สามารถใช้ประโยชน์ได้กับโมเดล multi-vector ทั่วไปอยู่แล้ว แต่ความยากจะเกิดขึ้นเมื่อเอกสารมีความแตกต่างที่สำคัญต่อการดึงข้อมูล แต่การรวมเวกเตอร์กลับทำให้ความแตกต่างนั้นกู้คืนได้ยากขึ้น วัตถุประสงค์การฝึกเดิมไม่เคยบังคับให้โมเดลทำงานร่วมกับตัวแทนที่ถูกบีบอัดเหล่านี้ แต่คุณสามารถสอนให้มันทำเช่นนั้นได้
หากคุณเคยใช้ Matryoshka embeddings หลักการฝึกจะดูคุ้นเคย Matryoshka ใช้วัตถุประสงค์การดึงข้อมูลที่ความกว้างของ embedding หลายระดับ เพื่อสอนให้ส่วนต้น (prefix) ที่เล็กกว่ายังคงมีประโยชน์ ส่วนการฝึกแบบ Pooling-aware จะใช้วัตถุประสงค์กับตัวแทนที่มีจำนวนเวกเตอร์ token น้อยลง
สำหรับตัวอย่างของฉัน แต่ละชุดการฝึก (batch) จะส่งผลต่อ loss สองส่วน:
- การดึงข้อมูลโดยใช้เอกสาร embedding เดิม
- การดึงข้อมูลหลังจากบีบอัดเอกสารเหลือประมาณหนึ่งในสี่ของเวกเตอร์เดิม
ฉันหาค่าเฉลี่ยของพวกมัน:
L=12Lunpooled+12Lpooled \mathcal{L} = \tfrac{1}{2}\mathcal{L}_{\mathrm{unpooled}} + \tfrac{1}{2}\mathcal{L}_{\mathrm{pooled}} L=21Lunpooled+21Lpooled
พจน์แรกสอนให้โมเดลดึงข้อมูลด้วยตัวแทนเต็มรูปแบบ พจน์ที่สองสอนให้มันจัดเรียง embedding ของ token เพื่อให้การจับคู่ที่มีประโยชน์รอดพ้นจากการทำ pooling วัตถุประสงค์ทั้งสองจะอัปเดต encoder ตัวเดียวกัน ทำให้มันได้รับผลตอบรับเกี่ยวกับการดึงข้อมูลทั้งก่อนและหลังการบีบอัด
Ward clustering ทำการตัดสินใจแบบไม่ต่อเนื่อง (discrete) ว่า token ใดควรอยู่ด้วยกัน ในระหว่างการฝึก HierarchicalTokenPooling จะใช้ straight-through estimator เพื่อส่งผ่าน gradient จากเวกเตอร์ที่ทำ pooling แล้วกลับไปยัง token ที่เป็นสมาชิก โดยไม่ต้องทำการหาอนุพันธ์ของการกำหนดคลัสเตอร์ encoder จึงสามารถเรียนรู้จากข้อผิดพลาดในการดึงข้อมูลที่เกิดขึ้นกับตัวแทนที่ทำ pooling แล้วได้
A Loss Wrapper ใน Sentence Transformers
MultiVectorTokenPoolingLoss จะห่อหุ้ม loss การดึงข้อมูลแบบ multi-vector ที่มีอยู่และปรับใช้โดยใช้ poolers ที่คุณเลือก:
from sentence_transformers import MultiVectorEncoder
from sentence_transformers.multi_vector_encoder.losses import (
    CachedMultiVectorMultipleNegativesRankingLoss,
    MultiVectorTokenPoolingLoss,
)
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

model = MultiVectorEncoder("answerdotai/ModernBERT-base", similarity_fn_name="maxsim")
pooling = HierarchicalTokenPooling(pool_factor=4)

base_loss = CachedMultiVectorMultipleNegativesRankingLoss(model, mini_batch_size=64)
loss = MultiVectorTokenPoolingLoss(
    model,
    base_loss,
    token_poolings=[None, pooling],
    weights=[0.5, 0.5],
)
CachedMultiVectorMultipleNegativesRankingLoss จะทำหน้าที่กำหนดวัตถุประสงค์การดึงข้อมูล มันสอนให้แต่ละคำค้นหาให้คะแนนเอกสารที่เกี่ยวข้องสูงกว่าเอกสารเชิงลบ (negative) ในชุดข้อมูล โดยค่าเริ่มต้นจะใช้ model.similarity ตามการตั้งค่าความคล้ายคลึงของโมเดล และการตั้งค่า kernel โมเดลที่กำหนดค่าด้วย similarity_fn_name="meanmaxsim" ก็จะใช้ MeanMaxSim ในระหว่างการฝึกด้วย
Gradient caching ช่วยให้ encoder ประมวลผล mini-batches ขนาดเล็กในขณะที่ยังรักษาชุดของ in-batch negatives ขนาดใหญ่ไว้ได้ สคริปต์การฝึกของฉันใช้ mini-batches ขนาด 64 โดยมีขนาด training batch อยู่ที่ 256
MultiVectorTokenPoolingLoss เพิ่มวัตถุประสงค์การบีบอัดเข้าไป ในที่นี้ None หมายถึงตัวแปรหนึ่งใช้ embedding เดิม ในขณะที่ pooling ใช้ตัวแปรแบบ factor-4 น้ำหนักทั้งสองจะเฉลี่ยค่า loss ของพวกมัน ตัวแปร pooling จะใช้ embedding ของ token ที่คำนวณไว้แล้วซ้ำ ดังนั้นการเพิ่ม pooler แต่ละตัวจะเพิ่มเพียงงานด้าน clustering และ scoring โดยไม่จำเป็นต้องส่งผ่าน encoder แยกต่างหากสำหรับตัวแปรนั้น
ตัว poolers ยังสามารถเป็น BaseTokenPooling ที่ปรับแต่งเองซึ่งรักษา gradient ผ่าน input embeddings ได้ด้วย คุณสามารถปรับวัตถุประสงค์การฝึกให้เข้ากับตัวแทนที่คุณต้องการนำไปใช้งานจริง เปลี่ยน pooler แบบ factor-4 เป็นการกำหนดค่าการใช้งานที่คุณเลือก หรือรวม pooler หลายตัวและเลือกน้ำหนักสำหรับ loss ของพวกมัน
สคริปต์การฝึก ที่สมบูรณ์จะรวมถึงชุดข้อมูล, trainer, validation loss และการประเมินการดึงข้อมูลขนาดเล็กระหว่างการฝึก จากการ checkout repository ให้รันทั้งสองตัวแปรในเครื่องด้วย uv:
uv run examples/multi_vector_encoder/training/token_pooling/training_cached_contrastive.py --baseline
uv run examples/multi_vector_encoder/training/token_pooling/training_cached_contrastive.py
สคริปต์จะประกาศการพึ่งพาการฝึกและ kernel ดังนั้น uv จะติดตั้งให้คุณเอง kernel ที่เข้ากันได้จะถูกเปิดใช้งานโดยอัตโนมัติ คุณยังสามารถฝึกบน cloud GPU ด้วย Hugging Face Jobs ติดตั้ง CLI และเข้าสู่ระบบด้วย token ที่สามารถรัน Jobs และอัปโหลดโมเดลได้:
pip install -U huggingface_hub
hf auth login

hf jobs uv run \
    --flavor a10g-small \
    --timeout 4h \
    --secrets HF_TOKEN \
    -- https://raw.githubusercontent.com/huggingface/sentence-transformers/main/examples/multi_vector_encoder/training/token_pooling/training_cached_contrastive.py
คำสั่งนี้จะรันตัวแปร pooling-aware บน GPU A10G โดยจำกัดเวลาสี่ชั่วโมง การส่งผ่าน HF_TOKEN เป็นความลับช่วยให้สคริปต์อัปโหลดโมเดลที่ฝึกแล้วไปยังบัญชี Hub ของคุณเมื่อการฝึกเสร็จสิ้น หากต้องการรันแบบ baseline ที่ใช้ loss ปกติด้วย ให้รันคำสั่งเดิมซ้ำโดยเติม --baseline หลัง URL ของสคริปต์
การเร่งความเร็วด้วย Kernel (ทางเลือกเพิ่มเติม)
คุณสามารถเร่งความเร็วการให้คะแนน MaxSim, Ward clustering และการดำเนินการ backbone ที่รองรับได้ด้วย kernels ติดตั้งการพึ่งพาสำหรับการฝึกและ kernel:
pip install -U "sentence-transformers[train,kernels]"ในตัวอย่างการฝึกข้างต้น ให้แทนที่การเริ่มต้นโมเดลและ pooler ก่อนที่จะสร้าง loss:
model = MultiVectorEncoder(
    "answerdotai/ModernBERT-base",
    device="cuda",
    similarity_fn_name="maxsim",
    use_kernels=True,
)
pooling = HierarchicalTokenPooling(pool_factor=4)
Hierarchical poolers จะรับการตั้งค่า kernel ของโมเดลมาตามค่าเริ่มต้น ดังนั้นคุณเพียงแค่ต้องเปิดใช้งาน kernel บนตัวโมเดลเท่านั้น Sentence Transformers จะเลือก kernel ที่เข้ากันได้กับระบบของคุณและใช้การใช้งานที่มีอยู่หากไม่มีตัวทดแทนที่พร้อมใช้งาน
ตัวอย่างเช่น MaxSim kernel พื้นฐาน จะให้คะแนนคำค้นหากับเอกสารโดยไม่ต้องสร้าง matrix ความคล้ายคลึงของ token ทั้งหมดในหน่วยความจำ แต่ต้องการ CUDA และ Triton ส่วน Ward clustering kernel จะช่วยเร่งความเร็วการทำ hierarchical clustering ได้อย่างมากโดยการรันบน CUDA แทน CPU ซึ่งเร็วกว่า SciPy ประมาณ 30-150 เท่า
การใช้งานโมเดลที่ผ่านการฝึกแล้ว
ลองโหลดโมเดลแบบ pooling-aware และดึงข้อมูลด้วยเอกสาร embedding ที่ถูกบีบอัด การตั้งค่า kernel จะไม่ถูกบันทึกไปกับโมเดล ดังนั้นให้เพิ่ม use_kernels=True เมื่อโหลดหากคุณต้องการใช้สำหรับการทำ inference ด้วย:
from sentence_transformers import MultiVectorEncoder
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

model = MultiVectorEncoder("tomaarsen/mve-ModernBERT-base-token-pooling")
pooling = HierarchicalTokenPooling(pool_factor=4)

queries = ["Which planet is known as the Red Planet?"]
documents = [
    "Venus is often called Earth's twin because of its similar size and proximity.",
    "Mars, known for its reddish appearance, is often referred to as the Red Planet.",
    "Jupiter, the largest planet in our solar system, has a prominent red spot.",
]

query_embeddings = model.encode_query(queries)
document_embeddings = model.encode_document(documents, token_pooling=pooling)

print([len(embedding) for embedding in document_embeddings])
# [5, 6, 5]
print(model.similarity(query_embeddings, document_embeddings))
# tensor([[16.0037, 25.9879, 22.8159]], device='cuda:0')

# สำหรับการเปรียบเทียบ โมเดลเดียวกันที่ไม่มีการทำ token pooling:
# [18, 21, 19]
# tensor([[16.6115, 27.6060, 24.1766]], device='cuda:0')
ตัว pooler จะบีบอัดเอกสาร embedding หลังจากกระบวนการ forward ของ encoder โดยลดจำนวนรวมจาก 58 เวกเตอร์เหลือ 16 เวกเตอร์ ในขณะที่ปล่อยให้คำค้นหา embedding ไม่เปลี่ยนแปลง ดาวอังคาร (Mars) ยังคงได้รับคะแนนความคล้ายคลึงสูงสุด ตามด้วยดาวพฤหัสบดี (Jupiter) และดาวศุกร์ (Venus) ดังนั้นลำดับการจัดอันดับจึงยังคงเดิมแม้ว่าจะจัดเก็บเวกเตอร์เอกสารน้อยลงมากก็ตาม
คุณสามารถเปลี่ยน pool_factor ในขั้นตอน inference เพื่อสำรวจงบประมาณพื้นที่จัดเก็บที่แตกต่างกันด้วยโมเดลที่ฝึกมาแล้วตัวเดียวกัน สำหรับการใช้งานซ้ำ คุณสามารถส่งผ่าน token_pooling=pooling เมื่อเริ่มต้น MultiVectorEncoder เพื่อให้เป็นค่าเริ่มต้นตอนรันไทม์
ผลการประเมิน เพื่อทำการตรวจสอบ ฉันได้ฝึกโมเดลสองตัวจาก answerdotai/ModernBERT-base โดยแต่ละตัวมีการทำ token projection 128 มิติใหม่:
- tomaarsen/mve-ModernBERT-base-token-pooling-baseline โดยใช้เฉพาะ cached contrastive loss
- tomaarsen/mve-ModernBERT-base-token-pooling โดยใช้ cached contrastive loss ที่ห่อหุ้มด้วยวัตถุประสงค์แบบ unpooled และ factor-4 ข้างต้น
ทั้งสองการรันใช้หนึ่ง epoch บน MS MARCO triplets ชุดเดียวกัน 120,000 รายการ โดยใช้การตั้งค่าเริ่มต้นที่เหมือนกัน ขีดจำกัดสูงสุดของ token ในการฝึกคือ 300 และคำค้นหาสั้นๆ จะถูกขยายเป็นอย่างน้อย 32 ตำแหน่ง token เพื่อให้มีเวกเตอร์คำค้นหาตามบริบทเพิ่มเติม
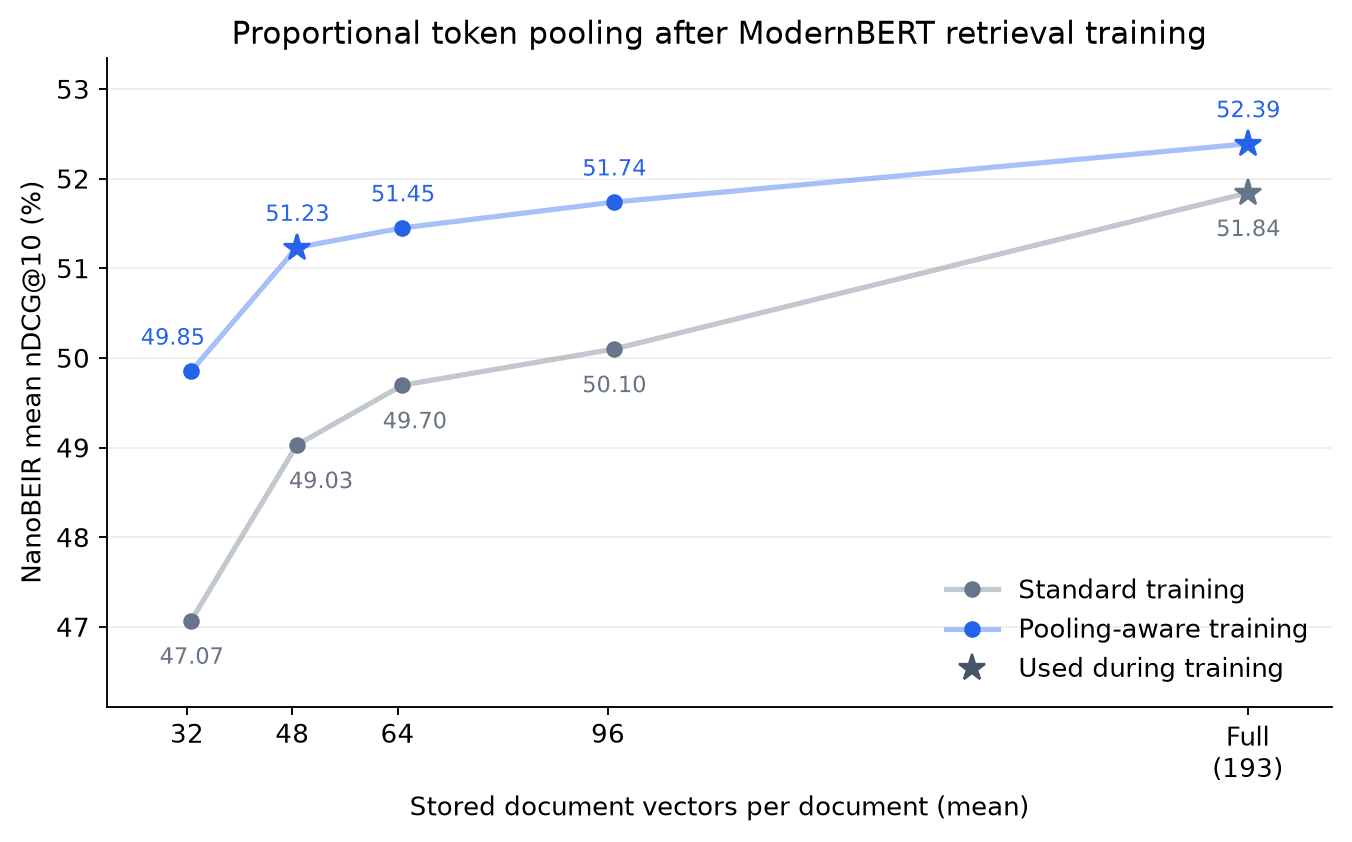
ฉันประเมินโมเดลทั้งสองบน NanoBEIR@13 โดยรายงานค่าเฉลี่ย nDCG@10 (%) รูปภาพเปรียบเทียบการฝึกแบบปกติและแบบ pooling-aware ด้วย pool factors ขนาด 2, 3, 4 และ 6 ควบคู่ไปกับการดึงข้อมูลแบบ unpooled ตารางยังรวมถึงขีดจำกัดแบบคงที่ (fixed caps) และเกณฑ์แบบยืดหยุ่น (adaptive thresholds) ด้วย
| Pooling ในขั้นตอน inference | เวกเตอร์เฉลี่ย | โมเดลปกติ | โมเดลแบบ Pooling-aware | ส่วนต่าง (คะแนน) |
|---|---|---|---|---|
| Unpooled | 193.22 | 51.84 | 52.39 | +0.55 |
pool_factor=2 | 96.86 | 50.10 | 51.74 | +1.64 |
pool_factor=3 | 64.74 | 49.70 | 51.45 | +1.76 |
pool_factor=4 | 48.68 | 49.03 | 51.23 | +2.20 |
pool_factor=5 | 39.04 | 48.13 | 50.28 | +2.15 |
pool_factor=6 | 32.62 | 47.07 | 49.85 | +2.78 |
max_tokens=64 | 54.76 | 49.27 | 50.89 | +1.63 |
max_tokens=32 | 29.58 | 48.25 | 50.12 | +1.87 |
max_tokens=16 | 15.60 | 46.61 | 49.26 | +2.65 |
max_tokens=8 | 7.99 | 43.12 | 46.61 | +3.48 |
max_tokens=4 | 4.00 | 37.22 | 43.00 | +5.78 |
distance_threshold (calibrated) | 54.76 | 50.10 | 51.24 | +1.14 |
distance_threshold (calibrated) | 29.58 | 48.38 | 50.96 | +2.58 |
distance_threshold (calibrated) | 15.60 | 47.23 | 49.63 | +2.41 |
สำหรับ adaptive pooling ฉันได้ปรับเทียบเกณฑ์แยกต่างหากสำหรับแต่ละ encoder และคลังข้อมูล NanoBEIR โดยใช้เอกสาร embedding แบบ unpooled เพื่อให้ตรงกับจำนวนเวกเตอร์เฉลี่ยภายใต้ขีดจำกัด 64, 32 และ 16
ที่ค่า pool_factor=4 ซึ่งถูกฝึกมา nDCG@10 ปรับปรุงจาก 49.03 เป็น 51.23 ในขณะที่จัดเก็บเวกเตอร์เอกสารน้อยลง 74.8% เมื่อเทียบกับการดึงข้อมูลแบบ unpooled สิ่งนี้ช่วยเพิ่มอัตราการรักษาคะแนน (score retention) จาก 94.6% เป็น 97.8% การดึงข้อมูลแบบ unpooled ก็ปรับปรุงขึ้นด้วยจาก 51.84 เป็น 52.39
ผลลัพธ์ที่เพิ่มขึ้นยังครอบคลุมถึงขีดจำกัดแบบคงที่และ adaptive pooling ที่ค่าเฉลี่ย 29.58 เวกเตอร์ต่อเอกสาร adaptive pooling รักษาคะแนนได้ 97.3% ของคะแนนแบบ unpooled ของโมเดล pooling-aware ในขณะที่จัดเก็บเวกเตอร์เอกสารน้อยลง 84.7% ส่วนโมเดลที่ฝึกแบบปกติรักษาคะแนนได้ 93.3% ภายใต้งบประมาณที่เท่ากัน
การผสมผสานเทคนิคการบีบอัดข้อมูล
หากขนาดของ index เป็นความกังวลหลักของคุณ ฉันขอแนะนำให้ใช้ตัวเลือกเหล่านี้ตามลำดับ:
- การทำ Embedding quantization ให้เหลือ 4, 2 หรือ 1 บิต เช่น ผ่าน Fast-PLAID เพื่อลดพื้นที่จัดเก็บต่อพิกัด
- การทำ Token pooling เพื่อลดจำนวนเวกเตอร์เอกสาร และอาจเลือกทำ pooling-aware fine-tuning ตามที่แสดงในบล็อกนี้
- Matryoshka token embeddings เพื่อลดมิติของแต่ละเวกเตอร์ token
หากมิติเริ่มต้นของโมเดลใหญ่กว่า 128 ควรพิจารณาการทำ Matryoshka truncation และ fine-tuning ด้วย วิธีการเหล่านี้สามารถนำมาผสมผสานกันได้ ดังนั้นควรประเมินขนาด index และคุณภาพการดึงข้อมูลที่ได้กับ search engine และคลังข้อมูลของคุณ
MultiVectorMatryoshkaLoss ฝึก embedding ของ token ให้ยังคงมีประโยชน์หลังจากการตัดทอน คุณสามารถห่อหุ้มมันด้วย MultiVectorTokenPoolingLoss เพื่อฝึกสำหรับทั้งมิติที่เล็กลงและจำนวนเวกเตอร์เอกสารที่น้อยลง โดยใช้ embedding ของ encoder ซ้ำในทุกการตั้งค่าการบีบอัด
ลองใช้ ตัวอย่างการฝึกที่สมบูรณ์ และเปรียบเทียบกับการรันแบบ loss ปกติ สคริปต์การประเมิน ที่แนบมาจะวัดผลการดึงข้อมูลในหลายรูปแบบ เพื่อให้คุณพล็อตความสัมพันธ์ระหว่างคุณภาพและการจัดเก็บได้เอง
ด้วยการเพิ่มเพียงไม่กี่บรรทัดในวัตถุประสงค์การฝึก การแสดงแทนเอกสารที่มีขนาดเล็กลงก็จะกลายเป็นสิ่งที่โมเดลเรียนรู้ที่จะใช้งานอย่างจริงจัง สิ่งนี้ช่วยเปิดพื้นที่ที่น่าตื่นเต้นในการทำให้การดึงข้อมูลแบบ multi-vector สามารถนำไปใช้งานจริงได้มากขึ้น!
อ้างอิง
- Stefan Josef. Learn to Pool: Lightweight Fine-Tuning for Flexible Multi-Vector Compression
- Benjamin Clavié, Antoine Chaffin, และ Griffin Adams. Reducing the Footprint of Multi-Vector Retrieval with Minimal Performance Impact via Token Pooling
- Antoine Chaffin. After the party comes the free lunch: regularizing ColBERT models to enhance pooling capabilities and reduce index footprint
- Luyu Gao, Yunyi Zhang, Jiawei Han, และ Jamie Callan. Scaling Deep Contrastive Learning Batch Size under Memory Limited Setup
- Introduction to Matryoshka Embedding Models
โค้ดและโมเดล
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร