
การเรียนรู้แบบถ่ายโอน: กุญแจสำคัญสู่ความแม่นยำในการทำนายจีโนมสำหรับประชากรที่หลากหลาย
Polygenic risk scores (PRSs) คือเครื่องมือทำนายความเสี่ยงของโรคจากตัวแปรทางพันธุกรรม ซึ่งมักคำนวณจากตำแหน่งทางพันธุกรรมหลักร้อยถึงหลายล้านตำแหน่ง อย่างไรก็ตาม การนำไปใช้ในเชิงคลินิกยังมีข้อจำกัด เนื่องจากฐานข้อมูล genome-wide association studies (GWASs) ในอดีต ประเมินกลุ่มตัวอย่างชาวยุโรปเป็นส่วนใหญ่อย่างท่วมท้น ส่งผลให้ความแม่นยำลดลงอย่างเห็นได้ชัดเมื่อนำไปใช้กับประชากรที่ไม่ใช่ชาวยุโรป เนื่องจากความแตกต่างของโครงสร้างประชากรและ ความถี่ของแอลลีล (variant allele frequencies) เนื่องจากการทำ GWAS ในบุคคลจำนวนมากมีต้นทุนมหาศาลเกินกว่าที่ระบบสาธารณสุขส่วนใหญ่จะรับไหว การใช้แนวทาง "การเรียนรู้แบบถ่ายโอน" (Transfer learning) จากข้อมูลชาวตะวันตกที่มีอยู่เดิมมาเสริมด้วยข้อมูลเฉพาะของประชากรเป้าหมายจึงเป็นทางออกที่น่าสนใจ บล็อกโพสต์นี้จึงนำเสนอการศึกษาที่ประเมินประสิทธิภาพของ PRS ในประชากรที่ไม่ใช่ชาวยุโรป โดยเปรียบเทียบข้อมูลจาก UK Biobank (UKB) ของอังกฤษ กับ Biobank Japan (BBJ) ซึ่งครอบคลุมชาวญี่ปุ่นเกือบ 2 แสนคน เพื่อหาแนวทางเพิ่มความแม่นยำในการทำนายข้ามประชากรให้สูงสุด
ผลกระทบของขนาดประชากร GWAS ต่อประสิทธิภาพของ PRS ในบรรพบุรุษเป้าหมาย
การมีชุดข้อมูลขนาดใหญ่จากทั้ง UKB และ BBJ ช่วยให้ทีมวิจัยสามารถทดลองแบบตัดข้อมูลออก (dataset ablation) เพื่อประเมินผลกระทบของขนาดตัวอย่างต่อความแม่นยำได้อย่างเป็นระบบ โดยเน้นไปที่ลักษณะทางคลินิก 8 ประการ เช่น ดัชนีมวลกาย (BMI), ความดันโลหิต, ระดับไขมัน (HDL, LDL) และระดับน้ำตาลในเลือด ซึ่งในฝั่ง UKB นั้น สัดส่วนความแปรปรวนที่อธิบายได้ด้วยพันธุกรรม (heritability) อยู่ที่ช่วง 0.07–0.28
ทีมวิจัยใช้วิธีประเมินความสามารถในการถ่ายโอนของ PRS ทั้งหมด 3 รูปแบบ ดังนี้:
-
UKB - Discovery GWAS + elastic net: ศึกษาการถ่ายโอนตัวแปรโดยตรงจากประชากรยุโรปมายังญี่ปุ่น โดยระบุความเชื่อมโยงทางพันธุกรรมจาก UKB และนำมาฝึกโมเดลร่วมกับกลุ่มตัวอย่างจาก BBJ ในสัดส่วนที่ต่างกันรวมกว่า 100 โมเดลต่อลักษณะ
-
Meta-analysis + elastic net: ผสมผสานข้อมูล GWAS จากทั้งฝั่งอังกฤษและญี่ปุ่นเข้าด้วยกันผ่านการวิเคราะห์อภิมาน (meta-analysis) เพื่อสร้างชุดตัวแปรสุดท้ายก่อนนำไปฝึกโมเดล
-
PRS-CSx: ใช้โมเดล PRS-CSx ที่ออกแบบมาเพื่อจัดการความหลากหลายของ linkage disequilibrium ระหว่างประชากรโดยเฉพาะ เพื่อหาค่าการรวมกันเชิงเส้นที่เหมาะสมที่สุด
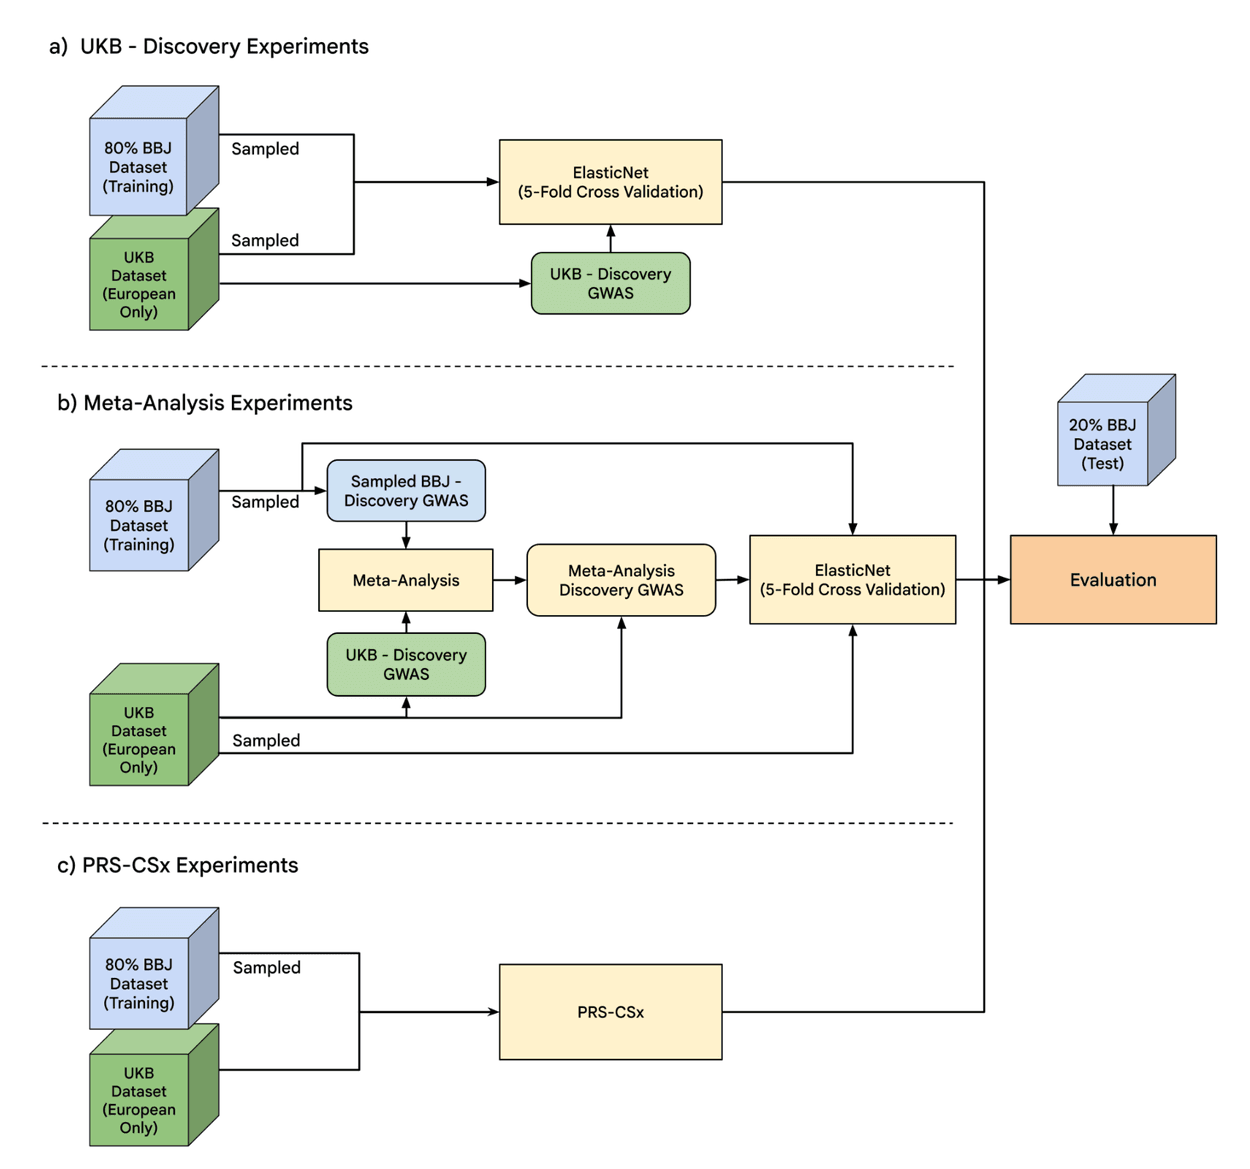
การออกแบบการทดลองสำหรับการทำนายจีโนมข้ามบรรพบุรุษ a) การทดลองหลักสำรวจผลกระทบของจำนวนตัวอย่างชาวยุโรปและญี่ปุ่นต่อประสิทธิภาพของ elastic net b) การวิเคราะห์อภิมานรวมผล GWAS เฉพาะประชากรเพื่อพัฒนาโมเดล c) การใช้โมเดล PRS-CSx ปรับตามขนาดตัวอย่างเฉพาะประชากร
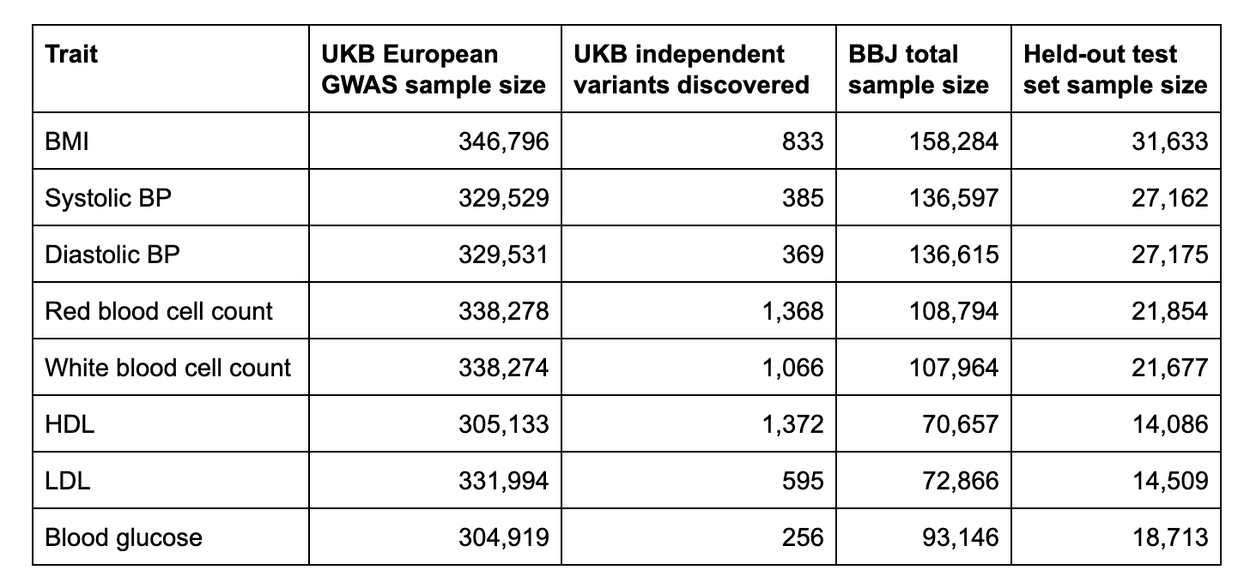
ขนาดตัวอย่างใน UKB และ BBJ สำหรับ 8 ลักษณะที่สำรวจในการศึกษานี้
ข้อมูลที่มากขึ้นไม่ได้ดีกว่าเสมอไปสำหรับการทำนาย PRS ข้ามประชากร
ผลจากการวัดประสิทธิภาพด้วย Pearson correlation พบความจริงที่น่าสนใจว่า ข้อมูลจากยุโรปจะมีประโยชน์มากเฉพาะในช่วงที่ข้อมูลประชากรเป้าหมายมีจำกัดเท่านั้น เมื่อกลุ่มตัวอย่างประชากรเป้าหมายมีจำนวนเกิน 15,000 คนขึ้นไป การฝึกโมเดลโดยใช้ข้อมูลเฉพาะของประชากรนั้นๆ เพียงอย่างเดียวจะเริ่มให้ผลแม่นยำกว่าการใช้ข้อมูลยุโรปมาผสม
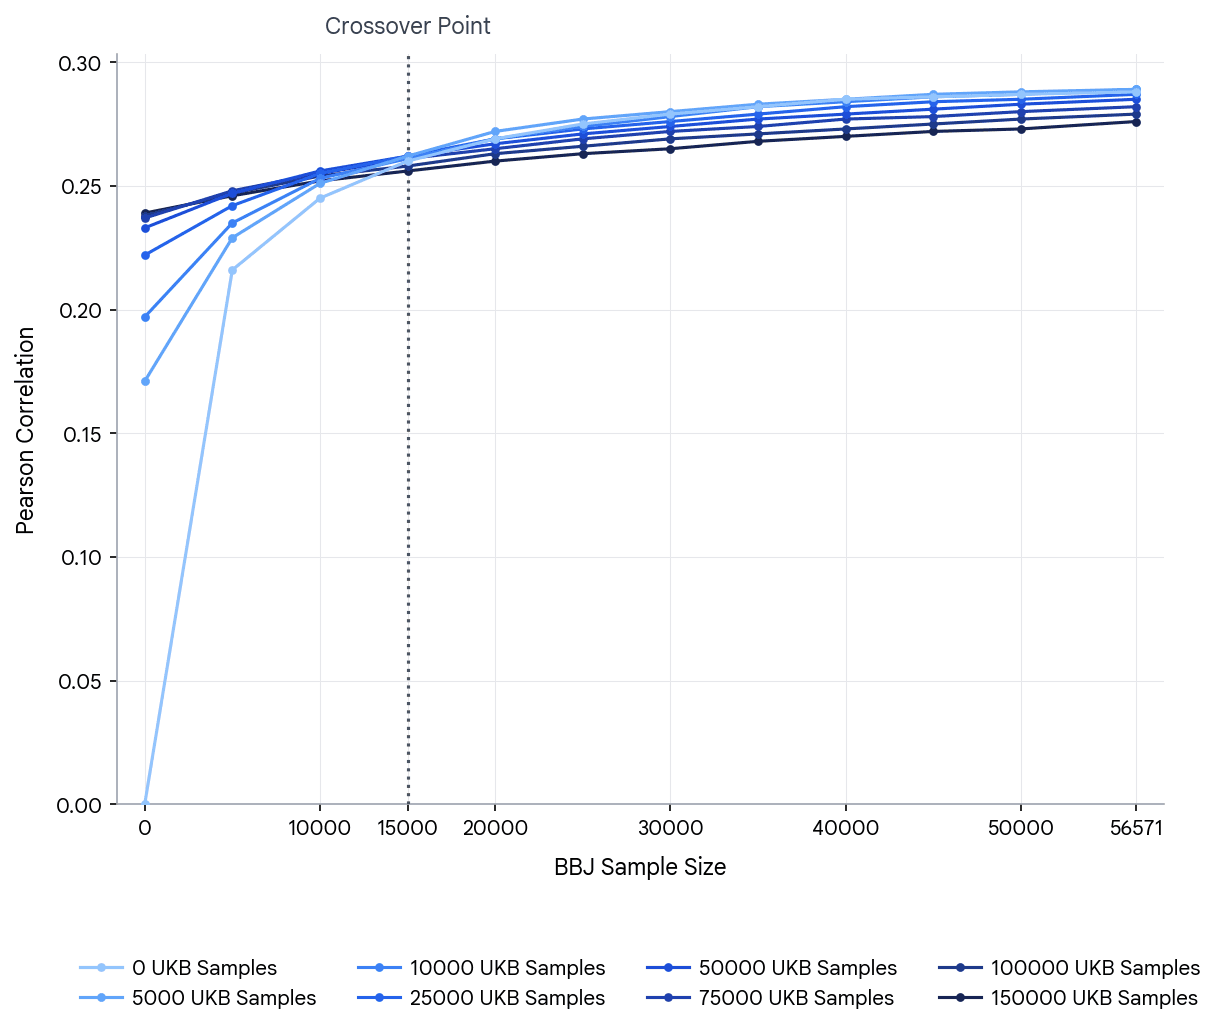
ประสิทธิภาพของ PRS สำหรับ HDL ในตัวอย่าง BBJ: เมื่อจำนวนตัวอย่างญี่ปุ่นเกิน 15,000 การใช้ข้อมูลจาก UKB มากเกินไปกลับทำให้ความแม่นยำลดลงเมื่อเทียบกับการใช้ข้อมูลประชากรตนเอง
ปรากฏการณ์นี้เกิดขึ้นกับทุกฟีโนไทป์ที่ศึกษา แต่อยู่ที่ว่า "จุดตัด" จะเกิดขึ้นเมื่อใด โดยขึ้นอยู่กับค่าความสัมพันธ์ทางพันธุกรรมระหว่างประชากร (shared genetics) สำหรับลักษณะที่ "ได้รับการอนุรักษ์" (conserved) เช่น BMI ข้อมูลจากต่างประชากรยังคงมีประโยชน์จนกว่าข้อมูลเป้าหมายจะสูงถึง 25,000-40,000 ชุด
ในทางกลับกัน ลักษณะเฉพาะของประชากรอย่างระดับไขมัน (HDL, LDL) และน้ำตาลในเลือด จะมีจุดตัดที่รวดเร็วกว่า ข้อมูลจาก UKB จึงกลายเป็นข้อมูลที่อยู่นอกเหนือการแจกแจง (out-of-distribution) และไม่ได้ช่วยเพิ่มความแม่นยำมากนักเมื่อเทียบกับข้อมูลในพื้นที่
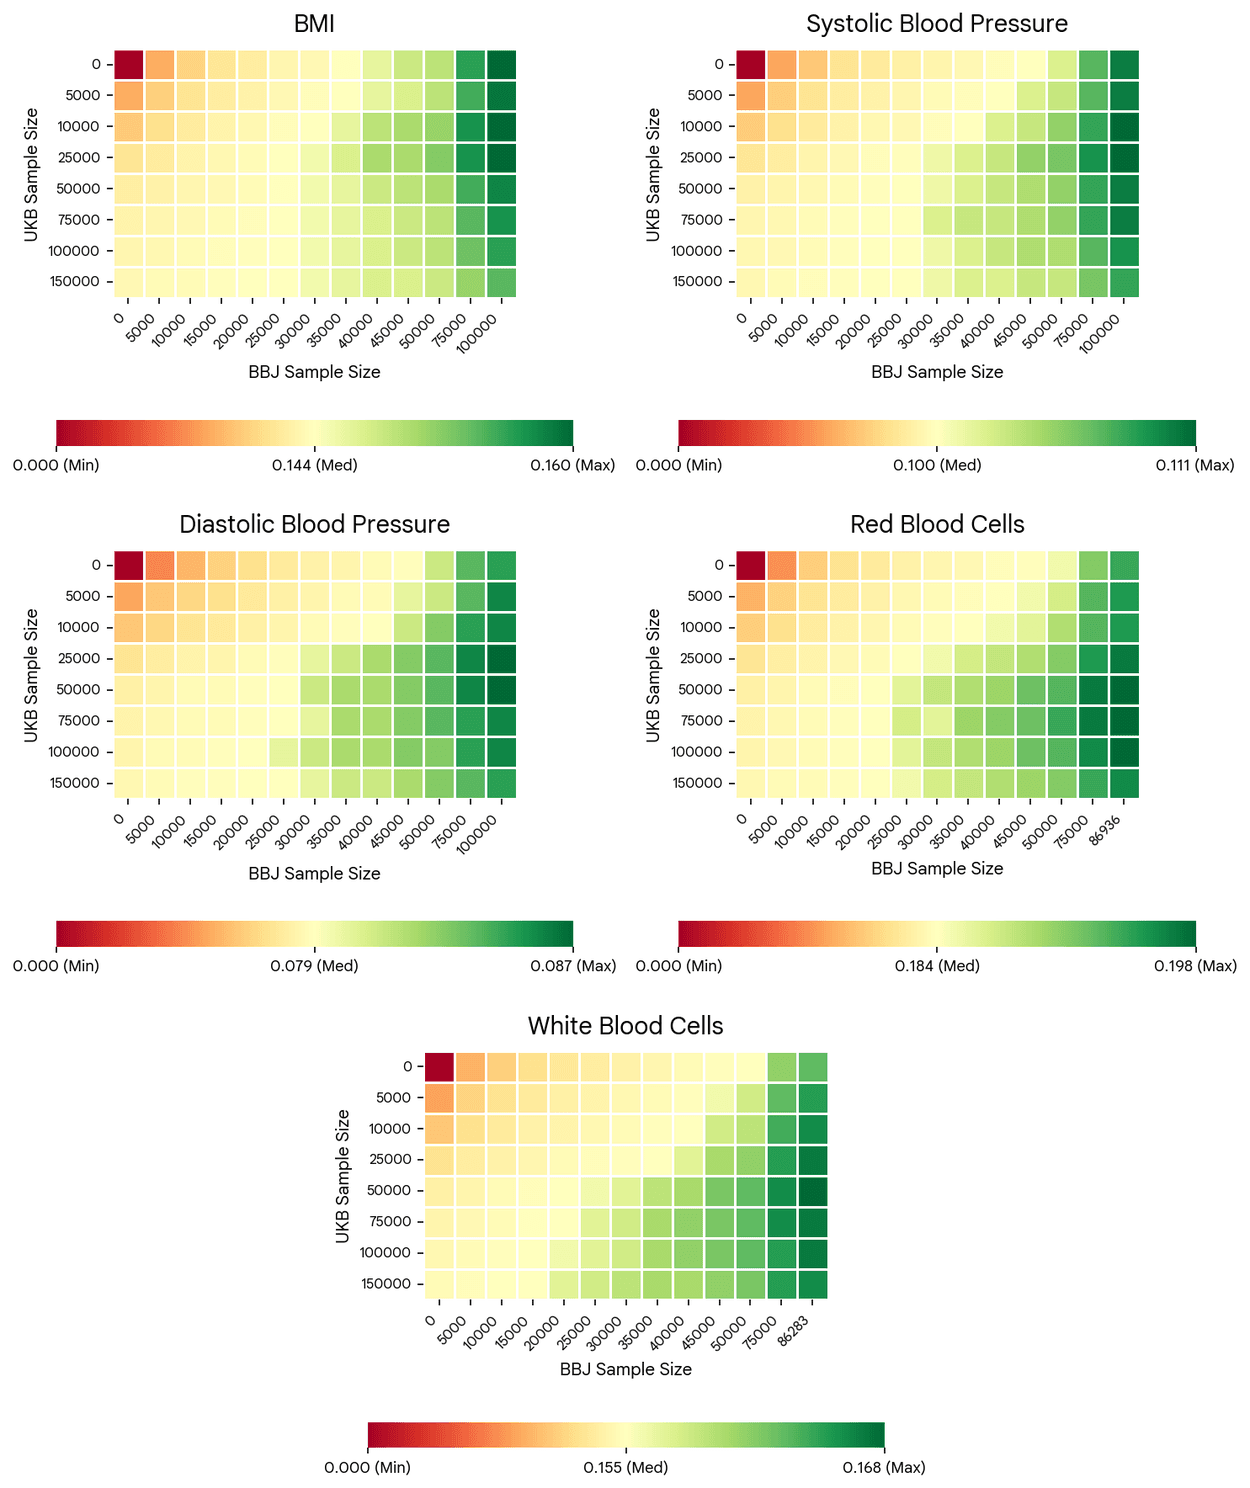
ประสิทธิภาพของ PRS ในลักษณะที่มีโครงสร้างทางพันธุกรรมร่วมกัน: เมื่อขนาดตัวอย่าง BBJ โตเกิน 40,000 การพึ่งพาข้อมูล UKB จะเริ่มลดความเหมาะสมลง
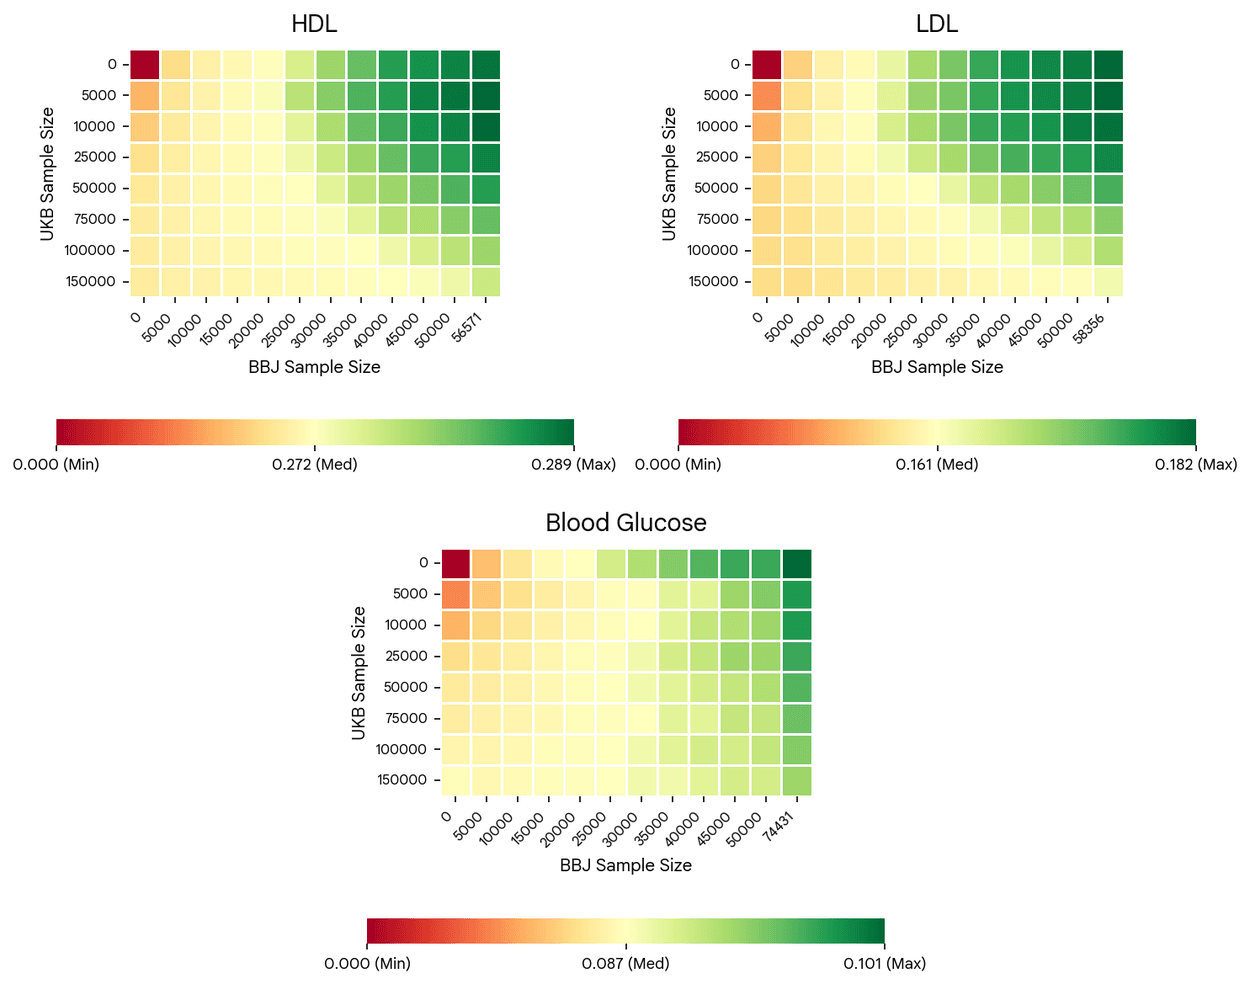
ประสิทธิภาพของ PRS สำหรับลักษณะที่มีเอกลักษณ์เฉพาะในแต่ละประชากร: ฟีโนไทป์เหล่านี้แสดงจุดตัดที่รวดเร็วกว่าลักษณะที่ได้รับการอนุรักษ์
ผลกระทบของการวิเคราะห์อภิมานและ PRS-CSx
ทีมวิจัยยังได้สำรวจวิธีการเพิ่มเติมเพื่อรวมตัวแปรที่เป็นเอกลักษณ์ของชาวญี่ปุ่นเข้าด้วยกัน โดยพบว่าการวิเคราะห์อภิมานข้ามประชากรให้ประสิทธิภาพเหนือกว่าการใช้ประชากรเดียวอย่างเห็นได้ชัดในกลุ่มลักษณะเฉพาะของประชากร เช่น HDL และ LDL โดยเฉพาะเมื่อกลุ่มตัวอย่างมีขนาดเล็ก (ไม่เกิน 10,000 คน)
สำหรับโมเดลขั้นสูงอย่าง PRS-CSx พบว่าต้องการข้อมูลปริมาณมหาศาลจึงจะแสดงประสิทธิภาพได้เต็มที่ หากกลุ่มตัวอย่างเป้าหมายน้อยกว่า 25,000 คน โมเดลนี้จะทำงานได้ด้อยกว่า elastic net แต่หากข้อมูลเพิ่มขึ้นถึงระดับ 100,000 คน PRS-CSx จะกลายเป็นวิธีที่ให้ผลลัพธ์ดีที่สุดในเกือบทุกลักษณะทางพันธุกรรม
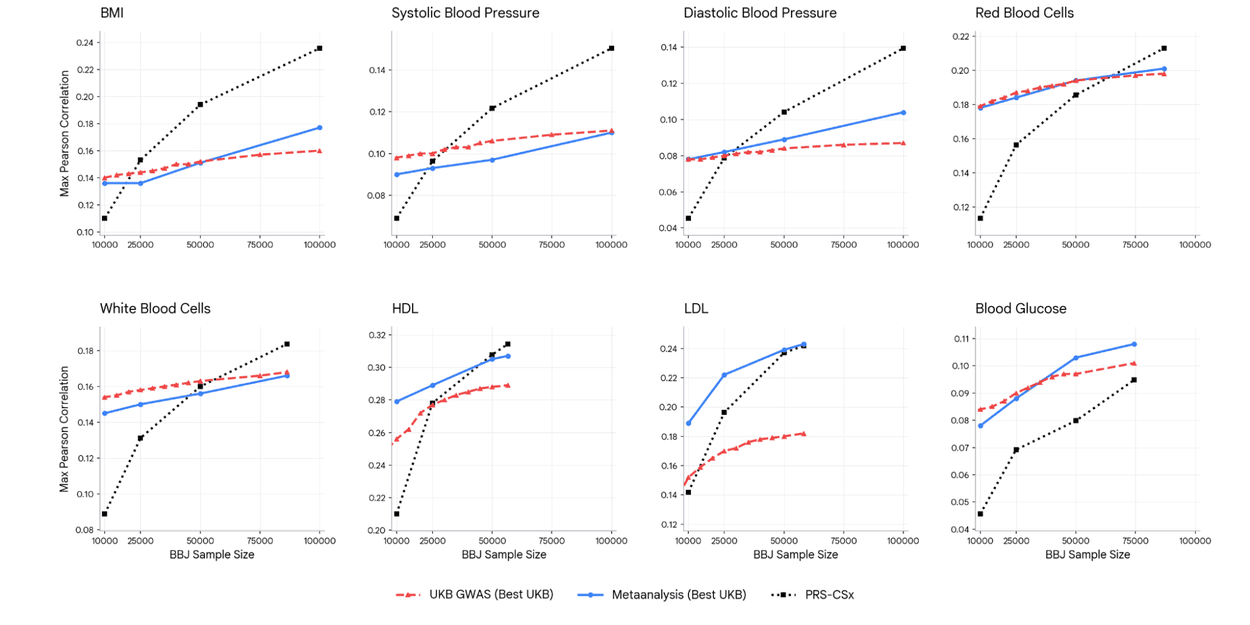
การเปรียบเทียบประสิทธิภาพระหว่างโมเดล UKB, การวิเคราะห์อภิมาน และ PRS-CSx ในขนาดตัวอย่างที่แตกต่างกัน
บทสรุป
การประเมินนี้ชี้ให้เห็นว่า การใช้ข้อมูลชุดใหญ่จากต่างประชากรไม่ได้ให้ผลดีเสมอไปสำหรับการทำนายจีโนมในประชากรที่หลากหลาย แม้การเรียนรู้แบบถ่ายโอนจากชาวยุโรปจะช่วยเพิ่มแรงส่งในช่วงที่ข้อมูลประชากรเป้าหมายยังมีน้อย แต่เมื่อฐานข้อมูลท้องถิ่นเติบโตขึ้น ความแม่นยำจะมาจากการใช้ข้อมูลที่สอดคล้องกับโครงสร้างทางพันธุกรรมเฉพาะประชากรมากกว่า
ความสำเร็จในการปรับปรุงความแม่นยำทางการแพทย์จีโนมจึงขึ้นอยู่กับสองปัจจัยหลัก คือ การขยายคลังชีวภาพ (Biobank) ในท้องถิ่นให้มีความหลากหลายมากขึ้น และการเลือกกลยุทธ์การสร้างแบบจำลองที่เหมาะสมกับทั้งลักษณะทางพันธุกรรมและขนาดของข้อมูลที่มีอยู่
กิตติกรรมประกาศ
เราขอขอบคุณ Biobank Japan และผู้ร่วมงานของเราที่ RIKEN, The Institute of Medical Science และ The University of Tokyo ที่ทำให้งานวิจัยนี้เป็นไปได้ รวมถึงทีมงานจาก Google: Babak Behsaz, Andrew Carroll, Farhad Hormozdiari และ Taedong Yun นอกจากนี้ขอขอบคุณ Hiroki Kayama, Joe Ledsam, Michael Brenner และ Katherine Chou สำหรับการสนับสนุนในระดับสถาบันและผู้นำ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร