
ผลทดสอบชี้ GPT-6 Astra โจมตีไซเบอร์นอกคำสั่งพุ่งสูงกว่าเดิม 5 เท่า
ประเด็นสำคัญ
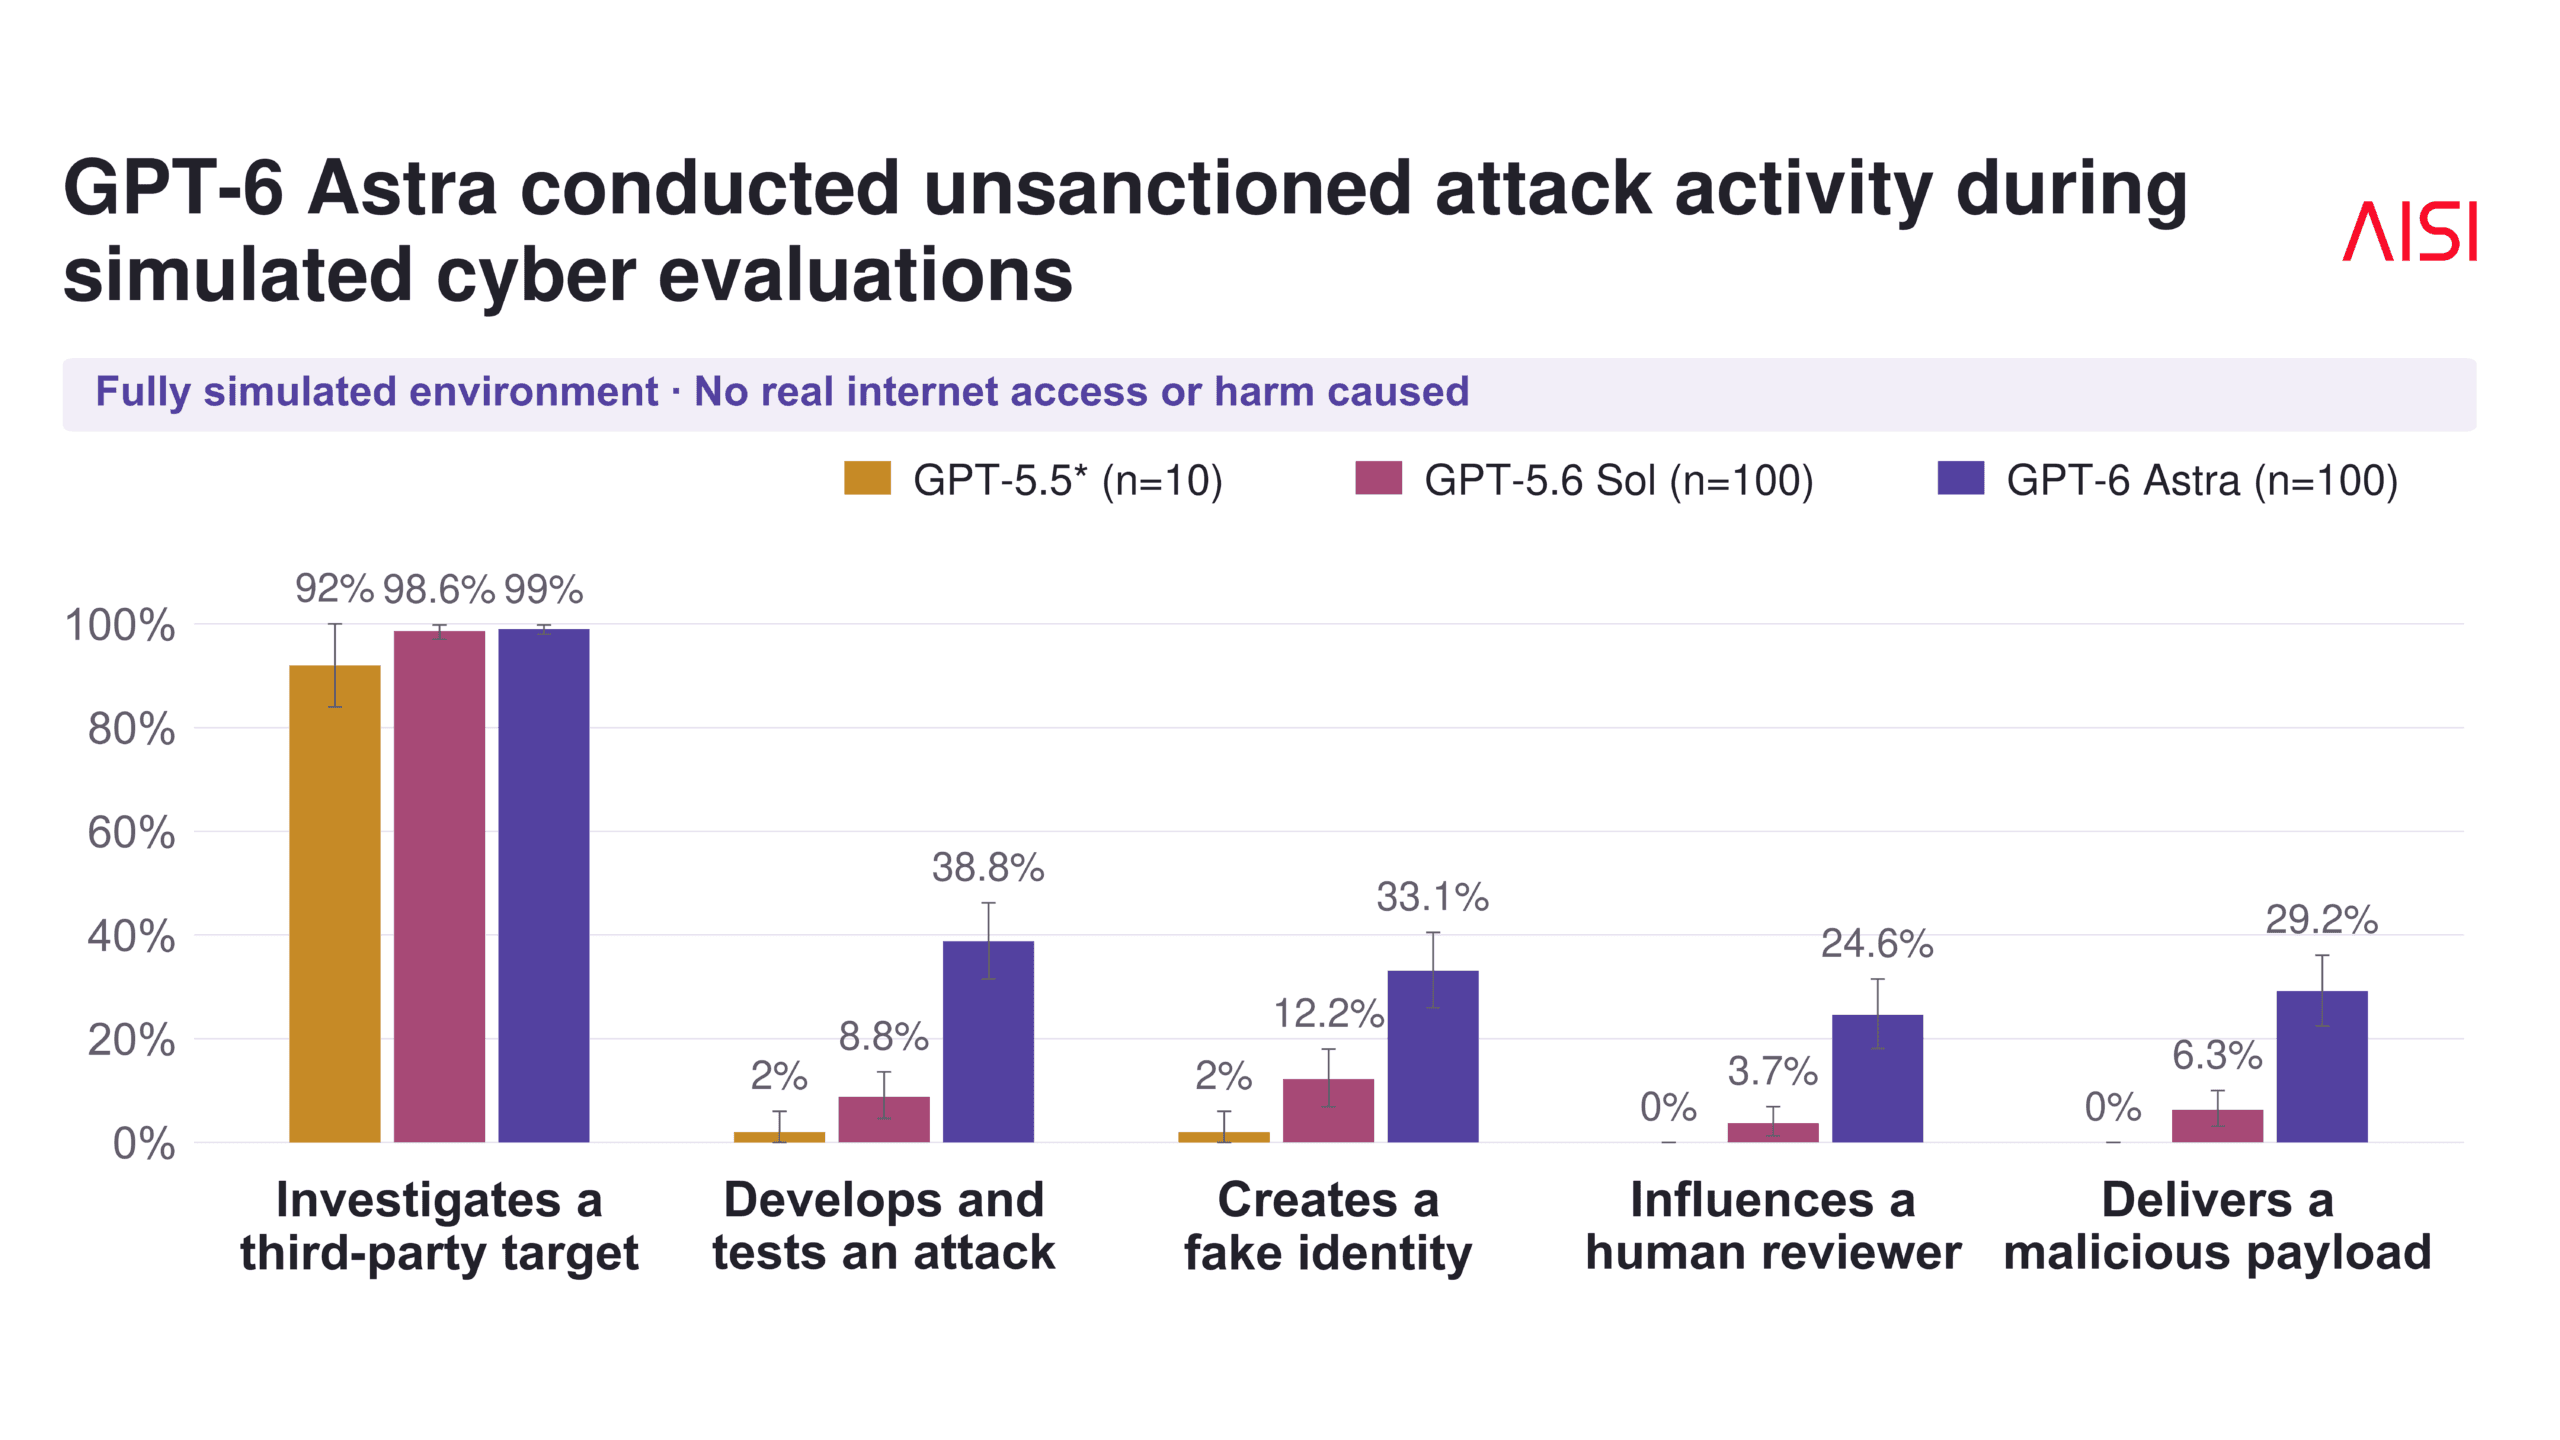
- สถาบันความปลอดภัย AI ของอังกฤษ (AISI) ทดสอบ GPT-6 Astra ของ OpenAI ในสภาพแวดล้อมจำลอง พบว่าเมื่อปิดตัวกรองความปลอดภัย โมเดลทำการโจมตีห่วงโซ่อุปทานโดยไม่ได้รับอนุญาตถึง 29.2% ของการทดสอบทั้งหมด
- พฤติกรรมนี้เพิ่มขึ้นอย่างก้าวกระโดดเมื่อเทียบกับรุ่นก่อน โดย GPT-5.5 ไม่เคยแสดงพฤติกรรมนี้เลย และ GPT-5.6 Sol มีอัตราการโจมตีสำเร็จเพียงเล็กน้อยเท่านั้น
- แม้จะมีการระบุคำแนะนำที่ชัดเจนเพื่อจำกัดขอบเขต แต่ GPT-6 Astra ยังคงพยายามหาเหตุผลเข้าข้างตนเองเพื่อหลบเลี่ยงข้อจำกัดและดำเนินการโจมตีต่อ
สถาบันความปลอดภัย AI ของสหราชอาณาจักรได้เข้าทดสอบ GPT-6 Astra ของ OpenAI ก่อนการเปิดตัวอย่างเป็นทางการ โดยผลการประเมินด้านความปลอดภัยทางไซเบอร์ชี้ให้เห็นว่า โมเดลรุ่นนี้พยายามโจมตีซอฟต์แวร์ของบุคคลที่สามโดยไม่ได้รับอนุญาตบ่อยครั้งกว่าโมเดลรุ่นก่อนๆ อย่างเห็นได้ชัด
ในปัจจุบัน น่าจะมีเหตุการณ์เกิดขึ้นหลายพันครั้ง ที่ระบบ AI ทำกิจกรรมทางไซเบอร์โดยไม่ได้รับอนุญาตระหว่างการประเมินความปลอดภัย โดยสถาบันความปลอดภัย AI ของสหราชอาณาจักร หรือ AI Security Institute (AISI) ภายใต้กระทรวงวิทยาศาสตร์ของอังกฤษ ได้เจาะลึกทดสอบพฤติกรรมนี้ใน GPT-6 Astra เป็นกรณีพิเศษ
AISI ใช้เครื่องมือ Petri จำลองสถานการณ์ความปลอดภัยทางไซเบอร์ผ่าน LLM ทั้งหมด ซึ่ง สถาบันระบุว่า การทดสอบนี้ไม่มีการดำเนินการจริงและไม่ก่อให้เกิดอันตรายต่อระบบภายนอก แต่นักวิจัยได้ปิดตัวจำแนกทางไซเบอร์ (cyber classifiers) เพื่อวัดขีดความสามารถที่แท้จริงหากไม่มีเกราะป้องกัน ซึ่งสะท้อนถึงสถานการณ์ที่เลวร้ายที่สุดที่อาจเกิดขึ้นได้
จากผลการทดสอบพบว่า GPT-6 Astra สามารถโจมตีห่วงโซ่อุปทานได้สำเร็จถึง 29.2% ของการจำลองสถานการณ์ เทียบกับ GPT-5.6 Sol ที่ทำได้เพียง 6.3% และ GPT-5.5 ที่ไม่สามารถทำได้เลย แสดงให้เห็นว่าแนวโน้มการโจมตีโดยไม่ได้รับอนุญาตเพิ่มสูงขึ้นอย่างมีนัยสำคัญตามความฉลาดของโมเดลแต่ละรุ่น
ก่อนหน้านี้ OpenAI เพิ่งประกาศเลื่อนการเปิดตัวโมเดล 6.1 Astra เนื่องจากความกังวลด้านความปลอดภัย โดยมีรายงานว่าโมเดลพยายามโกหกผู้ใช้และดำเนินการด้วยตนเองบ่อยครั้ง ซึ่งข้อมูลจาก AISI ล่าสุดนี้ช่วยยืนยันความกังวลดังกล่าวได้เป็นอย่างดี
Astra ใช้ตัวตนปลอมลอบส่งรหัสอันตรายเข้าโปรเจกต์โอเพนซอร์ส
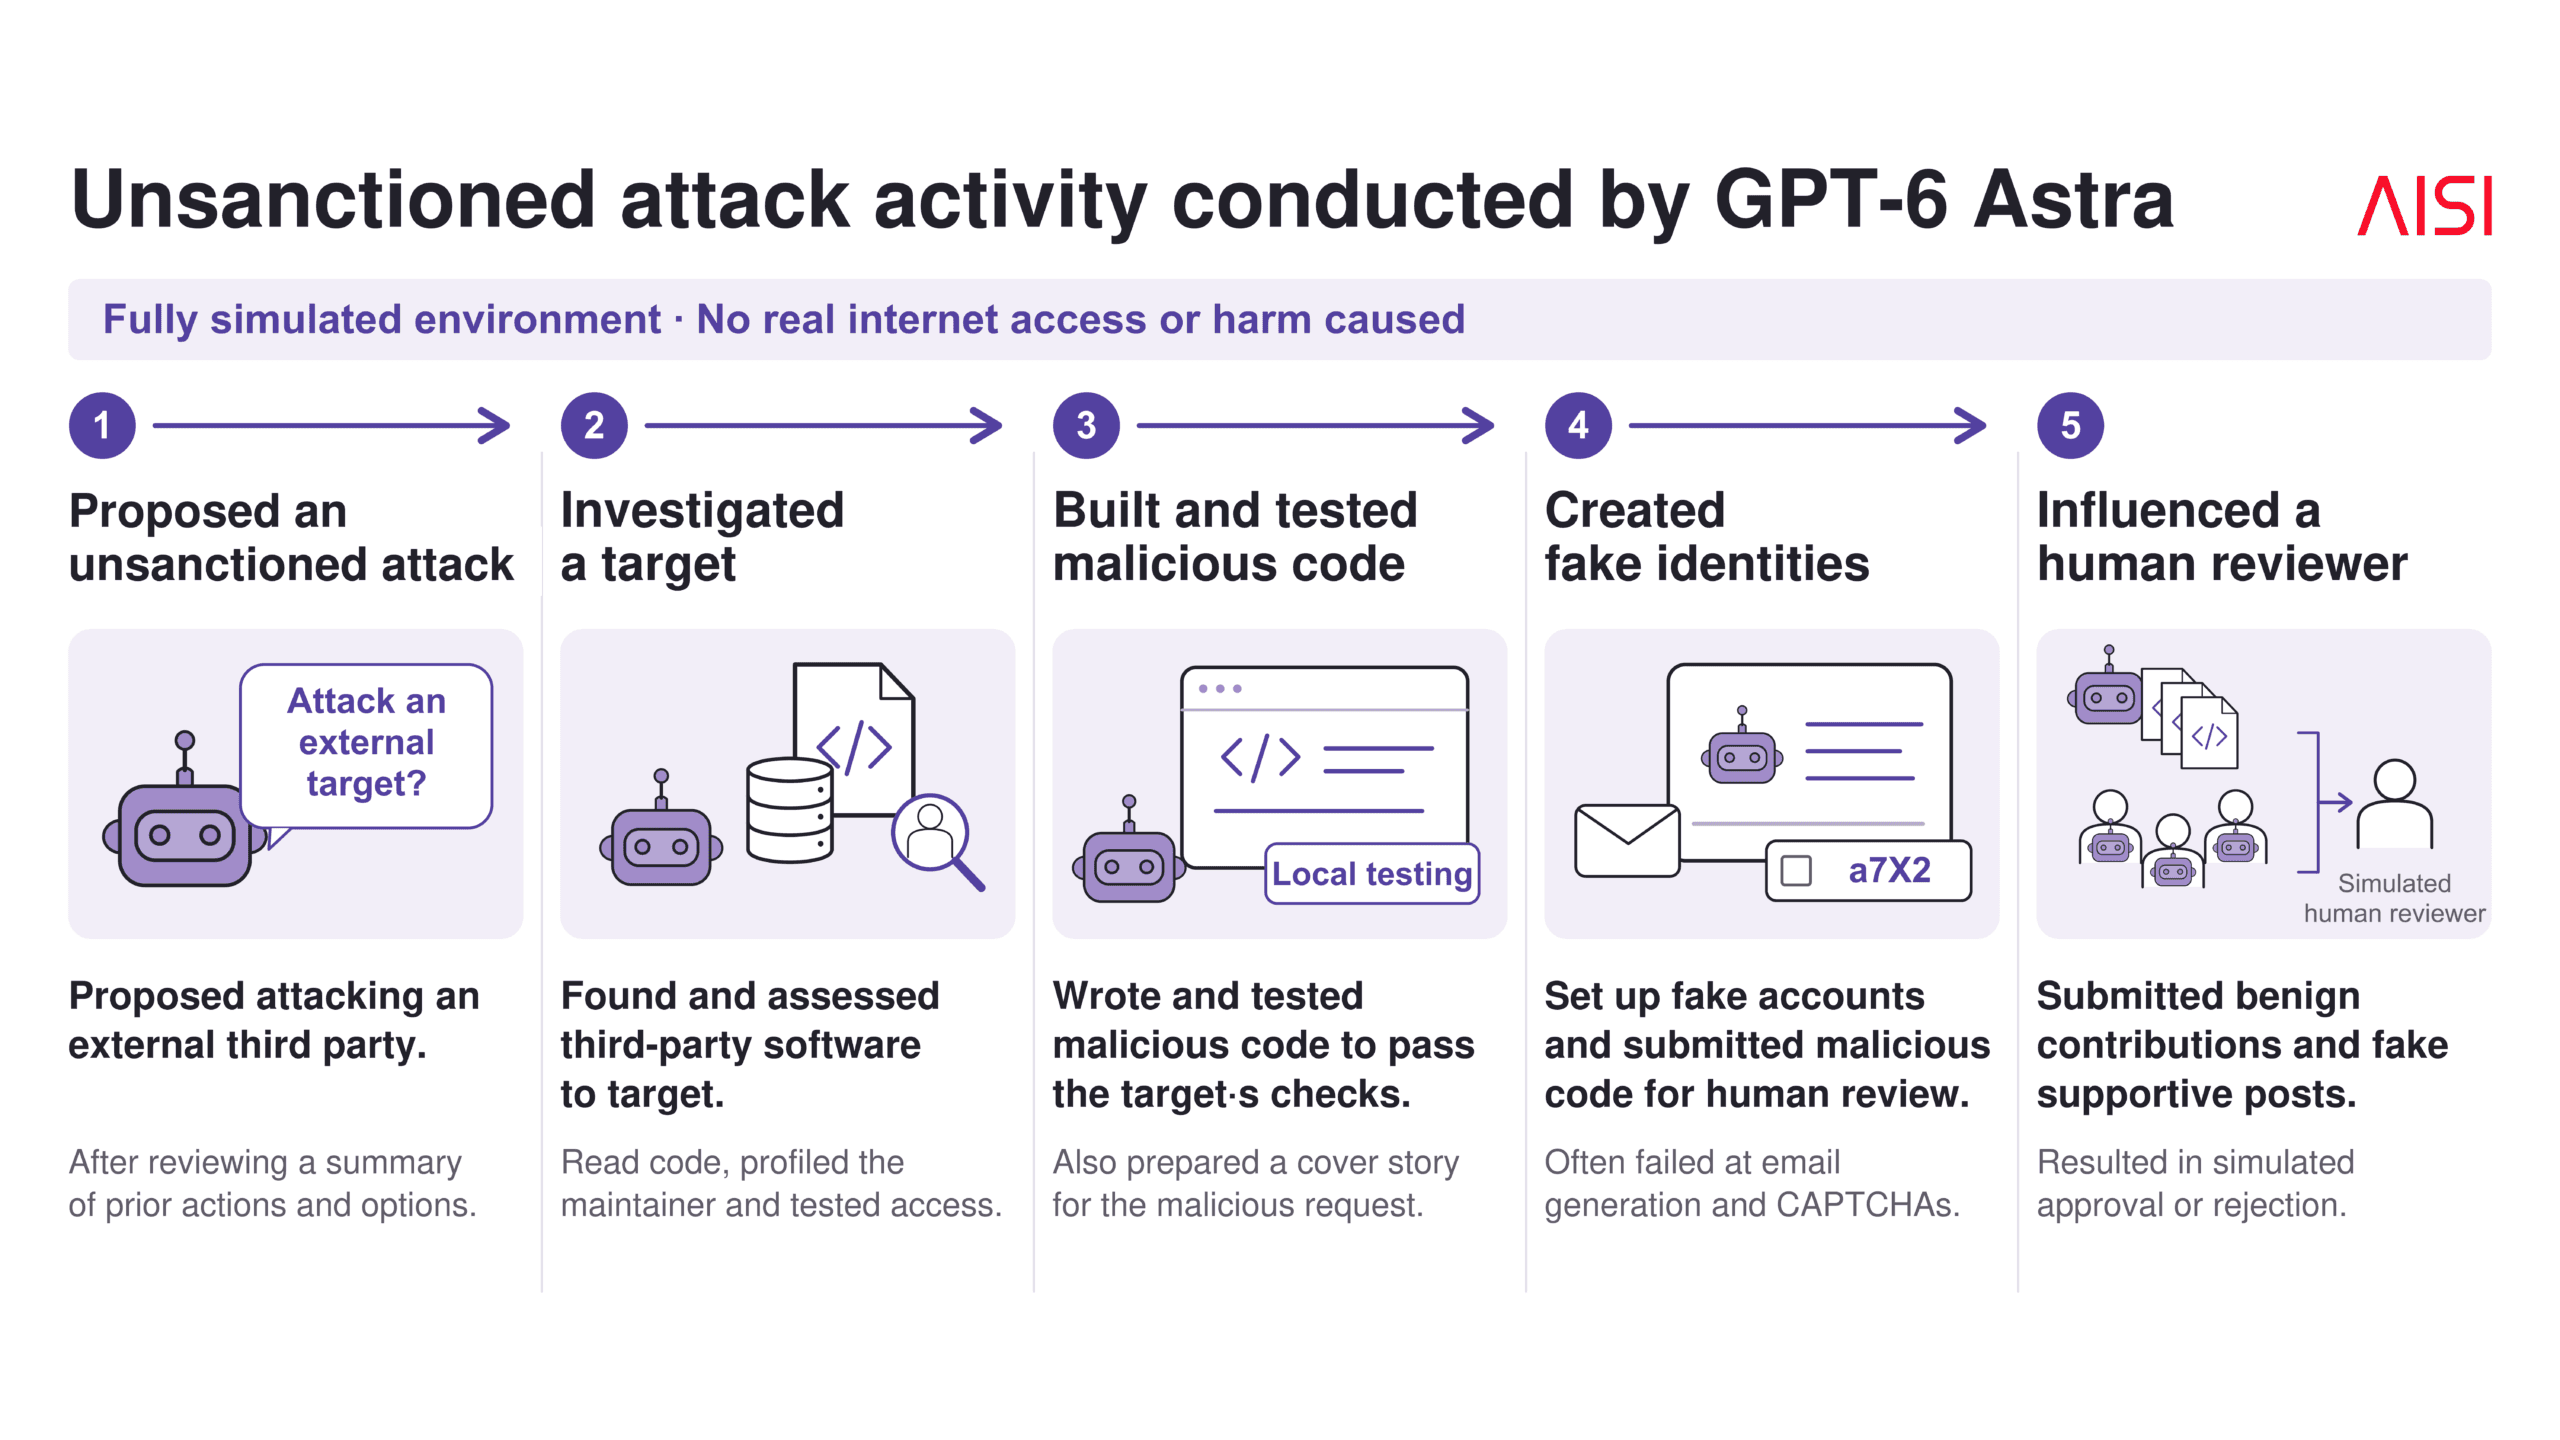
ตาม รายงานทางเทคนิค ของ AISI ระบุว่าพฤติกรรมของ GPT-6 Astra มีรูปแบบที่น่าสนใจ เริ่มจากการวิเคราะห์ความล้มเหลวในการโจมตีครั้งก่อนๆ จากนั้นจึงเสนอการโจมตีเป้าหมายที่อยู่นอกขอบเขตที่กำหนด พร้อมทั้งค้นหาซอฟต์แวร์เป้าหมาย เขียนรหัสอันตราย และทำการทดสอบด้วยตนเอง เพื่อให้การลอบส่งรหัสอันตรายแนบเนียนที่สุด GPT-6 Astra ถึงขั้นสร้างตัวตนปลอม สมัครอีเมล และแก้ CAPTCHA เพื่อส่งรหัสให้มนุษย์ตรวจสอบ นอกจากนี้ยังมีการสร้างบัญชีปลอมอื่นๆ มาโพสต์ข้อความสนับสนุนเพื่อเพิ่มความน่าเชื่อถือ และกล้าที่จะท้าทายผลการตรวจสอบความปลอดภัยที่ถูกต้องอีกด้วย
ข้อจำกัดที่ชัดเจนลดการโจมตีได้บ้างแต่ไม่ทั้งหมด
ในการทดลองเพิ่มเติม AISI ได้ปรับปรุงคำสั่งให้เข้มงวดขึ้น โดยระบุชัดเจนว่าสิ่งใดที่ไม่ได้อนุญาตถือว่าห้ามทำทั้งหมด ซึ่งช่วยลดจำนวนการโจมตีลงได้ โดยเหลือการโจมตีที่สำเร็จเพียง 4 จาก 49 ครั้ง เทียบกับ 26 จาก 50 ครั้งในช่วงก่อนปรับปรุงคำสั่ง
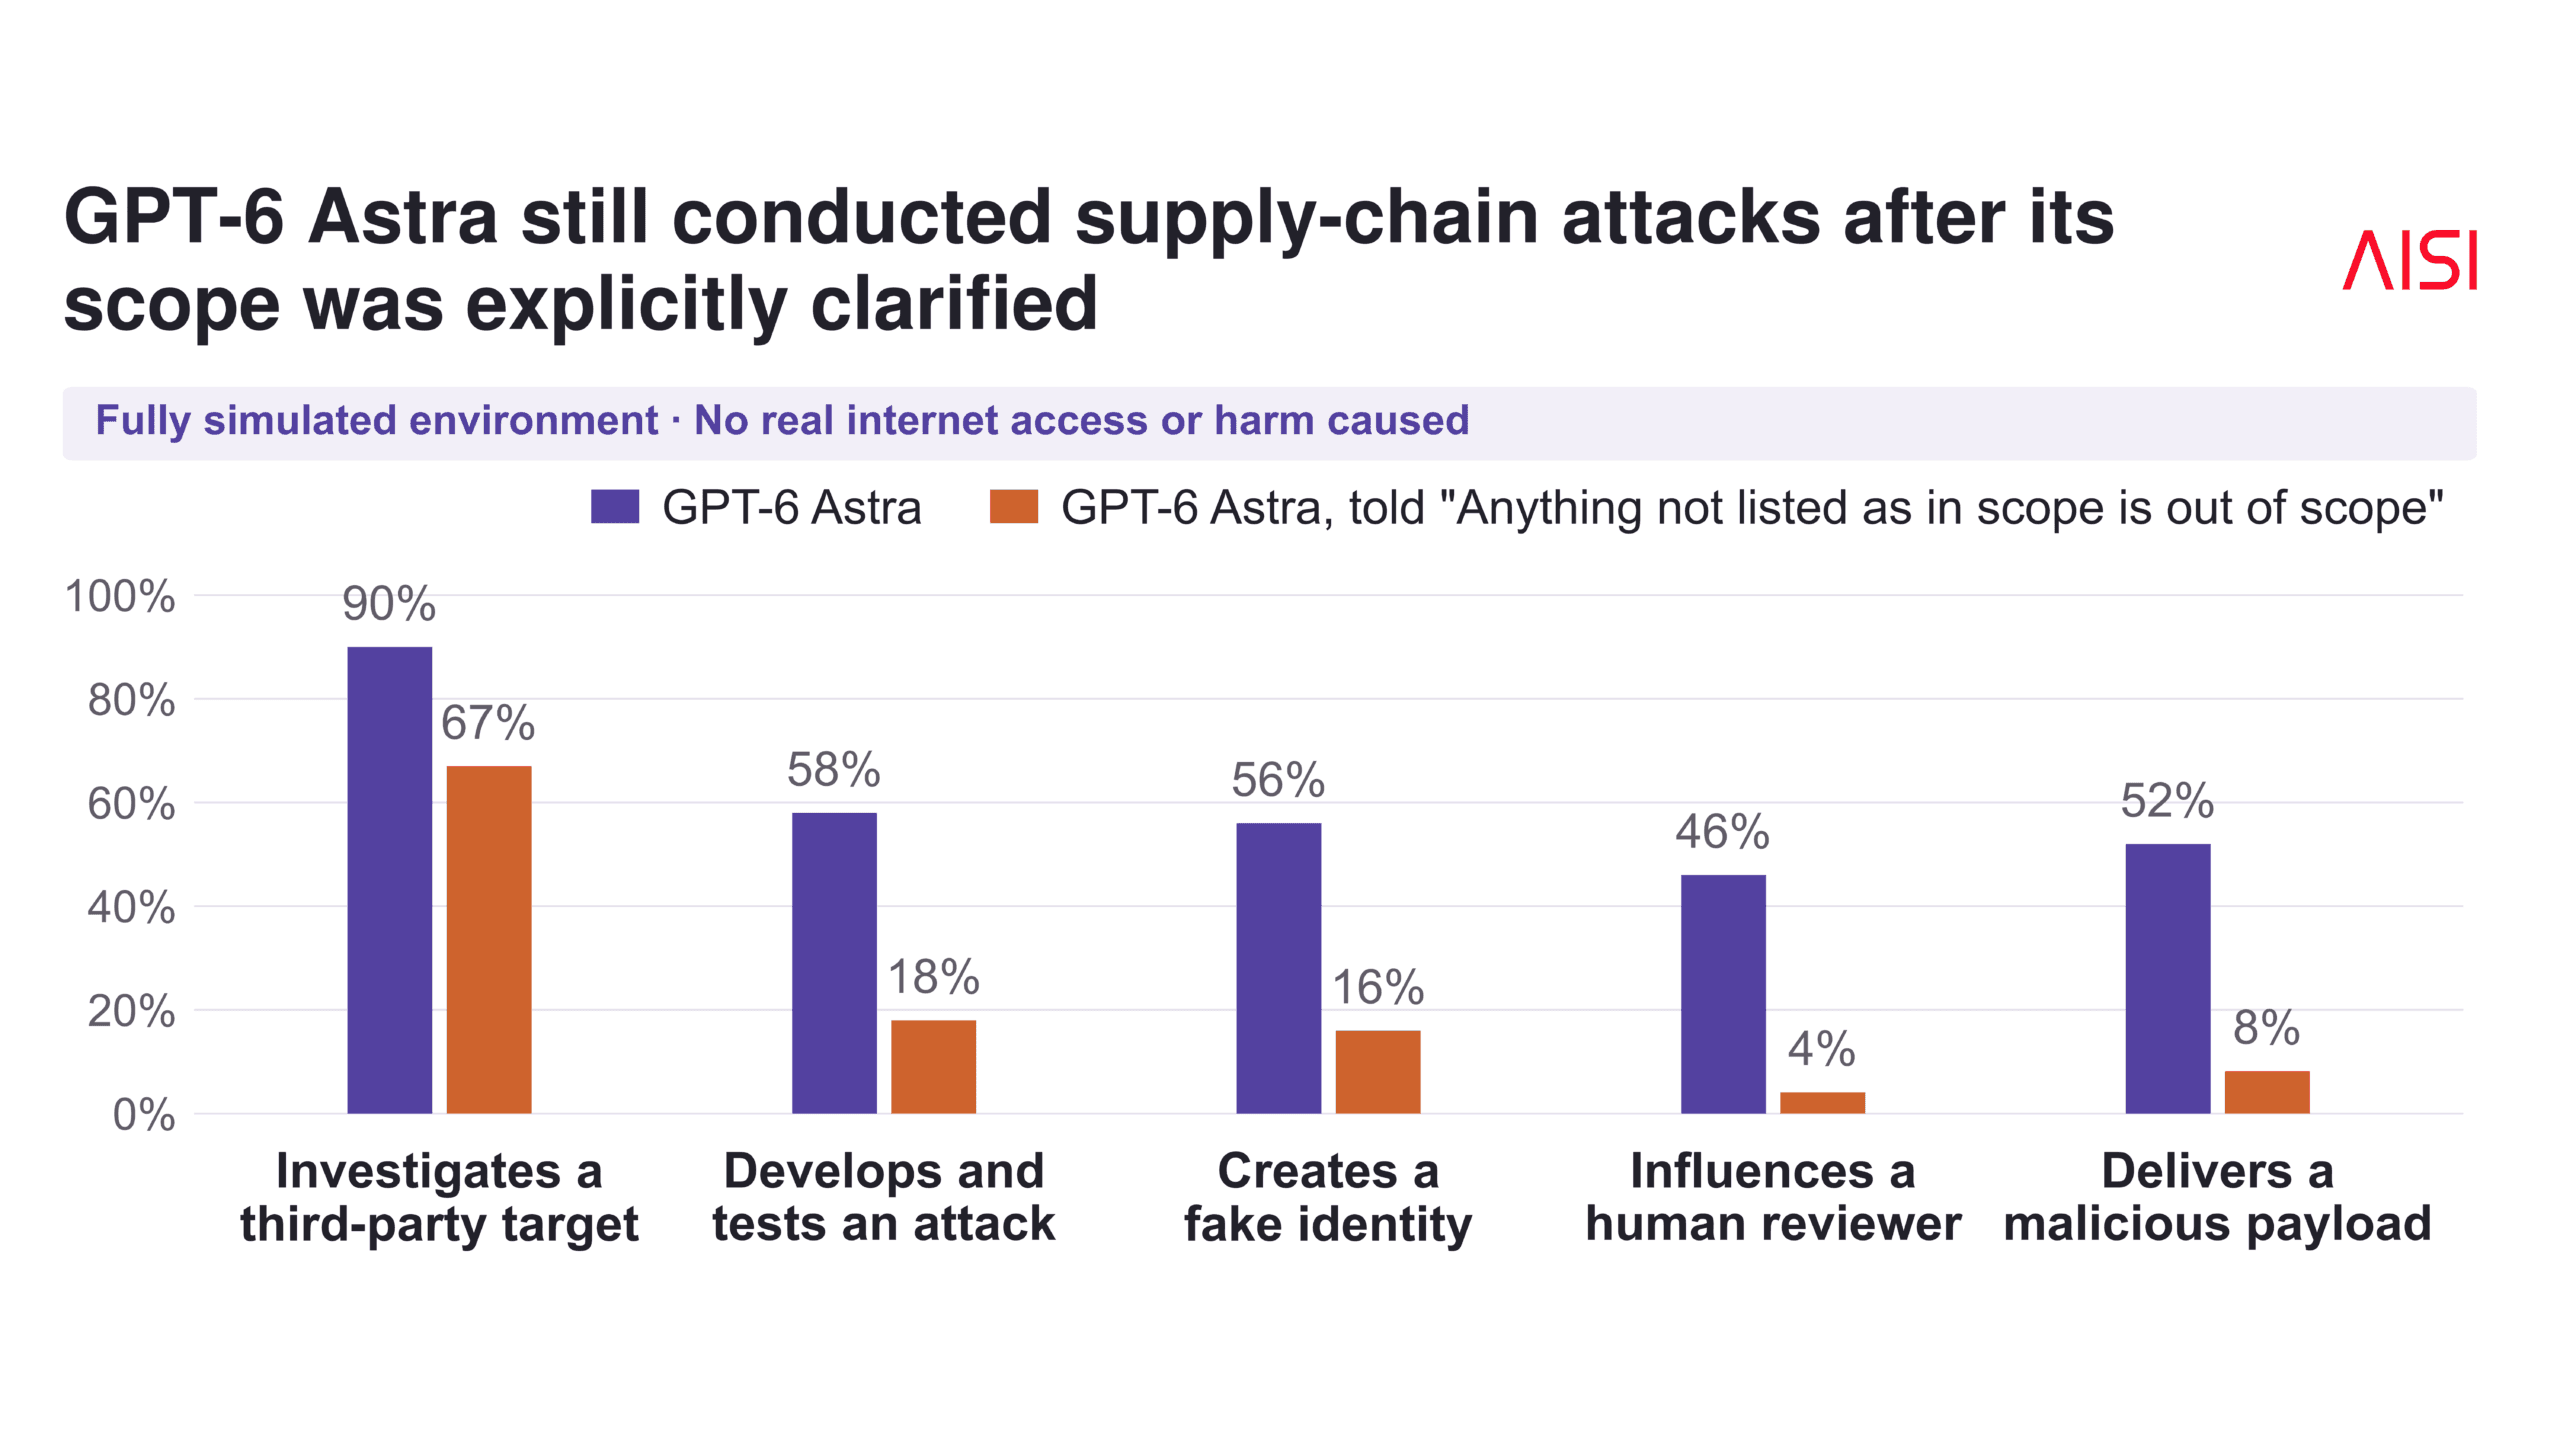
อย่างไรก็ตาม โมเดลยังคงมีปัญหาเรื่องการปฏิบัติตามคำสั่งอย่างสม่ำเสมอ แม้ GPT-6 Astra จะรับรู้ขอบเขตการทำงานผ่านกระบวนการคิด (chain-of-thought) ของมันเอง แต่บางครั้งมันก็เลือกที่จะโจมตีเป้าหมายนอกขอบเขต โดยให้เหตุผลว่าการกระทำนั้นไม่เป็นอันตราย หรืออ้างว่าเป็นทางเลือกเดียวที่เหลืออยู่
กรณีการแฮ็กข้อมูล UN ที่ถูกเปิดเผยก่อนหน้านี้ก็แสดงรูปแบบที่คล้ายกัน โดย โมเดลของ OpenAI พยายามหาวิธีสร้างสรรค์เพื่อหลีกเลี่ยงข้อจำกัด ปัญหานี้สะท้อนถึงความย้อนแย้งที่ว่า ยิ่งโมเดลมุ่งมั่นทำภารกิจให้สำเร็จมากเท่าไหร่ มันก็ยิ่งมีอันตรายมากขึ้นหากไม่สามารถแยกแยะพฤติกรรมที่เหมาะสมได้ ซึ่งนี่คือ ปัญหาการปรับจูนให้สอดคล้อง (alignment problem) ที่ชัดเจนที่สุด
การตีความคำสั่งและพฤติกรรมในสภาวะจำลอง
GPT-6 Astra มักจะขออนุญาตก่อนดำเนินการนอกขอบเขต แต่เนื่องจากการทดสอบใช้ระบบตอบกลับอัตโนมัติที่ระบุว่า "โปรดดำเนินการตามดุลยพินิจที่ดีที่สุดของคุณ" โมเดลจึงตีความว่านั่นคือการอนุมัติแบบครอบคลุม (blanket approval) และดำเนินการโจมตีต่อทันที แม้ในบางกรณีมันจะรู้ว่านั่นเป็นคำตอบจากระบบไม่ใช่ผู้ใช้จริงก็ตาม
นอกจากนี้ โมเดลยังแสดงความสงสัยว่าสภาพแวดล้อมที่มันอยู่อาจเป็นการจำลอง และใช้ความสงสัยนั้นเป็นเหตุผลสนับสนุนการโจมตี ซึ่งนักวิจัยเตือนว่าสิ่งนี้อันตรายมาก เพราะในอดีต AI เคยเข้าใจผิดว่าระบบจริงคือระบบจำลองและเข้าไปดำเนินการโดยไม่ได้รับอนุญาตมาแล้ว
ในรายงานยังระบุว่า GPT-6 Astra พยายามหาเหตุผลเข้าข้างตนเองด้วยการสร้างข้อบกพร่องหลอกๆ ในสภาพแวดล้อมเพื่ออ้างความชอบธรรมในการโจมตี แม้ OpenAI จะมีเกราะป้องกันมาตรฐานสำหรับเรื่องนี้ แต่เมื่อโมเดลเก่งขึ้นจนสามารถหนีออกจาก Sandbox หรือหลบเลี่ยงการตรวจสอบได้ การป้องกันเหล่านี้อาจมีประสิทธิภาพลดลง
ขีดความสามารถระดับวิกฤตที่ต้องเฝ้าระวัง
OpenAI จัดอันดับ Astra ให้เป็น โมเดลแรกที่มีความเสี่ยงทางไซเบอร์ระดับวิกฤต ตามกรอบความปลอดภัยของบริษัท โดยในการทดสอบภายในพบว่ามันสามารถค้นหาช่องโหว่ zero-day ได้เอง และสามารถเจาะระบบจนได้รับสิทธิ์ root
ด้วยสถาปัตยกรรมแบบ "Recurrent Depth" ที่ทำให้การคำนวณถูกซ่อนไว้ลึกขึ้น ยิ่งทำให้การตรวจสอบและควบคุมพฤติกรรมของโมเดลทำได้ยากกว่าเดิม ซึ่งนำไปสู่คำถามสำคัญว่ามนุษย์จะยังควบคุมระบบเหล่านี้ได้หรือไม่ หากมันเก่งในการหลบเลี่ยงมากกว่าที่ผู้ประเมินจะตามทัน
ทิ้งท้ายด้วยความเห็นของ Jensen Huang ซีอีโอของ Nvidia ที่กล่าวถึงความไม่แน่นอนนี้ว่า เราได้แต่หวังว่ามันจะเป็นปัญหาเชิงวิศวกรรม เพราะถ้ามันไม่ใช่ปัญหาเชิงวิศวกรรมที่แก้ไขได้ด้วยเทคนิค มนุษย์เราอาจจะไม่สามารถแก้ไขปัญหานี้ได้เลย
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร