
7 ข้อผิดพลาด Python ยอดฮิตใน AI Workflow ที่อาจทำให้โมเดลพังแบบเงียบเชียบ
โมเดลอาจทำคะแนน validation ได้สูงถึง 0.83 และรันผ่านทุกขั้นตอนโดยไม่มี error แต่หลังจาก deploy ไปเพียงสามสัปดาห์ ผลการทำนายกลับใช้การไม่ได้จริง ปัญหานี้มักเกิดจากบั๊กใน AI workflow ที่ต่างจากบั๊ก Python ทั่วไป เพราะ API ส่วนใหญ่พร้อมจะยอมรับโค้ดที่ละเมิดข้อตกลงของข้อมูล ไม่ว่าจะเป็นเรื่องสถานะหรือรูปร่างของ Tensor โดยไม่มีการแจ้งเตือน
การรันโค้ดผ่านฉลุยพิสูจน์ได้เพียงว่ากระบวนการทำงานได้ แต่มันไม่ได้การันตีว่าสิ่งที่ pipeline เรียนรู้นั้นถูกต้องหรือเชื่อถือได้ ข้อผิดพลาดทั้ง 7 ประการต่อไปนี้มักเกิดขึ้นอย่างเงียบเชียบ ซึ่งแต่ละข้อจำเป็นต้องมีวิธีการตรวจสอบที่ชัดเจนเพื่อดักจับปัญหาก่อนที่จะลุกลาม
| Stage | Silent Mistake | Misleading Symptom | The Check |
|---|---|---|---|
| Preprocessing | Transform fitted before the split | Validation score is optimistically inflated | Locate every fit call; name the rows visible at that moment |
| Splitting | Related rows on both sides of the split | Strong validation, weak on new entities | Group- or time-aware splitter matched to the real boundary |
| Serving | Second hand-written preprocessing path | Train and serve outputs drift apart silently | One fixture through both paths; assert outputs identical |
| Randomness | One seed treated as reproducibility | Reruns differ despite the seeded library | Record seeds, data, code, config, and dependencies |
| Evaluation | eval() and no_grad() used interchangeably | Dropout or batch norm active during validation | Both calls in the loop, then model.train() on resume |
| Loss Boundary | Broadcast hides a [batch, 1] vs [batch] mismatch | Plausible loss from the wrong computation | assert output.shape == target.shape before the loss |
| Artifact | Saved model treated as inert data | Code execution or version breakage on load | Trusted sources only; smoke-test in the serving environment |
Figure 1. จุดที่ข้อผิดพลาดทั้งเจ็ดซ่อนตัวอยู่ใน workflow และการตรวจสอบที่เผยให้เห็นก่อนที่จะถึงขั้นตอน production
1. การ Fitting Preprocessing ก่อนแยกข้อมูล (Data Leakage)
นี่คือข้อผิดพลาดที่พบบ่อยที่สุด ลองจินตนาการถึงการนำข้อมูลสุ่ม (noise) มาเลือก feature ที่ดีที่สุดด้วย SelectKBest แล้วทำ cross-validate หากคุณทำบนข้อมูลทั้งหมดก่อนแยกส่วน โค้ดจะรายงานค่า accuracy สูงผิดปกติเพราะข้อมูลในส่วนทดสอบได้รั่วไหลไปถึงขั้นตอนการเลือก feature แล้ว
sel = SelectKBest(f_classif, k=20).fit(X, y)   # fit บนทุกแถว ทำให้เกิด leakage
scores = cross_val_score(model, sel.transform(X), y, cv=5)
วิธีแก้ไขคือการใช้ scikit-learn pipeline เพื่อให้แต่ละ fold ทำการ fit และ transform ข้อมูลของตัวเอง ซึ่งจะให้ค่า accuracy ที่ซื่อตรงต่อความเป็นจริง กฎนี้ครอบคลุมทั้งการทำ scaling, imputation และการลดมิติข้อมูล ตามที่ระบุไว้ใน รายการกับดักเหล่านี้
2. การสุ่ม Split ข้อมูลที่มีความสัมพันธ์กัน
การสุ่มแยกข้อมูลแบบทั่วไป (Random Split) อาจใช้ไม่ได้หากข้อมูลแต่ละแถวไม่ได้เป็นอิสระต่อกัน เช่น ข้อมูลหลายแถวที่มาจากผู้ใช้คนเดียวกัน หากแยกข้อมูลผิดวิธี โมเดลจะจดจำลักษณะเฉพาะของบุคคลนั้นแทนที่จะเรียนรู้เพื่อนำไปใช้กับคนใหม่ ส่งผลให้คะแนน validation ดูดีเกินจริง
สำหรับข้อมูลที่มีการจับกลุ่มควรใช้ GroupKFold หรือ GroupShuffleSplit และข้อมูลที่เรียงตามเวลาควรใช้ TimeSeriesSplit เพื่อป้องกันไม่ให้โมเดลใช้ข้อมูลในอนาคตมาทำนายอดีต คุณสามารถศึกษาเพิ่มเติมได้จาก คู่มือ cross-validation เพื่อเลือกตัวแยกข้อมูลที่เหมาะสมที่สุด
3. ความต่างของ Preprocessing ระหว่าง Training และ Inference
ปัญหาที่เรียกว่า Skew เกิดจากการใช้เส้นทางแปลงข้อมูลที่ต่างกันในขั้นตอนเทรนและขั้นตอนใช้งานจริง เช่น การเขียนฟังก์ชัน scaling ใหม่ด้วยมือในขั้นตอน serving แทนที่จะใช้ออบเจ็กต์เดิมที่ผ่านการ fit มาแล้ว ความคลาดเคลื่อนเพียงเล็กน้อยอาจส่งผลให้ผลลัพธ์ผิดเพี้ยนไปมหาศาล
การรับประกันที่ดีที่สุดคือการส่งออบเจ็กต์ pipeline ที่ fitted แล้วไปใช้งานทั้งสองฝั่ง และตรวจสอบโดยใช้ข้อมูลตัวอย่าง (fixture) ชุดเดียวกันส่งผ่านทั้งสองเส้นทาง หากเอาต์พุตมีชื่อ ลำดับ หรือค่าที่ต่างกัน แสดงว่าระบบของคุณกำลังมีปัญหา
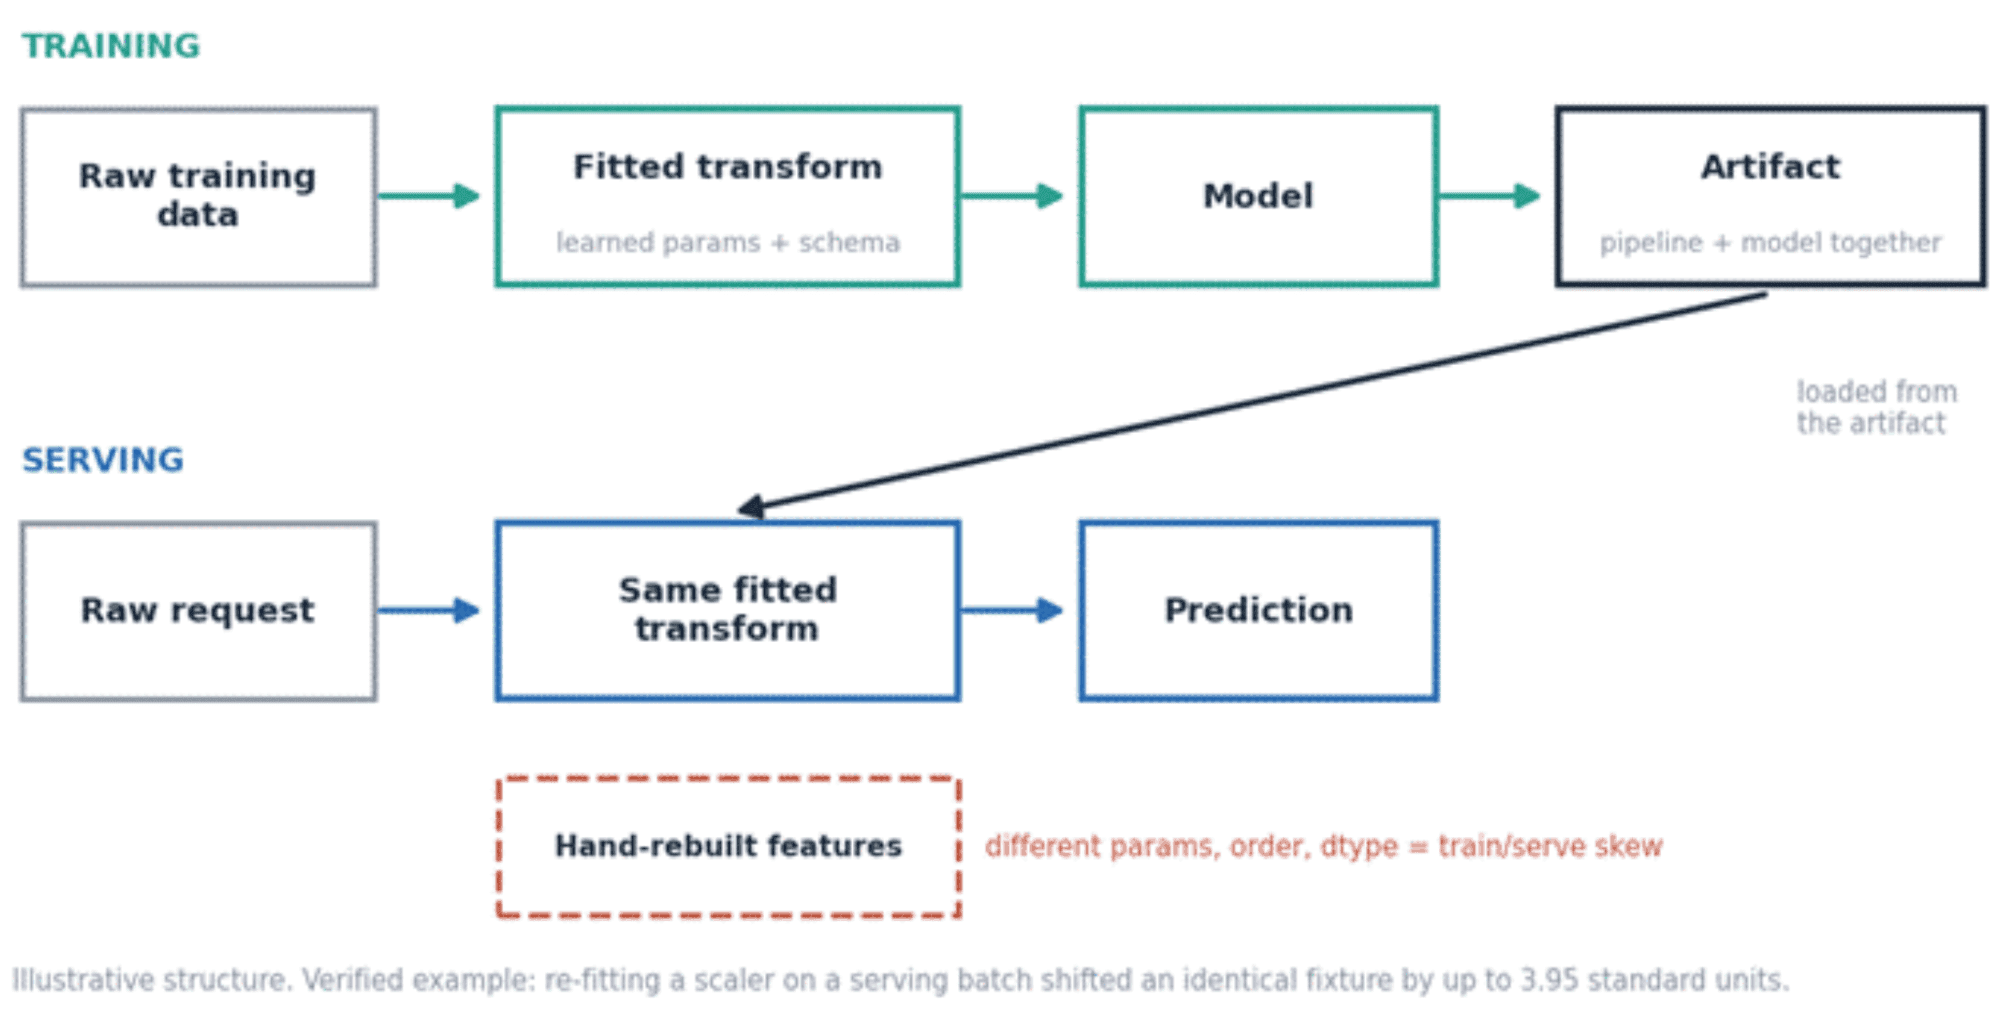
Figure 2. ตัว transform ที่ fitted แล้วต้องเดินทางไปพร้อมกับโมเดลในขั้นตอน serving มิฉะนั้นพารามิเตอร์ที่เรียนรู้มาและ feature schema จะไม่ตรงกับสิ่งที่ใช้ตอน training
4. การพึ่งพาการ Seed เพียงจุดเดียวเพื่อทำ Reproducibility
การตั้งค่า random.seed(42) เพียงอย่างเดียวไม่เพียงพอ เพราะโมดูลต่างๆ อย่าง NumPy หรือ PyTorch ต่างก็มี generator ของตัวเอง นอกจากนี้ใน บันทึกการทำ reproducibility ของ PyTorch ยังระบุว่าผลลัพธ์อาจไม่เหมือนเดิม 100% เมื่อเปลี่ยนเวอร์ชันไลบรารีหรือฮาร์ดแวร์
ดังนั้นการทำซ้ำได้ (Reproducibility) จึงเป็นเรื่องของการบันทึกข้อมูลให้ครบถ้วน ทั้งเวอร์ชันโค้ด, configuration, และ snapshot ของข้อมูล มากกว่าการหวังพึ่งแค่ตัวเลข seed เพียงอย่างเดียว ซึ่ง Weights & Biases crash course มีแนวทางในการบันทึกข้อมูลเหล่านี้แบบอัตโนมัติให้ศึกษา
5. การใช้สถานะ Evaluation สลับกับการปิด Gradient ผิดวิธี
ใน PyTorch model.eval() และ torch.no_grad() ทำหน้าที่ต่างกัน โดย eval() จะสั่งปิดการทำงานของ dropout และ batch normalization ส่วน no_grad() จะหยุดการบันทึก gradient เพื่อประหยัดหน่วยความจำ หากลืมอย่างใดอย่างหนึ่ง ผลลัพธ์ในขั้นตอน validation จะคลาดเคลื่อนหรือกินทรัพยากรเกินจำเป็น
ควรใช้ทั้งสองอย่างควบคู่กันเสมอใน loop การประเมินผล และอย่าลืมเปลี่ยนกลับเป็น training mode หลังจากนั้น:
model.eval()
with torch.no_grad():
    val_loss = criterion(model(x_val), y_val)
model.train()
อ้างอิงจาก บันทึก autograd หากต้องการประสิทธิภาพสูงสุดในขั้นตอน inference การใช้ torch.inference_mode() จะมีความปลอดภัยมากกว่า
6. การปล่อยให้ Broadcasting ซ่อนความผิดพลาดของ Tensor
Broadcasting อาจเป็นบั๊กที่มองไม่เห็นเมื่อมันไปอยู่ใน loss function เช่น หากผลการทำนายมีรูปร่างเป็น [batch, 1] แต่ target เป็น [batch] ฟังก์ชัน MSELoss จะทำการขยายเมทริกซ์ให้เท่ากันอัตโนมัติ ทำให้ได้ค่า loss ที่ดูปกติแต่มาจากการคำนวณที่ผิดพลาด
วิธีป้องกันคือการใช้ assert เพื่อตรวจสอบรูปร่างของ Tensor ให้ตรงกันก่อนการคำนวณ ดังที่ระบุในเอกสารของ MSELoss และควรระวังการขยายค่าแบบไม่ตั้งใจตามหลัก broadcasting semantics
pred = model(x).squeeze(1)      # จัดรูปร่าง Tensor ให้ถูกต้อง
assert pred.shape == target.shape
loss = criterion(pred, target)
7. การโหลดโมเดลจากแหล่งที่ไม่น่าเชื่อถือ
ไฟล์โมเดลที่ถูกบันทึกด้วย pickle, joblib หรือ cloudpickle ไม่ได้เป็นเพียงข้อมูลดิบ แต่สามารถรันโค้ดใดๆ ก็ได้ขณะโหลดไฟล์ การโหลดโมเดลจากแหล่งที่ไม่รู้จักจึงมีความเสี่ยงด้านความปลอดภัยอย่างมาก
นอกจากนี้ scikit-learn ไม่รองรับ การโหลดโมเดลข้ามเวอร์ชันของไลบรารี ดังนั้นการส่ง artifact โมเดลควรแนบข้อมูลเวอร์ชันของ dependency และสูตรการเทรนที่ใช้ไปด้วยเสมอ เพื่อให้แน่ใจว่าโมเดลจะทำงานได้อย่างถูกต้องในสภาพแวดล้อมจริง
บทสรุป: สร้าง Workflow ที่ตรวจสอบตัวเองได้
ข้อผิดพลาดเหล่านี้มักไม่แจ้งเตือนผ่าน error message การตรวจสอบอย่างสม่ำเสมอจึงเป็นสิ่งจำเป็น คุณควรตั้งคำถามเสมอว่า: ขั้นตอนนี้เรียนรู้อะไรจากข้อมูลส่วนไหน? โค้ดที่ใช้ในขั้นตอนใช้งานจริงตรงกับตอนเทรนหรือไม่? และสภาพแวดล้อมที่โหลดโมเดลมีความปลอดภัยเพียงใด? การมี metadata ที่บันทึกไว้ชัดเจนจะช่วยให้ AI workflow ของคุณมีความน่าเชื่อถือและพร้อมใช้งานจริง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร