
รีวิว Humanizer โมเดล Open-Source ที่เคลมว่าผ่านการตรวจจับ AI
คุณไม่จำเป็นต้องจ่ายค่าสมาชิกราคาแพงเพื่อรีไรท์เนื้อหาที่สร้างด้วย AI อีกต่อไป โมเดล open-source อย่าง Humanizer ช่วยให้คุณทำงานนี้ได้แบบ local โดยไม่มีค่าธรรมเนียมรายเดือน ค่าใช้จ่าย API หรือความเสี่ยงจากการส่งข้อมูลไปยังบุคคลที่สาม
โมเดลนี้กำลังได้รับความนิยมอย่างมากในชุมชน โดยมียอดดาวน์โหลดมากกว่า 143,000 ครั้ง และมีผู้กดถูกใจ 2,100 ครั้งบน Hugging Face ในช่วงต้นเดือนตุลาคม 2026 ผู้พัฒนายังอ้างว่า 95% ของร่างบทความภาษาอังกฤษ 210 ฉบับที่ถูกรีไรท์ ถูกจัดประเภทว่าเป็นงานเขียนโดยมนุษย์ผ่าน Originality.ai แม้ข้อมูลนี้จะยังไม่ได้รับการตรวจสอบอย่างเป็นอิสระก็ตาม
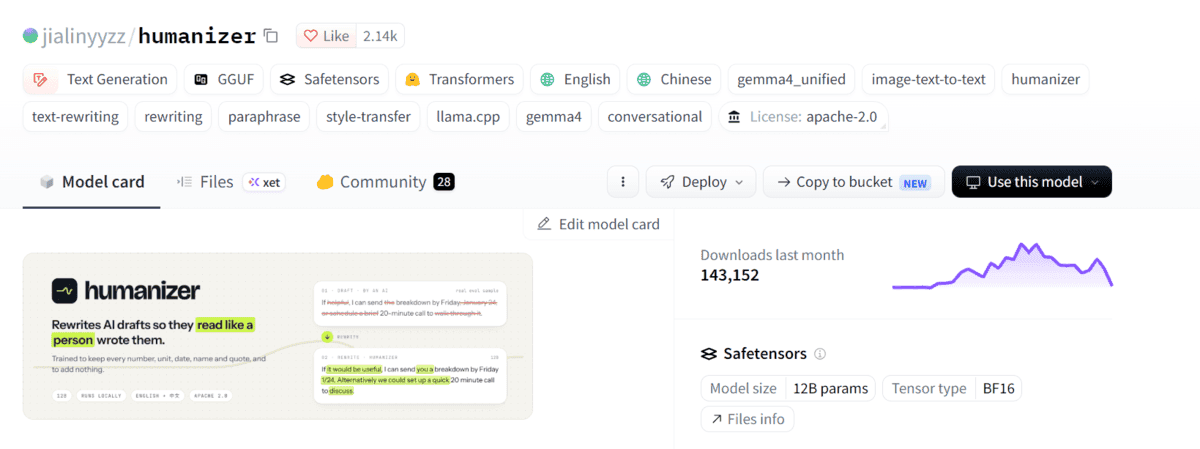
ภาพหน้าจอจาก jialinyyzz/humanizer
ในบทความนี้ เราจะดาวน์โหลดโมเดล Humanizer ขนาด 12 พันล้านพารามิเตอร์ มาเซ็ตอัปแบบ local บน Linux โดยใช้ llama.cpp ร่วมกับ NVIDIA CUDA เพื่อรีไรท์ข้อความ AI จากนั้นจะทดสอบผลลัพธ์กับเครื่องมือยอดนิยมอย่าง Originality.ai, GPTZero และ Copyleaks เพื่อดูว่าประสิทธิภาพจริงเป็นอย่างไร
ทำความรู้จักกับโมเดล Humanizer
Humanizer เป็นโมเดลที่พัฒนาต่อยอดมาจาก Gemma 4 12B ของ Google โดยถูกปรับแต่ง (fine-tuned) มาเพื่อเปลี่ยนเนื้อหาจาก AI ให้เป็นธรรมชาติเหมือนมนุษย์มากขึ้น โดยยังคงความหมาย ข้อเท็จจริง และรายละเอียดสำคัญไว้อย่างครบถ้วน
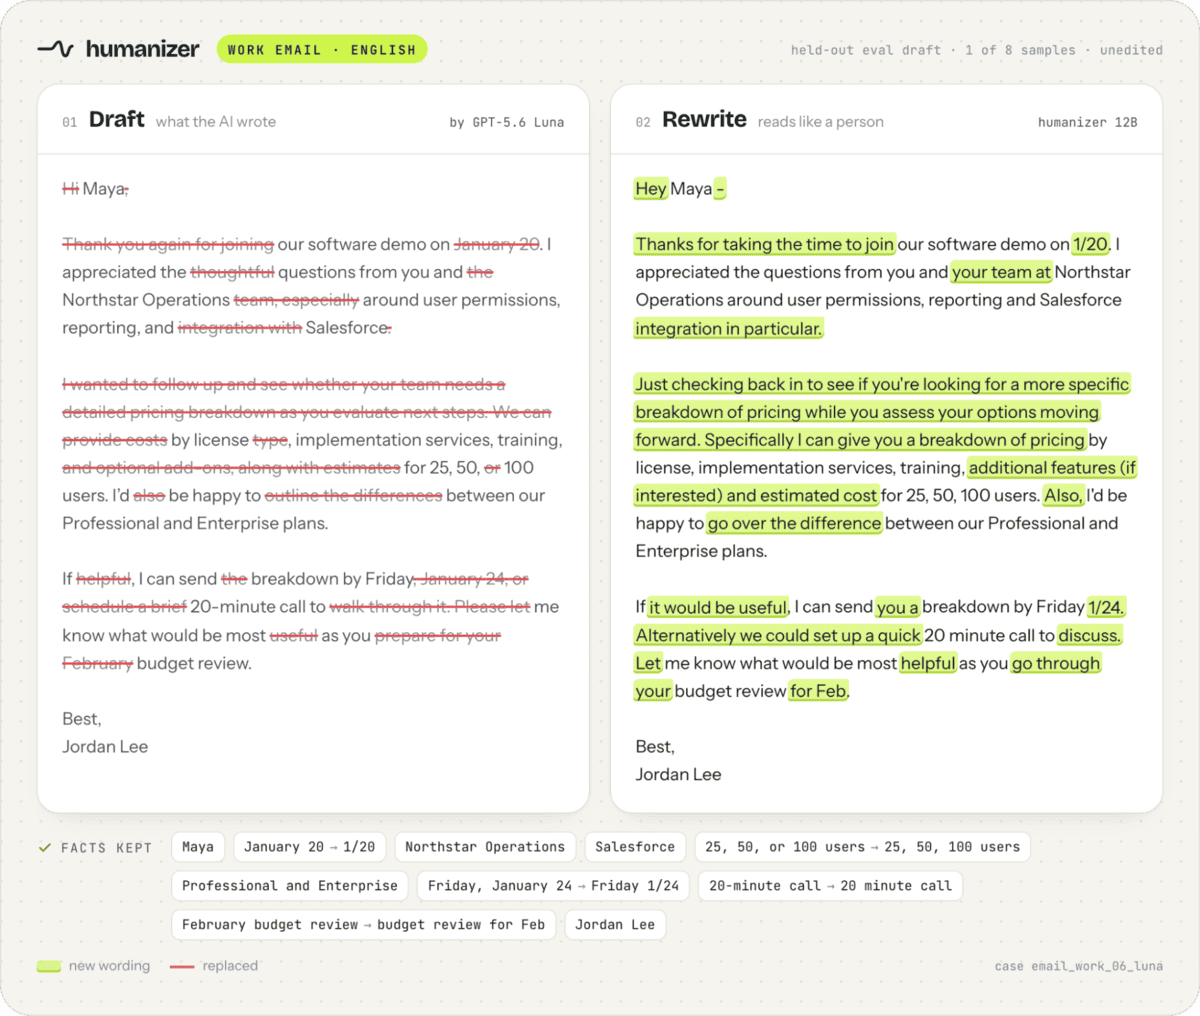
รูปภาพจาก jialinyyzz/humanizer · Hugging Face
โมเดลนี้ผ่านการฝึกฝนด้วยชุดข้อมูลเปรียบเทียบระหว่าง AI และมนุษย์จำนวน 28,598 คู่ จากแหล่งข้อมูลที่หลากหลาย เช่น เอกสารวิชาการ รายงานรัฐบาล Reddit และ Hacker News โดยใช้เทคนิค supervised fine-tuning ตามด้วย Direct Preference Optimization (DPO) และ Group Relative Policy Optimization (GRPO) โดยมี LLM ทำหน้าที่เป็นผู้ตัดสินความถูกต้องของเนื้อหา
กระบวนการรีไรท์จะมุ่งเน้นการปรับปรุงการเลือกใช้คำ โครงสร้างประโยค และการลบแพทเทิร์นซ้ำซากที่เป็นสไตล์ของ AI โดยที่ผู้พัฒนาไม่ได้ใช้เครื่องมือตรวจจับ AI ในระหว่างการฝึกฝน แต่เน้นไปที่คุณภาพการเขียนและความถูกต้องของข้อเท็จจริงเป็นหลัก
จากข้อมูลของผู้พัฒนาพบว่า 95% ของบทความที่ผ่านการรีไรท์ถูกระบุว่าเป็นมนุษย์โดย Originality.ai ขณะที่เวอร์ชัน quantized Q8_0 ทำได้ที่ 93% อย่างไรก็ตาม ผลลัพธ์อาจแตกต่างกันไปตามเครื่องมือตรวจจับและอาจมีข้อผิดพลาดด้านข้อเท็จจริงเกิดขึ้นได้
สำหรับผู้ที่ต้องการใช้งานง่ายๆ สามารถดาวน์โหลด แอปพลิเคชันสำหรับ Windows และ macOS เพื่อรันแบบออฟไลน์ได้ทันที ส่วนสายพัฒนา โมเดลนี้รองรับทั้ง llama.cpp, Ollama, Transformers, MLX และ vLLM
1. ติดตั้ง llama-server พร้อม CUDA
เราจะใช้ llama-server ในการรันโมเดลผ่าน local HTTP API โดยจะบิลด์ llama.cpp ร่วมกับการเร่งความเร็วด้วย GPU NVIDIA เพื่อให้ประมวลผลได้รวดเร็วขึ้น
เริ่มด้วยการโคลน repository และบิลด์ server:
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build -DGGML_CUDA=ON
cmake --build build --config Release --target llama-server -j
ตรวจสอบความถูกต้องหลังบิลด์:
./build/bin/llama-server --version2. ดาวน์โหลดและรัน Humanizer
เราจะใช้เวอร์ชัน 8-bit quantized (Q8_0) ซึ่งให้ความสมดุลระหว่างคุณภาพและการใช้ทรัพยากรเครื่องได้ดีที่สุด
ติดตั้ง Hugging Face CLI และดาวน์โหลดโมเดล:
pip install -U huggingface_hub
hf download jialinyyzz/humanizer \
  humanizer-12b-Q8_0.gguf prompt_format.json \
  --local-dir ./humanizer-model
หมายเหตุ: หาก VRAM ของ GPU ไม่พอ สามารถสลับไปใช้เวอร์ชัน humanizer-12b-Q6_K.gguf แทนได้
สั่งรัน server ด้วยคำสั่ง:
./build/bin/llama-server \
  -m ./humanizer-model/humanizer-12b-Q8_0.gguf \
  -c 8192 \
  -np 1 \
  -ngl 99 \
  -fa on \
  -b 2048 \
  -ub 512 \
  -t 8 \
  --host 127.0.0.1 \
  --port 8910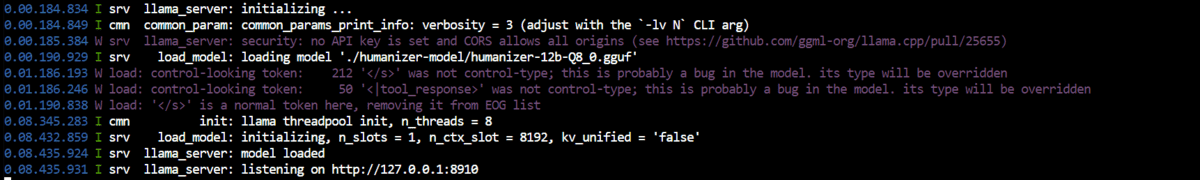
เมื่อ server พร้อมใช้งาน (ตรวจสอบผ่านพอร์ต 8910) เราก็เริ่มทดสอบรีไรท์ข้อความได้ทันที
3. รีไรท์ข้อความที่สร้างโดย AI
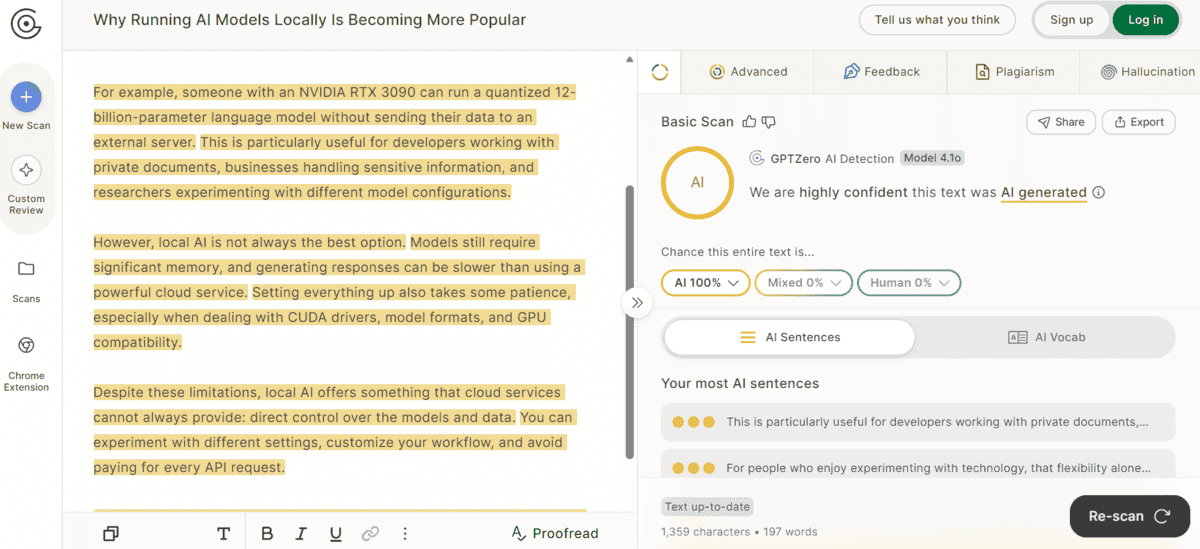
เราได้เตรียมบทความที่เขียนโดย AI ความยาว 200 คำ ซึ่ง GPTZero ตรวจจับว่าเป็น AI 100% ไว้ในไฟล์ draft.txt จากนั้นใช้สคริปต์ Python เพื่อส่งข้อมูลไปยัง API ของเรา
สร้างไฟล์ humanize.py ดังนี้:
import json
import urllib.request

# Load prompt and article
pf = json.load(open("humanizer-model/prompt_format.json"))
draft = open("draft.txt").read().strip()

# Model settings
body = {
    "prompt": pf["instr"] + "\n\n" + draft + pf["sep"],
    "temperature": 1.0,
    "top_p": 0.95,
    "top_k": 0,
    "min_p": 0,
    "repeat_penalty": 1.0,
    "n_predict": 2048,
    "seed": -1,
}

# Generate humanized text
req = urllib.request.Request(
    "http://127.0.0.1:8910/completion",
    json.dumps(body).encode(),
    {"Content-Type": "application/json"},
)

with urllib.request.urlopen(req, timeout=600) as response:
    result = json.load(response)["content"].strip()

# Save output
with open("humanized.txt", "w") as f:
    f.write(result)

print(result)
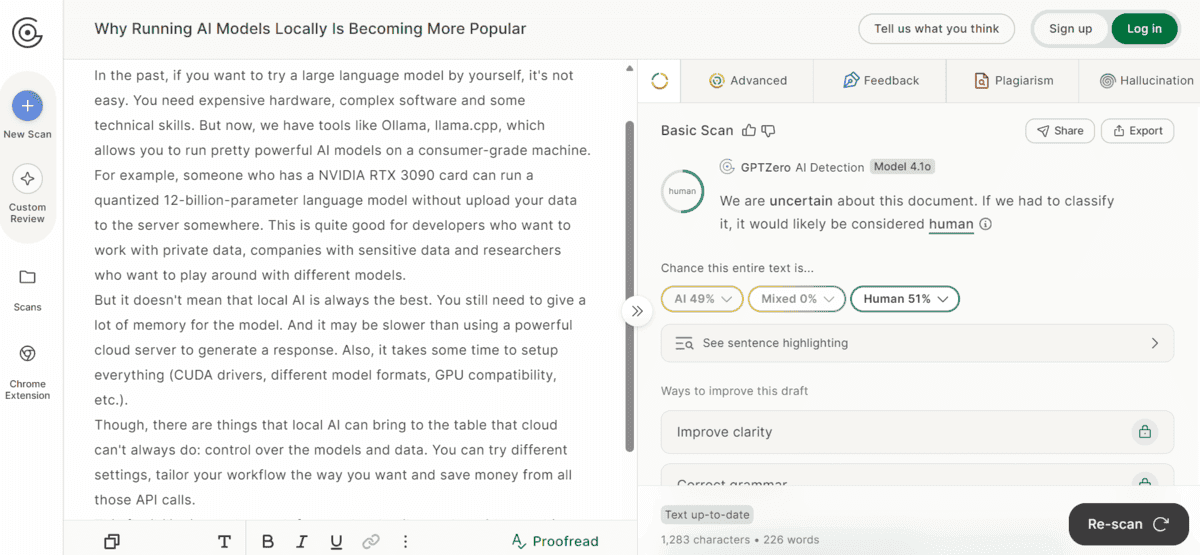
หลังจากรันสคริปต์ ผลลัพธ์ที่ได้น่าสนใจมาก คะแนนการตรวจจับ AI ใน GPTZero ลดลงจาก 100% เหลือเพียง 49% ซึ่งแสดงให้เห็นว่าโมเดลสามารถพรางเนื้อหาให้ดูเหมือนมนุษย์เขียนได้จริงในระดับหนึ่ง
ความคิดเห็นทิ้งท้าย
จากการทดสอบพบว่า Humanizer ให้ผลลัพธ์ที่ไม่สม่ำเสมอนัก บางครั้งก็ผ่านเครื่องมือตรวจจับได้อย่างราบรื่น แต่บางครั้งก็ยังถูกระบุว่าเป็น AI อยู่ ซึ่งมีโอกาสสำเร็จประมาณ 50-50 แม้จะใช้การตั้งค่าตามที่ผู้พัฒนาแนะนำทุกประการ
อย่างไรก็ตาม ต้องไม่ลืมว่าเครื่องมือตรวจจับ AI เองก็อาจเกิดข้อผิดพลาด (false positives) ได้เช่นกัน การจะตัดสินประสิทธิภาพของ Humanizer จากคะแนนเหล่านี้เพียงอย่างเดียวจึงทำได้ยาก โดยรวมแล้ว Humanizer เป็นทางเลือก open-source ที่น่าสนใจสำหรับผู้ที่ต้องการรันระบบเองแบบ local เพื่อความเป็นส่วนตัวและประหยัดค่าใช้จ่าย แนะนำให้ผู้ใช้ตรวจสอบความถูกต้องของเนื้อหาหลังรีไรท์เสมอ และไม่ควรพึ่งพาคะแนนจากเครื่องมือตรวจจับมากจนเกินไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร