
คู่มือเลือก Local LM รุ่นไหนเก่งงานด้านไหน สรุปชัดจบในที่เดียว
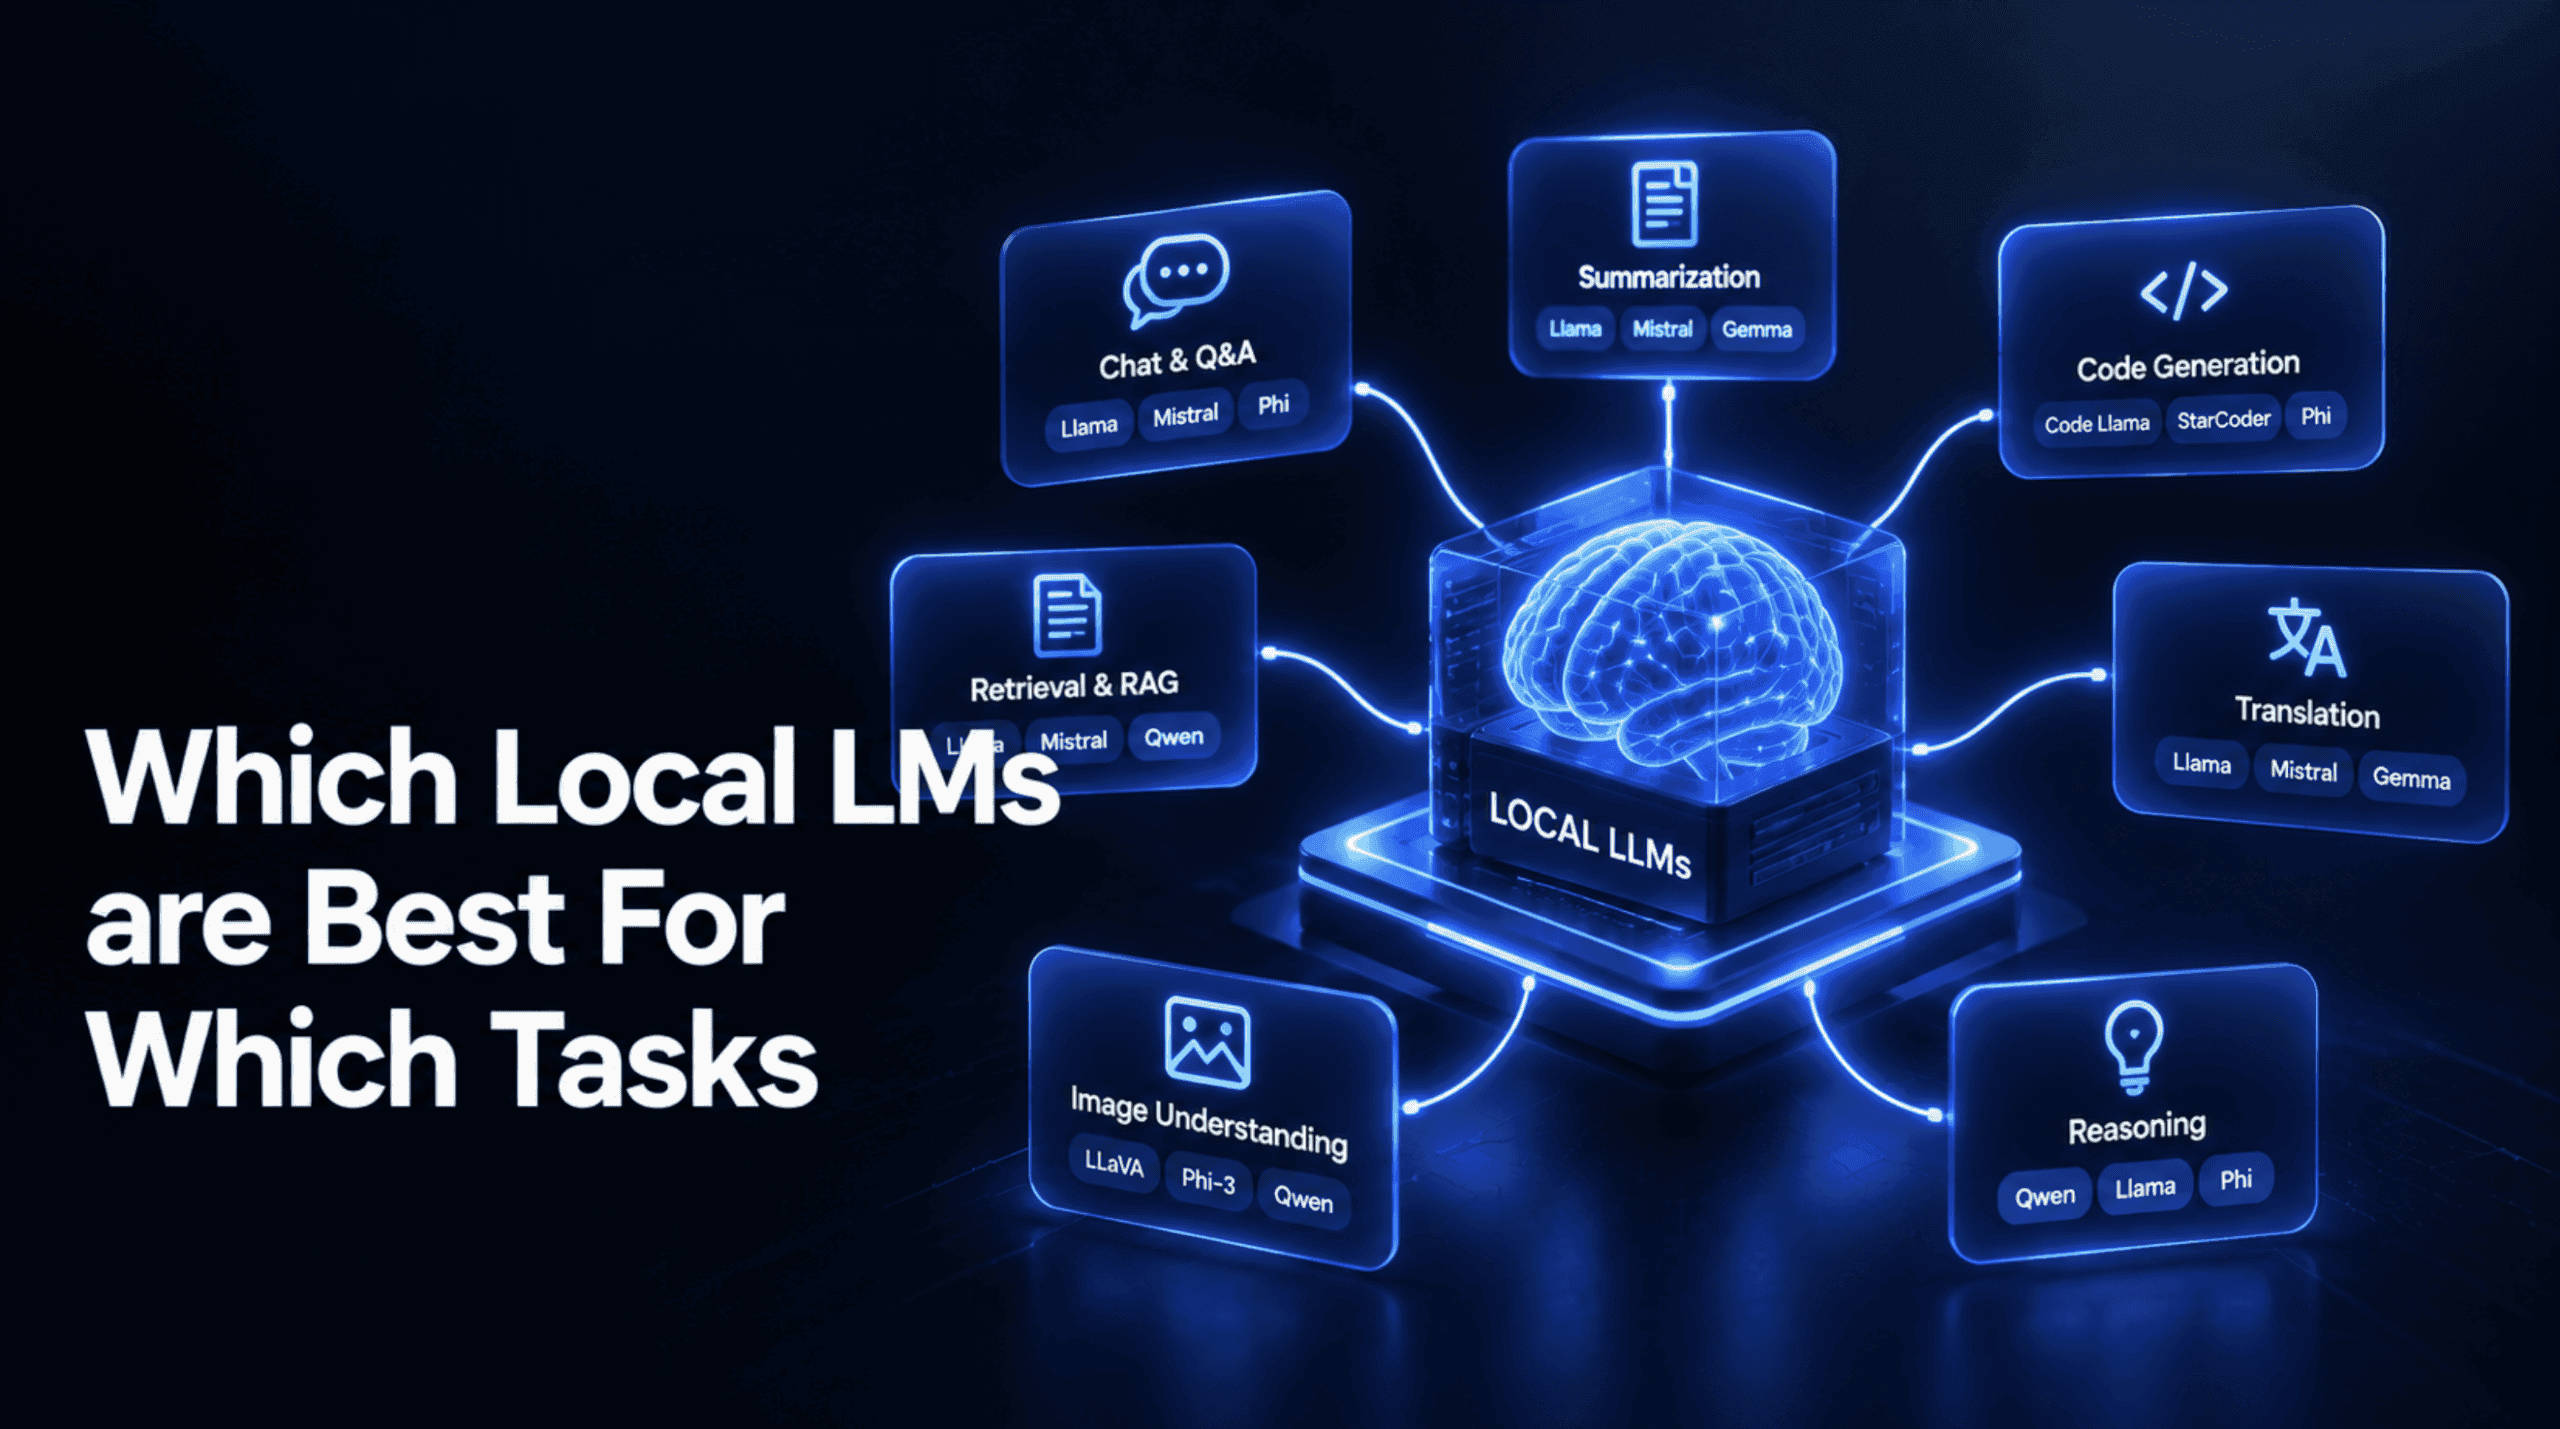
หลายคนอาจเสียเวลาอ่านสรุป "best local LLM" แล้วเลือกดาวน์โหลดตัวที่อยู่อันดับสูงสุดมาใช้งานจริง เช่น การจัดระเบียบสคริปต์ Python แต่ผลลัพธ์กลับออกมาแค่ระดับปานกลาง นั่นไม่ใช่เพราะโมเดลนั้นแย่ แต่เป็นเพราะโมเดลสายทั่วไป (generalist) มักทำได้ไม่ดีเท่านักเฉพาะทาง (specialist) และบทสรุปส่วนใหญ่มักไม่ได้ระบุจุดเด่นที่แท้จริงเอาไว้
ความไม่สอดคล้องกันนี้คือเหตุผลที่คู่มือนี้ถูกสร้างขึ้นมา คำว่า "ดีที่สุด" ไม่ใช่การจัดอันดับเพียงหนึ่งเดียว บทความนี้จะอธิบายว่าจริงๆ แล้ว local language model คืออะไร ทำไมการรันบนเครื่องตัวเองถึงคุ้มค่า และวิเคราะห์ทีละโมเดลพร้อมหลักฐานอ้างอิง เพื่อตอบคำถามสำคัญว่า สำหรับงานที่อยู่ตรงหน้า คุณควรเลือกใช้โมเดลตัวไหนกันแน่
Language Model คืออะไร และอะไรที่ทำให้มันเป็น "Local"? โดยเนื้อแท้แล้ว Language model คือระบบที่ถูกฝึกมาเพื่อพยากรณ์ข้อความ โดยพิจารณาจากบริบทก่อนหน้าว่าชิ้นส่วนข้อความถัดไปที่น่าจะเป็นไปได้มากที่สุดคืออะไร กลไกนี้เมื่อขยายสเกลให้ใหญ่ขึ้น จะทำให้โมเดลสามารถตอบคำถาม เขียนโค้ด หรือสรุปเอกสารได้ ซึ่งเป็นพื้นฐานของทั้ง ChatGPT, Claude และ Gemini
คำว่า "Local" อธิบายถึงวิธีการเข้าถึงโมเดล local language model คือการที่คุณดาวน์โหลด weights หรือไฟล์ตัวเลขขนาดมหาศาลที่ผ่านการฝึกฝนแล้ว มารันบนฮาร์ดแวร์ของคุณเองทั้งหมด โดยไม่มีการเรียกใช้ API ออกนอกเครื่อง ไม่ต้องมีบัญชีผู้ใช้ และไม่มีเซิร์ฟเวอร์ของบริษัทใดเห็น prompt ของคุณ ช่วยให้คุณครอบครองเทคโนโลยีนี้ได้อย่างแท้จริง
ทำไม Local Language Models ถึงสำคัญจริงๆ
- Privacy: ข้อมูลจะไม่หลุดออกจากอุปกรณ์ของคุณ ป้องกันการถูกนำไปเทรนต่อหรือข้อมูลรั่วไหล ซึ่งสำคัญมากสำหรับงานด้านการแพทย์หรืองานภายในบริษัท
- Cost: เมื่อมี weights ในเครื่องแล้ว ก็จะไม่มีค่าใช้จ่ายต่อ token ตามการใช้งาน ช่วยประหยัดต้นทุนสำหรับงานปริมาณมาก
- Offline capability: ใช้งานได้แม้ในพื้นที่ที่ไม่มีอินเทอร์เน็ต หรือสภาพแวดล้อมที่ต้องตัดการเชื่อมต่อภายนอก (air-gapped)
- Control: คุณเป็นเจ้าของ weights เอง โมเดลจะไม่ถูกแอบอัปเดตหรือเปลี่ยนพฤติกรรมโดยผู้ให้บริการ
Ollama กลายเป็นมาตรฐานหลักในการรันโมเดลแบบ local โดยมีคลังสาธารณะสำหรับบิลด์ GGUF ที่พร้อมใช้งานสำหรับทุกโมเดลในบทความนี้ ซึ่งบางตัวมียอดดาวน์โหลดสูงถึงหลายสิบล้านครั้ง
ทำไมคำว่า "ดีที่สุด" ถึงขึ้นอยู่กับงาน ไม่ใช่กระดานผู้นำ
คะแนน benchmark รวมเพียงตัวเดียวบอกความสามารถเฉพาะทางได้น้อยมาก โมเดลที่รู้ความรู้ทั่วไปดีอาจเขียนโค้ดได้แย่ การยึดติดกับอันดับหนึ่งเพียงอย่างเดียวจึงมักนำไปสู่ความผิดหวัง
การเข้าใจตัวชี้วัดจึงสำคัญ: Massive Multitask Language Understanding (MMLU) ใช้วัดความรู้ทั่วไป, HumanEval ใช้วัดความสามารถในการเขียนโค้ดที่ใช้งานได้จริง และ MT-Bench วัดความสามารถในการโต้ตอบและทำตามคำสั่ง ซึ่งแต่ละโมเดลจะมีจุดเด่นในด้านเหล่านี้แตกต่างกันไป
เจาะลึกแต่ละโมเดล
บทความนี้ครอบคลุม 7 โมเดล แบ่งเป็นโมเดลแชททั่วไป 6 ตัว และ embedding model 1 ตัว สำหรับระบบ retrieval-augmented generation (RAG) โดยข้อมูลทั้งหมดได้รับการตรวจสอบจาก model card ทางการหรือ benchmark อิสระ
1. Phi-4-mini
Phi-4-mini จาก Microsoft พิสูจน์ว่าโมเดลจิ๋วก็เก่งได้ ด้วยคะแนน MMLU 67.3 และ BigBench-Hard 70.4 แม้จะมีขนาดเพียง 1 ใน 5 ของคู่แข่งระดับ 20B
จากการศึกษาในปี 2026 การศึกษาความสามารถในการใช้เหตุผลข้ามแพลตฟอร์ม พบว่า Phi-4-mini นำหน้าในด้านความแม่นยำของการใช้เหตุผลแบบเป็นขั้นตอน (step-by-step reasoning) อย่างมีนัยสำคัญ
สิ่งที่เก่งเป็นพิเศษ:
- การตอบคำถามทั่วไปแบบใช้ทรัพยากรน้อย
- Structured output และ function calling
- เหมาะกับฮาร์ดแวร์จำกัดแต่ต้องการงานที่ซับซ้อน
2. Gemma 4 E2B และ E4B
Gemma 4 จาก Google DeepMind เปิดตัวเมื่อวันที่ 2 เมษายน 2026 ตามที่ระบุใน model card ของ Google เอง รุ่นย่อย E2B และ E4B เป็นรุ่น multimodal โดยกำเนิด รองรับทั้งข้อความ รูปภาพ และเสียง พร้อม context window 128K
สิ่งที่เก่งเป็นพิเศษ:
- งานเขียนและงานเอกสารที่ต้องการความชัดเจน
- การใช้งานระดับ edge บนมือถือหรืออุปกรณ์ทรัพยากรจำกัดมาก
3. Qwen2.5-7B-Instruct และ Qwen2.5-Coder-7B-Instruct
Qwen2.5-7B-Instruct ให้ผลลัพธ์ที่แข็งแกร่งทั้งความรู้ทั่วไปและการเขียนโค้ด ส่วนรุ่นเฉพาะทางอย่าง Qwen2.5-Coder-7B-Instruct ทำคะแนน HumanEval ได้สูงถึง 88.4 ตามการประเมินอิสระ
สิ่งที่เก่งเป็นพิเศษ:
- การช่วยเหลือด้านการเขียนโค้ด (รุ่น Coder)
- งานหลายภาษา (Multilingual) ที่ทำได้ดีกว่าตระกูล Llama
4. Qwen3.5-9B
รุ่นใหม่ล่าสุดบน Hugging Face ที่เป็น multimodal โดยกำเนิด มี context window 262K ใช้สถาปัตยกรรม Mixture-of-Experts บนลิขสิทธิ์ Apache 2.0 ที่นำไปใช้งานเชิงพาณิชย์ได้
สิ่งที่เก่งเป็นพิเศษ:
- เวิร์กโฟลว์แบบ Agentic และ tool calling
- เป็นโมเดลสายทั่วไปที่เก่งที่สุดในระดับขนาดเดียวกัน
5. Mistral 7B
Mistral 7B ยังคงเป็นโมเดลพื้นฐานยอดนิยมใน Hugging Face จุดเด่นคือความน่าเชื่อถือในการทำตามคำสั่ง (instruction-following) ที่ชัดเจน
สิ่งที่เก่งเป็นพิเศษ:
- การแชททั่วไป การเขียน commit messages และไฟล์ README ที่เน้นความสม่ำเสมอ
6. Llama 3.1 8B
อ้างอิงจาก model card ของ Meta รุ่น 3.1 8B ยังคงเป็นรุ่นปัจจุบันสำหรับขนาดนี้ (เนื่องจากรุ่น 3.3 มีเฉพาะขนาด 70B เท่านั้น)
สิ่งที่เก่งเป็นพิเศษ:
- การ fine-tune โดยชุมชนที่มีขนาดใหญ่ที่สุด เหมาะกับการหางานเฉพาะทาง เช่น กฎหมาย หรือภาษาเขียนโค้ดเฉพาะ
7. nomic-embed-text: Nomic AI, Apache 2.0
นี่คือโมเดล embedding ที่สำคัญมากสำหรับระบบ local RAG จาก การเปรียบเทียบ benchmark เมื่อเดือนมิถุนายน 2026 บน Ollama พบว่า nomic-embed-text มีขนาดไม่ถึง 300MB แต่มียอดดาวน์โหลดสูงถึง 85.6 ล้านครั้ง
สิ่งที่เก่งเป็นพิเศษ:
- การทำ embedding และ semantic search ในระบบ RAG
- ทำงานควบคู่กับโมเดลแชทตัวอื่นๆ ได้อย่างมีประสิทธิภาพ
ตารางสรุป
| หากคุณต้องการ | ใช้โมเดลนี้ | ทำไม | VRAM โดยประมาณที่ Q4 |
|---|---|---|---|
| รันโมเดลเก่งๆ บนฮาร์ดแวร์จำกัด | Phi-4-mini | ความสามารถต่อกิกะไบต์ดีที่สุด, ใช้เหตุผลสม่ำเสมอ | ~2.5GB |
| เขียนเอกสาร/อีเมล ที่ฝั่ง edge | Gemma 4 E2B / E4B | Multimodal โดยกำเนิด, รันบนอุปกรณ์จิ๋วได้จริง | ~1.5-3GB |
| ช่วยเขียนโค้ด หรือเน้นหลายภาษา | Qwen2.5-Coder-7B / Qwen2.5-7B-Instruct | HumanEval สูง, ข้อมูลหลายภาษาแข็งแกร่ง | ~5-6GB |
| สร้าง Agent เรียกใช้เครื่องมือต่างๆ | Qwen3.5-9B | สถาปัตยกรรมออกแบบมาเพื่อ agentic tool | ~6.5GB |
| งานเขียนทั่วไปที่สะอาดและน่าเชื่อถือ | Mistral 7B | ทำตามคำสั่งได้สม่ำเสมอตั้งแต่เริ่มต้น | ~5GB |
| หาโมเดลเฉพาะทางที่ชุมชนปรับแต่งไว้ | Llama 3.1 8B | มีระบบนิเวศการ fine-tune ใหญ่ที่สุด | ~6GB |
| ขับเคลื่อนระบบค้นหาข้อมูล local RAG | nomic-embed-text | ขนาดเล็กมาก, ใช้งานแพร่หลายที่สุด | ~0.3GB |
| เลือกตัวเดียวเมื่อไม่แน่ใจว่าจะทำอะไร | Qwen3.5-9B | Generalist ที่แข็งแกร่งที่สุดในรุ่นขนาดนี้ | ~6.5GB |
โมเดลทั้งหมดมีในรูปแบบ GGUF ผ่าน Ollama เพียงสั่ง ollama pull <ชื่อโมเดล> ก็ใช้งานได้ทันที
บทสรุป
คำถามสำคัญไม่ใช่ว่าโมเดลไหนดีที่สุด แต่คือ "คุณกำลังจะทำอะไร?" การเลือกโมเดลให้เหมาะกับเนื้องาน ไม่ว่าจะเป็นการแก้บัคโค้ดหรือการสรุปเอกสาร จะช่วยให้คุณได้ประสิทธิภาพสูงสุดโดยไม่ต้องพบกับความผิดหวังเหมือนการเลือกใช้โมเดลตามอันดับเพียงอย่างเดียว
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร