
เบื้องหลังความสำเร็จ Deep Agent: 4 กลไกการจัดการบริบทเพื่อแก้ปัญหา Context Overflow และ Goal Loss
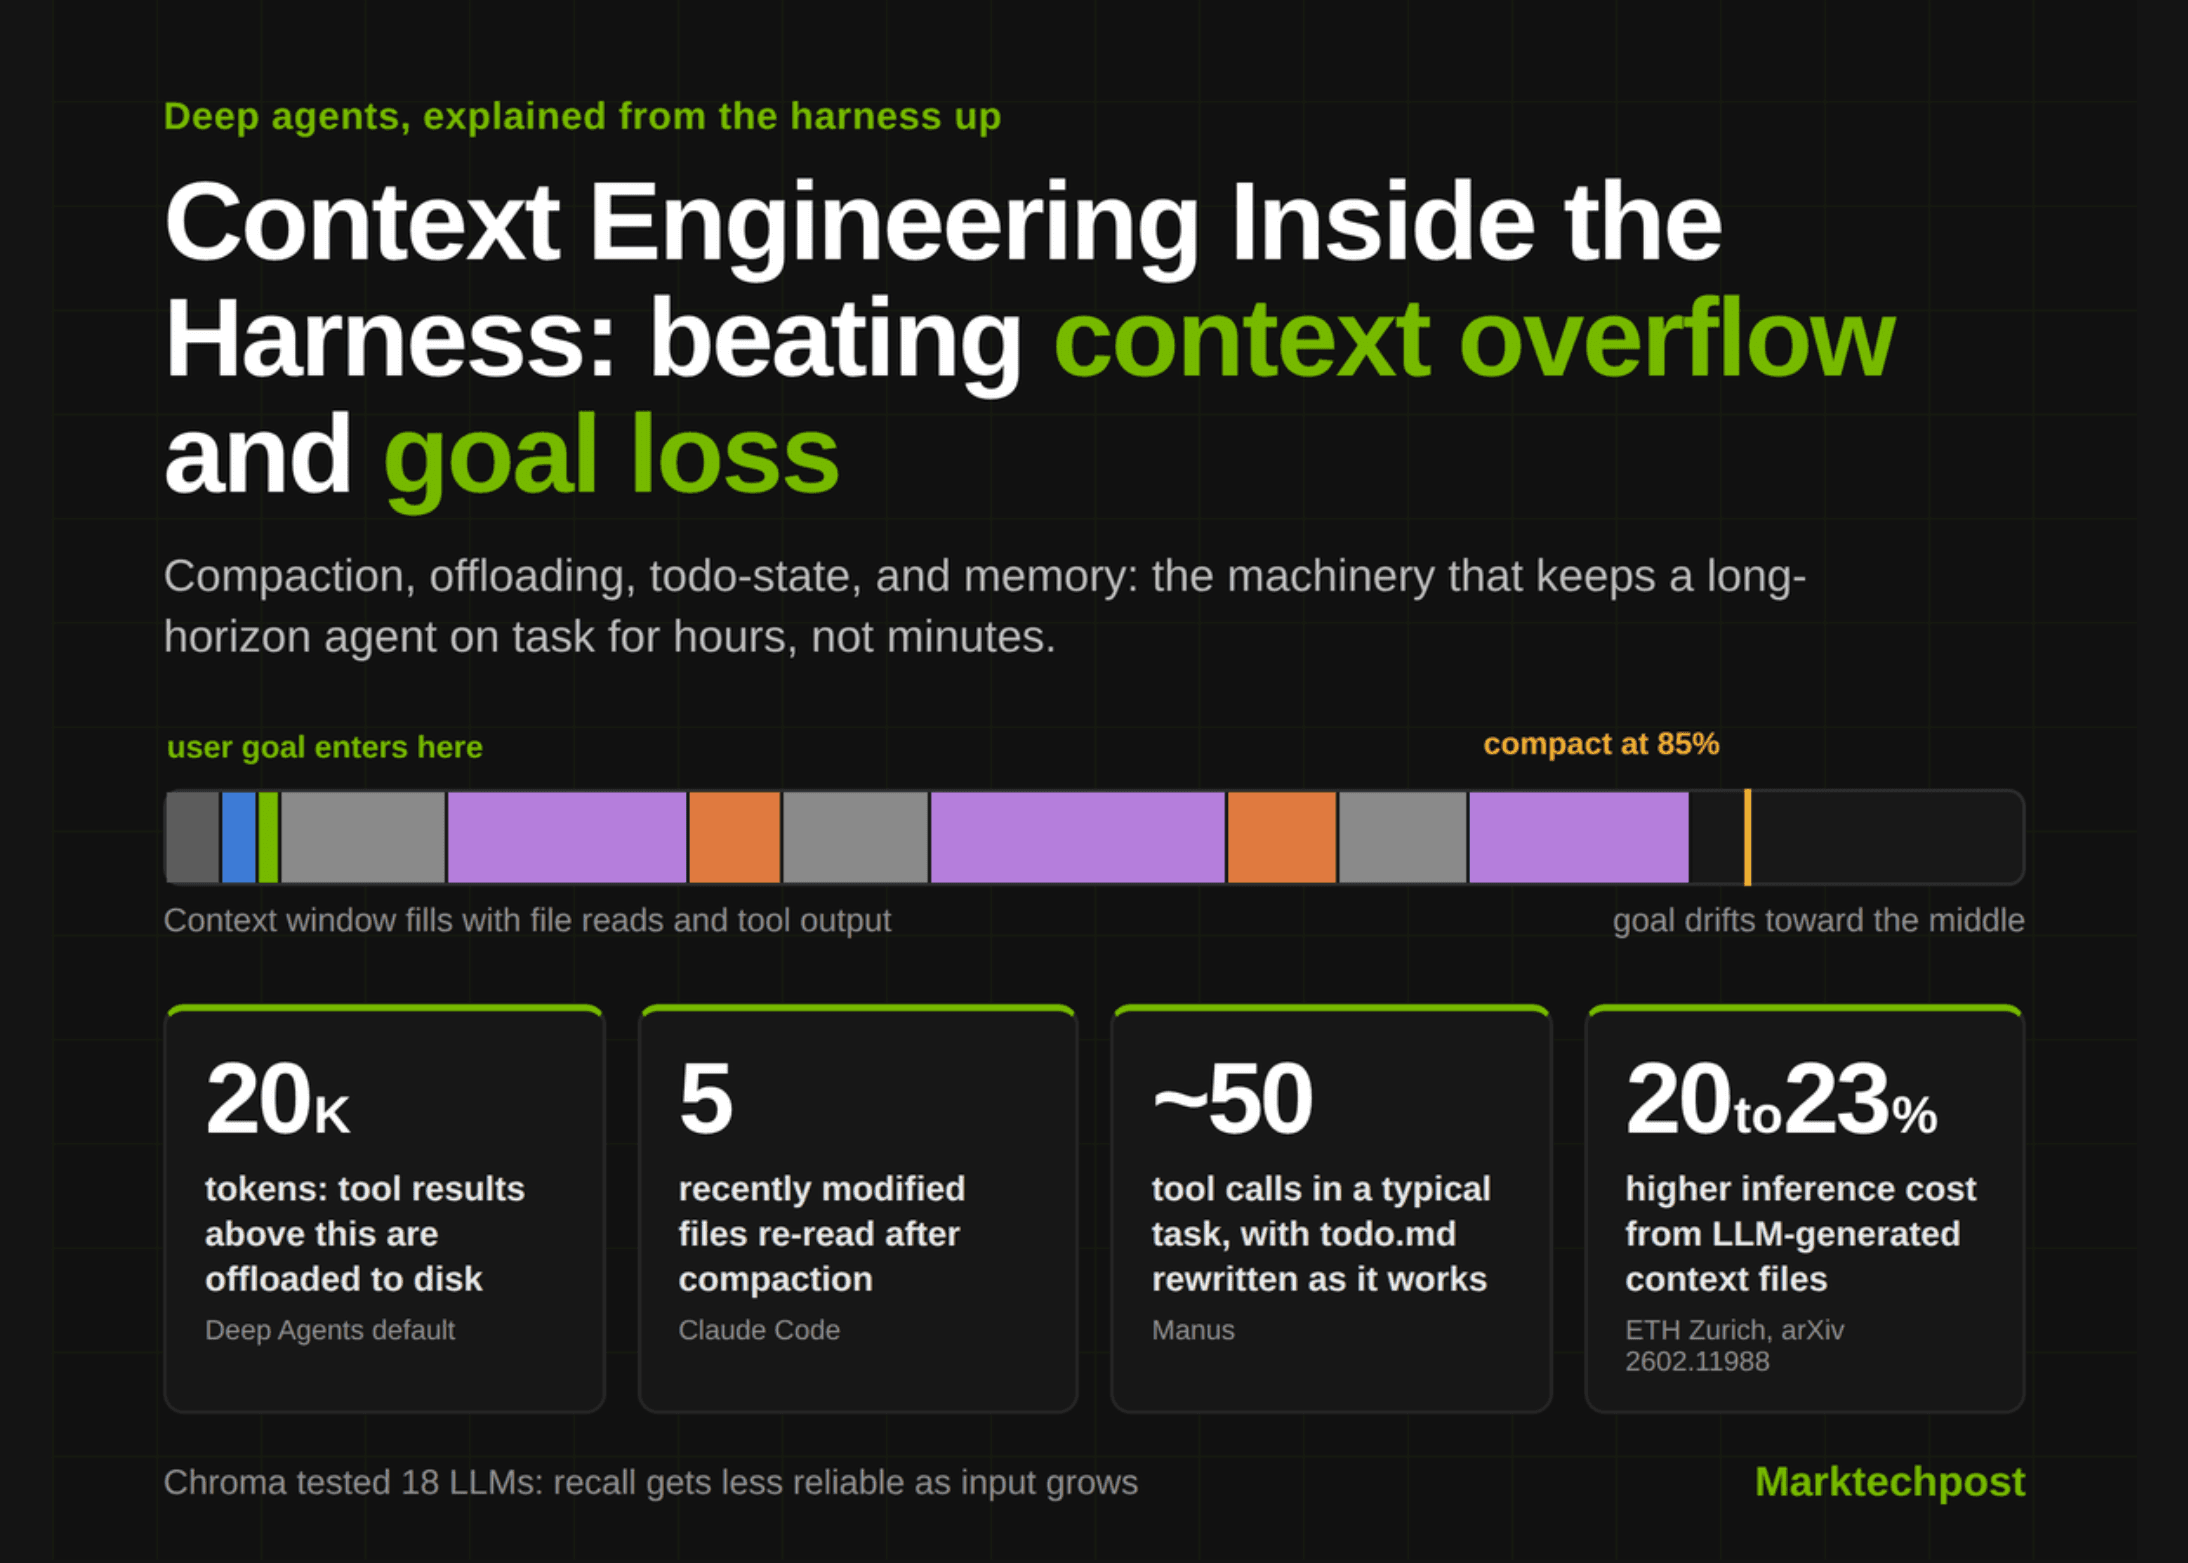
เอเจนต์ (Agent) ในรูปแบบที่เรียบง่ายที่สุดคือ LLM ที่เรียกใช้เครื่องมือซ้ำไปมาในลูป ซึ่งมักจะทำงานได้ดีสำหรับภารกิจระยะสั้น แต่หากต้องรับมือกับงานที่รันนานหลายชั่วโมงหรือมีการเรียกใช้เครื่องมือมากกว่า 200 ครั้ง ระบบมักจะล้มเหลวใน 2 รูปแบบหลัก
ตามข้อมูลจาก คู่มือการออกแบบ AWS Samples สำหรับเอเจนต์เขียนโค้ดบนคลาวด์อัตโนมัติ ระบุว่า "Shallow Agents" มักประสบปัญหาบริบทล้น (Context Overflow) สมาธิหลุดจากเป้าหมาย (Goal Loss) และไม่สามารถคงสถานะ (State) ไว้ได้ในระยะยาว ชั้นเลเยอร์ที่เข้ามาแก้ปัญหานี้ไม่ใช่ตัวโมเดล แต่คือ "Harness" ซึ่งทำหน้าที่จัดการองค์ประกอบทุกอย่างยกเว้นตัวโมเดลนั่นเอง
บทความนี้จะพาไปดู 4 กลไกสำคัญ ได้แก่ การบดอัด (Compaction), กลยุทธ์หน่วยความจำ (Memory Strategy), การทำงบประมาณบริบท (Context Budgeting) และการจัดการสถานะสิ่งที่ต้องทำ (Todo-state) ซึ่งเป็นหัวใจสำคัญที่เปลี่ยนลูปเอเจนต์ธรรมดาให้กลายเป็น Deep Agent ผ่านตัวอย่างจาก LangChain Deep Agents, Claude Code, Manus, OpenAI Codex และ Amazon Bedrock AgentCore
ทำไมหน้าต่างบริบทที่ใหญ่ขึ้นจึงไม่ใช่คำตอบสุดท้าย
แม้การขยาย Context Window จะดูเป็นวิธีแก้ปัญหาที่ง่ายที่สุด แต่หลักฐานกลับชี้ให้เห็นว่าช่วยได้ไม่มากนัก รายงาน Context Rot ของ Chroma ที่ประเมิน LLM 18 โมเดล (รวมถึง GPT-4.1 และ Claude 4) พบว่าประสิทธิภาพจะลดลงเรื่อยๆ เมื่ออินพุตยาวขึ้น แม้จะเป็นงานดึงข้อมูลพื้นฐานก็ตาม
คู่มือวิศวกรรมบริบทของ Anthropic อธิบายว่า กลไก Attention สร้างความสัมพันธ์แบบ n² ซึ่งหมายความว่าทุกๆ Token ที่เพิ่มเข้ามาจะไปแย่งชิง "งบประมาณความสนใจ" ที่มีจำกัด บริบทจึงเปรียบเสมือนทรัพยากรที่มีผลตอบแทนลดน้อยถอยลง ไม่ใช่ถังน้ำที่จะเติมได้ไม่จำกัด
สำหรับเอเจนต์ ปัญหานี้รุนแรงกว่าปกติ Manus รายงานว่างานทั่วไปต้องเรียกใช้เครื่องมือราว 50 ครั้ง โดยมีอัตราส่วน Token อินพุตต่อเอาต์พุตเกือบ 100:1 ทำให้คำสั่งเริ่มต้นถูกเลื่อนไปอยู่ตรงกลางหน้าต่างบริบท ซึ่งเป็นจุดที่ความสามารถในการดึงข้อมูล (Recall) เสื่อมถอยลงที่สุด นำไปสู่ปัญหา Goal Loss ที่ไม่ใช่แค่บั๊ก แต่เป็นผลลัพธ์ที่คาดเดาได้หากจัดการบริบทไม่ดีพอ
กลไกที่ 1: การทำงบประมาณบริบทและการถ่ายโอนข้อมูล (Context Budgeting and Offloading)
หน้าที่แรกของ Harness คือการคัดกรองข้อมูลเข้าสู่หน้าต่างบริบท Deep Agents ใช้กฎการถ่ายโอนข้อมูล (Offloading) ที่ชัดเจน เช่น หากผลลัพธ์จากเครื่องมือเกิน 20,000 Tokens ระบบจะเขียนลงระบบไฟล์และแทนที่ด้วย File Path พร้อมพรีวิว 10 บรรทัดแรกแทน
เมื่อบริบทใช้งานเกิน 85% ของหน้าต่างโมเดล ข้อมูลการเขียนหรือแก้ไขไฟล์เก่าจะถูกตัดทอนให้เหลือเพียงตัวชี้ (Pointer) เนื่องจากมีข้อมูลตัวเต็มอยู่ในดิสก์แล้ว หากพื้นที่ยังไม่พอ Harness จึงจะถอยไปใช้วิธีสรุปความ (Summarization) ต่อไป
Claude Code ใช้แนวทางเดียวกัน โดยจำกัดหน่วยความจำอัตโนมัติที่ 200 บรรทัดแรก และจะโหลด Schema ของเครื่องมือ MCP เฉพาะเมื่อจำเป็นเท่านั้น นอกจากนี้หากไฟล์ที่อ่านซ้ำมีขนาดเกิน 5,000 Tokens ระบบจะส่งคืนเพียงข้อมูลอ้างอิงเส้นทางไฟล์ โปรแกรมจำลองหน้าต่างบริบทของ Claude Code แสดงให้เห็นว่าเอเจนต์ย่อยสามารถอ่านไฟล์ 6,100 Tokens แต่ส่งคืนสรุปให้เอเจนต์แม่เพียง 420 Tokens เท่านั้น
แนวคิดเอเจนต์ย่อยยังช่วยบริหารจัดการงบประมาณในระดับโครงสร้าง โดยเอเจนต์ย่อยแต่ละตัวจะสำรวจข้อมูลนับหมื่น Tokens แต่ส่งคืนสรุปเพียง 1,000-2,000 Tokens ซึ่ง AWS AgentCore ก็นำแนวทางนี้ไปใช้โดยสร้างเอเจนต์เบราว์เซอร์ทำงานขนานกันใน MicroVM ช่วยลดเวลาการทำงานลงได้ถึง 3 เท่าเมื่อเทียบกับการประมวลผลแบบลำดับ
กลไกที่ 2: การบดอัด (Compaction)
การบดอัดคือการนำบทสนทนาที่ใกล้เต็มหน้าต่างมาสรุปความและเริ่มบริบทใหม่ แต่มักจะเป็นจุดที่เกิด Goal Loss ได้ง่ายเพราะรายละเอียดสำคัญอาจตกหล่นระหว่างการสรุปที่สูญเสียข้อมูล (Lossy Summary) เพื่อแก้ปัญหานี้ Claude Code จะเลือกเก็บเฉพาะการตัดสินใจเชิงสถาปัตยกรรม บั๊กที่ยังค้างอยู่ และรายละเอียดการทำงาน โดยทิ้งเอาต์พุตเครื่องมือที่ซ้ำซ้อน และจะอ่านไฟล์ล่าสุด 5 ไฟล์ซ้ำทันทีหลังบดอัดเพื่อคงความสดใหม่ของข้อมูล ส่วนกฎถาวรจะถูกเก็บไว้ใน CLAUDE.md เพื่อดึงกลับมาใหม่เสมอ โดยผู้ใช้สามารถสั่งควบคุมผ่านคำสั่งอย่าง /compact ได้
Deep Agents เลือกจัดการผ่านโครงสร้างสรุปที่มีฟิลด์เฉพาะ เช่น เจตจำนงของเซสชัน (Session Intent) และขั้นตอนถัดไป เพื่อป้องกันเป้าหมายหลุดลอย นอกจากนี้ยังมีการเขียนบันทึกฉบับเต็มลงระบบไฟล์เพื่อให้กู้คืนข้อเท็จจริงผ่าน read_file ได้ในภายหลัง
ปัจจุบันการบดอัดเริ่มขยับไปอยู่ในระดับ API โดย OpenAI มีระบบ context_management ใน Responses API เพื่อจัดการการบดอัดฝั่งเซิร์ฟเวอร์ ซึ่ง Codex พึ่งพากลไกนี้ ในงานเขียนโค้ดระยะยาว เช่นเดียวกับแพลตฟอร์มของ Claude ที่เปิดตัวระบบจัดการบริบท compact_20260112 ที่ให้นักพัฒนาปรับแต่งพรอมต์การบดอัดได้เอง
กลไกที่ 3: สถานะสิ่งที่ต้องทำและการท่องจำ (Todo-state and Recitation)
ในขณะที่การบดอัดปกป้องเป้าหมายตอนสรุปความ กลไก Todo-state จะช่วยรักษาเป้าหมายในทุกๆ เทิร์น Manus ใช้วิธีให้เอเจนต์สร้างและเขียนไฟล์ todo.md ใหม่ทีละขั้นตอน การกระทำนี้เปรียบเสมือนการ "ท่องจำ" วัตถุประสงค์ซ้ำๆ เพื่อดันแผนงานให้อยู่ในจุดที่โมเดลให้ความสนใจ (Attention) ล่าสุดอยู่เสมอ
อย่างไรก็ตาม ประสิทธิภาพของ Todo-state ยังคงมีข้อโต้แย้ง โดย LangChain พบใน Deep Agents v0.7 ว่าการใช้ TodoListMiddleware ให้ผลตอบแทนดีกว่าเพียงเล็กน้อยแต่มีต้นทุนต่ำกว่าเมื่อปิดใช้งาน จึงแนะนำให้เปิดใช้เฉพาะในงานที่ซับซ้อนหรือใช้โมเดลรุ่นเล็ก
แนวคิดสำคัญคือการทำให้เป้าหมายเป็น "สิ่งประดิษฐ์ที่เปลี่ยนแปลงได้" (Mutable Artifact) แทนที่จะเป็นแค่ประวัติข้อความทั่วไป เพราะข้อความจะเก่าและถูกสรุปทิ้งไป แต่ไฟล์ที่เขียนใหม่ทุกเทิร์นจะคงความสดใหม่และรอดพ้นจากการรีเซ็ตบริบทได้
กลไกที่ 4: กลยุทธ์หน่วยความจำข้ามเซสชัน (Memory Strategy)
กลไกสุดท้ายคือการคงอยู่ของข้อมูลหลังจบงาน Claude Code จะดึงข้อมูลจาก CLAUDE.md และหน่วยความจำอัตโนมัติจากดิสก์กลับมาทุกครั้ง ขณะที่ AgentCore Memory ของ AWS จะมีกลยุทธ์การดึงข้อมูลเหตุการณ์ในพื้นหลังเพื่อให้การรันครั้งถัดไปไม่ต้องเริ่มวิจัยใหม่
แต่ความคงทนนี้มีราคาที่ต้องจ่าย การศึกษาจาก ETH Zurich ที่นำเสนอใน เดือนกุมภาพันธ์ ชี้ว่าไฟล์บริบทที่ละเอียดเกินไปอาจเพิ่มต้นทุนการประมวลผล (Inference Cost) ได้ถึง 20-23% โดยไม่ช่วยให้งานสำเร็จมากขึ้น Claude Code จึงแนะนำให้รักษาไฟล์ CLAUDE.md ให้สั้นกว่า 200 บรรทัด และโหลดเอกสารอ้างอิงเฉพาะเมื่อจำเป็นเท่านั้น
การทดสอบและประเมินผล Harness เพื่อให้มั่นใจว่า Harness จัดการเป้าหมายได้จริง LangChain ได้สร้างระบบประเมิน (Evals) ที่เน้นการตรวจสอบว่าเอเจนต์ยังทำงานต่อได้หรือไม่หลังการสรุปความกลางคัน รวมถึงการทดสอบแบบ Needle-in-a-haystack เพื่อดูว่าเอเจนต์สามารถกู้ข้อมูลที่ถูกสรุปทิ้งไปจากระบบไฟล์ได้ไหม
ความล้มเหลวที่น่ากังวลที่สุดคือ "Goal Drift" หรืออาการที่เอเจนต์ถามซ้ำซ้อนหรือด่วนสรุปว่างานเสร็จทั้งที่ยังไม่เรียบร้อย การทดสอบด้วยการบังคับให้เกิดการบดอัด (Compaction) เร็วกว่าปกติจึงเป็นวิธีเดียวที่จะทำให้นักพัฒนารู้ว่า ระบบจัดการบริบทที่ออกแบบมานั้นทำข้อมูลสำคัญหล่นหายไปหรือไม่
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร