
Contrastive-LM เปิดตัว CLM-8B โมเดล Open-Source เร็วกว่า Jev 9 เท่า
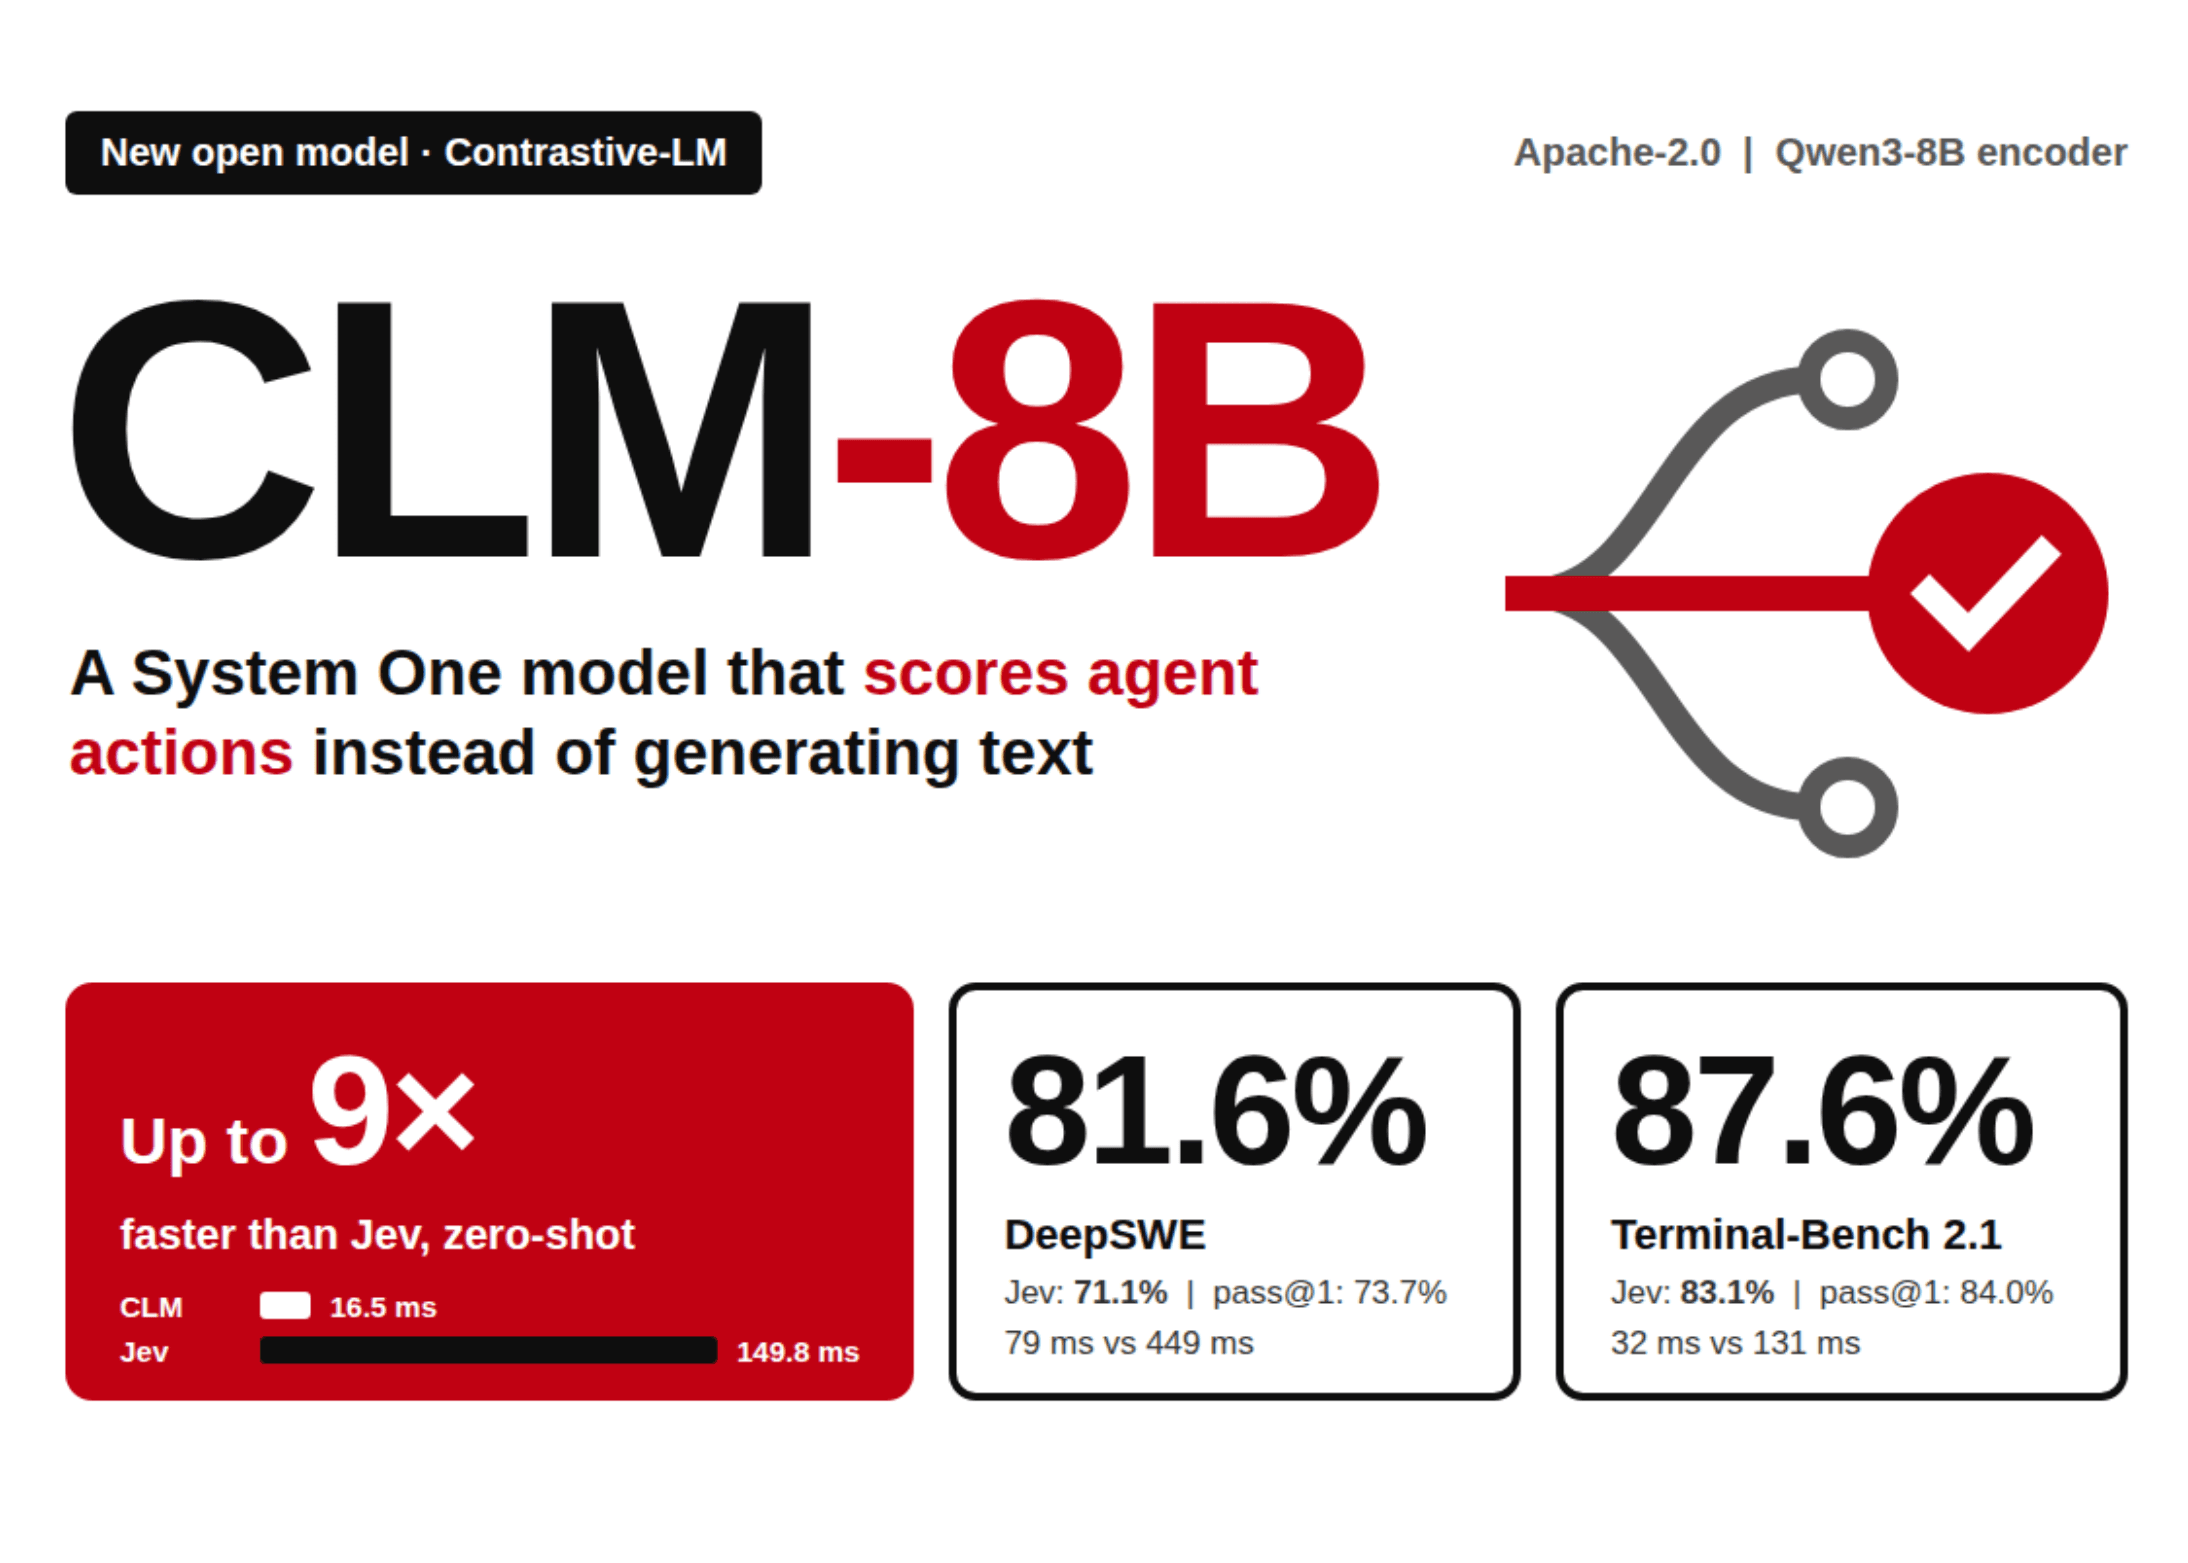
Contrastive-LM ได้เปิดตัว CLM-8B ซึ่งเป็นโมเดลตัวแรกในคลาสใหม่ที่เรียกว่า Contrastive Language Models (CLMs) ความพิเศษคือมันจะไม่สร้างข้อความ แต่จะทำหน้าที่ให้คะแนนชุดการกระทำของผู้สมัคร (candidate actions) เทียบกับสถานะปัจจุบันและส่งคืนค่าความน่าจะเป็น โดยมีคู่แข่งสำคัญคือ Jev ซึ่งเป็นโมเดล System One ที่เป็นกรรมสิทธิ์จาก TypeSafe AI
ในแง่การนำไปใช้งานจริง ผู้ใช้สามารถเข้าถึง head ภายใต้ลิขสิทธิ์ Apache-2.0 ที่มีขนาดเพียง 75 MB ทำงานบน NVIDIA GPU เพียง 1 ใบภายใต้ระบบ Linux โดยใช้ vLLM ในการรัน Qwen3-8B encoder
โมเดล System One ทำหน้าที่อะไร
Jev เริ่มเปิดให้เข้าใช้งานแบบจำกัดเมื่อช่วงปลายปี 2026 โดยเน้นการส่งคืนค่าที่ระบุประเภท (typed values) พร้อมความน่าจะเป็นแทนการตอบเป็นข้อความ ซึ่ง CLM มีเป้าหมายเดียวกัน CLM GitHub repo ให้บริการ CLM-8B ผ่าน API ที่ใช้งานร่วมกับ TypeSafe ได้ โดยรองรับคำถาม 3 รูปแบบหลัก ได้แก่:
- Noul: ส่งคืนความน่าจะเป็นที่ข้อความนั้นเป็นจริง
- Choice: เลือกตัวเลือกที่ดีที่สุดจากชุดที่กำหนดพร้อมค่าความน่าจะเป็น
- Score: ให้คะแนนตามเกณฑ์ที่กำหนด (ordered rubric)
ผู้ใช้งานสามารถนำคำขอ (request) ที่เขียนขึ้นสำหรับ API ของ TypeSafe มาประมวลผลผ่าน Python client ของ CLM ได้ทันที
CLM ทำงานอย่างไร
CLM ฝึกฝนด้วยวิธี bidirectional InfoNCE loss เพื่อจัดการ state encoder และ action encoder โดยใช้โครงสร้างหลักของ Qwen3-8B ที่ถูกแช่แข็ง (frozen) ไว้ แล้วเพิ่ม projection head ขนาด 20 ล้านพารามิเตอร์เข้าไป การฝึกฝนจะมุ่งเน้นการดึงสถานะเข้าหาการกระทำที่เกิดขึ้นจริง และผลักสถานะนั้นออกจากการกระทำอื่นๆ ที่ไม่เกี่ยวข้อง
ในขั้นตอนการอนุมาน (inference) CLM จะให้คะแนนผู้สมัครแต่ละรายผ่านการทำ dot product ของ state และ action embeddings จากนั้นจึงใช้ค่า softmax แปลงเป็นค่าความน่าจะเป็น รูปแบบนี้ช่วยให้โมเดลสามารถจัดอันดับโซลูชันแบบ best-of-N เลือกใช้เครื่องมือ (tool routing) และตัดสินใจในรูปแบบระบุประเภทได้อย่างมีประสิทธิภาพ
จุดเด่นของการออกแบบนี้คือการแยกสถานะและการกระทำออกจากกัน ในการทำงานของเอเจนต์ที่สถานะเปลี่ยนไปเรื่อยๆ แต่ชุดการกระทำยังเหมือนเดิม clm-serve จะใช้การสำรองหน่วยความจำ GPU ในลักษณะเดียวกับ KV cache ของ vLLM เพื่อนำเวกเตอร์มาใช้ใหม่ บน RTX 4090 การทำงานจะเร็วขึ้นจาก 1.7 ms เหลือเพียง 0.6 ms และเมื่อมีตัวเลือกประมาณ 1,000 ราย CLM จะทำงานเร็วกว่า Jev ถึง 13 เท่า
สูตรการฝึกฝน 3 ขั้นตอน
- Pre-training: ฝึกบนคู่คำถาม-คำตอบ Nemotron DQA 60 ล้านคู่
- Mid-training: ฝึกบน synthetic hard negatives 30 ล้านชุดที่สร้างโดย Gemini 2.5 Flash-Lite
- Post-training: ฝึกบนวิถีการทำงานของเอเจนต์ (agent trajectories) 1 ล้านชุดจากโปรโตคอลชั้นนำ
ผลการทดสอบพบว่าการทำ pre-training อย่างเดียวให้ความแม่นยำ top-1 ที่ 52.1% แต่เมื่อผ่านขั้นตอน mid-training ความแม่นยำจะพุ่งสูงถึง 69.2% ในขณะที่การฝึกบน hard negatives ตั้งแต่แรกเริ่มกลับทำให้เกิด overfitting ที่ 62.4%
ผลลัพธ์ Zero-Shot เทียบกับ Jev
| ภารกิจ | CLM-8B latency | Jev latency | CLM-8B success | Jev success |
|---|---|---|---|---|
| เกม T-Rex | 16.5 ms | 149.8 ms | 5/5 | 5/5 |
| การเรียกใช้เครื่องมือ (BFCL v4) | 76.8 ms | 125.5 ms | 95.2% | 99.2% |
| WikiRacing | 79.8 ms | 225 ms | 26/30 | 30/30 |
| Super Mario | 33.5 ms | 132.6 ms | 5/5 | 5/5 |
ความเร็วที่มากกว่า 9 เท่าเห็นได้ชัดในเกม T-Rex ซึ่งมีการกระทำซ้ำซ้อน CLM มีประสิทธิภาพเท่าเทียมกับ Jev ในเกมส่วนใหญ่ แต่อาจเป็นรองเล็กน้อยในด้านการเรียกใช้เครื่องมือและ WikiRacing แม้จะทำงานได้รวดเร็วกว่ามากก็ตาม
CLM ในฐานะตัวตรวจสอบสำหรับเอเจนต์เขียนโค้ด
เมื่อนำ CLM มาทำหน้าที่เป็นตัวตรวจสอบ (verifier) เพื่อเลือกโซลูชันที่ดีที่สุดจากผู้สมัครหลายราย ผลการประเมินในงาน DeepSWE (held-out) พบว่า CLM ที่ผ่านการ fine-tune ทำคะแนนได้ 81.6% และใน Terminal-Bench 2.1 ทำได้ 87.6% โดยมี latency ต่ำกว่าคู่แข่งอย่างเห็นได้ชัดบนเครื่อง H100
| เกณฑ์มาตรฐาน | Pass@1 | CLM (fine-tuned) | Jev | CLM latency | Jev latency |
|---|---|---|---|---|---|
| DeepSWE | 73.7% | 81.6% | 71.1% | 79 ms | 449 ms |
| Terminal-Bench 2.1 | 84.0% | 87.6% | 83.1% | 32 ms | 131 ms |
ผลลัพธ์นี้ถือเป็นมาตรฐานใหม่ (SOTA) ของตัวตรวจสอบ โดย CLM ทำงานเร็วกว่า Jev ถึง 4.1-5.7 เท่า ทั้งนี้ตัวเลขดังกล่าวมาจากการใช้ fine-tuned heads ขนาดเล็กในชุดทดสอบแบบ held-out ไม่ใช่คะแนนรวมจากตารางผู้นำหลัก
คำอธิบายแบบโต้ตอบ
ประเด็นสำคัญ
- CLM-8B เน้นการให้คะแนนการกระทำแทนการสร้างข้อความเพื่อลดการใช้ทรัพยากร
- ความเร็วสูงกว่า Jev สูงสุด 9 เท่าในการทดสอบแบบ zero-shot
- ทำคะแนนได้สูงถึง 81.6% ใน DeepSWE และ 87.6% ใน Terminal-Bench 2.1 หลังผ่านการ fine-tune
- ระบบแคชเวกเตอร์ช่วยลด latency ในลูปการทำงานของเอเจนต์อย่างมีนัยสำคัญ
- เป็นโมเดลแบบ Open-source ภายใต้ลิขสิทธิ์ Apache-2.0 ที่ติดตั้งใช้งานเองได้ง่าย
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร